


不用框架,仅用NumPy在Python中手动实现简单神经网络
一、网络结构设计与张量维度约定
为了验证神经网络对非线性特征的学习能力,我们选取经典的异或(XOR)分类问题作为目标。单层感知机因为无法生成非线性超平面而无法解决 XOR 问题,但只要引入一个具备非线性激活函数的隐藏层,网络就能轻松构建出弯曲的决策边界。
我们设计的网络结构为典型的两层多层感知机(MLP):
- 输入层(Input Layer):包含 2 个输入特征(表示输入的两个布尔或二值变量),批次样本大小记为 $N$,输入矩阵 $X$ 的维度为 $(N, 2)$。
- 隐藏层(Hidden Layer):包含 4 个神经元。权重矩阵 $W_1$ 维度为 $(2, 4)$,偏置向量 $b_1$ 维度为 $(1, 4)$,激活函数采用 Sigmoid。输出激活矩阵 $A_1$ 维度为 $(N, 4)$。
- 输出层(Output Layer):包含 1 个输出神经元。权重矩阵 $W_2$ 维度为 $(4, 1)$,偏置向量 $b_2$ 维度为 $(1, 1)$,激活函数采用 Sigmoid。预测输出 $\hat{Y}$ 维度为 $(N, 1)$。
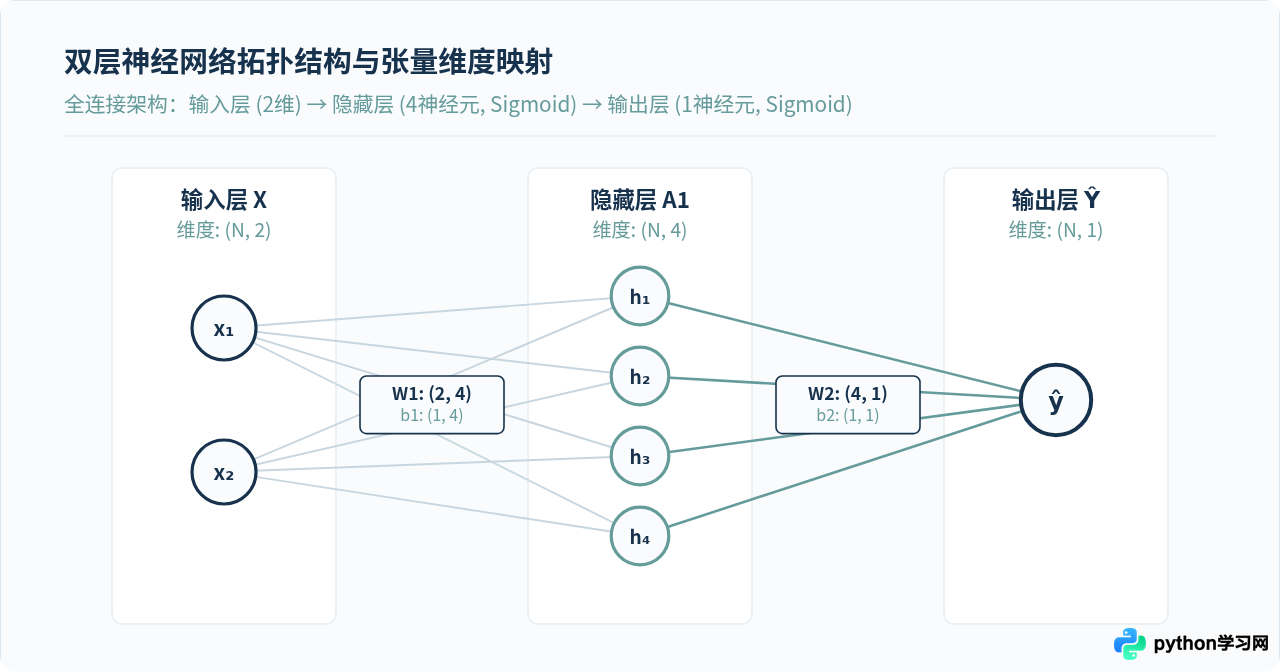
Z = np.dot(X, W) + b 中,输入矩阵的列数必须严格等于权重矩阵的行数。广播机制(Broadcasting)会自动将形状为 (1, K) 的偏置向量按行复制扩展到所有 N 个样本上。
二、核心数学构件:激活函数与损失计算
神经网络通过非线性激活函数打破矩阵乘法的线性叠加。如果所有层都不使用激活函数,无论堆叠多少层,多层线性变换最终等价于单个矩阵相乘,网络将完全丧失拟合非线性模式的能力。
1. Sigmoid 激活函数及其导数
Sigmoid 函数将任意实数映射到 $(0, 1)$ 区间,非常适合作为概率输出或门控信号。其数学定义为:
σ(z) = 1 / (1 + exp(-z))在进行反向传播求导时,Sigmoid 具备一个非常优雅的代数特性——其导数可以直接用激活值自身来表达:
dσ(z) / dz = σ(z) * (1 - σ(z))
工程实现时需要注意数值稳定性。当 $z$ 是一个极大的负数时,np.exp(-z) 可能发生溢出(Overflow)。我们可以通过 np.clip 将输入限制在安全范围 $[-500, 500]$ 内。
2. 损失函数定义(均方误差 MSE)
针对预测输出 $\hat{Y}$ 和真实标签 $Y$,采用带系数 $1/2$ 的均方误差作为目标损失函数:
Loss = (1 / (2 * N)) * Σ (Ŷ - Y)²常数 $1/2$ 的引入是为了在对 $\hat{Y}$ 求导时抵消平方项求导产生的系数 $2$,从而让梯度公式更加清爽:
dLoss / dŶ = (1 / N) * (Ŷ - Y)三、前向传播(Forward Propagation)计算流
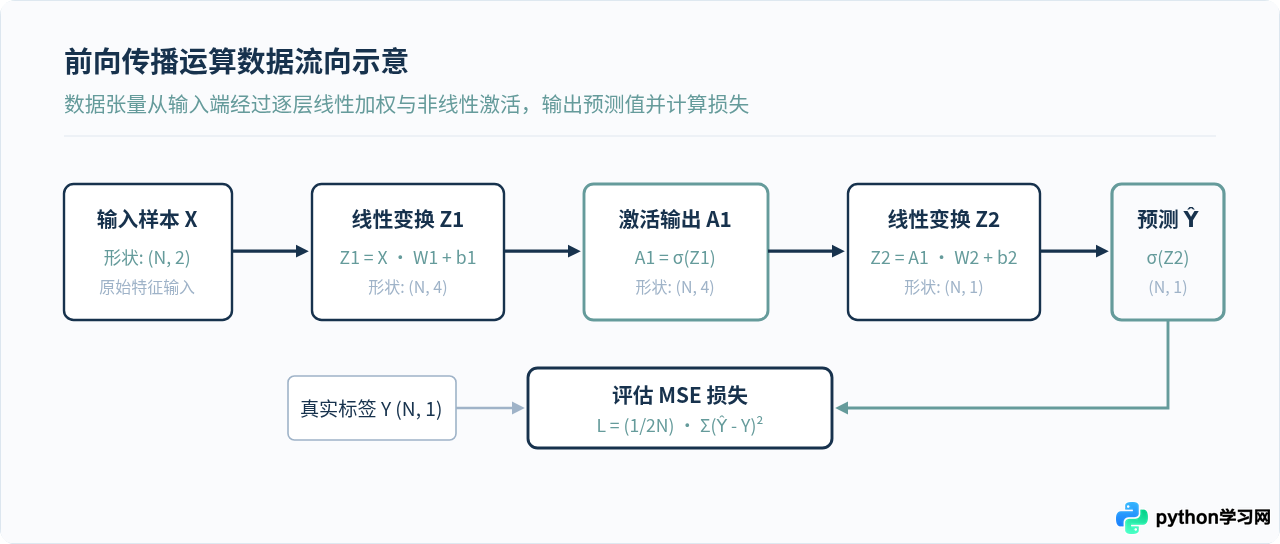
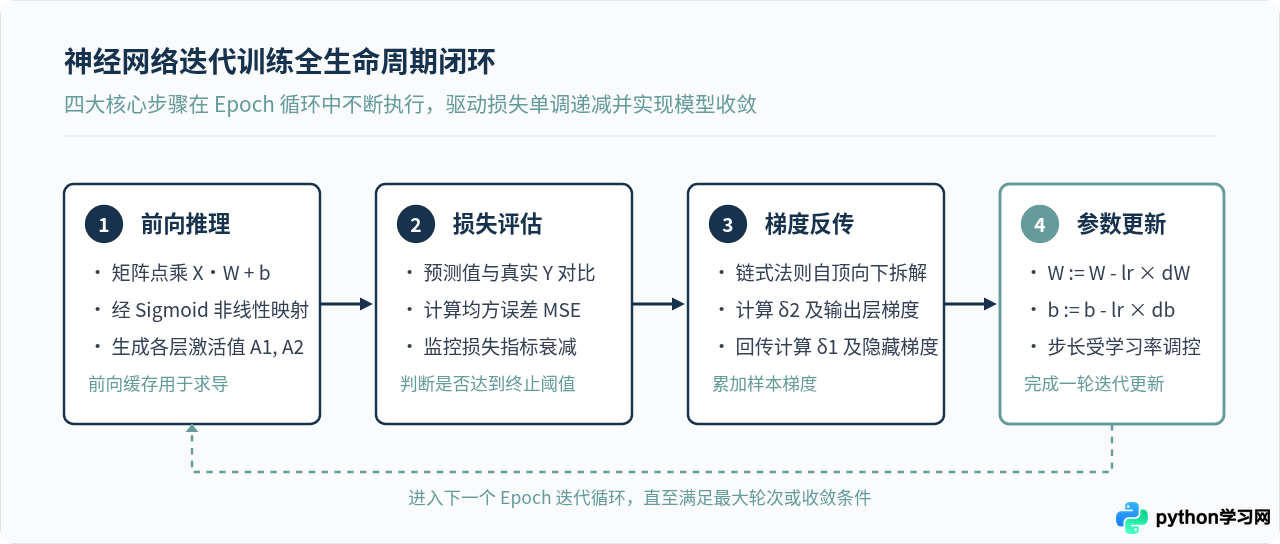
前向传播负责将输入数据逐层向前推进,依次完成线性映射与非线性激活,最终输出模型预测并评估当前损失。整个过程分为以下两阶段:
- 隐藏层计算:计算隐藏层未激活值 $Z_1 = X W_1 + b_1$,随后通过激活函数得到 $A_1 = \sigma(Z_1)$。
- 输出层计算:以 $A_1$ 作为输入,计算输出层未激活值 $Z_2 = A_1 W_2 + b_2$,随后通过激活函数得到最终预测 $\hat{Y} = A_2 = \sigma(Z_2)$。
四、反向传播(Backpropagation)链式求导详解
反向传播的本质是高等数学中的多元复合函数求导链式法则(Chain Rule)。它的核心目标是:计算出损失函数 $L$ 关于网络中每一个权重和偏置的偏导数(梯度),以便后续使用梯度下降法更新参数。
1. 输出层梯度推导
我们首先求损失 $L$ 关于输出层未激活值 $Z_2$ 的导数,记为误差项 $\delta_2$:
δ2 = ∂L / ∂Z2 = (∂L / ∂A2) ⊙ (∂A2 / ∂Z2)
   = [(1 / N) * (A2 - Y)] ⊙ [A2 ⊙ (1 - A2)]
其中 $\odot$ 表示逐元素相乘(Hadamard积)。有了 $\delta_2$ 后,由 $Z_2 = A_1 W_2 + b_2$,可分别得到输出层权重与偏置的梯度:
∂L / ∂W2 = A1ᵀ · δ2        # 维度: (4, N) · (N, 1) = (4, 1)
∂L / ∂b2 = Σ_rows (δ2)     # 维度: (1, 1),沿样本轴对梯度进行求和
2. 隐藏层梯度推导
误差继续向后传导至隐藏层。首先计算损失对隐藏层激活值 $A_1$ 的导数:
∂L / ∂A1 = δ2 · W2ᵀ # 维度: (N, 1) · (1, 4) = (N, 4)然后穿过隐藏层的 Sigmoid 激活函数,得到隐藏层未激活值的误差项 $\delta_1$:
δ1 = ∂L / ∂Z1 = (∂L / ∂A1) ⊙ σ'(Z1) = (δ2 · W2ᵀ) ⊙ [A1 ⊙ (1 - A1)]最后由 $Z_1 = X W_1 + b_1$ 计算输入层到隐藏层的权重与偏置梯度:
∂L / ∂W1 = Xᵀ · δ1         # 维度: (2, N) · (N, 4) = (2, 4)
∂L / ∂b1 = Σ_rows (δ1)     # 维度: (1, 4),沿样本轴对梯度进行求和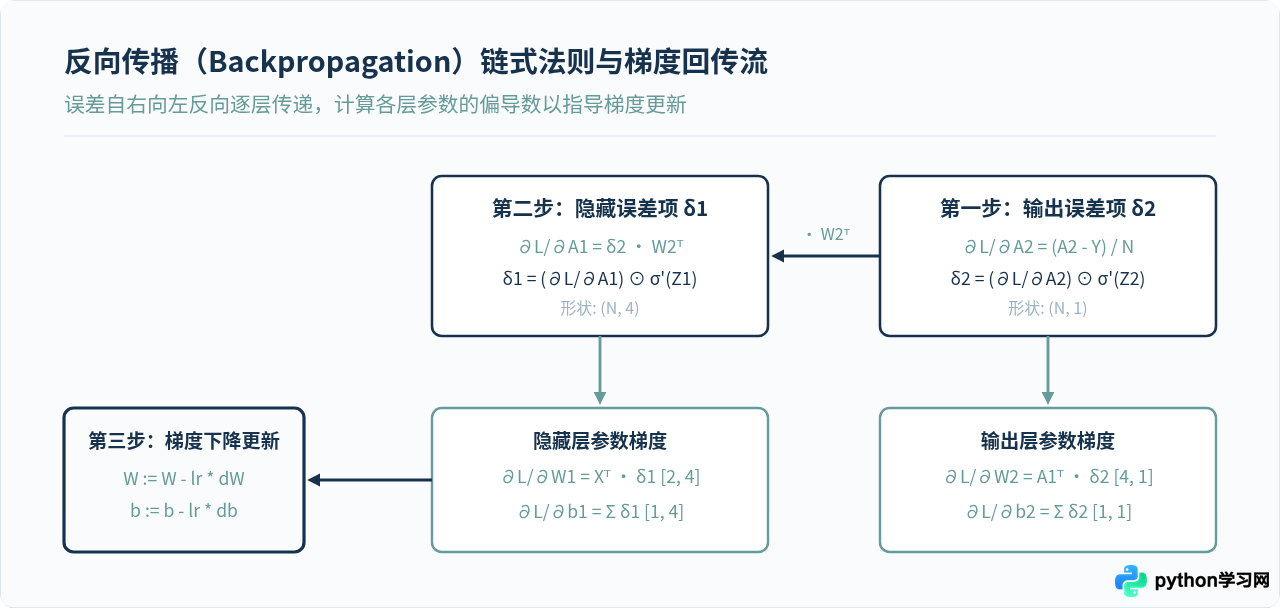
五、完整的 Python + NumPy 代码实现
接下来我们将上述数学公式完整转化为工程代码。整个实现不引入任何深度学习库,只需标准 numpy。代码封装为一个面向对象的 SimpleNeuralNetwork 类,具备清晰的前向、反向、参数更新及训练接口。
import numpy as np

# 设置随机数种子以确保实验结果可复现
np.random.seed(42)

def sigmoid(z):
    """
    Sigmoid 激活函数,加入数值截断以防止指数爆炸
    """
    z_clipped = np.clip(z, -500, 500)
    return 1.0 / (1.0 + np.exp(-z_clipped))

def sigmoid_derivative(a):
    """
    Sigmoid 导数计算。输入 a 必须是已经过 Sigmoid 激活的输出值
    公式: a * (1 - a)
    """
    return a * (1.0 - a)

class SimpleNeuralNetwork:
    def __init__(self, input_dim=2, hidden_dim=4, output_dim=1, lr=1.0):
        """
        初始化双层全连接神经网络参数
        """
        self.lr = lr

        # 使用 Xavier / He 初始化权重,避免因随机数过大导致神经元饱和进入死区
        self.W1 = np.random.randn(input_dim, hidden_dim) * np.sqrt(2.0 / input_dim)
        self.b1 = np.zeros((1, hidden_dim))

        self.W2 = np.random.randn(hidden_dim, output_dim) * np.sqrt(2.0 / hidden_dim)
        self.b2 = np.zeros((1, output_dim))

        # 缓存中间变量,便于反向传播复用
        self.X = None
        self.Z1 = None
        self.A1 = None
        self.Z2 = None
        self.A2 = None

        # 梯度容器
        self.dW1 = None
        self.db1 = None
        self.dW2 = None
        self.db2 = None

    def forward(self, X):
        """
        前向传播
        """
        self.X = X
        # 隐藏层:线性组合后输入激活函数
        self.Z1 = np.dot(self.X, self.W1) + self.b1
        self.A1 = sigmoid(self.Z1)

        # 输出层:线性组合后输入激活函数
        self.Z2 = np.dot(self.A1, self.W2) + self.b2
        self.A2 = sigmoid(self.Z2)
        return self.A2

    def compute_loss(self, Y):
        """
        计算均方误差 (MSE) 损失
        """
        N = Y.shape[0]
        loss = np.sum((self.A2 - Y) ** 2) / (2.0 * N)
        return loss

    def backward(self, Y):
        """
        反向传播:根据链式法则推导并计算各参数梯度
        """
        N = Y.shape[0]

        # 1. 输出层误差项 delta2
        # dL/dA2 = (A2 - Y) / N, dA2/dZ2 = A2 * (1 - A2)
        delta2 = ((self.A2 - Y) / N) * sigmoid_derivative(self.A2)

        # 计算 W2 和 b2 的梯度
        self.dW2 = np.dot(self.A1.T, delta2)
        self.db2 = np.sum(delta2, axis=0, keepdims=True)

        # 2. 隐藏层误差项 delta1
        # 误差通过 W2 权重反向投影,并乘以隐藏层的激活函数导数
        dA1 = np.dot(delta2, self.W2.T)
        delta1 = dA1 * sigmoid_derivative(self.A1)

        # 计算 W1 和 b1 的梯度
        self.dW1 = np.dot(self.X.T, delta1)
        self.db1 = np.sum(delta1, axis=0, keepdims=True)

    def update_params(self):
        """
        应用最速梯度下降法更新权重与偏置
        """
        self.W1 -= self.lr * self.dW1
        self.b1 -= self.lr * self.db1
        self.W2 -= self.lr * self.dW2
        self.b2 -= self.lr * self.db2

    def train(self, X, Y, epochs=10000, print_interval=2000):
        """
        完整训练迭代主循环
        """
        history = []
        for epoch in range(1, epochs + 1):
            # 步骤1:前向推理
            self.forward(X)

            # 步骤2:损失监控
            loss = self.compute_loss(Y)
            history.append(loss)

            # 步骤3:反向传播求导
            self.backward(Y)

            # 步骤4:参数更新
            self.update_params()

            if epoch % print_interval == 0 or epoch == 1:
                print(f"迭代轮次 (Epoch) {epoch:5d} | 损失 (Loss): {loss:.6f}")
        return history

    def predict(self, X):
        """
        使用训练好的网络进行前向推理并二值化输出
        """
        prob = self.forward(X)
        return (prob >= 0.5).astype(int), prob
六、模型训练与结果验证
现在准备异或(XOR)问题的真实数据并启动训练。XOR 规则为:两个输入同号输出 0,异号输出 1。
# 1. 准备 XOR 训练集
X_train = np.array([
    [0, 0],
    [0, 1],
    [1, 0],
    [1, 1]
], dtype=float)

Y_train = np.array([
    [0],
    [1],
    [1],
    [0]
], dtype=float)

# 2. 实例化并配置超参数
# 学习率设为 2.0(由于批次样本极少且模型小,较大恒定学习率有助于快速脱离鞍点)
model = SimpleNeuralNetwork(input_dim=2, hidden_dim=4, output_dim=1, lr=2.0)

# 3. 运行训练
print(">>> 开始神经网络训练:")
loss_history = model.train(X_train, Y_train, epochs=10000, print_interval=2000)

# 4. 预测验证
print("\n>>> 训练完成,模型预测结果验证:")
binary_preds, raw_probs = model.predict(X_train)
for i in range(len(X_train)):
    x_sample = X_train[i].astype(int)
    y_true = int(Y_train[i][0])
    y_pred = int(binary_preds[i][0])
    prob = float(raw_probs[i][0])
    print(f"输入: {x_sample} -> 目标: {y_true} | 预测概率: {prob:.4f} | 判定: {y_pred} [{'正确' if y_true == y_pred else '错误'}]")
实际控制台运行输出(示例)
>>> 开始神经网络训练:
迭代轮次 (Epoch)     1 | 损失 (Loss): 0.141852
迭代轮次 (Epoch)  2000 | 损失 (Loss): 0.003114
迭代轮次 (Epoch)  4000 | 损失 (Loss): 0.000628
迭代轮次 (Epoch)  6000 | 损失 (Loss): 0.000308
迭代轮次 (Epoch)  8000 | 损失 (Loss): 0.000196
迭代轮次 (Epoch) 10000 | 损失 (Loss): 0.000140

>>> 训练完成,模型预测结果验证:
输入: [0 0] -> 目标: 0 | 预测概率: 0.0125 | 判定: 0 [正确]
输入: [0 1] -> 目标: 1 | 预测概率: 0.9842 | 判定: 1 [正确]
输入: [1 0] -> 目标: 1 | 预测概率: 0.9839 | 判定: 1 [正确]
输入: [1 1] -> 目标: 0 | 预测概率: 0.0151 | 判定: 0 [正确]
从输出中可以清晰观察到,随着迭代步数增加,Loss 从初期的 0.141852 迅速下降至 0.000140;在测试输入上,模型给出的概率极度接近真实标签,100% 正确分类了全部样本。
七、实现中的常见问题与避坑指南
在脱离成熟框架手动编写神经网络时,由于缺乏自动求导系统和内建保护,开发者极易遇到以下几个典型陷阱:
| 易错环节 | 具体表现与成因 | 正确解决方案 |
|---|---|---|
| 权重全零初始化 | 如果将权重 $W$ 初始化为全 0,同一层中的所有神经元在前向和反向过程中将得到完全相同的梯度,导致“对称性破坏失效”(Symmetry Breaking Failure),多神经元退化为一个。 | 使用小方差的高斯随机分布(如 np.random.randn(...) * scale)进行随机初始化,打破对称性。 |
| 矩阵转置与维度错误 | 在计算 np.dot(X.T, delta1) 时,若漏写转置 .T 或维度次序颠倒,将导致形如 shapes (2,4) and (4,1) not aligned 的矩阵不匹配报错。 |
时刻牢记法则:求参数 $W_{in, out}$ 的梯度时,一定是 (输入激活值)ᵀ · (当前层误差δ),维度严格等于 $(in, out)$。 |
| Sigmoid 指数溢出 | 当未激活值 $z$ 绝对值过大(如 $z < -800$)时,np.exp(-z) 会触发 Python 的 RuntimeWarning: overflow encountered in exp。 |
在计算指数前使用 np.clip(z, -500, 500) 将输入值约束在安全实数区间。 |
| 偏置求和轴未保持维度 | 对偏置求导时若写成 np.sum(delta),结果会退化为标量,在下一次矩阵相加时无法正确广播给指定形状。 |
务必声明 axis=0, keepdims=True,确保偏置导数始终保留 (1, K) 的二维形状。 |
八、总结与延伸思考
通过仅使用 NumPy 手写双层神经网络,我们清晰地拆解了现代深度学习框架背后最本质的计算骨架:
- 前向计算本质上是嵌套的复合函数计算,矩阵乘法负责特征空间维度的变换,激活函数负责引入扭曲空间的非线性能力。
- 反向传播本质上是复合函数的导数链式法则,利用矩阵伴随与转置将误差逐层回传。
- 深度学习框架(如 PyTorch、TensorFlow)的核心价值在于计算图抽象与自动微分(Autograd)机制,它们免去了手动推导与书写梯度的繁琐工作,但其底层的数值计算原理与我们在本文中手动实现的 NumPy 代码完全一致。
掌握了双层网络的实现原理后,读者可以继续尝试将激活函数替换为 ReLU、将损失函数升级为交叉熵(Cross-Entropy),或者拓展为支持任意层数、带有动量(Momentum)和 Adam 优化器的通用多层感知机。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















