


Python怎么从类创建实例对象及self的作用
深入浅出地讲解Python中如何从类创建独立的实例对象,全面剖析self参数的底层机制、属性隔离与常见调用报错,配有完整代码与架构图解。
假设你正在编写一个团队项目中的用户权限系统,需要为张三、李四等不同用户记录各自的工号与登录状态。如果仅用普通字典或散落的全局函数处理,数据字段容易缺失,状态也极易在函数调用中被意外覆盖。在面向对象编程中,我们通过将通用的数据结构与处理逻辑抽象为一个“类”(Class),再根据这个模板生成具体的“实例对象”(Instance)。在 Python 中,通过 类名(参数) 的语法即可实例化对象,而定义在类方法内部的 self 参数,则是将行为与具体对象状态精确绑定在一起的关键纽带。
一、怎么从类创建实例对象
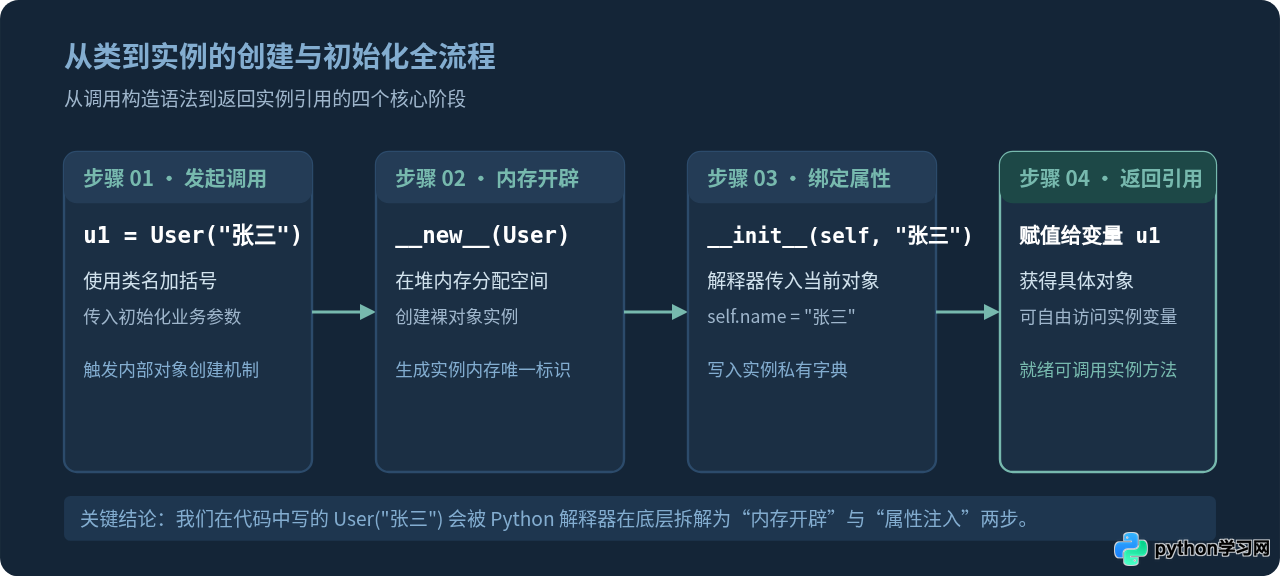
在 Python 中,类(Class)是创建对象的蓝图,而实例(Instance)是根据这幅蓝图实体化出来的具体数据对象。创建实例的过程通常被称为实例化。具体操作只需两个核心动作:
- 使用
class关键字定义类,并在内部编写__init__初始化方法; - 在类名后添加圆括号
ClassName(...),传入所需参数,并将返回的结果赋值给变量。
1. 完整可执行的代码示例
下面是一个标准的员工账号类示例。我们在类中定义了姓名和部门属性,并提供了一个打卡记录的方法:
# 1. 定义类模板
class Employee:
    def __init__(self, name: str, department: str):
        # 将传入的参数绑定到当前实例对象的属性上
        self.name = name
        self.department = department
        self.sign_in_count = 0

    def clock_in(self):
        # 修改当前实例的状态
        self.sign_in_count += 1
        print(f"[{self.department}] {self.name} 已打卡,累计打卡: {self.sign_in_count} 次")

# 2. 从类创建两个独立的实例对象
emp1 = Employee("张三", "技术部")
emp2 = Employee("李四", "市场部")

# 3. 分别调用各自的方法
emp1.clock_in()
emp1.clock_in()
emp2.clock_in()
在 Python 3 终端中执行上述代码,得到的输出如下:
[技术部] 张三 已打卡,累计打卡: 1 次
[技术部] 张三 已打卡,累计打卡: 2 次
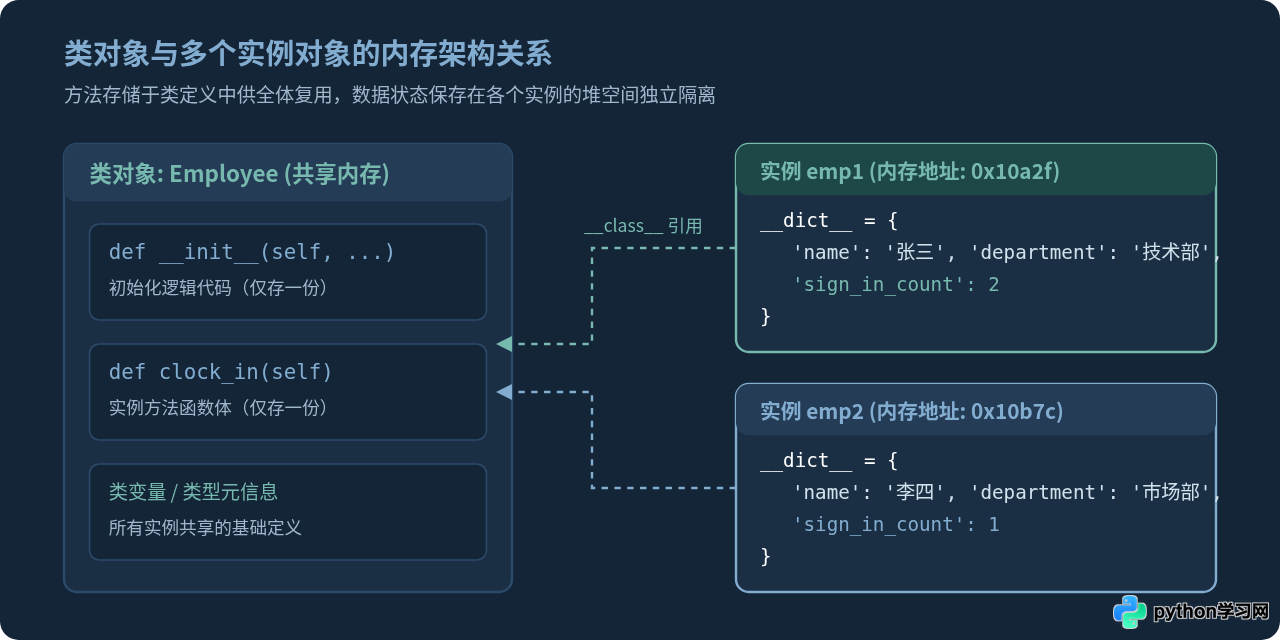
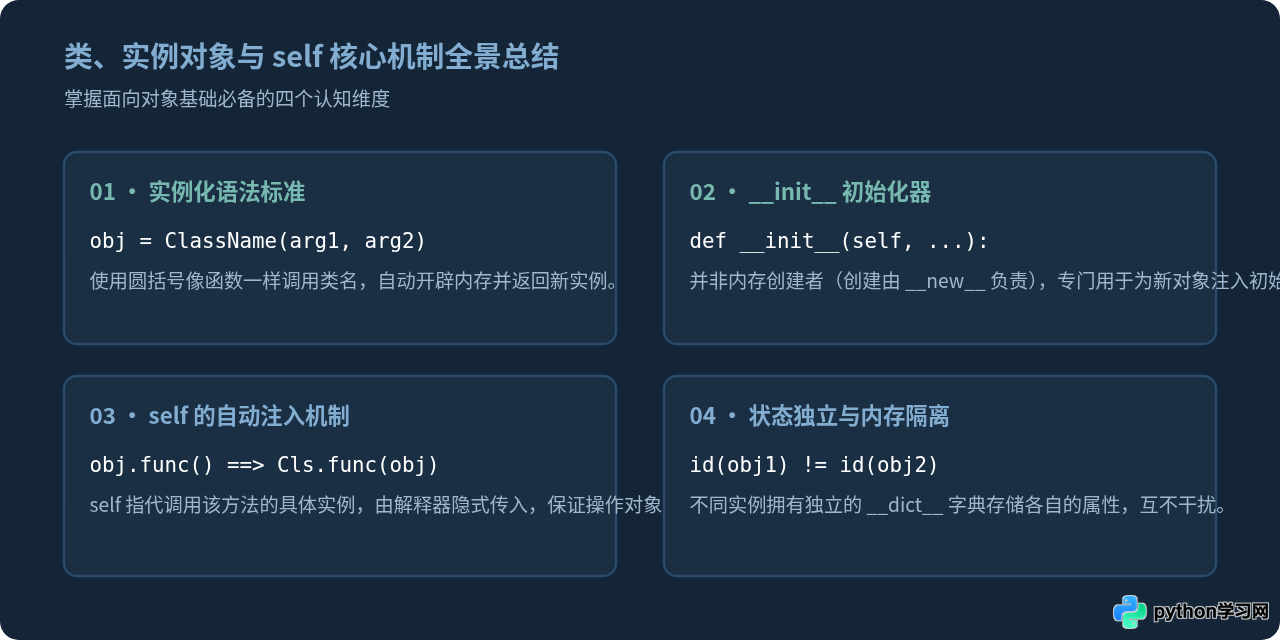
[市场部] 李四 已打卡,累计打卡: 1 次从输出中可以明显观察到:emp1 的打卡次数累积到了 2 次,而 emp2 仅打卡 1 次。尽管它们共享同一个 Employee 类中的方法代码,但各自的状态数据完全独立、互不干扰。这背后的核心支撑正是每一个对象独享的内存区域与 self 参数。
二、self 的本质与核心作用
很多刚学习 Python 的读者会困惑:既然在调用 emp1.clock_in() 时圆括号内什么都没传,为什么在定义 def clock_in(self): 时必须写上 self 参数?
1. self 是什么?
简而言之:self 就是当前正在调用这个方法的实例对象本身。
Python 设计哲学崇尚“明确优于隐晦”(Explicit is better than implicit)。在 C++ 或 Java 等语言中,调用对象的内部属性通常通过隐式存在的 this 指针完成,而在 Python 中,解释器要求在定义实例方法时,必须显式地把接收该实例引用的形参写在第一位,约定俗成命名为 self。
2. 底层解密:语法糖的本质转换
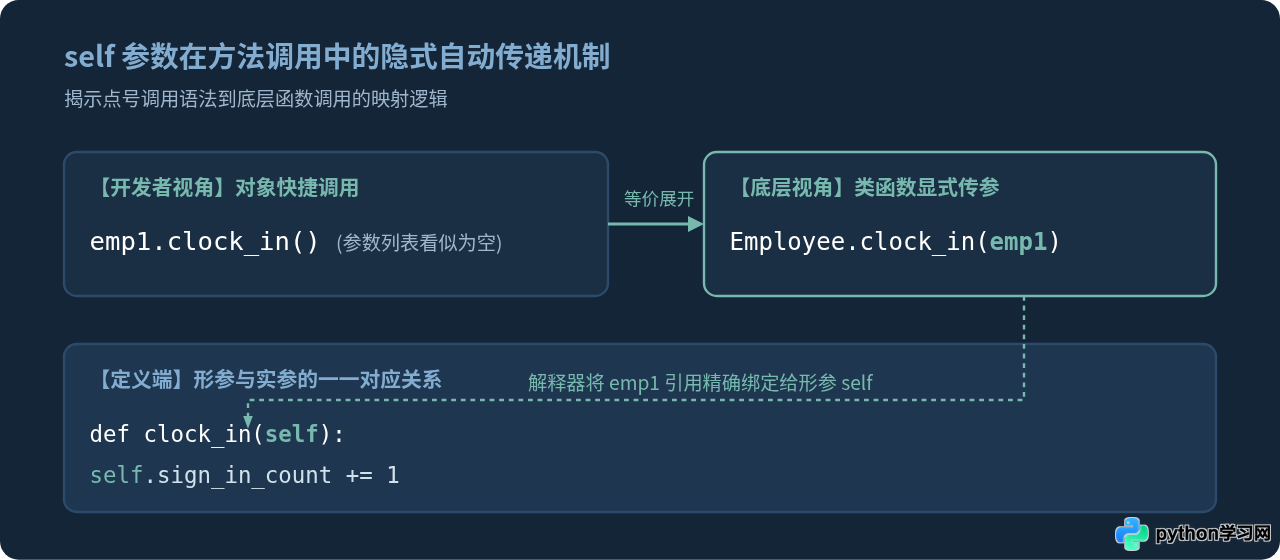
在 Python 底层,当使用 实例.方法(实参) 时,Python 解释器会自动将其转换为 类.方法(实例, 实参)。换句话说:
# 表面上的常规写法:
emp1.clock_in()

# 实际上解释器执行的等价底层写法:
Employee.clock_in(emp1)
你可以直接在 Python 交互式环境中执行 Employee.clock_in(emp1),结果与 emp1.clock_in() 完全相同。这清晰地说明了为什么定义方法时要有 self——因为在实际函数执行时,它确确实实接收到了一个真实的对象作为第一个入参。
3. self 的两大核心作用
- 隔离与持久化实例状态:通过
self.属性名 = 值,可以将数据永久保存在当前实例的独立字典空间中。只要实例还存在,它的内部变量就随身携带,不会被其他对象覆盖。 - 实现同一对象内部的方法与属性互通:在一个方法中,若需要调用该对象的另一个方法或读取其他属性,只需通过
self.其他方法()或self.其他属性即可轻松联动。
三、常见误区与避坑指南
在编写类与使用 self 时,新手开发者最常遇到以下四个典型错误:
1. 定义方法时遗漏 self 参数
如果定义普通方法时未写 self:
class Tool:
    def run():   # 错误:缺少 self 参数
        print("工具运行中")

t = Tool()
t.run()
TypeError: Tool.run() takes 0 positional arguments but 1 was given原因剖析:读者容易以为自己没传参,但 Python 解释器在后台自动将实例
t 传入了 run()。而 run() 定义时不接收任何参数,因此提示“期望 0 个位置参数却给了 1 个”。
2. 在方法内部直接使用变量名,忘记加 self. 前缀
class Counter:
    def __init__(self):
        self.count = 0

    def add(self):
        # 错误写法:count += 1 会被 Python 当作局部变量,抛出 UnboundLocalError
        # 正确写法应为:self.count += 1
        self.count += 1
不加 self. 的变量仅仅是当前函数执行栈中的临时局部变量,函数执行完毕后就会被立即销毁,根本无法写入对象的内部状态。
3. 类属性与实例属性混淆
直接写在类体里、而在 __init__ 外面的变量是类属性,它被所有实例共享;而在方法中通过 self.属性名 赋值的则是实例属性,属于个体独有。例如将可变列表作为类属性,会导致所有实例对该列表的修改相互串扰。
四、总结
理解 Python 中的类与对象,可以把“类”看作建筑工程的图纸,而“实例”就是依据图纸建造出的实体大楼。你可以使用同一份图纸建造十栋大楼,每一栋大楼的房间格局一致(共享方法),但每栋大楼里住着不同的人、摆放着不同的家具(独立实例属性)。
而 self,就是大楼内部各处标识的“本栋大楼专属门牌”。无论执行巡检还是开关电闸(调用方法),self 都能确保工作人员准确操作当前这栋大楼,而绝不会走错门栋。掌握好实例化的调用过程与 self 的传参原理,就打通了理解 Python 面向对象高级特性的坚实基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















