


Python多重装饰器执行顺序:加载与调用的区别
深入解析Python多重装饰器的执行机制,理清导入定义阶段(自底向上加载)与实际调用阶段(自顶向下执行)的本质区别与代码原理。
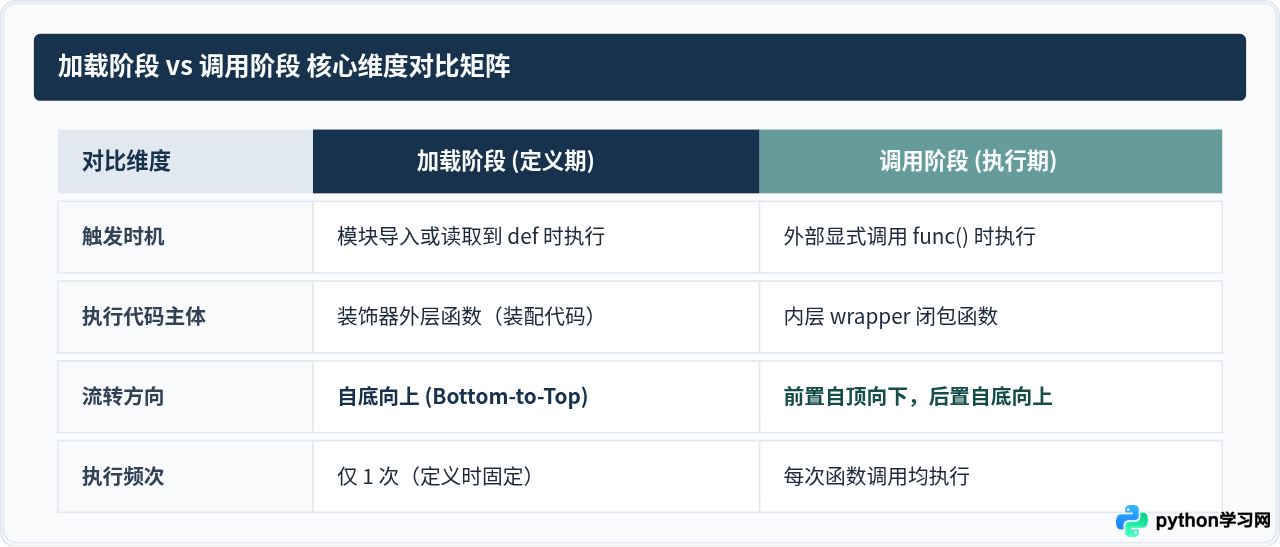
在 Python 开发中,叠加多个装饰器(如同时添加鉴权、日志、缓存等)是常见的模式。很多初学者常会产生困惑:“为什么装饰器看起来是倒着装配的,但实际运行日志又是正着打印的?”核心答案在于:装饰器的执行分为两个完全不同的阶段——模块加载时的“装配绑定阶段”和函数执行时的“闭包调用阶段”。装配时遵循从下到上(自底向上)的数学复合顺序,而调用时外层包装函数先捕获请求,遵循从上到下(自顶向下)的洋葱模型展开。
一、核心机制:语法糖等价展开
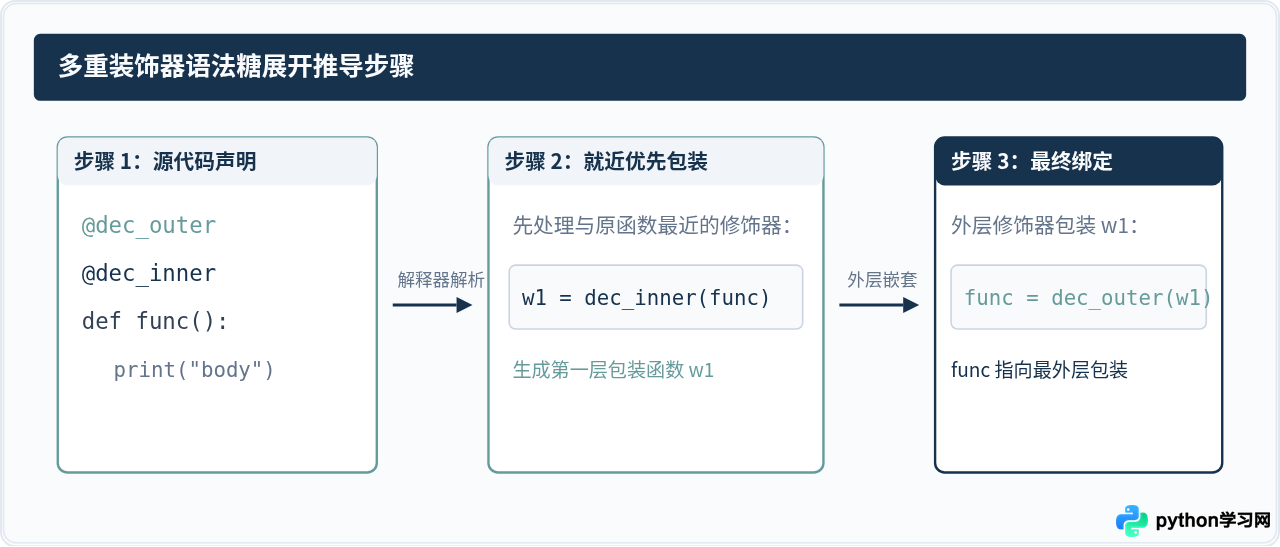
要彻底厘清顺序问题,首先需要理解 Python 中的 @decorator 语法糖究竟做了什么。当多个装饰器修饰同一个函数时,Python 解释器在语法解析期对其进行嵌套求值。
# 语法糖写法
@decorator_a
@decorator_b
def target_func():
    pass

# 底层等价代码(自底向上的数学复合)
target_func = decorator_a(decorator_b(target_func))如上述等价形式所示,target_func 首先作为参数传入最底部的 decorator_b;随后,decorator_b 的返回值(通常是一个包装函数)再作为参数传入上一层的 decorator_a。这种从内向外的函数求值规则,直接决定了装饰器的加载行为。
二、阶段一:加载阶段(自底向上)
加载阶段(又称定义期、装饰期)发生在 Python 脚本被运行或模块被 import 时。只要解释器读取到函数定义处的 def 语句,装饰器函数本体就会立刻被执行。
为了明确观察这一过程,我们编写两个基础装饰器,在装饰器函数体内(而非内部 wrapper 中)打印初始化日志:
def decorator_a(func):
    print("[加载期] decorator_a 正在包装:", func.__name__)
    def wrapper_a(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper_a

def decorator_b(func):
    print("[加载期] decorator_b 正在包装:", func.__name__)
    def wrapper_b(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper_b

# 此时仅定义函数,不调用
@decorator_a
@decorator_b
def test_demo():
    print("test_demo 核心业务执行")
示例输出:
[加载期] decorator_b 正在包装: test_demo
[加载期] decorator_a 正在包装: wrapper_b
可以看到,虽然源码中 @decorator_a 写在上方,但先执行输出的却是 decorator_b。因为 decorator_a 必须等待其参数计算完毕,而它的参数正是 decorator_b(test_demo) 的返回值。因此加载阶段是严格自底向上运行的。
三、阶段二:调用阶段(自顶向下与洋葱模型)
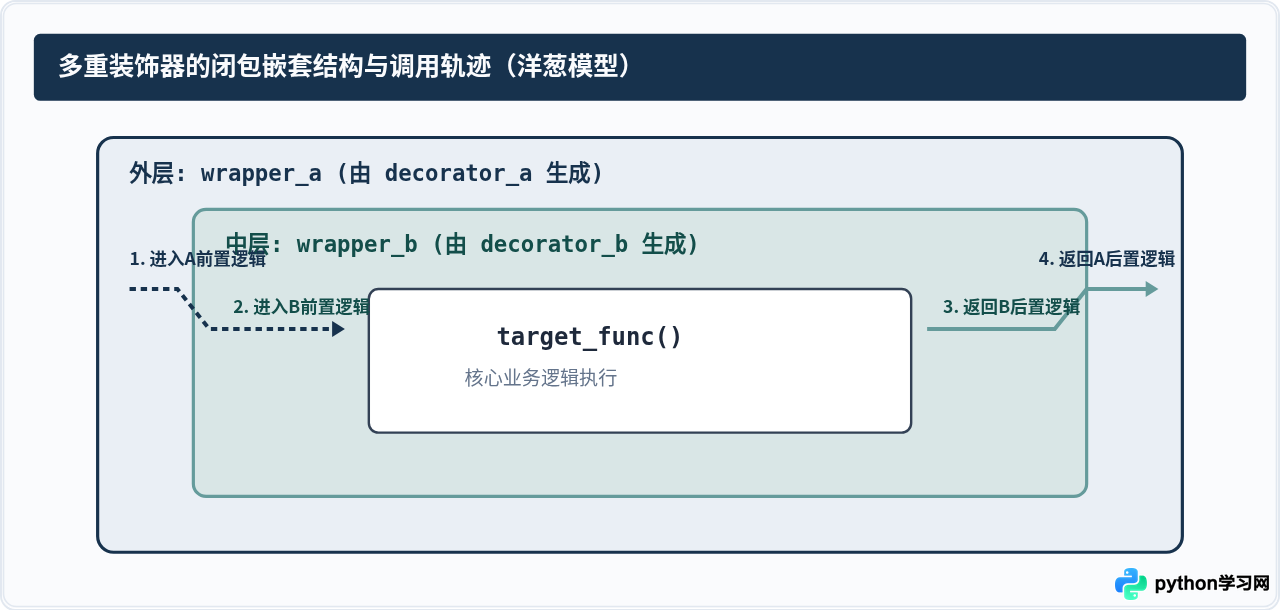
当真正的业务代码调用 test_demo() 时,程序进入调用阶段。此时 test_demo 变量引用的实际是 wrapper_a。wrapper_a 的闭包内保存着 wrapper_b,而 wrapper_b 内部保存着原始的 test_demo。
完整调用测试代码如下:
import functools

def decorator_a(func):
    @functools.wraps(func)
    def wrapper_a(*args, **kwargs):
        print("[A] 前置拦截 (入栈)")
        result = func(*args, **kwargs)
        print("[A] 后置处理 (出栈)")
        return result
    return wrapper_a

def decorator_b(func):
    @functools.wraps(func)
    def wrapper_b(*args, **kwargs):
        print("  [B] 前置拦截 (入栈)")
        result = func(*args, **kwargs)
        print("  [B] 后置处理 (出栈)")
        return result
    return wrapper_b

@decorator_a
@decorator_b
def run_task():
    print("    [Core] 核心业务函数运行中...")

# 触发调用
if __name__ == "__main__":
    print("=== 开始调用 run_task ===")
    run_task()
    print("=== 调用结束 ===")
示例输出:
=== 开始调用 run_task ===
[A] 前置拦截 (入栈)
  [B] 前置拦截 (入栈)
    [Core] 核心业务函数运行中...
  [B] 后置处理 (出栈)
[A] 后置处理 (出栈)
=== 调用结束 ===
从输出中可以清晰地看到:
- 前置代码执行顺序:由上至下(A → B)。因为最外层的
wrapper_a首先捕获到函数调用。 - 核心业务执行:位于最内层,在前置拦截均放行后运行。
- 后置代码执行顺序:由下至上(B → A)。类似函数调用栈的“后进先出”(LIFO),最深层的
wrapper_b先完成并返回给wrapper_a。
四、工程实战:带参数装饰器的求值顺序
当装饰器本身带有参数时(如 @auth(role="admin")),会引入第三个细节:工厂函数的执行。
带参数装饰器本质上是一个“返回装饰器的工厂函数”。在解释器处理时,必须先求出装饰器本身,才能进行装配:
def dec_maker(name):
    print(f"[工厂求值] 生成装饰器: {name}")
    def real_decorator(func):
        print(f"  [加载装配] {name} 正在包装: {func.__name__}")
        def wrapper(*args, **kwargs):
            print(f"    [调用] 进入 {name}")
            res = func(*args, **kwargs)
            print(f"    [调用] 退出 {name}")
            return res
        return wrapper
    return real_decorator

@dec_maker("Outer")
@dec_maker("Inner")
def my_service():
    print("      [Service] 业务处理中...")
示例输出:
[工厂求值] 生成装饰器: Outer
[工厂求值] 生成装饰器: Inner
  [加载装配] Inner 正在包装: my_service
  [加载装配] Outer 正在包装: wrapper
原因解释: Python 在从上往下阅读表达式时,先依次计算了 dec_maker("Outer") 和 dec_maker("Inner") 的函数调用。得到两个真实的装饰器后,再按照上述规则从下到上进行装配。这一细节在排查动态装饰器传参问题时尤为关键。
五、设计建议与顺序依赖避坑
在工程项目中,装饰器的顺序如果不加以注意,很容易产生严重 Bug 或性能瓶颈:
- 认证鉴权应置于最外层:例如
@require_auth应当放在最上方。如果将费时的@cache或@metric放在更外层,未授权的恶意请求也会导致缓存查询或监控打点,造成资源浪费。 - 路由注册装饰器与包装顺序:在 Flask 等框架中,
@app.route必须放在最顶层。如果把其他装饰器放在其上方,Flask 注册的将是未经包装的函数引用。 - 保留元数据(functools.wraps):始终在
wrapper上使用@functools.wraps(func)。否则经过多层包装后,__name__和__doc__会退化为内层的wrapper,导致依赖函数名的反射逻辑或文档生成器失效。
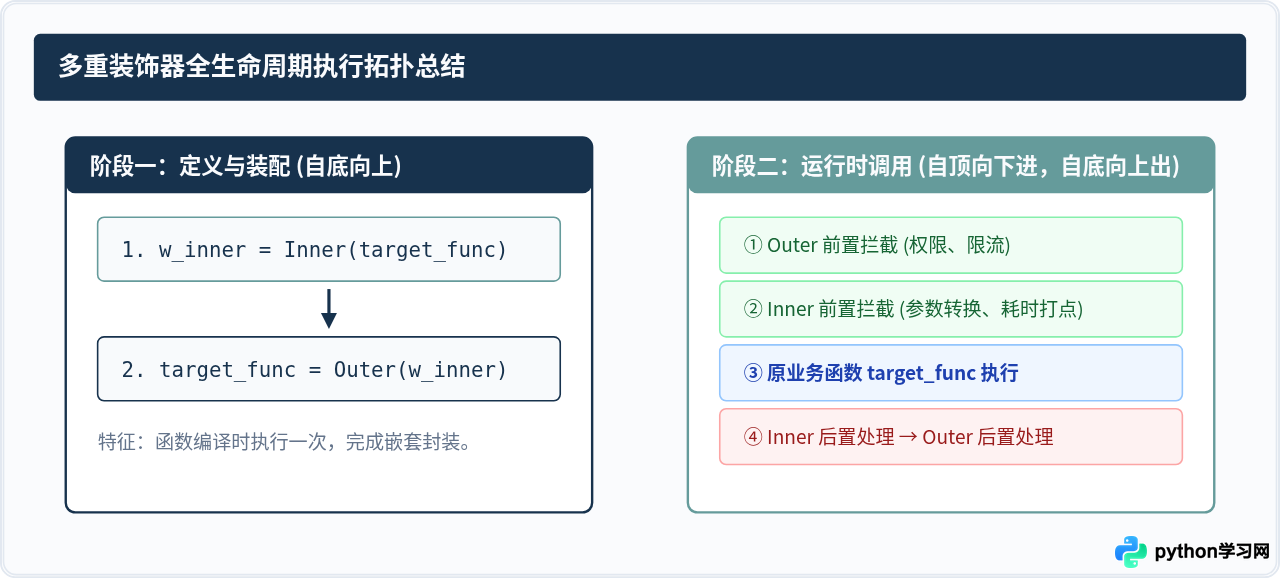
装配自底向上(数学复合,内层先包);
前置自顶向下(洋葱穿透,外层先拦);
后置自底向上(调用返回,先进后出)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















