


Python官方参考文档使用指南:怎么快速定位标准库与API
本指南详细讲解如何高效查阅Python官方参考文档,掌握Global Module Index、标准库分类目录、函数签名解析及版本差异对比,快速准确直达所需API。
查找 Python 官方文档时,许多人习惯直接在搜索引擎中输入零碎的关键字,但往往会被过时的第三方博客或版本不一致的代码片段误导。快速、精准定位 Python 标准库与 API 的核心路径,在于掌握官方文档的三大核心导航体系:通过模块全局索引(Global Module Index)实现秒级直达、利用标准库分类树(The Python Standard Library)建立知识定位图谱,以及读懂函数签名与版本变更标签。掌握这套方法后,无论查找日常模块还是确认底层接口,都能在数十秒内锁定权威定义。
一、认识官方文档体系:四大板块与分工定位
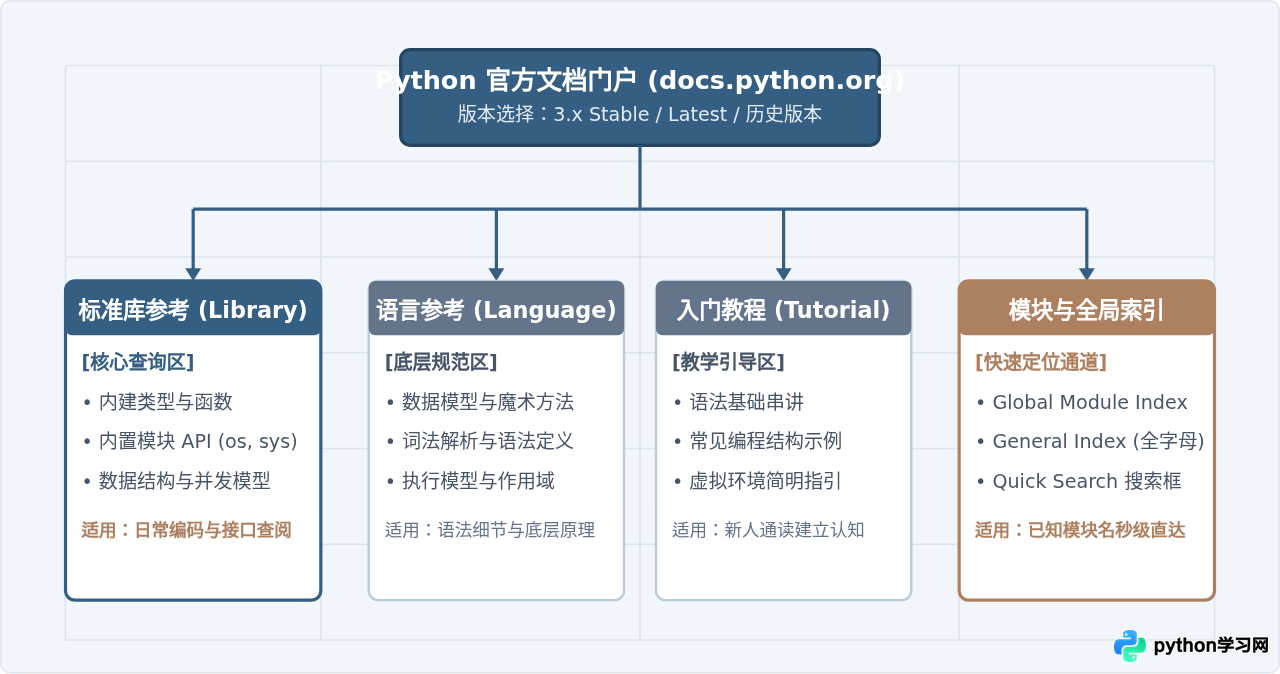
进入 Python 官方文档首页(docs.python.org)后,读者会看到数十个导航入口。面对庞杂的内容,首先需要明确各分卷的职责边界,避免在错误的板块浪费时间:
- Python 标准库参考(The Python Standard Library):日常查阅频率最高的核心部分。涵盖所有内建类型(如
dict、list)、内建函数(如enumerate()、zip())以及随 Python 解释器附带的所有标准模块(如os、json、asyncio、pathlib)。 - Python 语言参考手册(The Python Language Reference):专门描述 Python 语法规范与语言内部执行模型。当需要弄清楚变量作用域、赋值解包规则、垃圾回收机制、元类运作或操作符底层魔术方法(如
__new__与__init__的先后顺序)时才需要查阅此卷。 - 入门教程(The Python Tutorial):面向初学者的概念串讲,适合宏观建立语言印象,但不适合作为 API 快速参考手册。
- 索引与搜索入口(Global Module Index / General Index):按字母排序整理的全局索引列表,是快速跳转到指定模块最平稳、直观的通道。
二、快速定位标准库与API的实操四步法
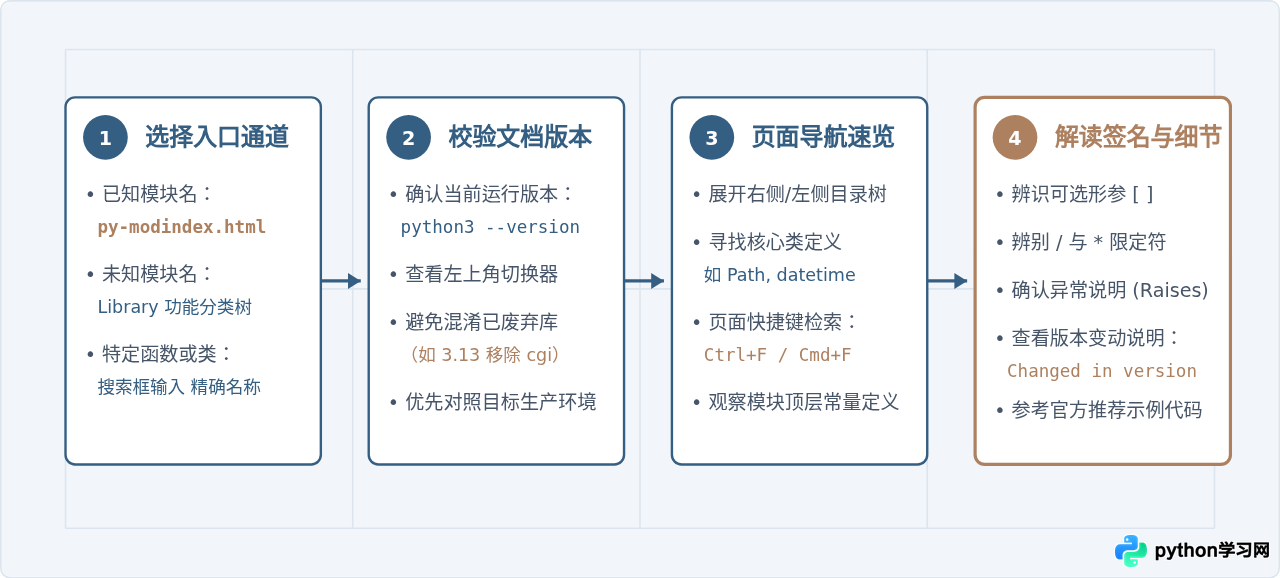
为了摆脱无目的翻找,查阅官方文档应建立结构化的操作步骤。按照以下四个顺序执行,可以在极短时间内锁定目标内容:
第一步:善用 Global Module Index 直达目标模块
如果已经知道需要使用的标准库模块名称(例如 sqlite3、urllib.parse、hashlib),最快速的方法不是在搜索框盲猜,而是直接点击页面右上角的 Global Module Index(或者直接在浏览器地址栏输入类似 docs.python.org/3/py-modindex.html)。
这个页面按英文字母 A 到 Z 组织了完整的标准库模块列表。点击对应的首字母即可直接定位并跳转到该模块的官方说明页,完全不受全文检索关键字匹配度排名的干扰。
第二步:严格校验文档版本,规避兼容性陷阱
Python 3 各小版本(例如 3.8、3.10、3.12、3.13)在标准库的增补、参数调整以及过时模块清理上有显著变化。进入任意文档页面后,应首先观察左上角(或导航栏下拉列表)所标注的版本号:
- 如果当前开发环境使用的是 Python 3.10,而直接阅读了默认的最新版本(如 3.13)文档,可能会误用 3.11 或 3.12 才引入的新特性或新参数(例如
datetime.UTC是 3.11 引入的,3.10 中并不存在)。 - 如果当前正在维护旧系统,可以通过切换器直接选择对应的历史版本文档,保证查阅的信息与运行环境完全一致。
第三步:利用标准库分类树应对“功能已知、模块未知”
如果面临一个具体功能需求,但不知道 Python 是否自带或者是由哪个模块实现的,切勿直接依赖外部搜索。直接进入 The Python Standard Library 根目录,该页面将整个标准库按工程领域清晰地划分为 20 多个大类:
| 标准库大类(分类目录) | 覆盖的核心功能与代表模块 | 适用场景举例 |
|---|---|---|
| Generic Operating System Services | os, io, time, logging, platform |
操作系统交互、日志记录、文件描述符、计时与平台检测 |
| File and Directory Access | pathlib, os.path, shutil, stat |
面向对象的路径操作、目录递归遍历、文件复制与解压 |
| Data Types & Collections | collections, heapq, bisect, dataclasses |
双端队列、堆排序、二分查找、结构化数据容器定义 |
| Internet Data Handling | email, json, mailbox, mimetypes |
JSON 编解码、邮件内容解析、MIME 类型推导 |
| Concurrent Execution | threading, multiprocessing, concurrent.futures, subprocess |
多线程、多进程池、子进程调用与外部命令交互 |
第四步:终端快速辅助——脱机时的 pydoc 与 help()
在网络受限或离线开发环境中,Python 自带的脱机工具是官方文档的完整本地镜像:
# 启动本地官方文档 HTTP 服务,浏览器访问 http://localhost:8888 即可离线浏览完整文档
python3 -m pydoc -p 8888

# 在终端内直接按手册(man-page)风格查看指定模块或类
python3 -m pydoc json.dumps
在 Python 交互式命令行(REPL)中,直接执行 help(os.path.join) 即可提取底层 docstring,其内容与在线文档的方法签名及基础说明完全同步。
三、标准库 API 页面解构:读懂专业工程标记
定位到具体模块页面后,核心任务是准确解读函数或类的声明规范。官方文档有一套通用的排版与标记规范,用于严谨传达参数的使用边界与演变历程:
1. 正确识别形参语法符号:方括号 [ ]、斜杠 / 与星号 *
在阅读官方文档的函数定义时,经常会看到一些特殊的符号,它们具有精确的语法含义:
- 方括号
[ ]:表示可选参数。例如str.split([sep[, maxsplit]]),这是一种源于传统手册的表示法,表示sep是可选的;若提供了sep,还可以选择性提供maxsplit。注意:这并不是实际代码中的列表语法。 - 斜杠
/(仅限位置形参):斜杠之前的参数只能按位置传入,不能使用关键字方式指定。例如内建函数pow(base, exp, mod=None, /),调用时必须写pow(2, 3),写成pow(base=2, exp=3)将在解释器中直接抛出TypeError。 - 独立星号
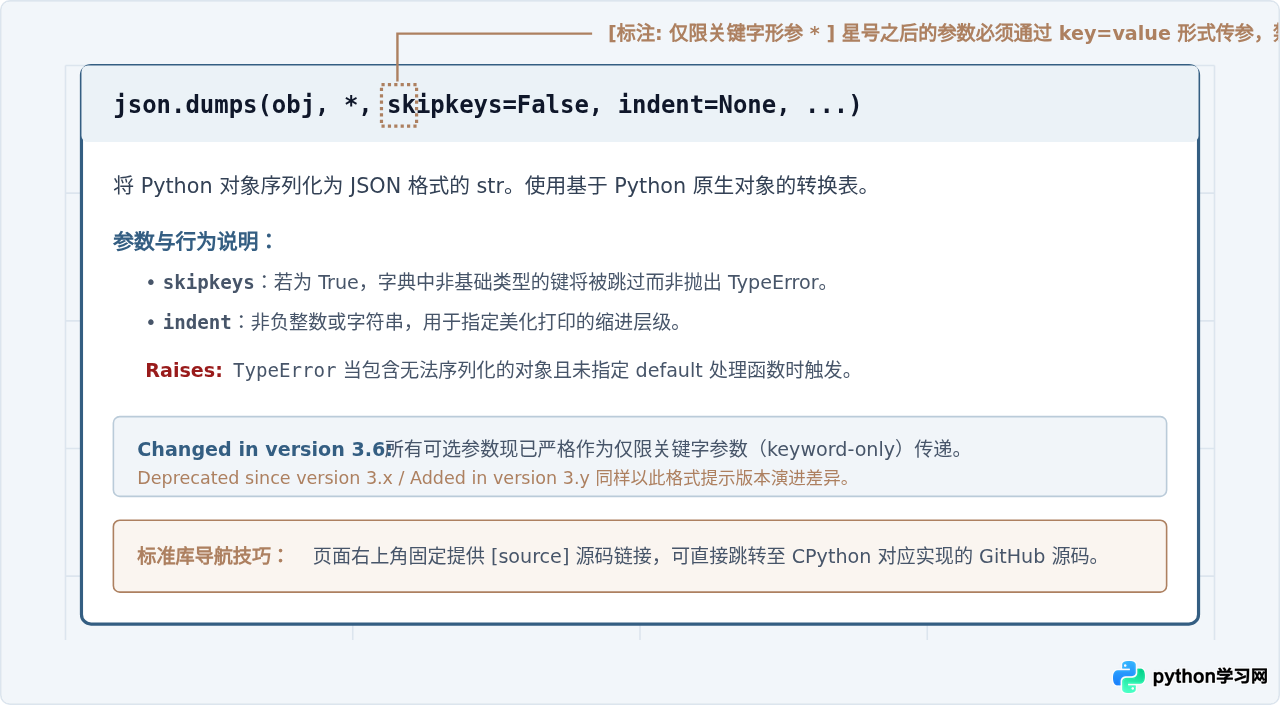
*(仅限关键字形参):星号之后的参数必须明确以键值对的形式传递。例如上图中的json.dumps(obj, *, skipkeys=False, ...),如果在调用时试图按位置给skipkeys传参(如json.dumps(data, True)),Python 会直接拦截并报错。
2. 仔细核对“Changed in version”与“Deprecated since”
在每个重要函数或类的正文下方,官方文档都会详细列出该条目的历史演化记录。例如:
New in version 3.9:表明该函数或该特性是 3.9 版本新引入的,若要在 3.8 环境运行则无法使用。Changed in version 3.11:标明此处调整了默认值、支持了额外的数据类型或优化了解析行为。Deprecated since version 3.12, will be removed in version 3.14:这是官方发出的废弃预警,说明已有替代方案,在编写新项目或长期维护工程时应立即停止使用旧 API。
避坑提示:在查阅 API 时,不要只看签名就关掉页面,至少向下扫视两段正文。许多方法在遇到非法输入时的抛错类型(例如触发 ValueError 还是 KeyError)以及在多线程环境下的安全性,都是在正文段落中特别说明的。
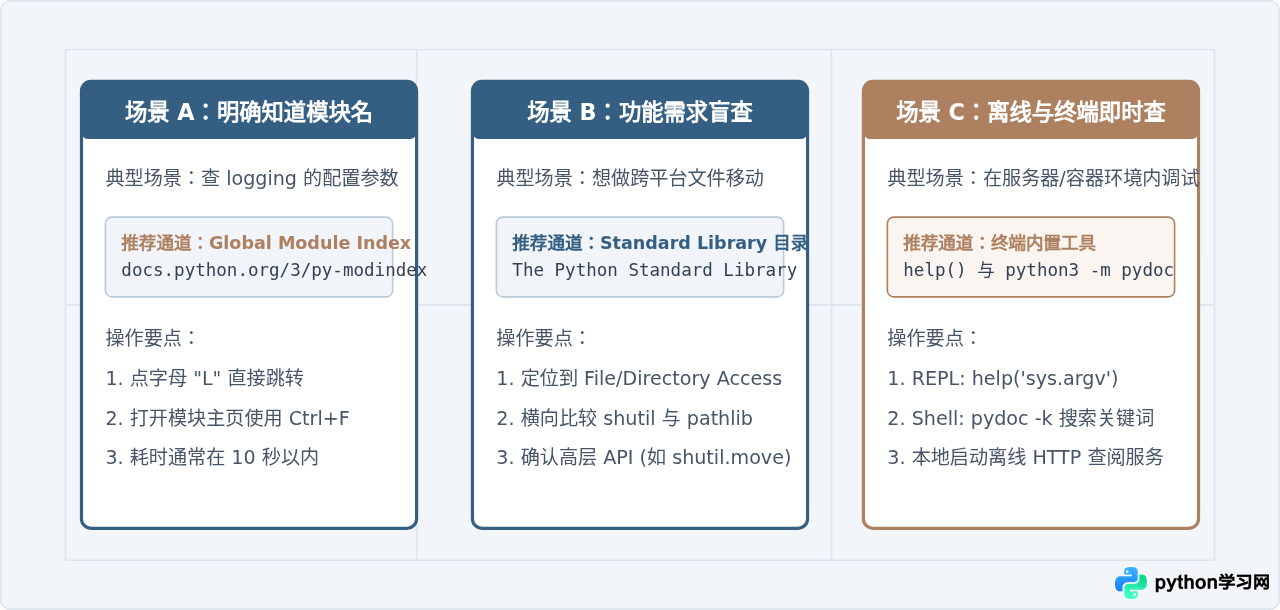
四、查阅全景决策:按查询场景选择最高效通道
为了让日常查阅形成肌肉记忆,可以将不同的查询需求归纳为以下决策流程:
五、高效查阅总结清单
将 Python 官方文档转化为实际生产力的关键,在于改变“遇事直接全局搜关键字”的习惯,建立层次化检索路径:
- 先选版本后看内容:进入文档页面时,第一眼看版本号,确保和实际执行环境相符。
- 优先使用直达通道:已知模块名直接用
Global Module Index;查语法底层原理进Language Reference;查内建类型与模块进入Library Reference。 - 细读函数原型符号:认清
[ ]代表可选、/代表仅限位置传参、*代表仅限关键字传参,避免低级的传参报错。 - 善用官方推荐示例与源码:每个标准库模块页面末尾都提供了丰富、符合官方最佳实践的完整代码段(Examples),遇到复杂配置或对象嵌套时,直接参考官方示例是避免歧义的最短路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















