


Python字典推导式:高效遍历与过滤取值技巧
深入解析Python字典推导式的核心语法、遍历构造方法与条件过滤取值技巧,结合内联架构图示与实战代码,帮助开发者写出高效优雅的Python数据处理逻辑。
在日常数据清洗与业务逻辑编写中,开发者经常需要基于既有数据快速生成、转换或筛选字典。Python 提供的字典推导式(Dictionary Comprehension)是一种用简洁语法在单行表达式内完成遍历、条件过滤和键值映射的内置机制,相比传统的 for 循环追加,它不仅代码紧凑,还在底层依托专用字节码实现了更高的执行效率。本文将系统拆解字典推导式的执行原理,重点演示遍历多源数据、精确条件过滤以及避免常见逻辑陷阱的实用技巧。
一、字典推导式的语法结构与执行流
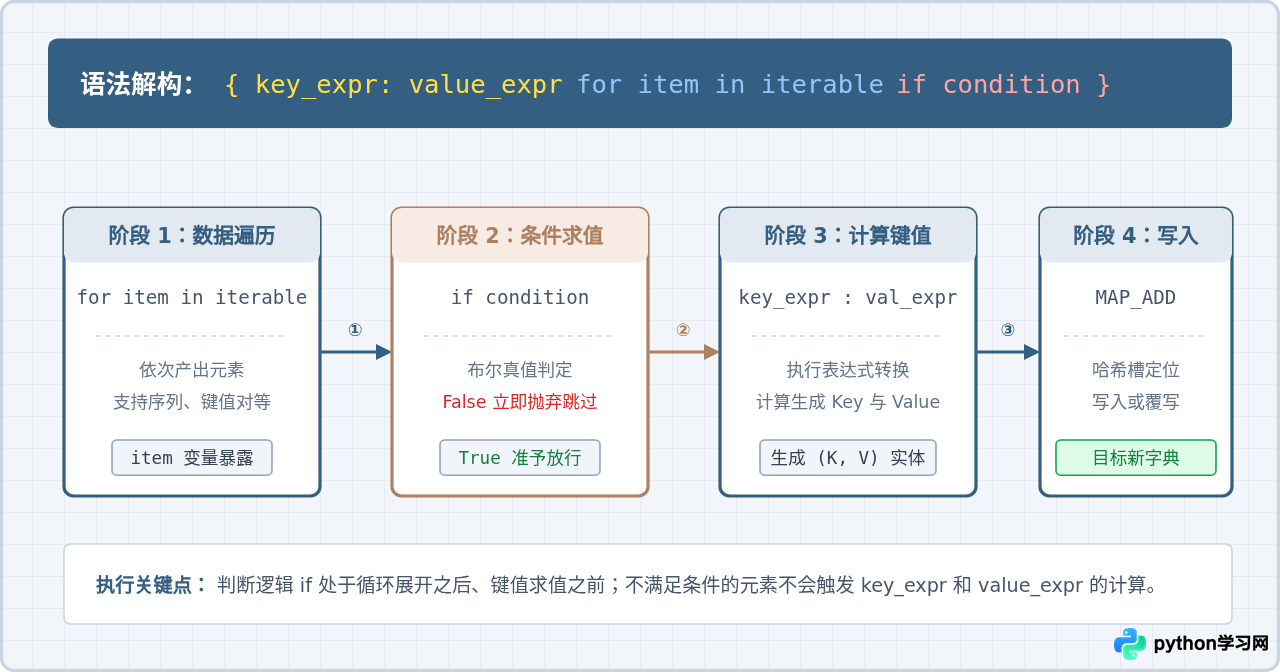
字典推导式由一对花括号 {} 包裹,核心包含三个组成要素:键值映射表达式、数据迭代来源以及可选的条件判断子句。其标准通用模板如下:
{key_expr: value_expr for item in iterable if condition}与传统的空字典初始化并配合 for 循环追加不同,字典推导式在底层执行时由 Python 解释器直接调用专用的字典构建字节码指令(如 BUILD_MAP 与 MAP_ADD),减少了在 Python 虚拟机层面反复调用 dict.__setitem__ 或 dict[k] = v 的属性查找开销。
为了直观展现该表达式的内在运转步骤,下图详细解构了推导式各个语法单元之间的衔接与流转顺序:
二、多源数据的高效遍历与构造技巧
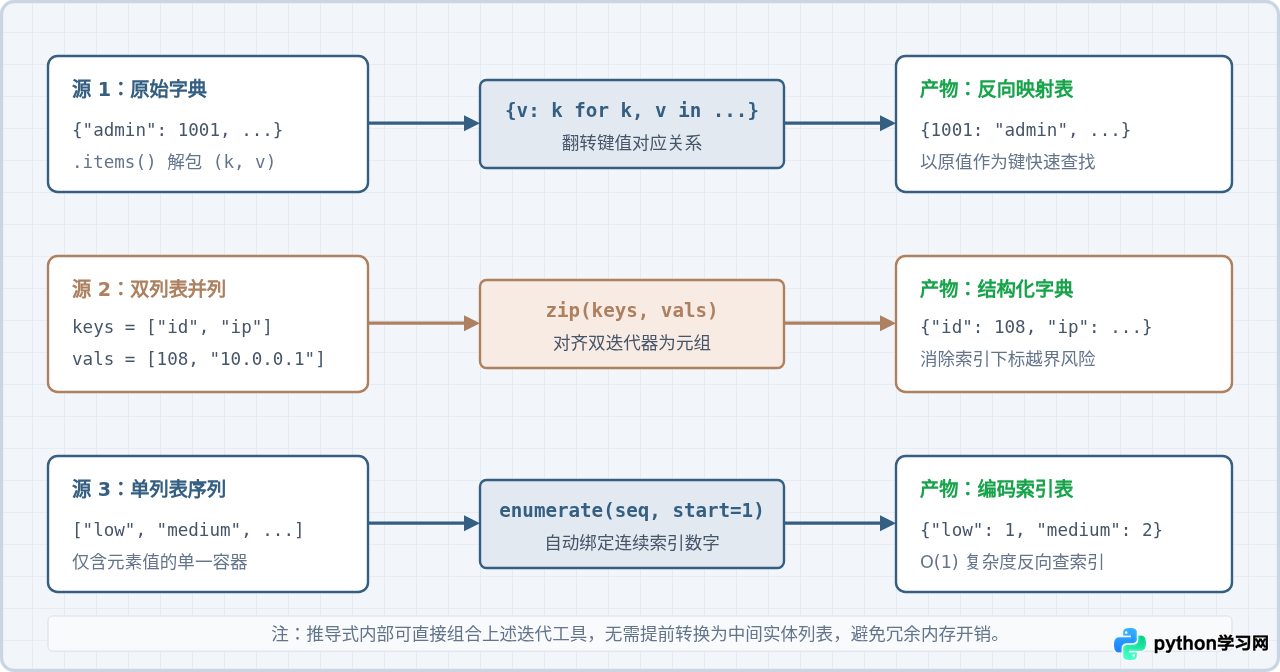
推导式不仅可以直接作用于单一列表,还可以针对不同类型的数据源,通过 Python 原生组合函数进行灵活高效的遍历。
1. 遍历既有字典:转换与翻转
处理既有字典时,最常见的做法是调用 .items() 方法同时解包键与值。例如在数据标准化过程中,常需要翻转键值对以建立反向索引,或者将所有字符串键统一格式化:
# 示例 1:字典键值对反转
role_codes = {"admin": 1001, "editor": 1002, "viewer": 1003}
code_to_role = {code: role for role, code in role_codes.items()}

# 示例 2:键名标准化处理
raw_headers = {"Content-Type": "application/json", "User-Agent": "Python3"}
clean_headers = {k.lower().replace("-", "_"): v for k, v in raw_headers.items()}code_to_role -> {1001: 'admin', 1002: 'editor', 1003: 'viewer'}clean_headers -> {'content_type': 'application/json', 'user_agent': 'Python3'}
2. 双序列合并构造:结合 zip()
当拥有两个平行的序列(如分离的表头和数据行、ID列表与名称列表)时,手动按索引遍历容易引发 IndexError。使用 zip() 与字典推导式配合,可以在保证长度对齐的同时直接生成结构化字典:
keys = ["server_id", "ip_address", "region", "status"]
values = [108, "192.168.1.50", "cn-north-1", "active"]

server_info = {k: v for k, v in zip(keys, values)}server_info -> {'server_id': 108, 'ip_address': '192.168.1.50', 'region': 'cn-north-1', 'status': 'active'}
3. 索引与序列枚举构造:结合 enumerate()
在建立字典映射表或位置查找缓存时,使用 enumerate() 能快速在元素与序号之间建立双向关系:
priorities = ["low", "medium", "high", "critical"]
priority_map = {name: rank for rank, name in enumerate(priorities, start=1)}priority_map -> {'low': 1, 'medium': 2, 'high': 3, 'critical': 4}
下图展示了不同数据输入方式经由推导式映射为目标字典的流向通道:
三、过滤取值与条件分支实战技巧
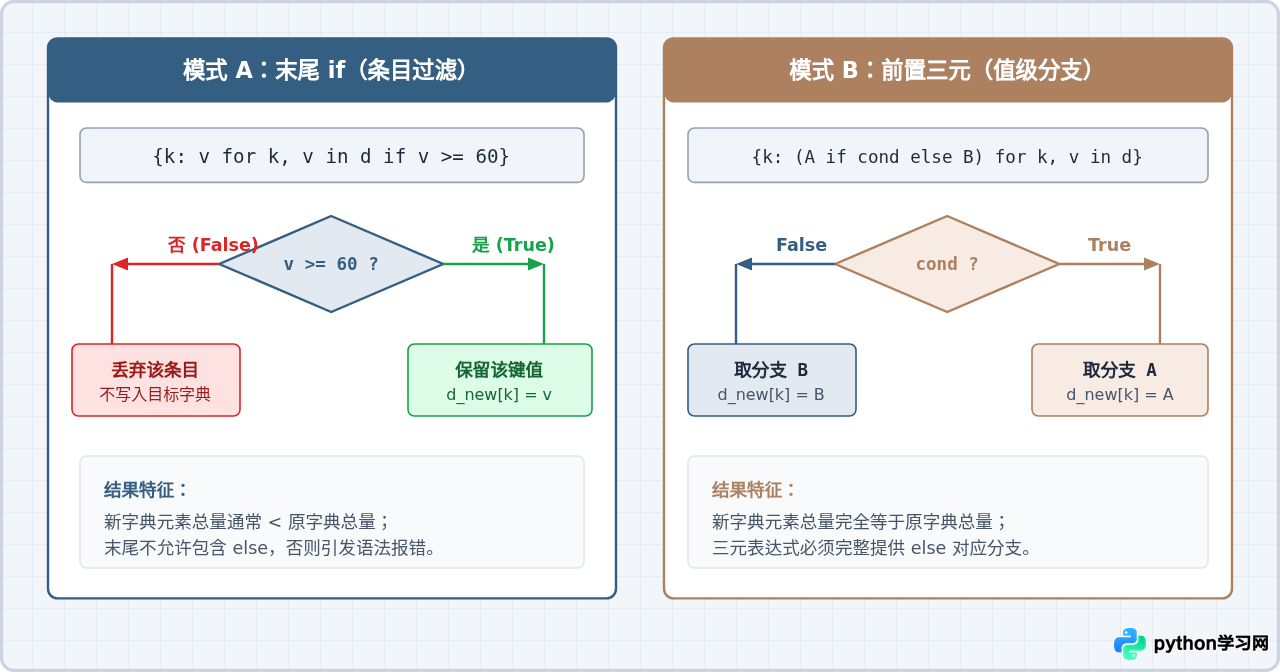
推导式强大的地方在于其过滤和选择能力。在日常业务中,开发者通常面临两类需求:一是过滤筛选(丢弃不满足条件的键值对),二是分支转换(所有键均保留,但根据条件修改其对应的值)。
1. 末尾 if 子句:条目级过滤
置于推导式末尾的 if condition 决定了当前元素是否被写入新字典。只要条件计算结果为假值(如 False、None、0 或空容器),整个键值对都会被抛弃:
# 筛选分数达到及格线且已提交的学生
test_scores = {"Alice": 85, "Bob": 56, "Charlie": 92, "David": 45, "Eva": 78}

passed_students = {name: score for name, score in test_scores.items() if score >= 60}passed_students -> {'Alice': 85, 'Charlie': 92, 'Eva': 78}
2. 复合逻辑与数据清洗过滤
在清洗接口返回的脏数据时,可以通过 and、is not None 以及类型校验组合过滤条件:
raw_payload = {
    "metric_cpu": 45.2,
    "metric_mem": None,
    "debug_tag": "test_env",
    "metric_disk": 78.0,
    "invalid_entry": ""
}

# 仅保留键以 "metric_" 开头且数值不为空的监控指标
clean_metrics = {
    k: v for k, v in raw_payload.items()
    if k.startswith("metric_") and v is not None and isinstance(v, (int, float))
}clean_metrics -> {'metric_cpu': 45.2, 'metric_disk': 78.0}
3. 前置三元表达式:值级分支映射
若需求是“保留所有键,但对于特定条件的值进行缺省值填充或加工转换”,则必须使用 三元运算符(Ternary Operator)。三元运算应写在冒号之后的值表达式区域,而非末尾:
# 将低于 60 的分数标记为 "Needs Improvement",其余保持 "Passed"
score_status = {
    name: ("Passed" if score >= 60 else "Needs Improvement")
    for name, score in test_scores.items()
}score_status -> {'Alice': 'Passed', 'Bob': 'Needs Improvement', 'Charlie': 'Passed', 'David': 'Needs Improvement', 'Eva': 'Passed'}
许多初学者容易混淆“末尾过滤 if”与“前置三元 if...else”的语义与语法位置。下图直观展示了这两者的执行分流差异:
四、关键细节与边界避坑指南
推导式虽然精炼,但在处理复杂边界情况时若缺乏审慎设计,容易产生难以察觉的隐蔽 Bug。以下是必须重点把控的工程要点:
1. 键名冲突与后值覆盖陷阱
在 Python 字典规范中,键名具备唯一性。如果在推导式计算过程中产生重复的键,后产生的键值对会无条件覆盖之前的数据。这在反转非一对一映射的字典时尤为常见:
# 错误示例:部门与员工为一对多关系
dept_map = {"Alice": "Tech", "Bob": "Tech", "Charlie": "HR"}

# 试图反转将部门作为键,导致员工丢失
inverted_dept = {dept: name for name, dept in dept_map.items()}inverted_dept -> {'Tech': 'Bob', 'HR': 'Charlie'} # Alice 的数据被静默覆盖丢弃!
若需要处理一对多映射,应放弃使用简单的推导式赋值,转为使用 collections.defaultdict(list) 进行分组收集:
from collections import defaultdict

grouped_dept = defaultdict(list)
for name, dept in dept_map.items():
    grouped_dept[dept].append(name)
2. 嵌套推导式与可读性边界
推导式支持多层 for 循环嵌套,例如展平包含分类的树状数据。但 Python 核心哲学提倡“扁平优于嵌套(Flat is better than nested)”,一旦嵌套超过两层,推导式将极度晦涩难以维护:
matrix = {
    "group_a": {"x": 1, "y": 2},
    "group_b": {"x": 10, "y": 20}
}

# 展开两层结构:生成复合键名
flat_matrix = {
    f"{grp}_{k}": v
    for grp, sub_dict in matrix.items()
    for k, v in sub_dict.items()
}flat_matrix -> {'group_a_x': 1, 'group_a_y': 2, 'group_b_x': 10, 'group_b_y': 20}
for 循环,避免在一行内堆叠复杂状态。
3. 异常处理的局限性与函数封装
推导式语法不允许在内部直接书写 try...except 语句块。当遍历的数据源可能含有格式异常或非法类型(例如需对字符串进行类型转换)时,直接解析会抛出异常中断执行:
# 安全处理模式:借助辅助解析函数屏蔽异常
def safe_int_convert(value, default=0):
    try:
        return int(value)
    except (ValueError, TypeError):
        return default

raw_strings = {"a": "100", "b": "invalid_num", "c": None, "d": "45"}
safe_parsed = {k: safe_int_convert(v) for k, v in raw_strings.items()}safe_parsed -> {'a': 100, 'b': 0, 'c': 0, 'd': 45}
下图总结了在决定是否采用字典推导式时的工程技术选型路径:
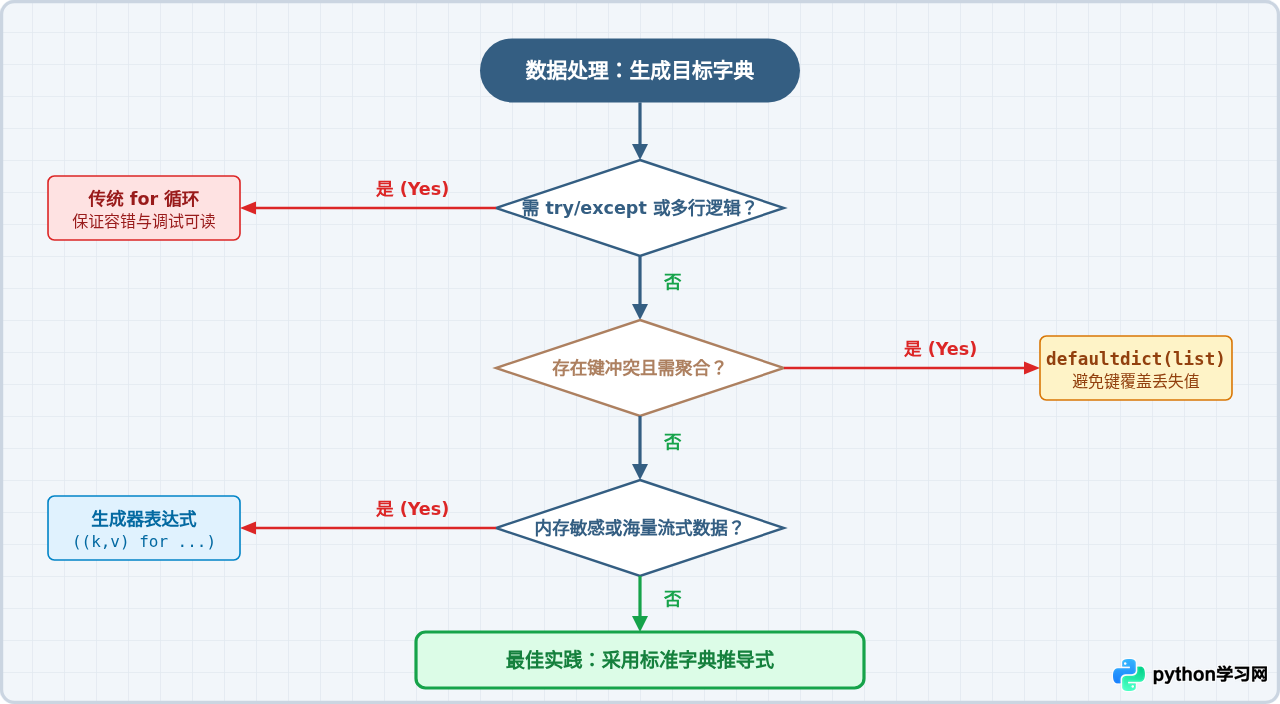
五、核心语法模式速查表
为了便于日常编码快速参考,下表汇总了最常用的推导式编写模式及其应用场景:
| 应用场景 | 典型代码模板 | 关键注意事项 |
|---|---|---|
| 基础键值变换 | {k.upper(): v * 2 for k, v in d.items()} |
同时遍历键值对时必须调用 .items()。 |
| 条件条目过滤 | {k: v for k, v in d.items() if condition} |
末尾 if 仅做布尔判定,不可附加 else。 |
| 缺省分支赋值 | {k: (v if v else default) for k, v in d.items()} |
三元表达式位于冒号右侧,必须显式包含 else。 |
| 双序列配对 | {k: v for k, v in zip(keys, vals)} |
自动截断至较短序列长度;如需保留全部可使用 itertools.zip_longest。 |
| 序列索引绑定 | {item: idx for idx, item in enumerate(seq)} |
可指定 start 起始偏移量,常用于构建快速反向查找字典。 |
掌握字典推导式不仅能显著缩减代码篇幅,更能借助 Python 底层的字节码优化提升执行性能。在实际应用中,合理结合 zip 与 enumerate 等迭代工具,并清晰区分“末尾条目过滤”与“前置分支赋值”的语义边界,便能在保持代码清晰易读的同时,构建出既健壮又高效的数据转换管道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















