


生产环境Python定时任务选型:APScheduler对比Celery Beat
深度对比Python主流定时任务方案APScheduler与Celery Beat,从架构原理、多实例部署、动态调度、失败重试与运维成本等维度剖析优劣,并提供生产落地配置与决策路径。
在生产环境中为 Python 应用程序选定定时任务方案时,工程师面对的核心权衡并不是语法习惯,而是任务调度与任务执行是否需要物理隔离,以及系统是否具备常态化运行的异步消息中间件底座。简而言之,如果定时任务属于应用内部轻量维护工作、需要频繁通过 API 动态增删任务,或者部署环境属于资源有限的单体服务,轻量直接的 APScheduler 是最易维护且开销最低的路径;若任务本身耗时长、并发压力高、整个服务采用容器化多副本集群部署,或者业务线本身已深度使用 Celery 进行异步解耦,那么采用 Celery Beat 搭配专用 Worker 集群则是保障生产高可用与容错重试的工业级标准方案。
一、架构设计与执行流转的本质差异
很多开发者在技术选型初期容易将 APScheduler 与 Celery Beat 归为同类竞品,但两者的内部架构设计和职责边界有着根本区别。理解这一底层机制是规避后续生产故障的关键。
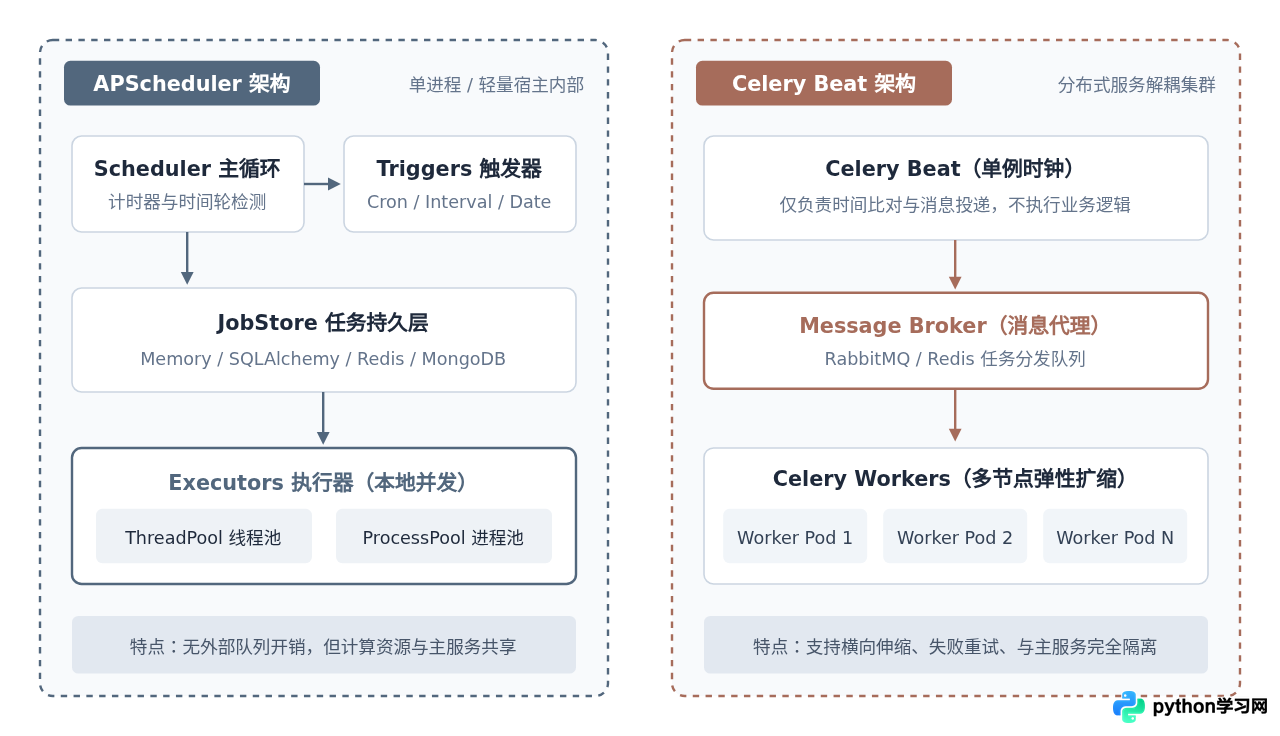
APScheduler(Advanced Python Scheduler)是一个典型的进程内或轻量外部协作调度框架。它的运行核心主要由四部分构成:Triggers(触发器,计算下一次运行时间点)、Job Stores(任务持久化存储,如 Memory、SQLAlchemy、Redis 或 MongoDB)、Executors(任务执行器,将任务分发给 ThreadPoolExecutor、ProcessPoolExecutor 或 AsyncIO 事件循环)以及 Schedulers(统一协调调度循环的控制器)。在标准运行模式下,调度逻辑与实际业务执行代码运行在同一个宿主服务进程内,任务到期后由本地线程池直接提取并执行,整个流程紧密闭环。
与此相对,Celery Beat 本质上并不是一个“任务执行器”,而是一个专门的“定时事件发射器”。Celery 遵循严格的分布式消息队列范式,Beat 进程唯一的工作就是按照预定时刻表检查定时规则,一旦命中时间点,就生成一条包含任务名称与参数的消息,将其推入消息代理(Message Broker,例如 RabbitMQ 或 Redis)。真正的任务计算与 IO 执行则由独立的 Celery Worker 进程集群拉取处理,完成后再将状态记录至结果存储后端(Result Backend)。调度节点与执行节点完全解耦,两者甚至运行在不同的物理机器或容器规格上。
二、生产环境关键维度的对比与权衡
脱离具体的业务指标去讨论好坏往往没有意义。在生产环境中,选型决策通常需要围绕以下五个硬性维度展开。
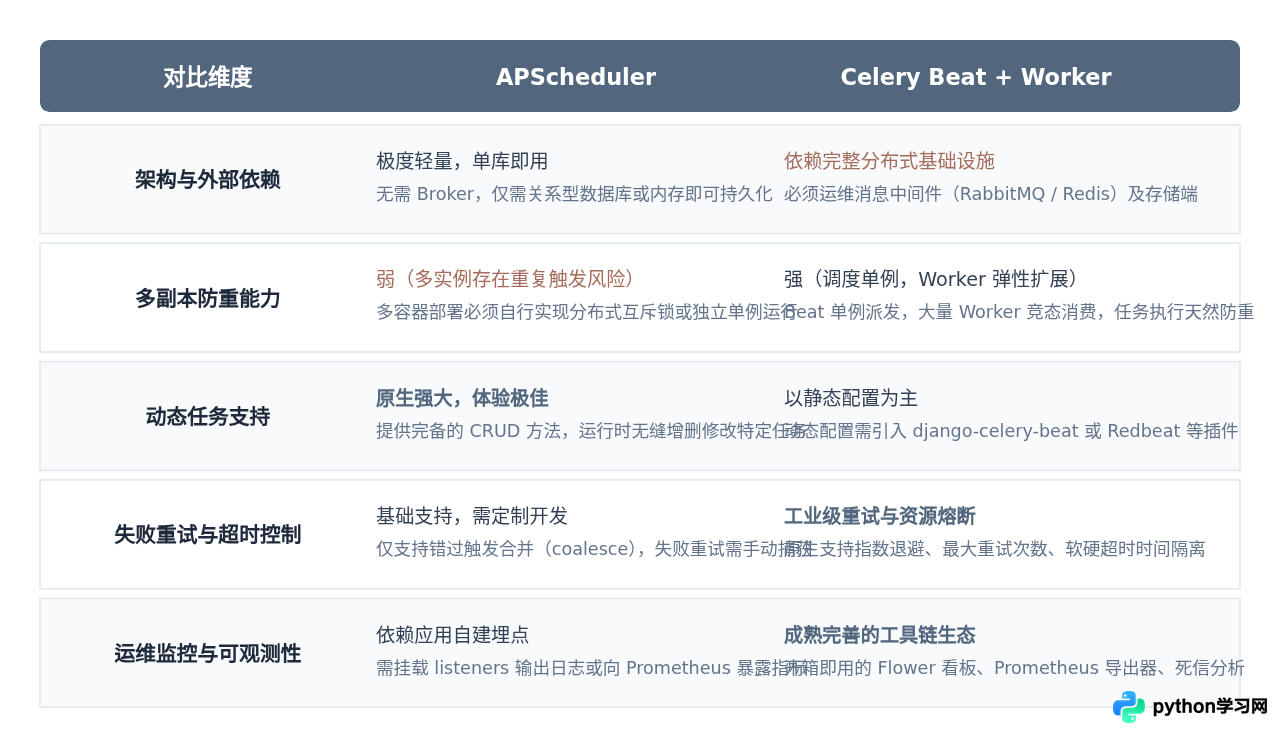
1. 容器多副本部署与防重复执行(重中之重)
现代生产系统大多运行在 Kubernetes 或容器编排平台中,应用通常配置了多副本(ReplicaCount ≥ 2)以实现高可用。此时两者的表现大相径庭:
- APScheduler 的重复触发陷阱:如果直接将 APScheduler 嵌入在 Web 服务内部(例如在 FastAPI 或 Django 启动钩子中初始化),当服务横向扩容至 5 个 Pod 时,每个 Pod 都会启动一个独立的调度器循环。到了指定时刻,5 个 Pod 会在同一秒并发执行同一项定时任务。如果该任务涉及账单扣款、邮件群发或库存核销,将引发严重的业务灾难。为了规避这个问题,必须通过分布式排他锁(如基于 Redis 的 SETNX / Redlock)在任务执行前加锁,或者将 APScheduler 剥离为独立的单副本 Deployment。
- Celery Beat 的天然分工:Celery 架构中,Worker 节点可以水平扩容数十甚至数百个,互相竞争消费队列中的任务。只要确保 Celery Beat 调度器是作为独立的单实例容器运行(例如通过 K8s Deployment 的 replicas: 1 配置),无论后端 Worker 如何扩缩容,任务永远只会被派发一次,并且能够自动被空闲节点消费,天然具备防重复与负载均衡能力。
2. 动态任务增删改查能力
业务对“动态性”的需求是选型的重要分水岭:
- APScheduler 优秀的动态接口:APScheduler 原生设计就考虑了动态维护,提供了
add_job、remove_job、modify_job、pause_job等完备的 Python API。配合 SQLAlchemyJobStore,当运营后台新增一个“用户自定义每日提醒”时,直接调用 API 即可写入数据库持久化,运行中的调度器在下一个刷新周期内会自动加载新任务,无需重启任何进程。 - Celery Beat 的静态倾向:原生 Celery 默认使用静态文件
beat_schedule配置任务,修改任务通常需要重新部署或重启 Beat 进程。虽然社区提供了django-celery-beat(基于 Django ORM)或celery-redbeat(基于 Redis),支持在外部存储中动态修改任务,但引入了额外的维护复杂度,且动态更新时延与存储同步机制不如 APScheduler 纯粹。
3. 任务隔离与系统稳定性
当定时任务涉及耗时数分钟的复杂报表导出或大规模网络请求时,隔离性直接决定了系统底线:
- APScheduler 的资源挤占风险:由于默认基于线程池或子进程池,如果短时间内大量任务被触发或某个外部接口发生超时挂起,很容易耗尽宿主线程池资源,严重时甚至导致宿主 Web 接口无响应或触发 OOM(内存溢出)。
- Celery 的沙箱化执行:Beat 仅仅投递一条轻量 JSON 消息,耗时不到 2 毫秒。复杂的计算被封装在 Broker 消息后交由独立的工作节点运行,即便某个 Worker 发生内存泄露崩溃或超时被强制终止(配合
time_limit参数),调度器和其他业务容器依然完好无损。
4. 监控、可观测性与重试机制
生产环境不可避免会遇到偶发性网络闪断或数据库死锁。Celery 拥有成熟的企业级治理生态:支持原生任务重试(可配置 autoretry_for、最大重试次数与指数退避延迟),并具备成熟的 Web 监控套件 Flower,可实时查看任务吞吐量、执行耗时、成功率与堆积情况。而 APScheduler 原生只提供基础的事件监听机制(如监听 EVENT_JOB_ERROR),若要实现自动重试、告警通知或看板监控,团队必须编写定制代码进行二次开发。
三、生产环境落地实施与部署步骤
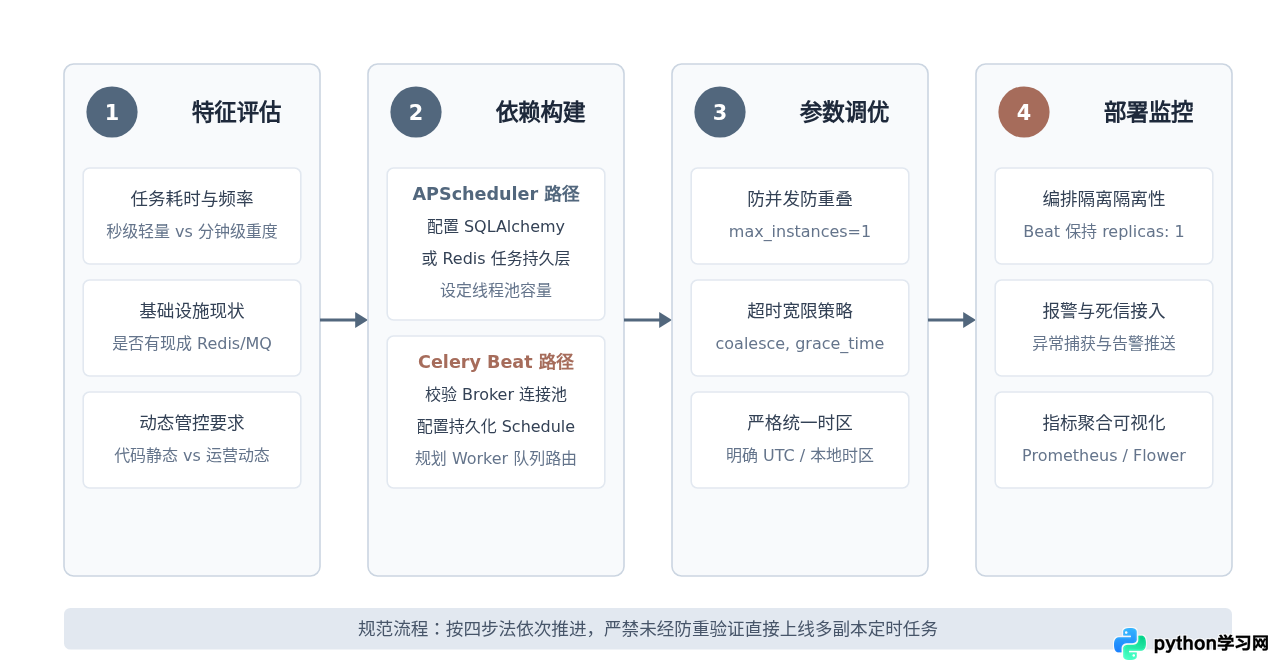
为了让选型能够切实落地,下面分别给出两种技术在生产环境中的工程实施范式与核心代码配置。
方案 A:APScheduler 生产级稳健配置范式
在生产环境中运行 APScheduler,切忌使用默认的 MemoryJobStore,因为应用一旦重启或升级,未完成或未来的任务排期都会全部丢失。推荐使用持久化存储(如 PostgreSQL/MySQL 或 Redis),并搭配全局优雅关闭钩子:
import logging
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.jobstores.sqlalchemy import SQLAlchemyJobStore
from apscheduler.executors.pool import ThreadPoolExecutor
from apscheduler.events import EVENT_JOB_ERROR, EVENT_JOB_EXECUTED
from pytz import timezone

logger = logging.getLogger("apscheduler_prod")

# 1. 持久化存储与并发执行器配置
jobstores = {
    'default': SQLAlchemyJobStore(url='postgresql://user:pass@127.0.0.1:5432/app_db')
}
executors = {
    'default': ThreadPoolExecutor(max_workers=20)
}
job_defaults = {
    'coalesce': True,             # 积压任务自动合并,避免服务宕机恢复后的突发雪崩
    'max_instances': 1,           # 核心防并发配置:同一任务在同一时刻只能有1个实例在执行
    'misfire_grace_time': 60      # 错过触发时间60秒内允许补跑,超期则跳过
}

scheduler = BackgroundScheduler(
    jobstores=jobstores,
    executors=executors,
    job_defaults=job_defaults,
    timezone=timezone('Asia/Shanghai')
)

# 2. 生产事件监听器(替代缺失的监控看板)
def job_listener(event):
    if event.exception:
        logger.error(f"任务执行异常: JobID={event.job_id}, 异常信息: {event.exception}")
    else:
        logger.info(f"任务正常完成: JobID={event.job_id}, 耗时={event.retval}")

scheduler.add_listener(job_listener, EVENT_JOB_ERROR | EVENT_JOB_EXECUTED)

# 3. 注册定时任务
def daily_sync_task():
    # 具体的轻量同步逻辑
    pass

scheduler.add_job(
    daily_sync_task,
    trigger='cron',
    hour=2,
    minute=30,
    id='daily_sync_job',
    replace_existing=True
)

# 启动调度器
scheduler.start()
方案 B:Celery Beat 生产解耦配置范式
在 Celery 生态中,生产环境要求将定时任务定义与执行彻底拆分为两个独立的进程。首先在统一配置文件中声明:
# celery_app.py
import os
from celery import Celery
from celery.schedules import crontab

os.environ.setdefault('CELERY_CONFIG_MODULE', 'celery_config')

app = Celery('prod_tasks')
app.conf.update(
    broker_url='redis://:redis_password@127.0.0.1:6379/1',
    result_backend='redis://:redis_password@127.0.0.1:6379/2',
    timezone='Asia/Shanghai',
    enable_utc=False,                       # 统一本地时区调度
    task_serializer='json',
    accept_content=['json'],
    result_serializer='json',
    task_time_limit=300,                    # 硬超时5分钟,超时强制终止Worker进程
    task_soft_time_limit=240,               # 软超时4分钟,触发SoftTimeLimitExceeded异常
    worker_prefetch_multiplier=1,           # 避免长任务场景下的调度堆积
)

# 静态定时任务时刻表
app.conf.beat_schedule = {
    'process-order-reconciliation-every-night': {
        'task': 'tasks.orders.reconcile_daily_orders',
        'schedule': crontab(hour=1, minute=0),
        'options': {'queue': 'heavy_reports'}, # 路由到重计算专用队列
    },
}
在容器化编排中,启动命令必须明确分开,严禁在同一个容器内使用 celery -B 同时启动 Worker 和 Beat:
# 容器A(只启动单实例 Beat 调度器,负责派发):
celery -A celery_app.app beat --loglevel=info -s /var/run/celery/celerybeat-schedule

# 容器B(水平扩容多个 Worker,负责具体计算执行):
celery -A celery_app.app worker --loglevel=info -Q heavy_reports --concurrency=4
四、生产高频踩坑与应对策略
避坑 1:时区配置不一致导致的深夜任务白天跑
Celery 默认开启 enable_utc = True,而很多开发者的 crontab 按本地时区(如 UTC+8)编写,如果不显式设置 timezone = 'Asia/Shanghai' 且关闭 enable_utc,定时任务将会延后或提前 8 小时触发。APScheduler 同样要求在 Scheduler 初始化时传入统一的 timezone,禁止依赖宿主机的默认环境变量。
避坑 2:长任务阻塞导致的调度雪崩
在 APScheduler 中,如果某个任务耗时超过了触发间隔(例如每隔 10 秒跑一次,但单次执行花了 30 秒),若未设置 max_instances=1,执行器会不断开启新线程并发运行,导致线程与数据库连接池迅速被占满;若未设置 coalesce=True,在系统偶发停机 10 分钟恢复后,累积的 60 次任务会瞬间全部触发,造成下游数据库击穿。
避坑 3:Celery Beat 状态文件冲突
Beat 在运行时会维护一个本地的调度快照文件(celerybeat-schedule)。如果将该状态文件存放在宿主机共享挂载目录,且由于部署配置失误导致运行了两个 Beat 容器,两者同时读写同一文件会导致严重锁冲突与任务双发。正确的做法是状态文件存放在容器本地临时目录,并通过 Kubernetes Deployment 强制限制 replicas: 1。
五、选型决策树与最终建议
技术选型不存在绝对的优劣,只有与业务规模、架构演进阶段的高度契合。通过以下清晰的判断分支,团队可以快速得出确定性选型:
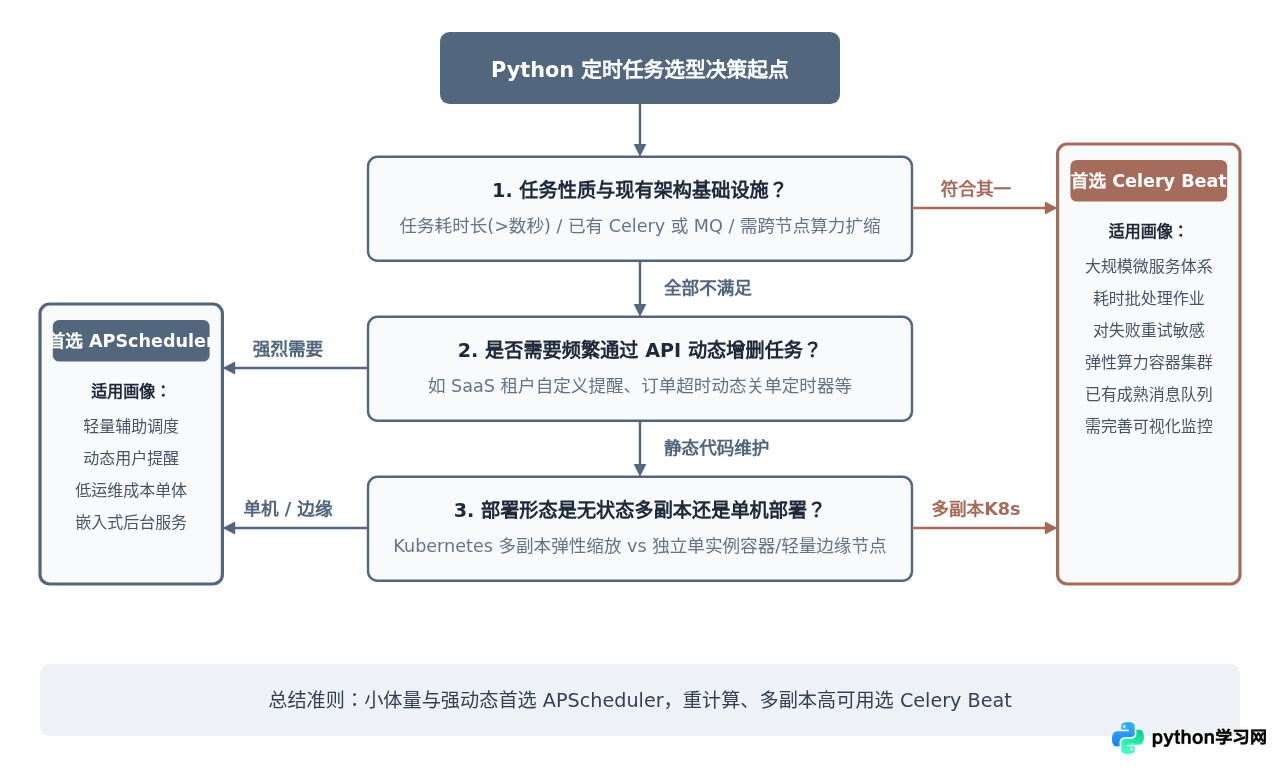
综上所述,技术方案没有优劣之分,关键在于能否与当前系统的生产架构无缝咬合。通过清晰划分调度与执行的边界,合理治理多副本下的防重互斥,团队便能在保证业务高可用的前提下,找到开销与稳定性的最佳平衡点。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















