


Python函数与模块怎么写?自学进阶必须掌握的代码组织技巧
系统讲解自学Python过程中如何编写规范的函数与模块,涵盖函数设计原则、模块拆分、导入路径与__name__控制技巧,帮助初学者跨越脚本阶段,掌握清晰可靠的代码组织方法。
很多初学者在自学 Python 时,往往习惯从头到尾在一个 .py 脚本里写满线性执行的代码,随着业务逻辑增加,变量互相覆盖、调试困难、复制粘贴代码等问题接踵而至。编写清晰的函数与拆分模块,是跨越“单脚本练习”迈向“项目化工程”的核心跳板。本文将直接从函数设计的核心约束切入,逐步演示从单文件逻辑提炼为独立模块并正确导入的具体步骤,梳理工程代码组织的实用技巧。
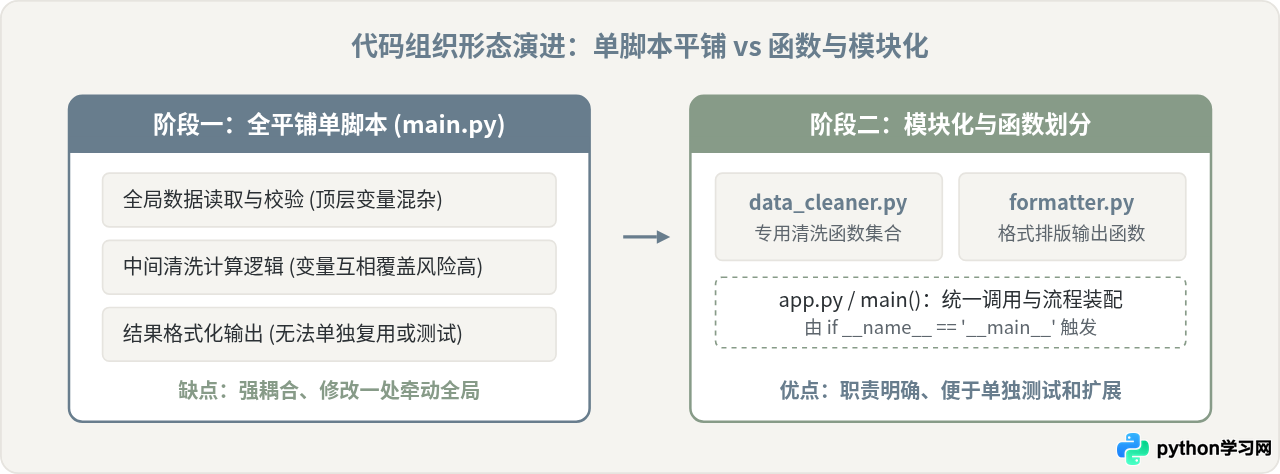
一、为什么线性脚本需要重构为函数
在开始写函数前,需要建立一种“逻辑封装”的直觉。线性脚本将所有数据和逻辑直接暴露在顶层作用域,不仅每次执行都必须从上跑到底,而且中间变量名极易冲突。将可重复或具有单一目的的计算封装成函数,核心目的是界定职责、控制副作用并实现参数化输入。
二、写好 Python 函数的三个底线要求
编写函数不是简单把几行代码前面加上 def。自学进阶的关键在于理解参数传递、返回值以及作用域的边界控制。以下是编写规范函数的三个核心准则:
1. 单一职责与明确返回值
一个函数只做一件事。例如一个函数负责“解析文本中的数字”,另一个函数负责“统计总和”,切勿在一个函数里既读文件、又计算、还直接用 print() 输出。尽量使用 return 产出计算结果,将输出方式(打印到控制台还是写入日志)交给上层调用者决定。
2. 严禁使用可变对象作为默认参数
初学者容易犯的典型错误是在参数默认值中直接指定列表或字典(例如 def add_item(item, box=[]))。Python 的函数定义在模块加载时只执行一次,默认参数属于函数对象的持久属性。如果使用列表等可变对象,多次调用会共享同一个容器,导致状态污染。推荐做法是使用 None 作为哨兵值:
# 推荐做法:使用 None 作为默认值,在函数体内部新建独立对象
def collect_score(score: float, history: list = None) -> list:
    if history is None:
        history = []
    history.append(score)
    return history
3. 添加类型注解与说明文档(Docstring)
从 Python 3.5 起内置类型提示,配合清晰的文档字符串,能让调用方不需要逐行翻查实现代码即可明白输入期望与产出格式:
def calculate_discount(price: float, rate: float = 0.9) -> float:
    """计算折后价格。

    :param price: 原始价格,必须为非负浮点数
    :param rate: 折扣比例,范围在 0 到 1 之间,默认 0.9
    :return: 折后计算金额,保留两位小数
    """
    if price < 0 or not (0 < rate <= 1):
        raise ValueError("价格或折扣率参数无效")
    return round(price * rate, 2)
三、从单个函数到模块拆分的操作步骤
在 Python 中,每一个以 .py 结尾的文件都是一个独立的模块(Module)。当函数数量增多、职责开始出现分化时,就需要将它们拆分到独立模块中。
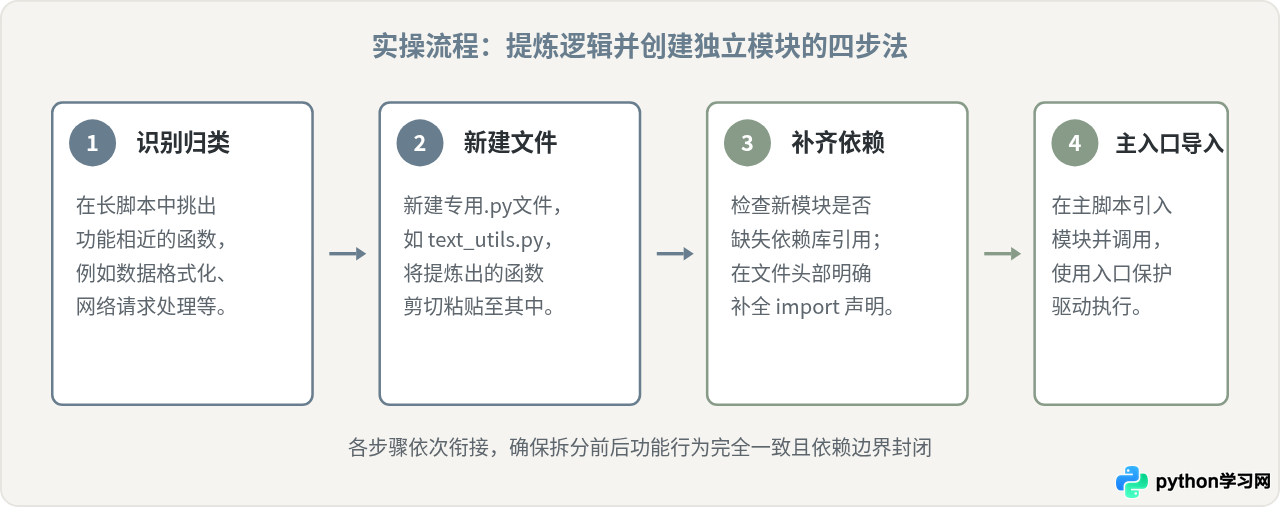
以下通过一个微型项目结构展示实际落地代码。假设目录结构如下:
my_project/
│
├── text_cleaner.py     # 独立功能模块:存放纯函数
└── main.py             # 程序主入口:装配流程并执行
第一步:编写模块 text_cleaner.py
# text_cleaner.py
"""文本清洗与统计专用模块"""

def remove_punctuation(text: str) -> str:
    """去除常见标点符号"""
    symbols = ",.!?,。!?;;\"' "
    for char in symbols:
        text = text.replace(char, "")
    return text

def count_words(text: str) -> int:
    """计算清洗后的字符总数"""
    cleaned = remove_punctuation(text)
    return len(cleaned)
第二步:在 main.py 中引入并使用
# main.py
"""主入口执行脚本"""
import text_cleaner

def main():
    raw_message = "你好,世界!Python 让代码组织更高效。"
    cleaned = text_cleaner.remove_punctuation(raw_message)
    total = text_cleaner.count_words(raw_message)

    print(f"清洗后文本: {cleaned}")
    print(f"有效字符总数: {total}")

if __name__ == "__main__":
    main()
四、关键差异对比:两种模块导入方式的区别
在 Python 中,引入模块通常有两种写法:import module_name 与 from module_name import function_name。初学者常以为两者只是字面长短的区别,但在命名空间隔离与代码可读性上存在显著不同。
| 对比维度 | import 完整模块名 | from 模块名 import 函数名 |
|---|---|---|
| 语法示例 | import text_cleaner调用: text_cleaner.count_words() |
from text_cleaner import count_words调用: count_words() |
| 命名空间影响 | 仅在当前作用域注册一个模块变量名,不会污染当前命名空间。 | 直接将函数名载入当前作用域,若当前文件有同名函数会发生覆盖。 |
| 代码可读性 | 极高。调用处一眼看出该函数来自哪个模块,定位清晰。 | 较简洁,但在大型项目中容易看不出函数究竟是本文件定义还是外部引入。 |
| 循环导入容忍度 | 相对较高,在运行时只要访问属性时不形成死锁即可。 | 较低,在加载执行该语句瞬间就要求对应名字已就绪,更易引发错误。 |
import module_name 或为较长的模块起简短别名 import text_cleaner as tc。这能时刻提醒自己代码来自何处,避免因同名函数引发难以排查的命名覆盖 Bug。绝对禁止使用 from module import * 通配符导入。
五、理解 if __name__ == "__main__" 的底层机制
每个自学 Python 的人都会遇到 if __name__ == "__main__",但往往只把它当成固定的样板代码复制粘贴。要真正掌握模块组织,必须理解其背后的 Python 导入机制。
当 Python 解释器运行一个文件时,会在执行任何代码之前设置一些内置变量,其中 __name__ 就是当前模块的标识符:
- 如果该文件是直接在终端被启动的入口文件(例如执行
python main.py),Python 会将该文件的__name__赋值为字符串"__main__"。 - 如果该文件是被其他文件通过
import引入的,Python 会将该文件的__name__赋值为其真实文件名(如"text_cleaner")。
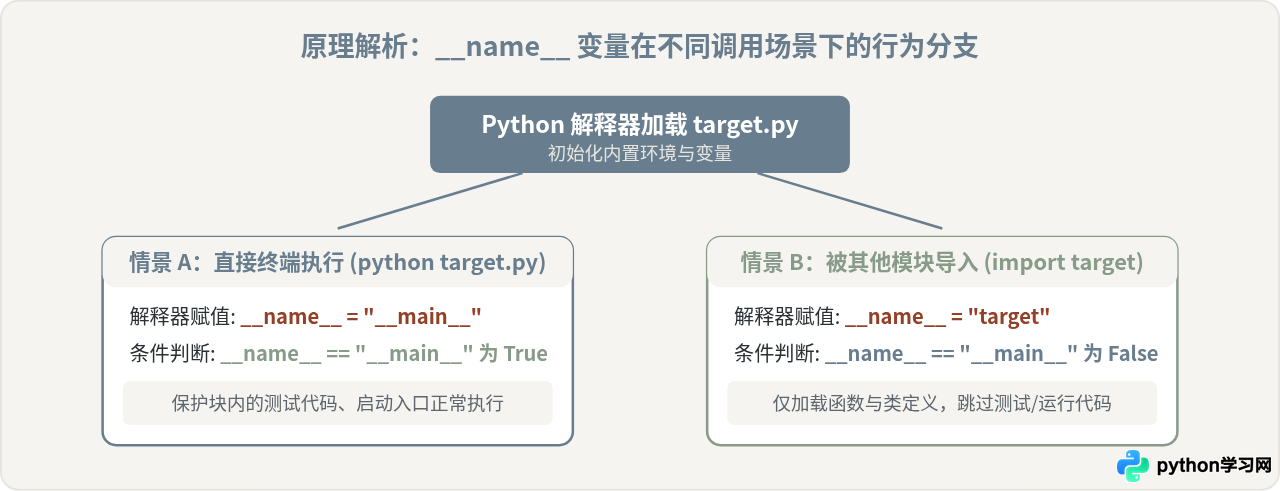
这意味着:当你写完一个功能模块后,完全可以在文件末尾加上 if __name__ == "__main__": 编写自测代码。在直接运行该文件时,可以方便地测试各个函数;而当其他主程序导入该模块时,这些测试语句绝不会被自动触发,既保证了模块独立调试的便利,又避免了产生副作用。
六、自学进阶代码组织总结
从随意写脚本到能够自如地搭建模块化项目,本质是掌握软件工程中“高内聚、低耦合”的思维。在日常写代码时,建议遵循以下组织自检闭环:
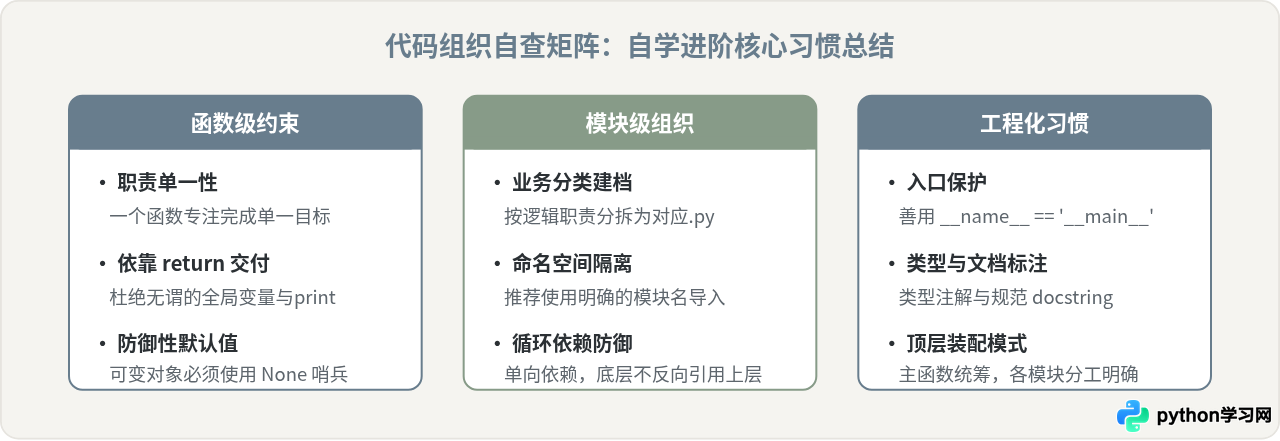
掌握了函数封装与模块化拆分,你的 Python 技能就正式脱离了“即写即弃”的初级脚本模式。在接下来的练习中,不妨尝试把过去写过的上百行长脚本,按照功能拆解出 2~3 个模块,用清晰的函数签名和主入口重构一遍,体会代码条理分明、易于维护的愉悦感。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















