


Numba @jit装饰器怎么加速Python数值计算型for循环
深入解析如何利用Numba的@jit与@njit装饰器加速Python数值计算型for循环,剖析CPython解释器瓶颈与LLVM JIT底层原理,提供标准化实操四步法、性能对比范例、适用边界判断及最佳实践清单。
@jit(nopython=True)(或更推荐直接使用 @njit)装饰器。它能够在函数首次执行时推导参数的具体数值类型,利用 LLVM 编译器直接将 Python 循环编译为与 C 或 Fortran 速度相当的原生机器码,从而绕过 Python 虚拟机的开销,实现数十倍至数百倍的速度提升。
一、为什么 Python 的数值循环慢?Numba 是如何介入的
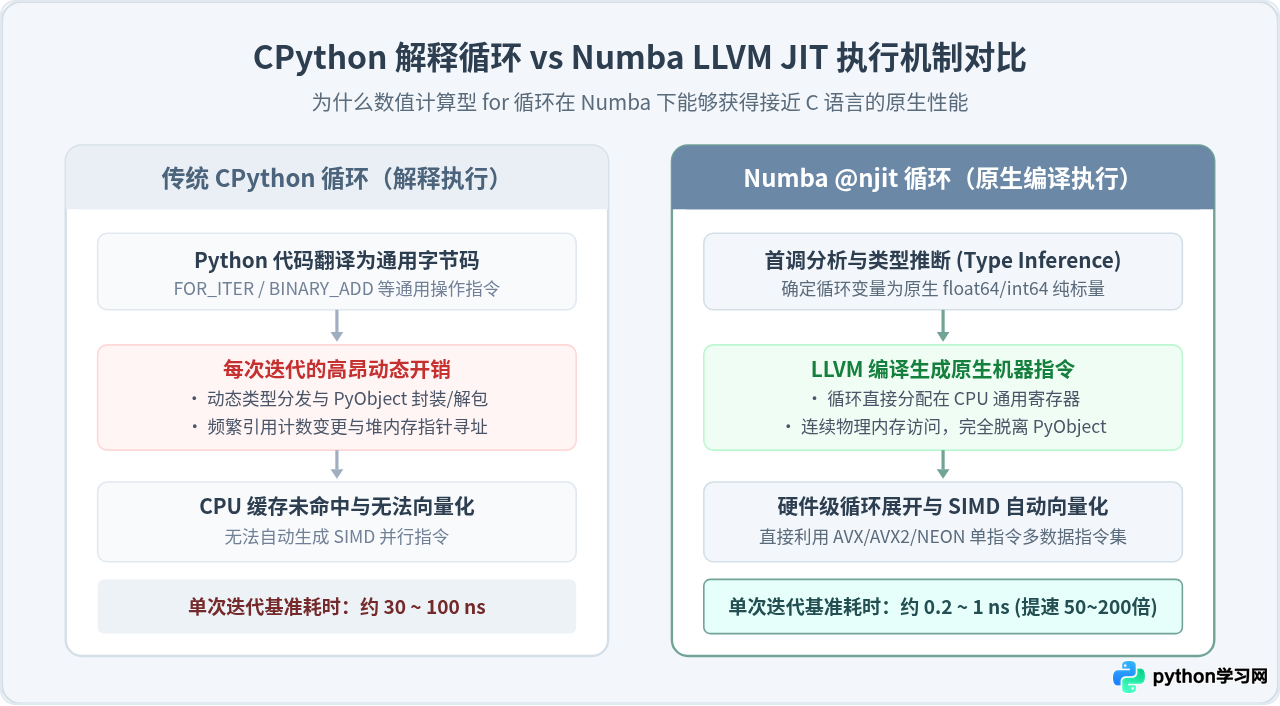
Python 本质上是一种高度动态的解释型语言。当我们在 CPython 解释器中运行一个包含大量计算的 for 循环时,每次循环迭代都会带来庞大的内部损耗。即使循环变量只是简单的整数自增,解释器也需要经历以下过程:
- 动态类型解包(Unboxing):每个数字都被封装成一个庞大的
PyObject结构体(包含引用计数、类型指针和数值本体)。每次加法运算都需要先检查操作数的类型,解包出底层原始数值,计算后再封装成新的PyObject。 - 字节码逐条解释执行:CPython 虚拟机必须逐条分发字节码(如
FOR_ITER、BINARY_OP),无法利用现代 CPU 的寄存器流水线和向量化指令(SIMD)。 - 内存分散寻址:大量临时对象分配在堆上,破坏了 CPU 的一级/二级数据缓存局部性。
Numba 的工作机制彻底改变了这一路径。它并没有重写整个 Python 解释器,而是作为一个即时编译器(Just-In-Time Compiler, JIT),专门针对科学计算函数进行精准优化。当一个被 @jit 修饰的函数被首次调用时,Numba 拦截该函数的抽象语法树(AST)和字节码,根据实际传入的参数类型(如连续内存的 float64 数组)完成类型推断,随后由内置的 LLVM 后端直接生成高度优化的 CPU 原生机器码并缓存在内存中。后续所有的循环迭代直接在硬件原生指令集层面全速运行。
二、标准化实操:从纯 Python 循环到 JIT 加速的四个步骤
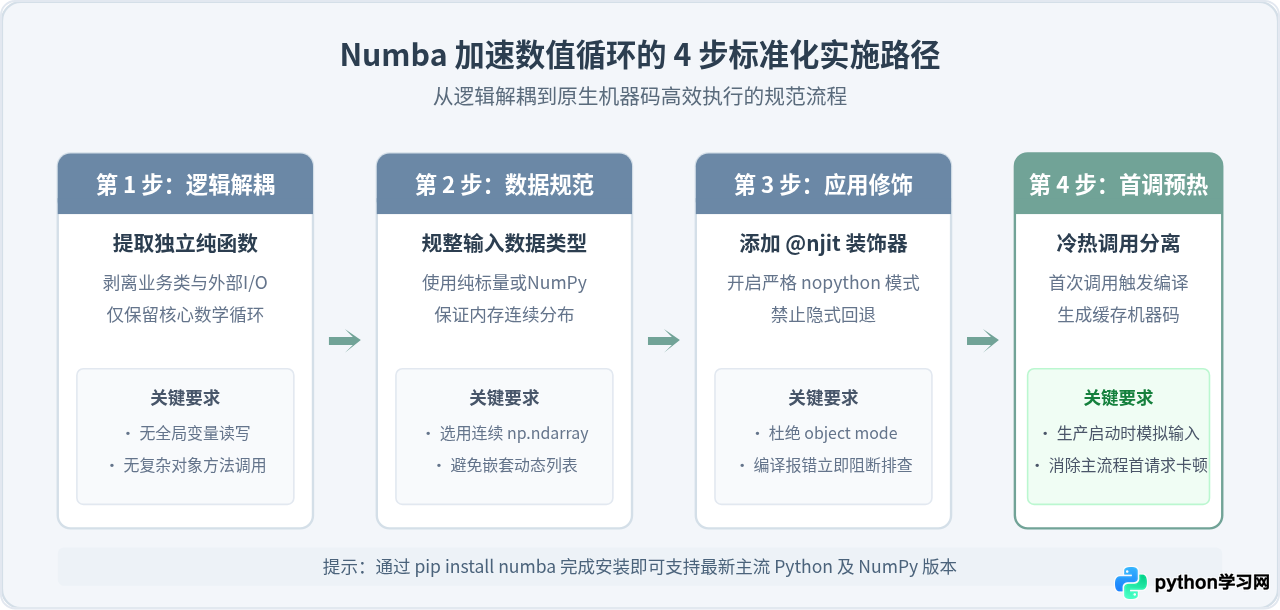
将一个数值计算型的循环接入 Numba 并不复杂,但在工业级代码中需要遵循规范的步骤,确保性能发挥并避免隐式错误。推荐的操作步骤如下:
完整代码对比范例:二维网格高斯平滑计算
我们以科学计算中非常典型的“二维数组高斯平滑模糊滤波”为例。在该场景下,每个像素点的新值取决于它与周围 3×3 邻域像素的加权求和,包含密集的嵌套双重循环:
import time
import numpy as np
from numba import njit

# 1. 纯 Python 实现的嵌套循环
def gaussian_blur_py(image, output):
    rows, cols = image.shape
    for i in range(1, rows - 1):
        for j in range(1, cols - 1):
            # 3x3 模板加权求和
            val = (
                image[i-1, j-1] * 1.0 + image[i-1, j] * 2.0 + image[i-1, j+1] * 1.0 +
                image[i,   j-1] * 2.0 + image[i,   j] * 4.0 + image[i,   j+1] * 2.0 +
                image[i+1, j-1] * 1.0 + image[i+1, j] * 2.0 + image[i+1, j+1] * 1.0
            ) / 16.0
            output[i, j] = val
    return output

# 2. 使用 Numba @njit 装饰的加速版本
# @njit 等价于 @jit(nopython=True),在纯原生机器码模式下运行
@njit
def gaussian_blur_numba(image, output):
    rows, cols = image.shape
    for i in range(1, rows - 1):
        for j in range(1, cols - 1):
            val = (
                image[i-1, j-1] * 1.0 + image[i-1, j] * 2.0 + image[i-1, j+1] * 1.0 +
                image[i,   j-1] * 2.0 + image[i,   j] * 4.0 + image[i,   j+1] * 2.0 +
                image[i+1, j-1] * 1.0 + image[i+1, j] * 2.0 + image[i+1, j+1] * 1.0
            ) / 16.0
            output[i, j] = val
    return output

# 测试环境:构建 2000 x 2000 规模的单精度浮点数网格(400万像素)
img_input = np.random.rand(2000, 2000).astype(np.float32)
out_py = np.zeros_like(img_input)
out_nb = np.zeros_like(img_input)

# --- 步骤 4 验证:首调用预热(JIT 编译期) ---
dummy_in = np.zeros((10, 10), dtype=np.float32)
dummy_out = np.zeros((10, 10), dtype=np.float32)
gaussian_blur_numba(dummy_in, dummy_out) # 触发编译

# --- 性能测试:正式运行 ---
# 纯 Python 耗时测量
t0 = time.perf_counter()
gaussian_blur_py(img_input, out_py)
time_py = time.perf_counter() - t0

# Numba 机器码耗时测量
t0 = time.perf_counter()
gaussian_blur_numba(img_input, out_nb)
time_nb = time.perf_counter() - t0

print(f"纯 Python 耗时: {time_py:.4f} 秒")
print(f"Numba 机器码耗时: {time_nb:.4f} 秒")
print(f"加速比: {time_py / time_nb:.1f} 倍")
在常规 x86_64 CPU 机器上,纯 Python 双重 for 循环处理 400 万次迭代通常需要 1.8 秒至 2.5 秒;而经过 @njit 编译后的机器码仅需 0.015 秒至 0.025 秒,带来 80 倍至 120 倍 的实质性提速。不仅结果与纯 Python 浮点输出完全一致,而且由于没有额外的临时数组产生,内存占用保持在极低水平。
三、适用边界与技术选型:什么时候能用,什么时候失效?
虽然 Numba 加速非常强悍,但它并不是万能的“全局加速器”。读者在引入 @jit 时,必须清醒识别它的有效边界:
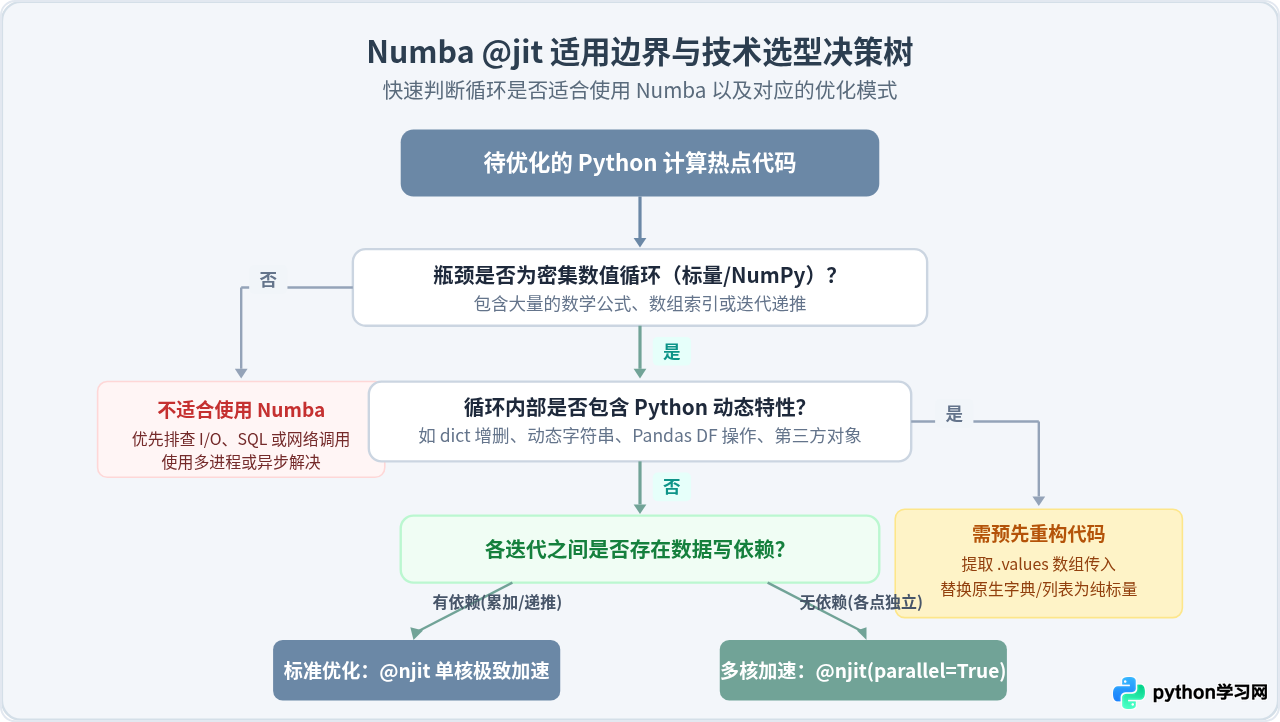
1. 最佳适用场景(极速加速)
- 密集的数学模拟与物理仿真:例如蒙特卡洛(Monte Carlo)随机数采样、差分方程求解、质点轨道计算。
- 无法直接向量化的嵌套循环:例如 Dynamic Programming(动态规划)中的网格递推,第
i项必须依赖于i-1项的计算结果,NumPy 广播无法展开,而 Numba 可以在原生机器码下无开销完成迭代。 - 图像与矩阵邻域操作:如卷积滤波、连通域扫描、点云欧氏距离计算等。
2. 不适用与降级场景(报错或变慢)
| 特性 / 数据结构 | 在 @njit 下的表现 | 推荐替代方案 |
|---|---|---|
| Pandas DataFrame / Series | 抛出 TypingError,无法编译 |
在传入前调用 df['col'].values 提取为 NumPy 数组 |
| 原生 Python 字典 (dict) | 支持有限且严重损失性能 | 使用一维或二维浮点数组通过数值索引模拟查找表 |
| 循环内字符串拼接 | 无法推导为机器码指令 | 字符串操作保留在纯 Python 逻辑层处理 |
| 循环内动态分配内存 (list.append) | 产生显著的堆内存管理开销 | 提前用 np.empty() 或 np.zeros() 分配固定输出数组 |
四、进阶提速:多核并行计算与编译开销处理
在许多大规模数值处理任务中,单核机器码依然满足不了实时要求。Numba 内置了轻量级线程池支持,只要设置 parallel=True 并配合 prange,就能以几乎零语法负担的方式释放多核 CPU 算力。
from numba import njit, prange
import numpy as np

# parallel=True 启用内置线程调度池,prange 自动将外层循环切片并行分发
@njit(parallel=True)
def parallel_pairwise_distance(points, output):
    n = points.shape[0]
    for i in prange(n):
        for j in range(i + 1, n):
            dx = points[i, 0] - points[j, 0]
            dy = points[i, 1] - points[j, 1]
            dist = (dx * dx + dy * dy) ** 0.5
            output[i, j] = dist
            output[j, i] = dist
    return output
在上面的代码中,prange(n) 会根据机器的 CPU 物理核心数将 0 到 n 的外层循环分块到多个线程上并发执行。由于不存在 GIL(全局解释器锁)的干扰,Numba 的多线程是真正的系统级硬件线程并发,多核扩展性极佳。
解决“首调用编译开销”的两种策略
因为 JIT 是延迟编译的,第一次调用函数时需要耗费数十毫秒到数百毫秒来完成 LLVM 编译,后续调用才会飞速运行。针对生产部署,有两种应对手段:
- 冷启动显式预热(Warm-up):在 Web 服务或工作进程启动完成的钩子中,用最小尺寸的模拟数据先调用一次
@njit函数,完成内存内机器码编译,确保用户的第一笔请求不遭遇冷启动延迟。 - 磁盘缓存(Cache):添加参数
@njit(cache=True)。Numba 会将编译生成的机器码保存到__pycache__目录下。只要函数代码及环境没有改动,下次启动程序时即可直接从磁盘加载机器码,跳过重编译。
五、核心规则总结与排坑清单
总结来说,使用 Numba 加速 Python 数值循环,是一门“用严格的静态类型约束换取硬件极限性能”的技术。牢记以下四项核心设计准则:
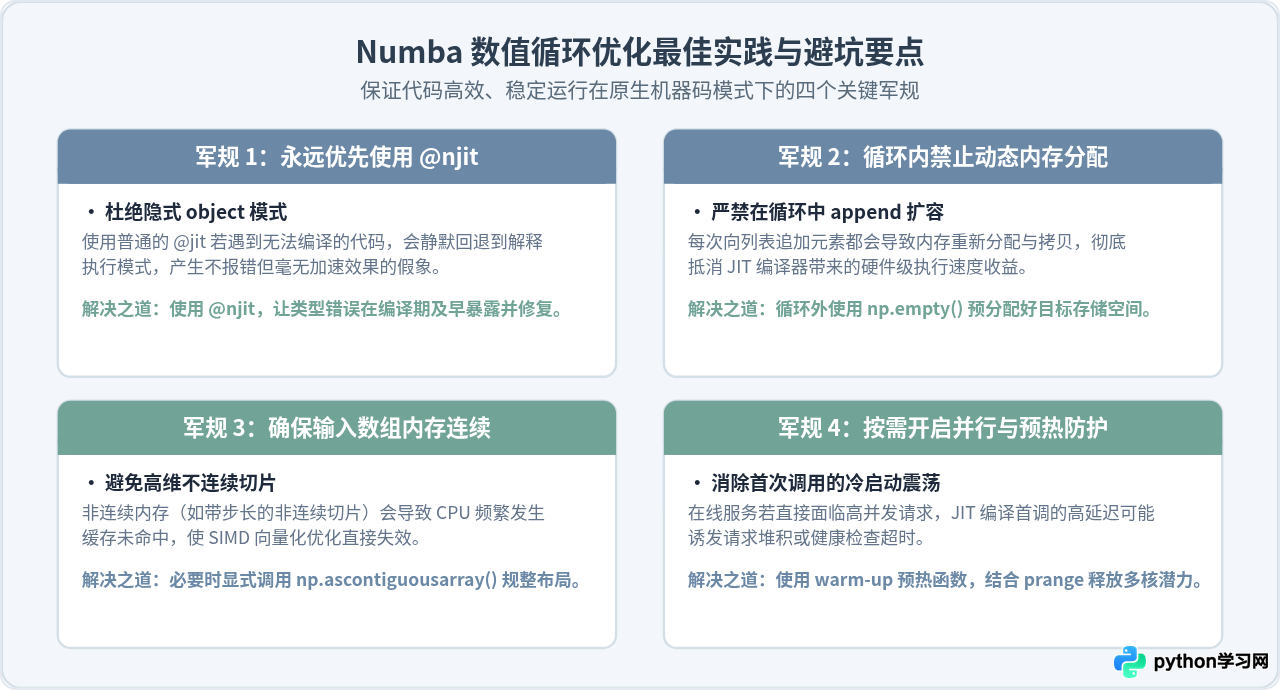
只要按照上述方法,将数值循环部分抽离为规整的纯函数,并用 @njit 标注,Python 开发效率与 C/C++ 级运行速度之间的鸿沟就能被有效弥合,让数据科学、工程仿真和图像处理任务轻松获得数量级的性能爆发。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















