


Python爬虫 vs 八爪鱼:自定义开发与可视化工具怎么选
面对数据采集需求,选Python自定义开发还是八爪鱼等可视化工具?本文从运行机制、学习成本、反爬应对、工程集成等维度全面对比,并提供操作步骤、代码示例与选型决策指南。
选择数据采集方案的核心依据不是“哪种工具更高级”,而是业务场景对“技术维护成本”与“底层定制自由度”的平衡取舍。如果目标是快速提取常规网站数据、没有编程背景或需求偏向临时性调研,八爪鱼这类可视化工具能在半小时内产出结果;如果面临复杂的自定义反爬验证、海量并发抓取、毫秒级响应,或是需要将采集流程深度嵌入企业的自动化业务系统,Python 自定义开发则是无法替代的基础设施。
一、底层逻辑与工作链路差异
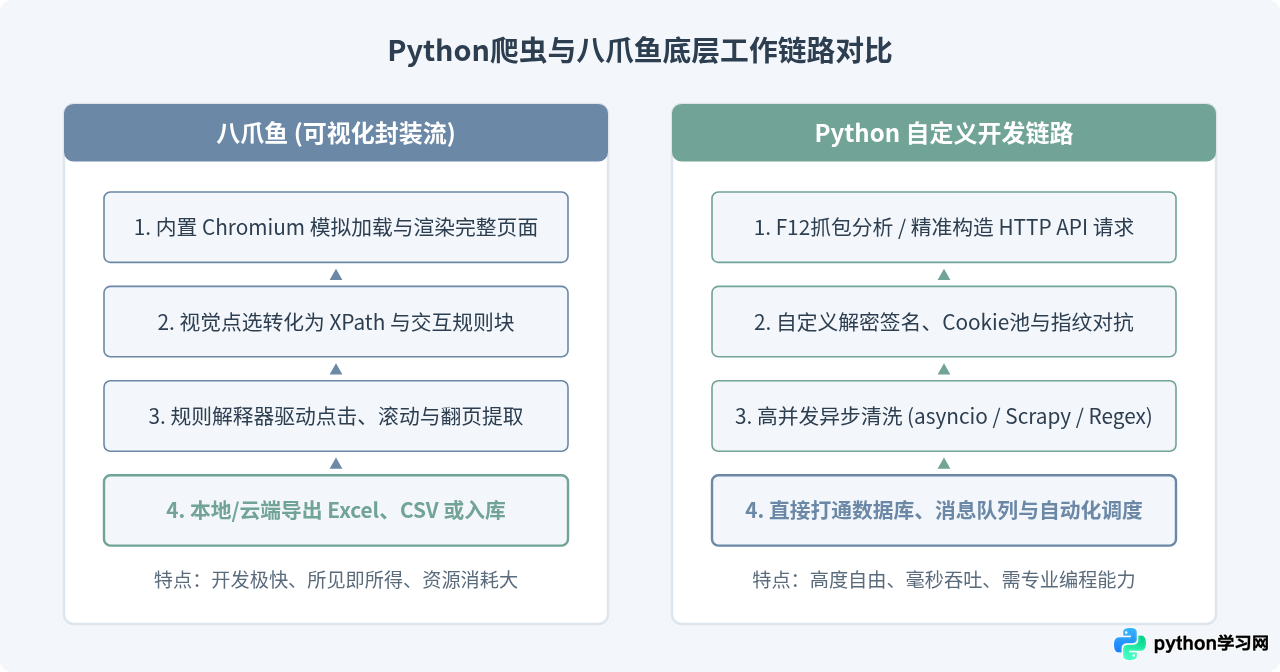
理解两种工具的差异,首先要看它们在网络层与解析层是如何处理数据的。可视化工具与原生代码在技术抽象层级上有本质区别。
八爪鱼本质上是一个封装了无头浏览器内核与规则引擎的桌面客户端。用户在界面上的每一次点击、框选、翻页设置,都会被内置引擎转化为对 DOM 节点的定位表达式(如 XPath、CSS 选择器)以及浏览器事件流。这种模式省去了分析网络抓包的繁杂过程,直接在渲染后的页面中提取可见内容。
Python 爬虫则是基于代码驱动的网络请求与数据管道。开发者可以直接调用底层网络库(如 requests、httpx、aiohttp)与目标服务器直接通信,或者在需要时调用无头浏览器驱动(如 Playwright、Selenium)。开发者对请求头、TLS 指纹、Cookie 会话管理、异步协程并发以及数据持久化拥有百分之百的控制权。
二、关键维度的深度横向对比
为了让选型有明确的依据,我们需要从日常开发中最为关切的五个核心维度来审视两者的差异:
| 评估维度 | 八爪鱼 (可视化工具) | Python 自定义爬虫 |
|---|---|---|
| 上手门槛 | 极低。无需语法基础,官方提供大量现成模板,普通业务人员半天内即可掌握。 | 较高。需要掌握 Python 语法、HTML/DOM 结构、网络通信协议及基础反爬知识。 |
| 开发与上线速度 | 针对通用页面极快,几分钟到十几分钟即可完成一条采集规则的配置。 | 初始编码较慢,需搭建开发环境、分析网络请求、编写与调试解析代码。 |
| 反爬对抗深度 | 支持常见代理IP配置、随机延时与简单验证码打码,但无法处理高阶逆向加密与动态验签。 | 极高。可通过逆向 JS 解密参数,伪造特定 TLS 握手特征,灵活集成各类智能验证码破解。 |
| 运行效率与资源开销 | 依赖完整浏览器内核渲染,占用较多内存和 CPU,单机并发能力受限于硬件。 | 接口级请求只需传输纯文本或 JSON,内存开销小,异步协程可实现极高吞吐量。 |
| 工程集成与自动化 | 主要通过客户端运行或官方付费云平台托管,导出数据多为文件形式,与内部系统打通成本较高。 | 原生支持命令行、Docker 容器化部署、定时任务调度(Crontab/Airflow)及直接存入企业数据库。 |
三、八爪鱼典型操作步骤与适用场景
八爪鱼最适合的场景包括:电商平台公开比价、新闻资讯列表聚合、行业公开报告汇总以及产品运营人员的日常数据收集。这些场景的共同特征是页面结构规范、对采集频率要求不严苛、无需复杂验签。
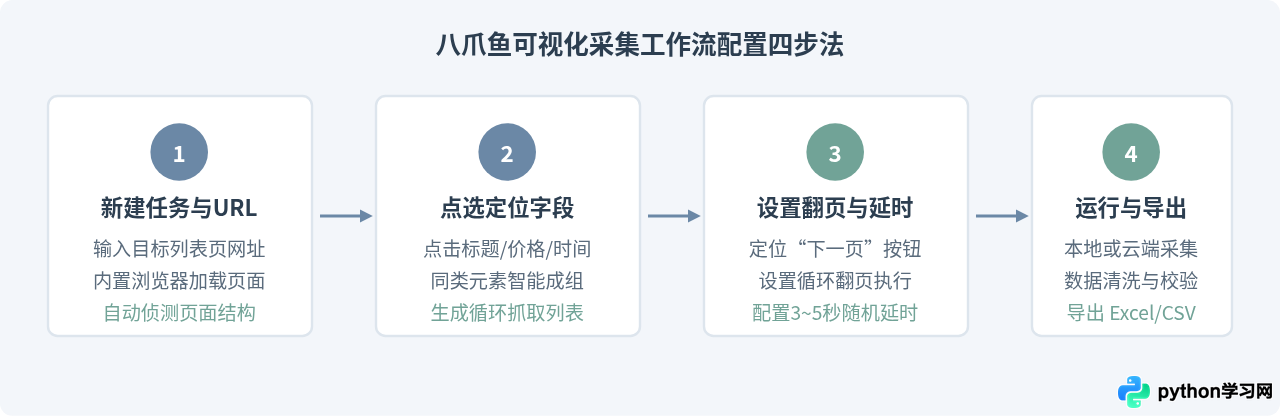
在八爪鱼中配置采集任务时,最需要注意以下两点:
- 动态加载与滚动:如果页面采用了瀑布流加载(需向下滚动才渲染后续内容),必须在高级设置中勾选“页面向下滚动”并指定滚动次数,否则采集到的列表往往只有前几条数据。
- 防封频率控制:可视化工具很容易因为频繁刷新和多开导致目标网站封禁 IP。在执行前务必在流程线中增加“执行前等待”或使用八爪鱼内置的代理IP切换功能。
四、Python自定义爬虫的工程实践与代码示例
当目标网站的数据存在异步接口加密、大量翻页数据需批量入库、或者每天需要在特定时间点自动触发时,Python 代码开发的灵活性就显现出来了。
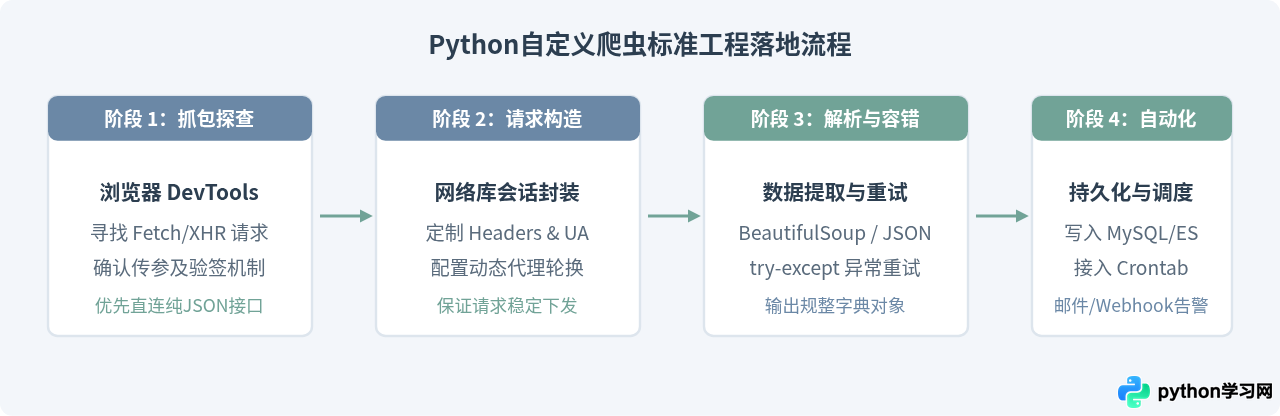
下面是一个标准的 Python 结构化采集代码示例。代码使用 requests 发起请求,结合 BeautifulSoup 进行数据提取,并加入了基础的会话管理、请求头伪装和异常捕获:
import time
import requests
from bs4 import BeautifulSoup

def fetch_page_items(page_num):
    url = f"https://example.com/books?page={page_num}"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
    }

    try:
        response = requests.get(url, headers=headers, timeout=10)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
    except requests.RequestException as e:
        print(f"[错误] 第 {page_num} 页请求失败: {e}")
        return []

    soup = BeautifulSoup(response.text, "html.parser")
    items = []

    # 定位商品或文章卡片
    cards = soup.select(".product-card")
    for card in cards:
        title_node = card.select_one(".product-title")
        price_node = card.select_one(".product-price")

        if title_node and price_node:
            items.append({
                "title": title_node.get_text(strip=True),
                "price": price_node.get_text(strip=True),
                "page": page_num
            })

    return items

if __name__ == "__main__":
    all_data = []
    for page in range(1, 4):
        print(f"正在抓取第 {page} 页...")
        data = fetch_page_items(page)
        all_data.extend(data)
        time.sleep(2)  # 合理延时,保护目标服务器

print(f"抓取完成,共获得 {len(all_data)} 条数据。")五、综合选型决策:怎么选最合理
在实际工作中,选型不应是非此即彼的对立关系。面对一个具体的采集任务,可以按照以下决策路径来判断最适工具:
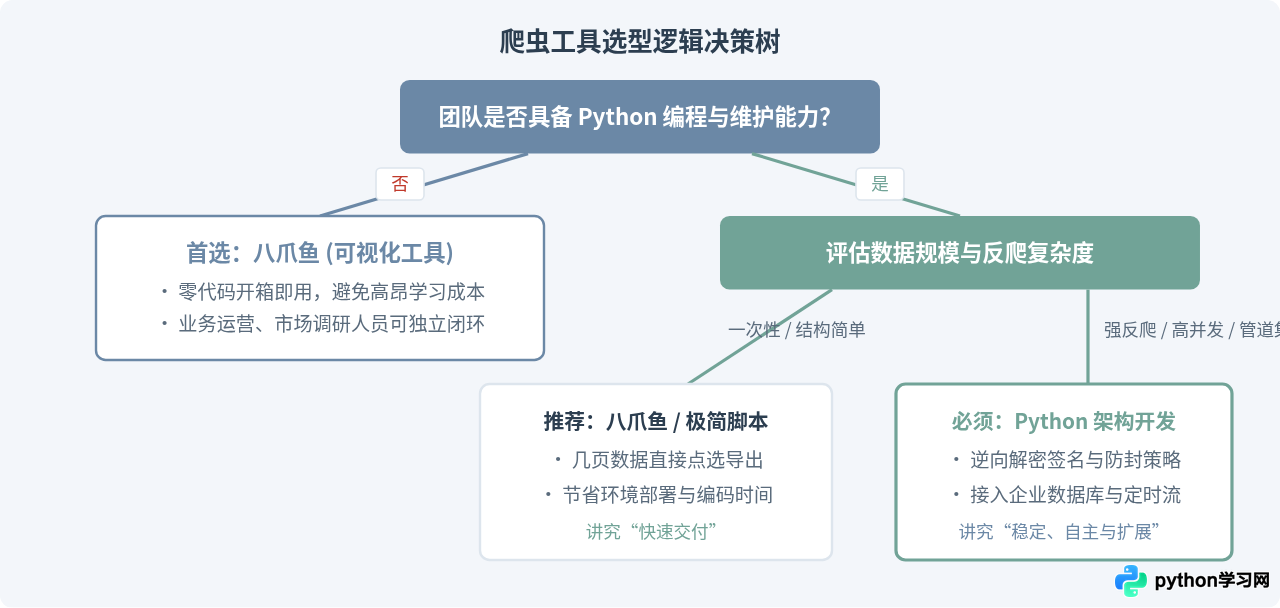
常见场景推荐归类:
- 市场调研与行业报告编制:这类需求频次低、目标网站分散,通常只需要采集一次性 Excel 表格。推荐直接使用八爪鱼,可以在几十分钟内拿到结果并投入分析,无需投入工程师资源。
- 中小型垂直电商价格监控:每天固定时间抓取数万款商品变动,存在一定频控。推荐Python 爬虫。采用 Scrapy 或 Requests 结合轻量代理池,每天通过服务器定时任务静默执行,数据自动入库并触发变价告警。
- 大型平台深度反爬对抗:涉及复杂滑块、设备指纹、动态字体反爬或 Wasm 加密。此时可视化工具往往失效,必须依赖Python + 逆向调试或 Playwright 深度指纹伪造来攻克。
- 最佳混合策略:在企业成熟团队中,两者常协同使用——业务分析人员用八爪鱼快速验证目标数据源的商业价值;一旦确认具备长期监控意义,再交由技术团队用 Python 开发标准化的采集清洗管道。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















