


机器学习选Python还是R语言?库生态与工业界应用对比
深入对比机器学习领域Python与R语言的核心库生态、工程流水线支持、工业生产部署能力及团队协作场景,提供清晰明确的技术选型决策指南。
如果你的目标是将机器学习模型接入工程系统、构建实时高并发 API、探索深度学习与大语言模型,或者与后端开发及大数据团队无缝协作,Python 是绝大多数工业场景的标准选择;而如果你的核心任务集中在严格统计推断、生物医药临床试验、计量经济学研究,或者需要快速输出高质量可交互统计研报,R 语言至今依然保持着无可替代的专业深度与严谨表达力。本文将从库生态分层、工业流水线集成、落地选型步骤与决策矩阵四个维度,为读者梳理清晰的技术判断依据。
一、库生态分层对比:从数据清洗到前沿建模
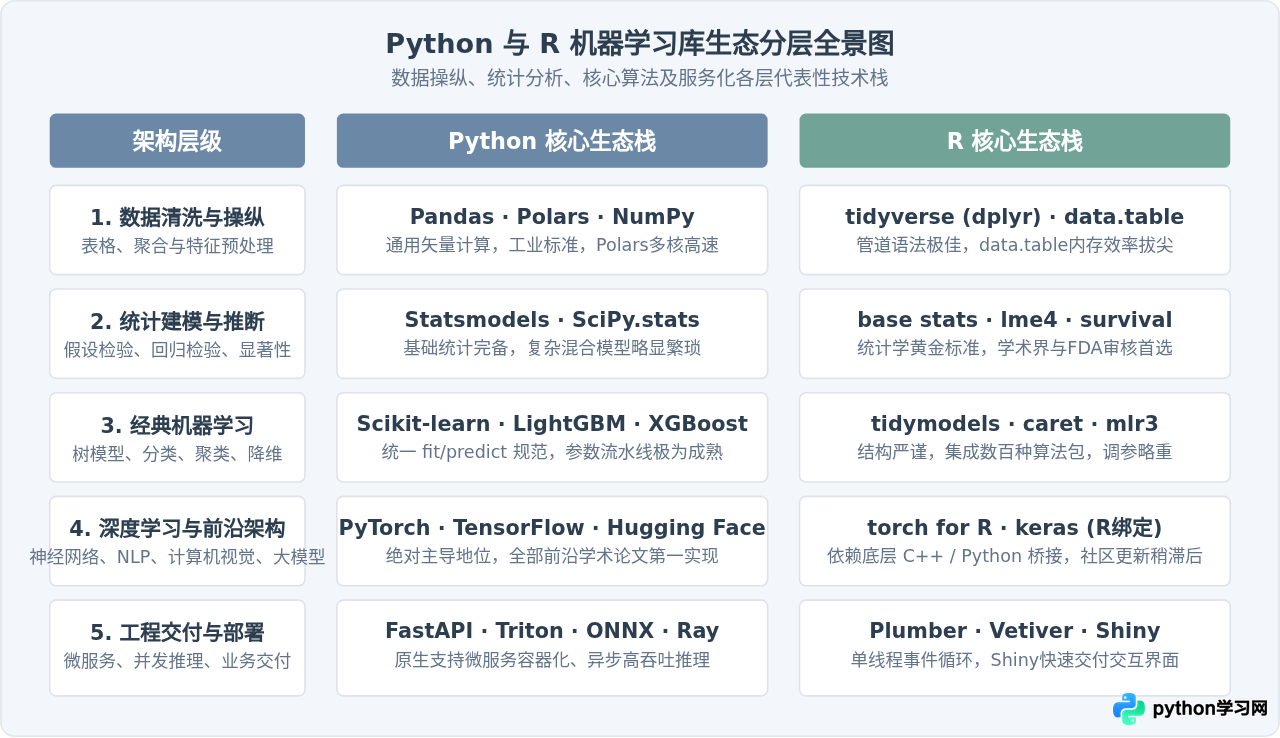
机器学习项目的代码实现通常分为数据操纵、统计推断、经典机器学习、深度学习及服务化五大阶段。Python 与 R 在每个阶段都沉淀了代表性工具库,两者的设计哲学在工具链形态上有显著体现。
Python 依靠通用的面向对象范式和统一的 API 规范建立了极其标准化的算法流水线;而 R 语言从诞生之初就以统计分析和向量化数据操作为核心,语法设计极其贴合数据科学家的探索性思维。
1. 数据操纵:语法一致性与极致内存吞吐
在探索性数据分析(EDA)阶段,R 语言的 tidyverse 生态凭借 %>% 或原生 |> 管道操作符,提供了极其优雅的数据重塑体验。代码读起来就像自然语言的动词短语组合:
另外,R 中的 data.table 更是单机千万级数据内存处理的标杆,其语法紧凑且依靠 C 级优化获得惊人的聚合速度。相比之下,Python 传统的 Pandas 在链式处理时语法相对冗长,但近年来新兴的 Polars 吸收了现代数据库内核的查询优化和惰性执行(LazyFrame),大幅抹平了与 R 的性能差距。更关键的是,Pandas 输出的结构可以天然无缝喂给下游的深度学习 Tensor,在全链路类型转换上具备天然优势。
2. 核心算法库:统一接口 vs 统计包汇聚
Python 的基石是 Scikit-learn。Scikit-learn 制定了数据科学界的通用标准:无论是逻辑回归、支持向量机,还是随机森林,全部遵循统一的 estimator.fit(X, y) 与 estimator.predict(X_test)。配合 Pipeline 和 ColumnTransformer,开发者可以把特征缺失值填充、标准化、单热编码与模型训练严格打包为一个序列化对象。这种规范性使得模型在上线部署时能够原封不动地进行前向推理,彻底杜绝数据泄露和预处理不一致。
R 语言的经典模型则分散在各学术包中。早期的 R 语言每个算法包的函数入参、输出结构各不相同(例如 randomForest 与 glm 的输出摘要结构差异极大)。虽然 caret 与新一代的 tidymodels 尝试建立了统一包装层,但在工程规范性上,Scikit-learn 的成熟度在工业界仍被视为黄金参考标杆。
二、工业界工程落地与生产流水线集成
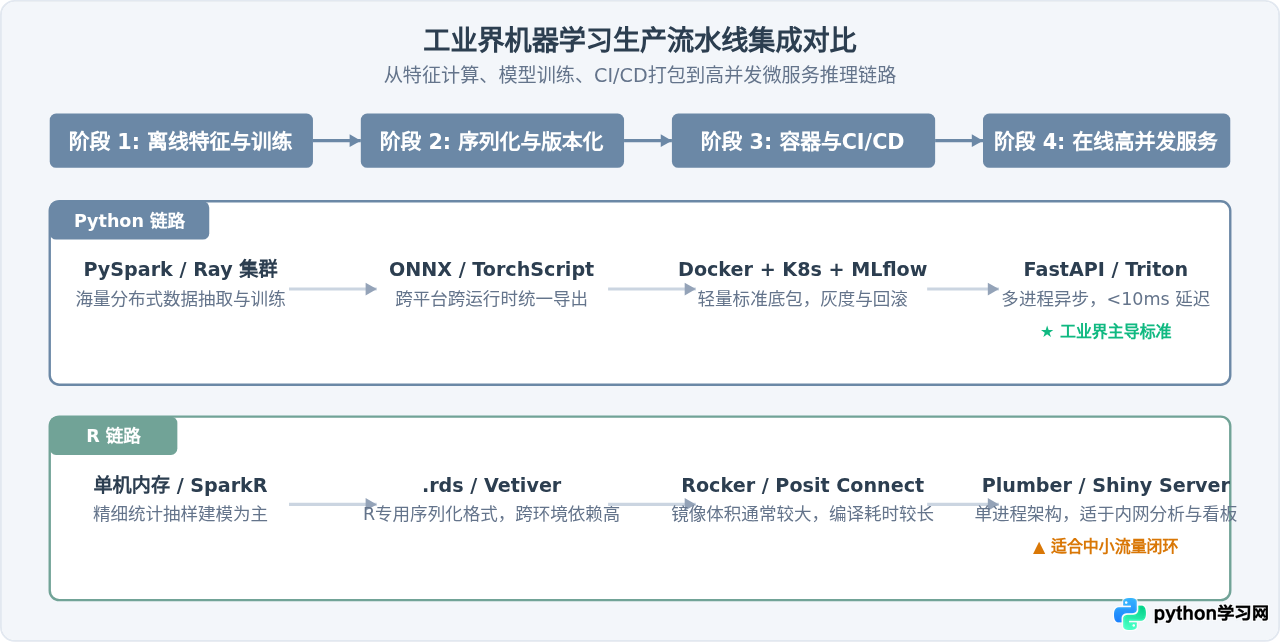
如果说模型探索只需要关注算法准确率(Accuracy/AUC),那么工业界落地更关注吞吐量(Throughput)、延迟(P99 Latency)、容器化体积、并发安全性以及与现有后端基础设施的通信协议支持。
1. 为什么工业微服务首选 Python?
在互联网核心业务中,一个反欺诈或实时推荐模型每天需要处理数亿次在线请求,接口响应耗时通常要求在 10 毫秒至 50 毫秒以内。
- 通用网络服务器基础设施:Python 拥有现代化的 ASGI 异步网络框架(如
FastAPI、Uvicorn),并可直接挂载在 NVIDIA Triton Inference Server 或 TorchServe 之中。这些服务原生支持微批处理(Dynamic Batching)、GPU 显存并发复用以及 gRPC 高性能通信。 - 工业级跨语言运行时转换:Python 训练的模型可以直接导出为 ONNX(Open Neural Network Exchange)或 TensorRT 格式。一旦转换为 ONNX,线上服务甚至不需要运行 Python 解释器,直接由 C++ 或 Go 服务加载执行,既消除了 GIL 限制,又达到了顶尖吞吐效率。
- 大数据体系的原生支持:工业界特征工程平台依赖 Spark、Flink 和 Ray。
PySpark和Ray Core均以 Python 为一等公民接口,工程师可以在分布式环境下轻松完成 TB 级数据的离线训练。
2. R 语言在工业部署中的局限与突围
R 语言提供了 Plumber 库,可以通过装饰器注释将 R 函数快速封装为 REST API:
尽管 Plumber 使用简便,但由于 R 解释器本质上是单线程事件模型,当遇到耗时较长的矩阵计算时,事件循环会被阻塞,后续请求将排队等待。虽然可以通过 Docker 多容器配合负载均衡(Nginx)进行横向扩容,但 R 的运行时镜像通常包含大量系统编译依赖(如 BLAS、LAPACK、Fortran 运行时),基础镜像体积动辄 1GB 以上,容器拉取与冷启动速度相对较慢。因此,R 语言更适合内网决策系统、低频复杂统计分析服务或面向内部高管的 Shiny 仪表盘,较少直接暴露给公网海量用户侧。
三、技术选型四步实施法:如何做出理性决策
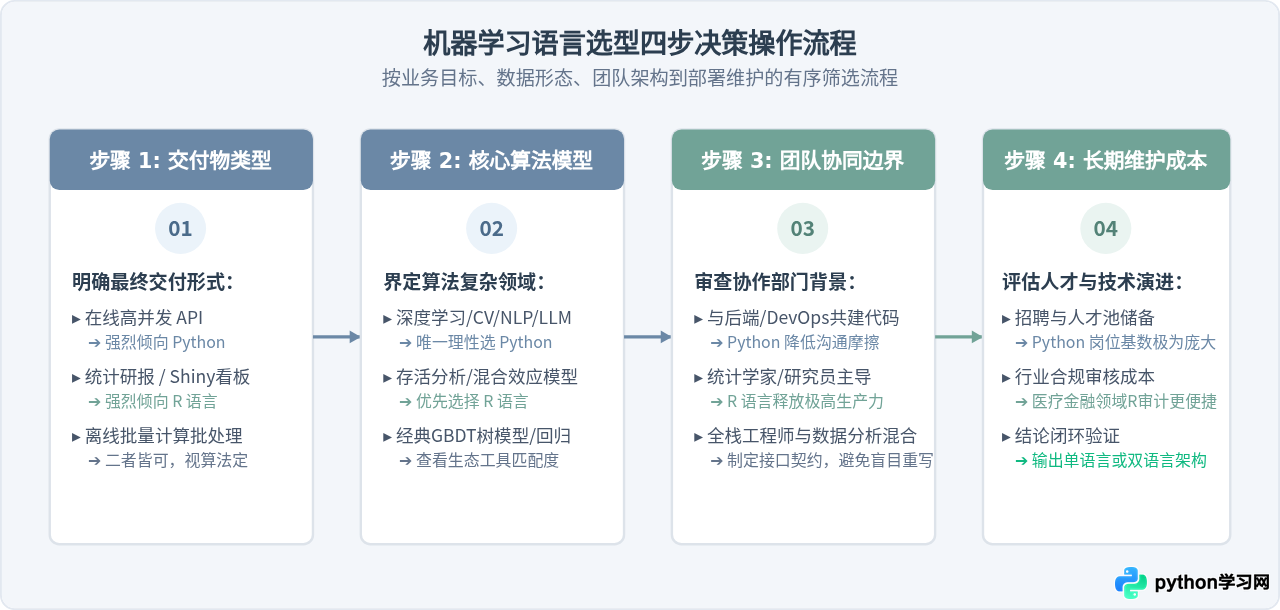
技术选型不应停留在抽象的优缺点比较上,而应根据项目的实际约束条件进行条件式推导。团队可以通过以下四个步骤系统化推演适合的技术路线:
详细操作步骤说明:
- 第一步:锁定交付形态。如果项目要求嵌入已有的 Java/Go/Python 后端微服务集群,必须提供低延迟 RESTful/gRPC 接口,首选 Python;如果最终产物是面向运营决策层的 PDF 自动化分析报告、临床试验申报资料或 Shiny 动态应用,R 语言能在更短时间内完成高质量交付。
- 第二步:核对算法类型。若涉及图像识别、语音处理、自然语言处理(NLP)或调用 Hugging Face 上的开源大模型,无须犹豫直接选 Python;若涉及复杂的实验设计(DOE)、生存分析(Survival Analysis)、广义可加模型(GAM)或小样本因果推断,R 语言提供的统计显著性检验与模型诊断工具要更加深入、完备。
- 第三步:评估团队研发背景。团队中如果多为计算机、软件工程背景,Python 契合常规软件工程实践(如面向对象设计、类型提示 Typing、pytest 单元测试);若团队主要由生物统计学家、流行病学家、量化金融分析师构成,强制改用 Python 会增加不必要的语法心智负担。
- 第四步:权衡招聘与维护生命周期。在通用人才市场中,精通 Python 机器学习工程的工程师基数远大于 R 语言工程师,后续人员流动下的交接成本更低;而在特定垂直行业(如全球顶尖制药巨头与临床 CRO 公司),R 语言是经过长期法规验证的标准工具,迁移至 Python 可能会面临重大的再验证成本。
四、场景决策总结矩阵与混合实践架构
在成熟的企业级实践中,Python 与 R 并不是绝对对立的单选题。很多技术团队通过明确的职责切分,实现了“1 + 1 > 2”的混合架构。
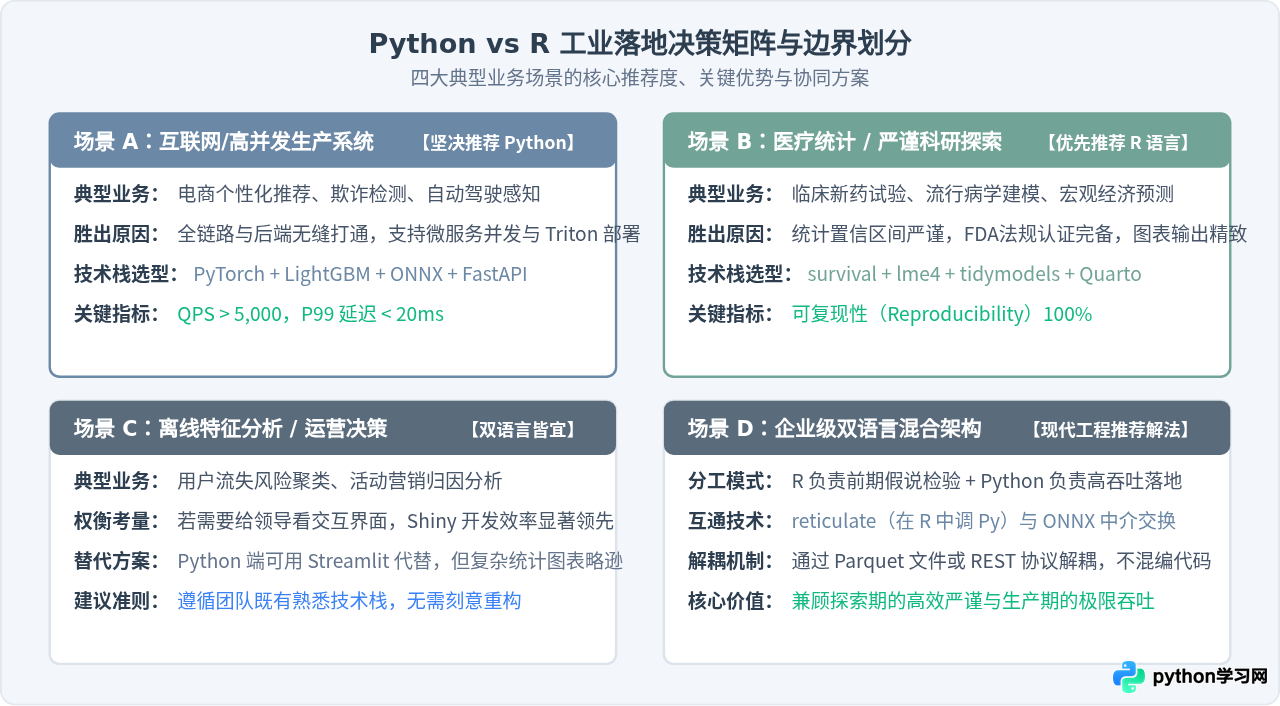
综合能力雷达评分对照表
| 评估维度 | Python 表现 | R 语言表现 | 工业落地选型要点 |
|---|---|---|---|
| 统计学严密性 | 良好(Statsmodels 可用,部分前沿检验缺失) | 卓越(学术界基准,包罗万象的检验函数) | 若涉及法规审计与精细实验设计,R 具备天然优势 |
| 深度学习支持 | 卓越(PyTorch, TensorFlow, JAX 绝对垄断) | 受限(大多作为 Python 底层包装层) | 计算机视觉、自然语言处理与大语言模型只推荐 Python |
| 工程服务化并发 | 卓越(FastAPI, gRPC, Triton, ONNX 完备) | 一般(Plumber 单线程,多核需依赖进程池扩容) | 高并发(>1000 QPS)低延迟实时推理首选 Python |
| 探索式数据可视化 | 良好(Matplotlib, Seaborn, Plotly) | 卓越(ggplot2 图形语法,出版级制图标准) | 向业务决策层做数据汇报和交互式探索展示时,R 更快更美观 |
| 团队协同与工程规范 | 卓越(强类型提示、代码风格检查、与后端通用) | 良好(函数式编程、动态属性丰富,大型工程不易维护) | 团队超过 5 人跨端共建同一代码库时,Python 规范维护成本低 |
五、常见实际疑问与避坑建议
很多传统数据团队的痛点在于:统计学家用 R 调好了复杂的回归与特征转换逻辑,交付给工程部门时要求用 Java 或 Python 重写。这种“跨语言翻译”极易引入浮点计算细微差异、类别型特征哑变量编码不一致等致命隐患。推荐做法是:要么直接采用标准化格式(如通过 ONNX 或 PMML)导出计算图;要么在探索阶段就直接统一使用 Python 的 Scikit-learn Pipeline。
虽然 Python 社区推出了 Streamlit 和 Gradio,但在数据表格的交互操作、复杂统计图表的细节微调以及自动生成 PDF/Word 格式的科研研报方面,R 语言的 Quarto(前身 R Markdown)与 Shiny 依然是全自动化分析领域的生产力天花板。如果模型的核心目标是辅助内部高管或业务方决策,直接使用 R Shiny 是极具性价比的选择。
最终结论
归结为一句话:在现代企业的数据架构中,Python 是串联整个软件工程体系与前沿 AI 能力的主干网络;而 R 语言则是专精于高严密性统计推断、探索性分析与专业报告的利刃。厘清项目的交付形态与性能指标,方能在具体场景中做出最稳健的技术选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















