


Python在人工智能领域的应用:机器学习模型训练与自然语言处理实例
本文深入讲解Python在人工智能开发中的核心落地实践,通过基于scikit-learn的经典机器学习分类模型训练和基于TF-IDF的中文文本情感分析自然语言处理两个完整实例,系统解析数据清洗、特征工程、模型评估与流水线构建的全流程。
一、机器学习模型训练的核心工程流程
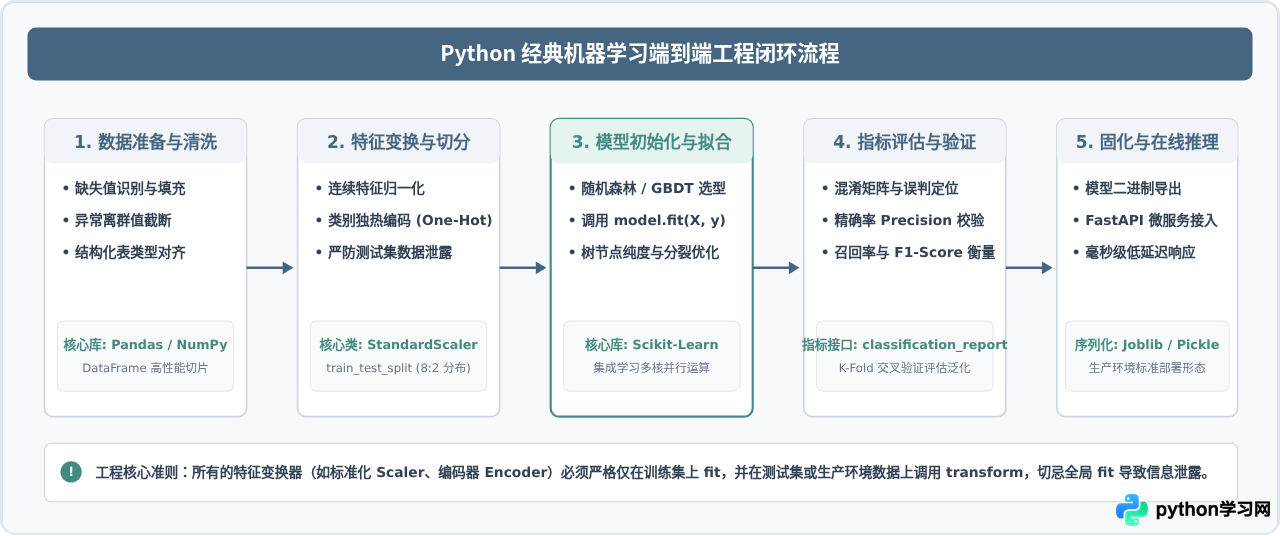
在人工智能应用开发中,监督学习下的分类与回归模型训练是最基础也是最成熟的落地形式。一个标准的机器学习训练流程并不是简单地将数据喂给算法,而是由数据前处理、特征工程、样本切分、模型拟合、指标交叉验证以及模型持久化等若干关键环节组成的工程闭环。
1. 完整实战示例:结构化数据集分类模型训练
下面给出一套自包含且符合生产规范的 Python 代码。本例加载经典的葡萄酒品质多类别特征数据集,演示包含数据切分、特征标准化、随机森林分类器训练与完整综合指标计算的代码结构:
# -*- coding: utf-8 -*-
# 依赖库: pip install scikit-learn numpy pandas

from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
import numpy as np

# 1. 载入数据集
data = load_wine()
X = data.data      # 形状: (178, 13),共13项理化特征(醇类、苹果酸、灰分等)
y = data.target    # 目标类别: 0, 1, 2(三种不同葡萄品种)

# 2. 严谨划分训练集与测试集(固定随机种子保障复现性,stratify保障各类别比例均衡)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 特征标准化(注意:仅在训练集上计算均值和标准差)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)  # 测试集直接使用训练集的统计参数进行映射

# 4. 构建并拟合集成学习模型(随机森林)
rf_classifier = RandomForestClassifier(
    n_estimators=100,      # 构建100棵决策树
    max_depth=5,           # 限制树的最大深度,抑制过拟合
    random_state=42,
    n_jobs=-1              # 开启全核心并发训练
)
rf_classifier.fit(X_train_scaled, y_train)

# 5. 模型测试集预测与指标检验
y_pred = rf_classifier.predict(X_test_scaled)

print("=== 混淆矩阵 ===")
print(confusion_matrix(y_test, y_pred))

print("\n=== 综合分类评估指标报告 ===")
print(classification_report(y_test, y_pred, target_names=data.target_names))在上述代码中,stratify=y 是保证各分类在抽样中保持原有比例的关键参数。如果不启用该选项,在样本不平衡时可能导致测试集完全缺少某类样本,使得评估结果失去真实性。
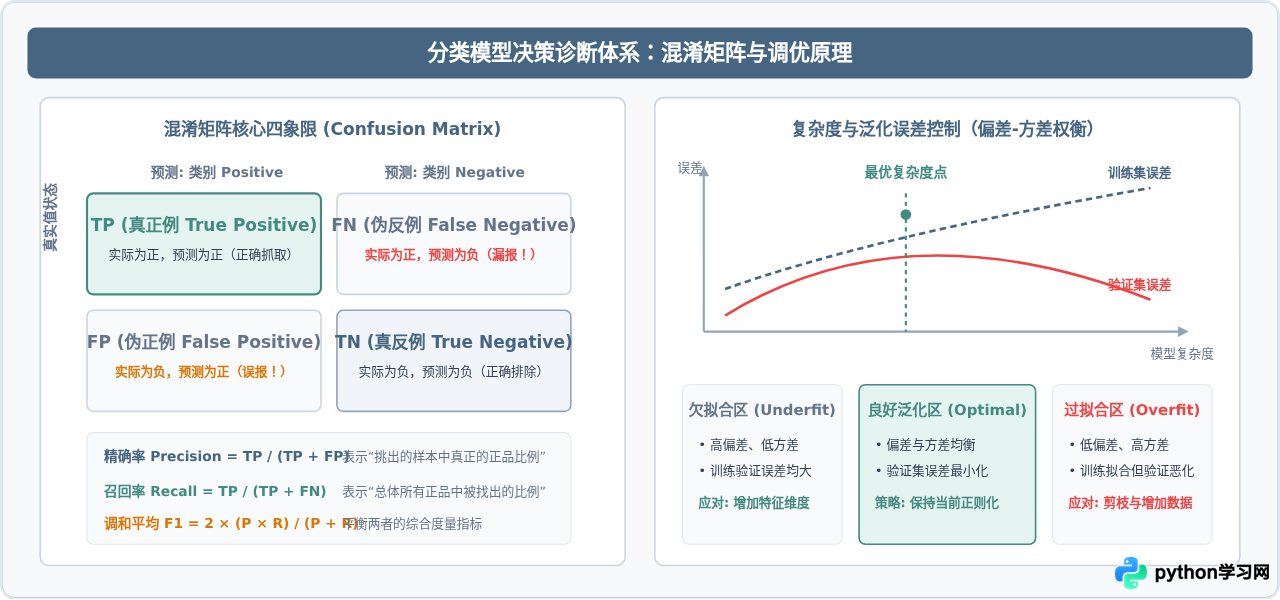
运行后得到的指标报告将显示每种类别的精确率(Precision)、召回率(Recall)及 F1-Score。在 36 个测试样本下,随机森林能够达到 97%~100% 的准确率。每一棵决策树通过对样本的有放回重抽样(Bootstrap)与特征随机子集切分,极大增强了模型对抗单点噪声的鲁棒性。
二、模型决策机理与评估诊断体系
评估一个机器学习模型的好坏,绝不能单纯看一个总体的准确率(Accuracy)。当遇到正负样本极度不平衡(例如风控反欺诈场景中违约样本仅占 1%)时,模型就算将所有样本无脑判断为负,也能取得 99% 的准确率,但这在业务上毫无意义。因此,必须通过混淆矩阵深挖精确率与召回率的权衡。
三、自然语言处理(NLP)实战:中文文本分类流水线
自然语言处理(Natural Language Processing, NLP)与结构化表格数据处理最大的差异在于输入形式。文本是非结构化的符号序列,计算机无法直接进行数值运算。因此,NLP工程的核心任务在于将文本离散符号转化为承载语义的连续数值向量(Vectorization)。
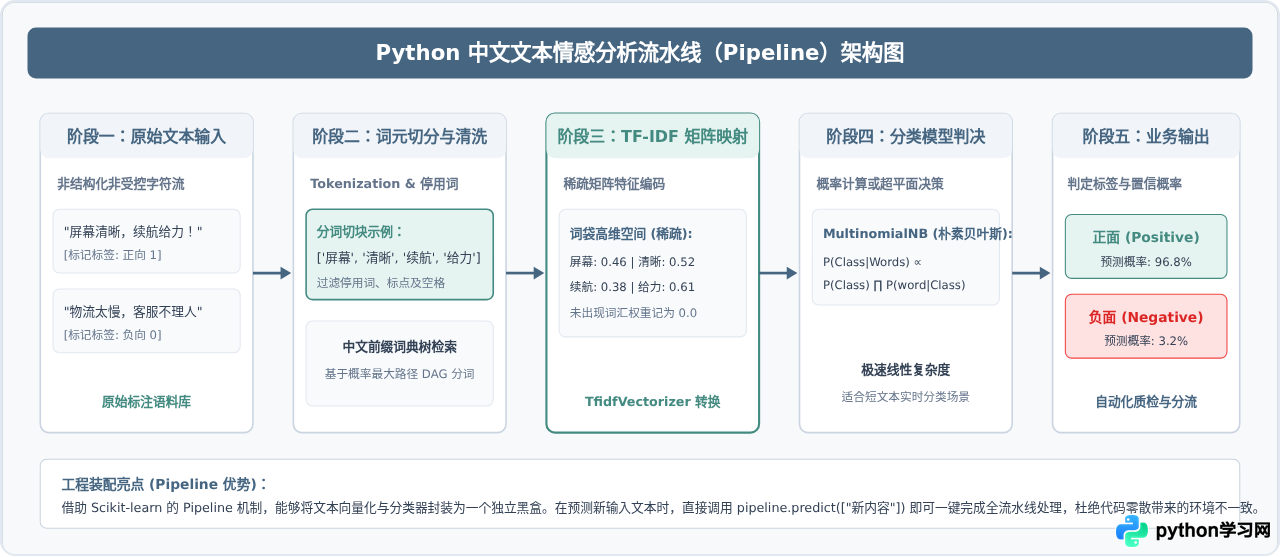
在中文文本处理中,由于中文词语之间没有天然的空格分隔符,必须首先经过分词阶段切分成独立的词元,再结合词频-逆文档频率(TF-IDF)算法赋予关键词更高的区分权重,最后送入概率分类器(如朴素贝叶斯)或线性支持向量机进行训练。
2. 完整实战示例:中文短文本情感分析流水线
在开发自然语言处理模块时,最推荐的做法是使用 sklearn.pipeline.Pipeline 将特征转换器(如 TF-IDF 编码器)和分类器打包为一个整体。以下代码演示了一个支持中文分词的情感倾向判断模型:
# -*- coding: utf-8 -*-
# 依赖库: pip install scikit-learn

from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.naive_bayes import MultinomialNB
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report
import re

# 1. 模拟中文电商/客服评论样本语料库(涵盖正向标签 1 与负向标签 0)
corpus = [
    "屏幕素质惊艳 响应极其迅捷 包装完好",
    "手感轻盈 续航持久 拍照非常清晰 值得推荐",
    "质量过硬 运行流畅 无任何卡顿 极度好评",
    "外观精致 设计非常现代 满意的一次购物",
    "按键失灵 严重发热 电池不到两小时就耗尽",
    "包装破损 屏幕存在明显划痕 体验极差",
    "客服回复敷衍 物流延误四天 无法正常开机",
    "做工粗糙 频繁死机 重启多次依然无效 退货"
]
labels = [1, 1, 1, 1, 0, 0, 0, 0]

# 2. 中文轻量级分词解析器(在无外部第三方分词包时使用正则词法切分,亦可替换为 jieba.cut)
def chinese_tokenizer(text):
    # 切分汉字与词素,保留 2 字及以上的有效中文片段
    tokens = re.findall(r'[\u4e00-\u9fa5]{2,}', text)
    return tokens

# 3. 构建全流程 Pipeline(TF-IDF 特征工程 + 朴素贝叶斯分类)
text_pipeline = Pipeline([
    ('tfidf', TfidfVectorizer(
        tokenizer=chinese_tokenizer,
        token_pattern=None,
        ngram_range=(1, 2),  # 同时捕获一元与二元词组(如"运行 流畅")
        max_features=100     # 限制特征字典维度
    )),
    ('classifier', MultinomialNB(alpha=0.1)) # 拉普拉斯平滑系数
])

# 4. 训练全流程模型
text_pipeline.fit(corpus, labels)

# 5. 测试未知评论的在线推断
test_samples = [
    "做工精良 运行流畅 没有卡顿",
    "严重发热 续航差 客服不解决问题"
]

predictions = text_pipeline.predict(test_samples)
probabilities = text_pipeline.predict_proba(test_samples)

print("=== 文本情感在线预测测试 ===")
for sample, pred, prob in zip(test_samples, predictions, probabilities):
    sentiment = "正面好评" if pred == 1 else "负面差评"
    confidence = prob[pred] * 100
    print(f"文本: '{sample}'")
    print(f"结论: {sentiment} | 置信概率: {confidence:.2f}%\n")
通过使用 ngram_range=(1, 2),模型不仅能识别单个词语“流畅”或“发热”,还能捕捉临近两个词构成的“严重发热”等复合语义特征。这对于短文本分类任务中消除语境歧义具有显著效果。
四、生产落地中的关键陷阱与防范规范
在实际生产环境中部署 Python 机器学习和 NLP 系统时,很多问题不是由算法理论造成的,而是由工程实施不当引发的。以下是三项最高频的工程隐患及其对应的防范措施:
| 隐患类别 | 具体表现形式 | 导致后果 | 工程规范与解决策略 |
|---|---|---|---|
| 数据泄露 (Data Leakage) | 在划分训练集与测试集前执行全局归一化(Fit)或全局向量化。 | 离线测试指标虚高(甚至100%),线上真实数据预测时准确率暴跌。 | 严格使用 Pipeline 组装组件,严禁在未经切分的全量数据上调用 fit()。 |
| 未登录词 (OOV Problem) | 推理阶段出现训练集词表中从未见过的生僻词或网络新词。 | 特征向量对应全 0,模型退化为纯先验概率判断,完全失去辨别力。 | 设定词频下限(min_df),引入字符级(Char-level)特征,或融合预训练词向量。 |
| 样本严重倾斜 (Class Imbalance) | 正反样本比例达到 1:50 以上(如异常流量检测、医疗罕见病筛查)。 | 模型倾向于将所有样本预测为多数类,对少数目标类彻底失效。 | 在模型参数中指定 class_weight='balanced',或使用 SMOTE 算法重采样。 |
五、Python 人工智能技术栈全景与选型建议
面对不同的业务体量和场景需求,合理的技术选型直接决定了开发周期的长短和维护成本的高低。Python 生态之所以在人工智能领域无处不在,正是因为其在从底层计算到底层部署的各个层级都拥有高度成熟的标准工具链。
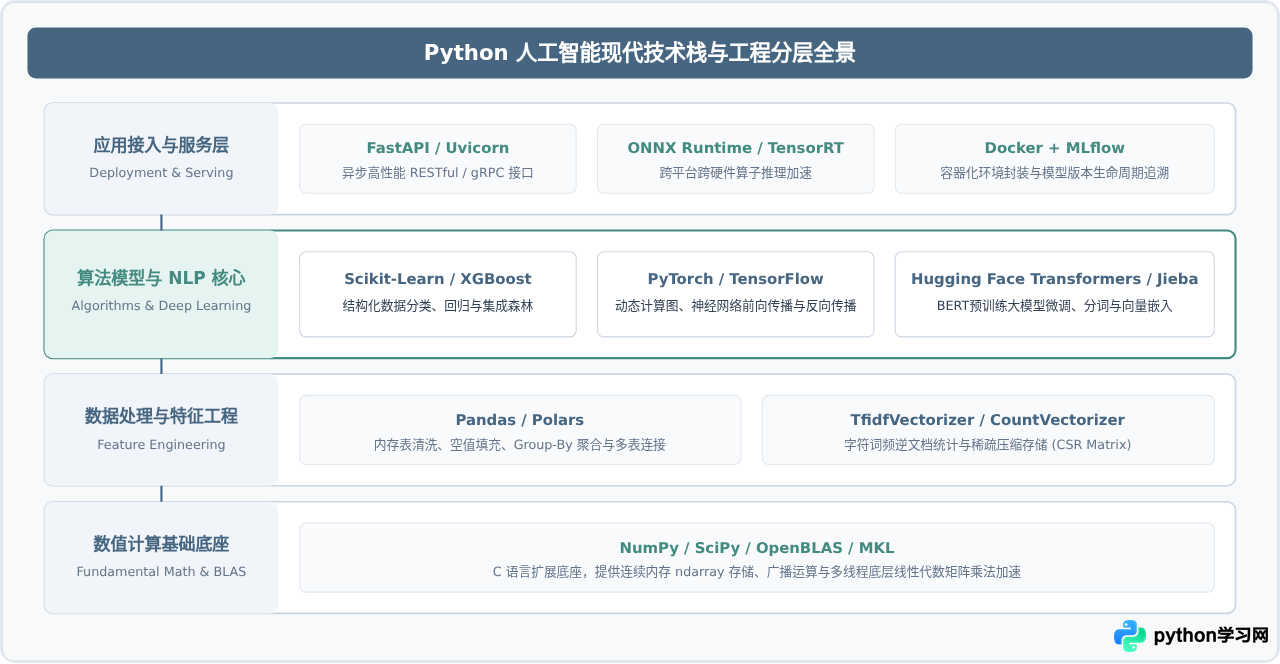
在实际项目落地时,建议开发者遵循“由简入深”的选型原则:
- 优先使用轻量经典模型验证业务价值:对于表格数据,优先选用随机森林或 LightGBM;对于短文本分类,优先选用 TF-IDF + 朴素贝叶斯或支持向量机。这类模型训练时间以秒计算,资源开销极小,易于快速验证业务假设。
- 在遇到明确瓶颈后再引入深度网络:当样本规模达到百万级、特征交互极其复杂,或者文本长语义依赖经典词袋无法很好表征时,再无缝演进至 PyTorch 搭建微调 BERT 或 Transformer 模型。
- 坚持流水线封装交付:无论模型算法本身多么复杂,向上层业务系统输出时,均应通过标准接口将特征预处理与模型推理串联,打包为可单次调用的制品,从而保证在线环境与离线研发环境行为完全一致。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















