


Python for循环遍历列表与while循环条件执行怎么选?
深入对比Python中for循环遍历列表与while循环条件执行的核心差异、执行模型与选择依据,帮助开发者在明确边界、状态变动和动态跳步场景下做出规范且优雅的代码决策。
在 Python 编程中,选择 for 还是 while 的基本法则非常明确:当遍历目标是已有容器(如列表、元组、字典)或执行次数在进入循环前已知时,优先选择 for 循环;当循环执行依赖于动态条件的状态改变、等待外部事件或需要非单调步进时,选择 while 循环。 掌握这一选型原则不仅能减少手写索引带来的越界与死循环风险,还能充分利用 Python 迭代器协议带来的性能与可读性优势。
一、核心机制与底层差异
虽然两种循环结构最终都可以完成“重复执行代码块”的任务,但它们背后的驱动机制截然不同。理解这一底层区别是避免滥用语法的前提。
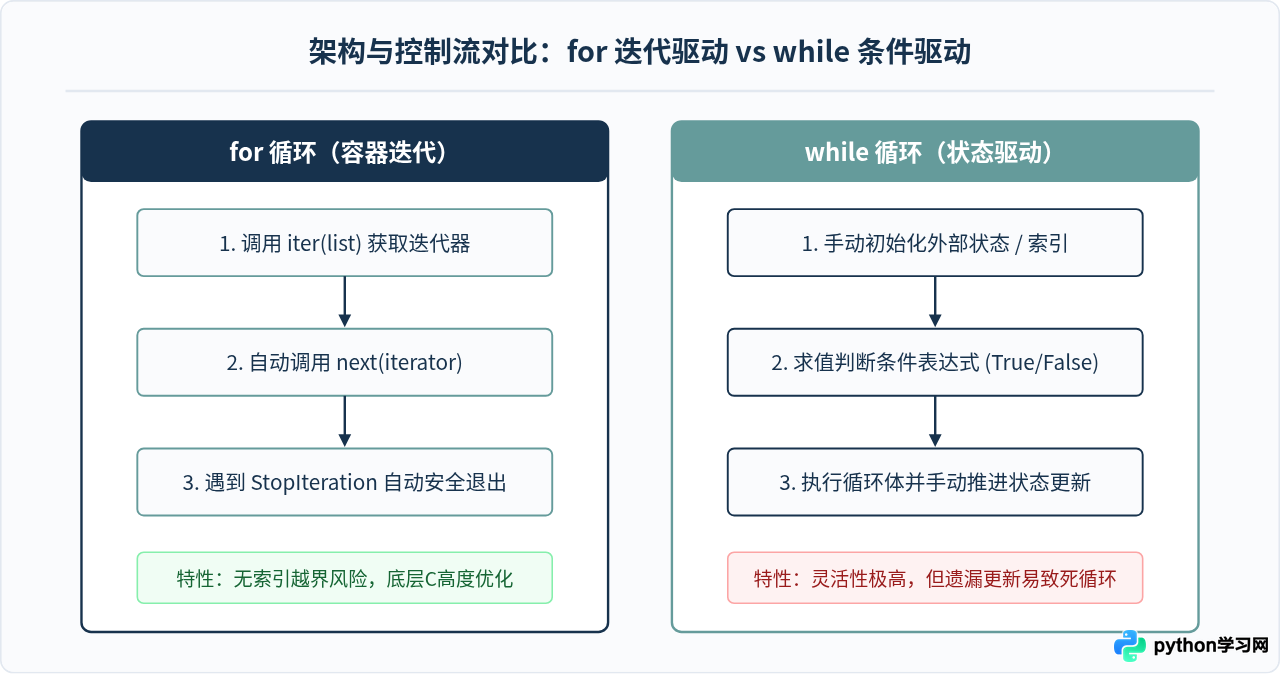
Python 的 for 循环本质上是一个迭代器驱动机制(Iterator Protocol)。当对列表执行 for item in my_list: 时,解释器首先调用内置的 iter(my_list) 获取迭代器,随后在每个迭代步中自动调用 next() 取得下一个元素,直到捕获到 StopIteration 异常自动退出。开发者无需介入索引计数或越界判断。
相比之下,while 循环是布尔条件驱动机制(Boolean Condition Loop)。它在每次循环体开始前评估指定的表达式。只要表达式值为 True,就会继续运行。它不关心数据结构本身的边界,循环变量的初始化、自增以及边界防御都由开发者手动维护。
二、选择依据与典型场景矩阵
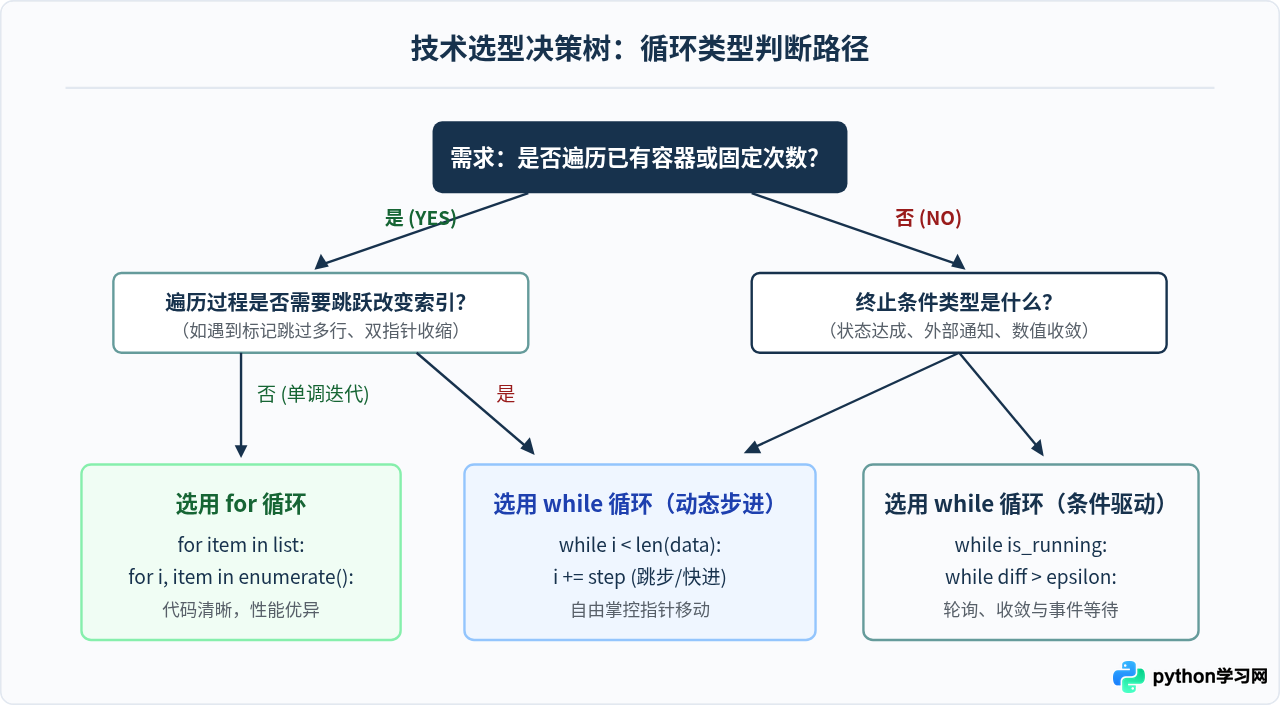
为了在实际编码中快速做出准确决断,我们可以从“数据是否有序固定”、“循环次数是否预知”以及“索引变动规则”三个维度进行对照:
| 判断维度 | for 循环适用场景 | while 循环适用场景 |
|---|---|---|
| 数据形态 | 已有固定序列(列表、元组、字符串、文件行) | 无边界生成数据、流式输入、动态队列 |
| 循环次数 | 已知固定次数(len(seq) 或 range(n)) |
未知次数,完全取决于何时触发终止条件 |
| 步进控制 | 单调向前(每个元素依次访问) | 动态步进(快进、后退、重试、双指针跳跃) |
| 代码安全性 | 天然免疫无限循环,无手动索引维护 | 依赖状态终止,需严格防范死循环与越界 |
以下决策树展示了从需求输入到选择循环结构的标准推导过程:
三、实操对照与代码示例
1. 列表遍历:为什么绝大多数情况应使用 for
初学者容易把 C 或 Java 风格的循环惯性带到 Python 中,使用 while i < len(my_list): 遍历列表。虽然结果一致,但这并非 Pythonic 的写法。
# 示例列表
servers = ["web-01", "web-02", "db-primary", "cache-01"]

# 【不推荐写法】:使用 while 循环模拟索引遍历
i = 0
while i < len(servers):
    server = servers[i]
    print(f"Checking server: {server}")
    i += 1  # 容易被遗漏导致死循环,且多余维护了变量 i

# 【推荐写法 1】:直接使用 for 遍历元素
for server in servers:
    print(f"Checking server: {server}")

# 【推荐写法 2】:如果同时需要索引与元素,使用 enumerate
for idx, server in enumerate(servers, start=1):
    print(f"Server #{idx}: {server}")
技术要点:for item in list: 直接在底层 C 层面由迭代器推进,没有 Python 字节码层面的索引计算与下标查找(BINARY_SUBSCR),执行速度通常比带索引的 while 循环快 20%~30%,并且杜绝了 IndexError。
2. 条件执行:必须选用 while 的场景
当满足终止条件的时刻无法预估,或者在循环过程中需要动态跳过若干元素时,while 才是不可替代的正确工具。
场景 A:动态跳步与标记解析
例如在解析命令行参数或令牌列表(Tokens)时,当遇到 --config 参数时,下一个元素必须作为参数值被消费,指针需要前进 2 步;普通参数则前进 1 步。这种非单调递增的场景若用 for 会难以控制:
# 动态跳步示例:解析参数
args = ["--verbose", "--config", "app.json", "--retry", "3", "--dry-run"]
i = 0

while i < len(args):
    arg = args[i]
    if arg in ("--config", "--retry"):
        value = args[i + 1]
        print(f"配置项 {arg} 的值为: {value}")
        i += 2  # 跳过当前项与对应值
    else:
        print(f"标志开关: {arg}")
        i += 1  # 正常前进 1 步
场景 B:状态收敛与轮询等待
在数学计算(如牛顿法求平方根)或轮询网络请求状态时,代码需反复运行直到误差小于阈值或任务完成:
# 状态收敛示例:牛顿迭代法求平方根
target = 25.0
guess = target / 2.0
epsilon = 0.00001

while abs(guess * guess - target) > epsilon:
    guess = (guess + target / guess) / 2.0

print(f"计算结果: {guess:.5f}")
四、操作步骤:重构反模式代码的标准流程
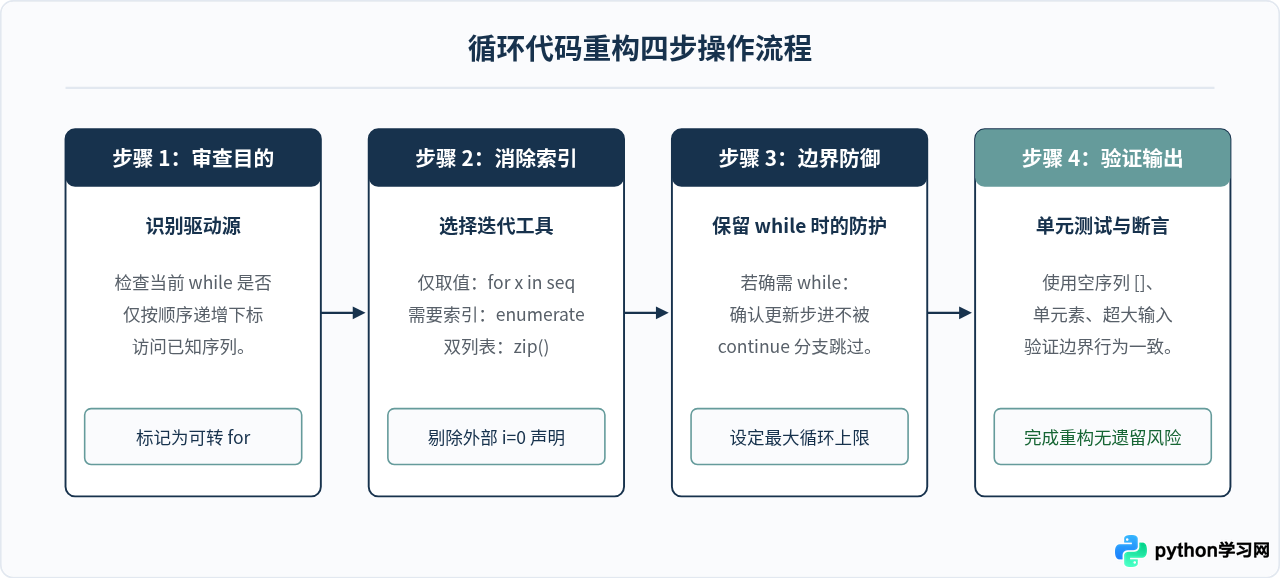
在现有代码维护中,常能见到混淆二者带来的坏味道(Code Smells)。以下是把不规范的条件或遍历循环重构成健壮代码的 4 个规范步骤:
五、避坑指南:两种循环的常见陷阱
陷阱 1:在 for 循环中修改当前正在遍历的列表
这是一个极具隐蔽性的错误。当遍历列表并在循环体内部执行 remove() 或 pop() 时,由于底层索引指针在持续向前,删除元素会导致后续元素前移,产生“跳过元素”现象:
# 【错误示例】:一边遍历一边原地删除
nums = [1, 2, 2, 3, 4]
for n in nums:
    if n == 2:
        nums.remove(n)  # 第二个 2 会被漏掉!
# 最终 nums 变成了 [1, 2, 3, 4],并未完全删除 2

# 【正确解决方式 A】:列表推导式生成新列表
nums = [n for n in nums if n != 2]

# 【正确解决方式 B】:切片遍历原列表副本
for n in nums[:]:
    if n == 2:
        nums.remove(n)
陷阱 2:while 循环中 continue 跳过了状态更新
在 while 循环体中,如果把状态自增语句放在分支条件下方,一旦触发 continue,程序将直接跳回条件判定处,导致自增语句永远无法执行,进而陷入死循环:
# 【危险示例】:continue 导致死循环
i = 0
items = [10, -1, 20, 30]
while i < len(items):
    if items[i] < 0:
        continue  # i 没有自增,下一次循环 i 依然不变,直接陷入死循环!
    print(items[i])
    i += 1

# 【安全修复】:确保更新动作无论如何都会触发,或改写为 for 循环
for item in items:
    if item < 0:
        continue
    print(item)
六、全文总结
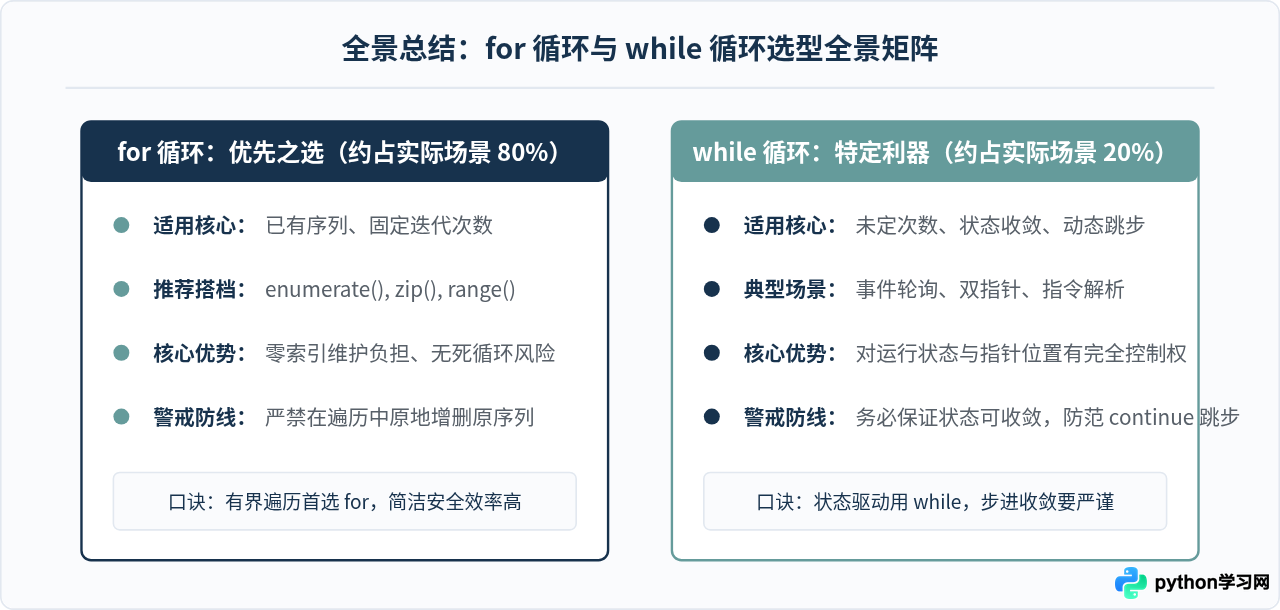
编写高质量 Python 代码的核心哲学之一是“简洁与确定”。通过以下图示对两种循环进行综合对比与总结:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















