


Python爬虫标准步骤详解:requests与BeautifulSoup实战
系统详解Python网络爬虫的标准开发步骤,涵盖请求构建、HTML解析、DOM树节点检索、数据清洗与持久化存储,结合requests与BeautifulSoup给出完整实战代码与容错方案。
编写网络爬虫的本质,就是通过程序自动化完成“发送网络请求、下载网页源代码、定位关键数据节点、清洗并保存结构化数据”这套闭环动作。在 Python 数据采集中,requests 负责与服务端建立 HTTP 通信并获取原始内容,BeautifulSoup 则负责将扁平的文本解析为具备层级关系的 DOM 树,进而快速检索数据。本文围绕这一经典组合,拆解标准爬虫流程的五个核心环节,并结合完整可执行的实战代码说明落地要点与容错技巧。
一、爬虫标准工作流全景剖析
任何稳健的爬虫程序都不是直接生搬硬套代码,而是遵循明确的阶段划分。一个标准的数据抓取周期包含五个步骤:目标页面分析、构建并发送网络请求、构建 DOM 解析树、节点检索与属性清洗,以及结构化存储与频控保护。
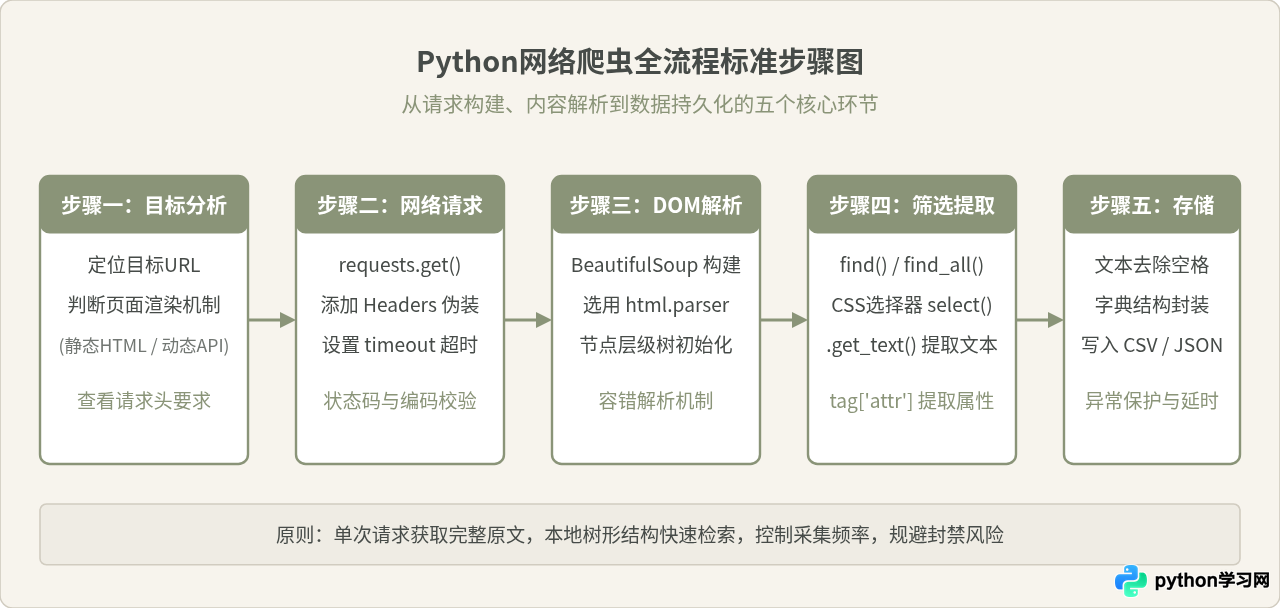
requests.get() 就一定能抓到。这仅适用于服务端直接渲染返回完整 HTML 的“静态页面”。如果目标网站使用 Vue、React 等单页架构,或在页面加载后通过 AJAX 异步拉取 JSON 数据,requests.get() 拿到的往往只是一段骨架脚本。在写代码前,务必先在浏览器中右键“查看网页源代码”(而非审查元素),确认目标数据是否存在于服务端返回的原始 HTML 中。
二、使用 requests 发起可靠的网络请求
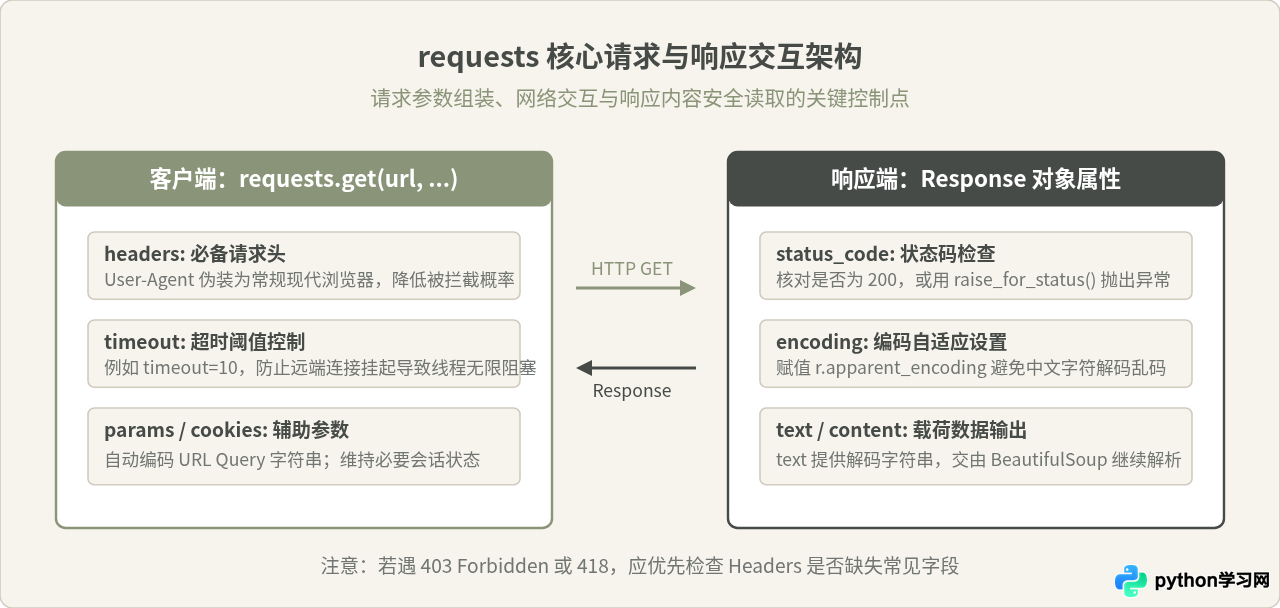
requests 是 Python 事实上的 HTTP 客户端标准库。要发出一份规范且不易被服务端拦截的请求,需要处理好三个关键要素:请求头伪装(Headers)、网络超时控制(timeout)以及字符编码适配(encoding)。
1. 请求头伪装与防拦截基础
默认情况下,requests 发出的 HTTP 请求头中的 User-Agent 会显示为 python-requests/x.x.x。多数服务器的安全策略会直接拦截带有此标识的流量,返回 403 Forbidden。因此,显式声明真实的浏览器 User-Agent 是爬虫开发的基准要求。
2. 超时参数(timeout)的重要性
在网络状况不稳定或服务端限流时,未设置 timeout 的请求可能永久挂起,导致后续的所有采集任务完全停滞。推荐设置一个明确的超时阈值(如 10 秒),并在外层捕获 requests.exceptions.Timeout 异常。
3. 中文乱码处理机制
访问部分国内网站时,response.text 可能会解析出乱码。这是因为 requests 默认通过 HTTP 标头推断编码,当标头未指定编码时常猜测为 ISO-8859-1。解决办法是在读取文本前执行 response.encoding = response.apparent_encoding,让底层利用内容特征重新测定字符集(如 UTF-8 或 GBK)。
import requests

url = "https://example.com/articles"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

try:
    response = requests.get(url, headers=headers, timeout=10)
    response.raise_for_status()  # 若状态码非 200 系列则抛出 HTTPError
    response.encoding = response.apparent_encoding  # 自动修正中文编码
    html_content = response.text
    print("网页下载成功,字节数:", len(html_content))
except requests.exceptions.RequestException as e:
    print(f"请求失败:{e}")
    html_content = None
三、使用 BeautifulSoup 解析与定位 DOM 节点
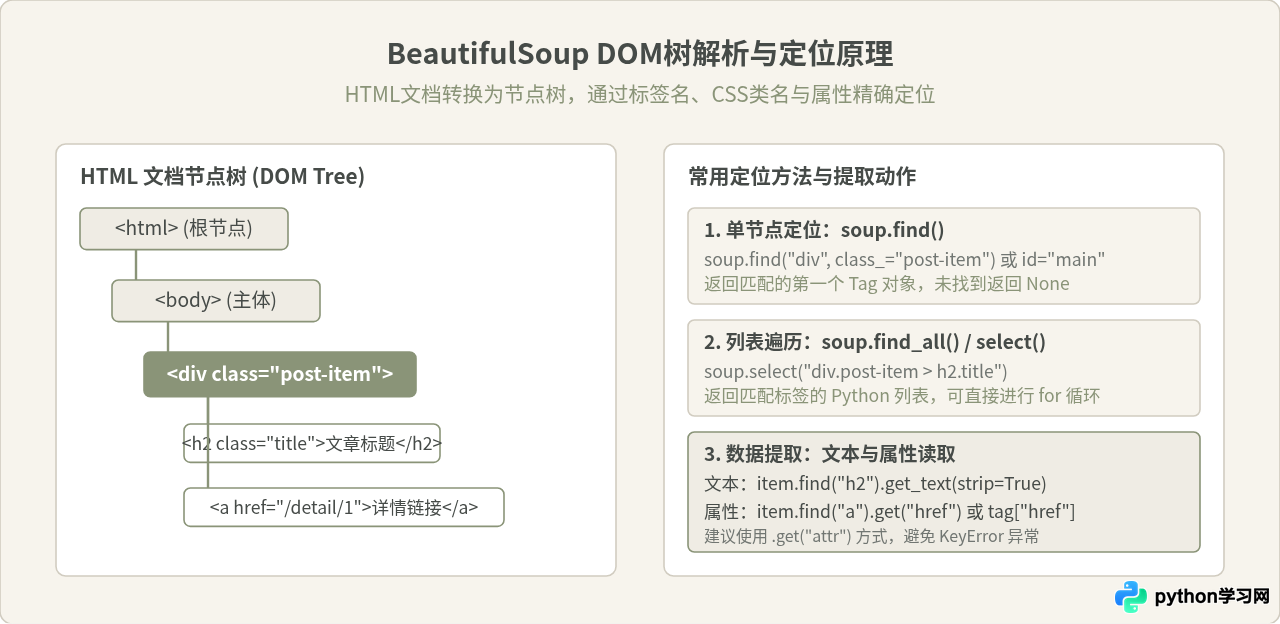
获取到原始 HTML 字符串后,下一步是使用 BeautifulSoup 将其转换为树状对象模型。解析库内部将每一个 HTML 标签(如 <div>、<a>)抽象为节点对象,并提供丰富的查找接口。
1. 解析器选择:html.parser 与 lxml
初始化 BeautifulSoup 时需要指定底层解析引擎:
html.parser:Python 语言自带的内置解析器,无需额外安装第三方二进制依赖,容错性适中,适合初学和常规页面。lxml:基于 C 语言 libxml2 库封装,解析速度极快且对畸变 HTML 的容错性极强。在处理大型页面或对性能有要求时推荐安装(pip install lxml)并传入"lxml"。
2. 定位 API 对比与选择
检索节点主要有两大流派,其特性对比如下:
| 方法名称 | 调用形式 | 返回值类型 | 适用场景 |
|---|---|---|---|
find() |
soup.find('div', class_='box') |
单个 Tag 或 None |
页面中只有唯一的容器、详情页正文块或首个元素 |
find_all() |
soup.find_all('li', class_='item') |
Tag 列表(list) | 多条规整的列表数据遍历,按属性名精确过滤 |
select_one() |
soup.select_one('div.main > h1') |
单个 Tag 或 None |
复杂父子层级定位、兄弟选择器场景 |
select() |
soup.select('ul.list > li.item') |
Tag 列表(list) | 习惯前端 CSS 选择器写法的场景,支持多级复合路径 |
四、文本抽取、属性清洗与防空处理
在批量处理抓取结果时,代码崩溃往往不是发生在网络请求阶段,而是在解析节点的微观阶段。以下是三条必须遵守的防御性编程规范:
1. 属性安全获取:避免 KeyError
获取 <a> 标签的 href 或 <img> 的 src 时,直接使用下标方式(如 tag['href'])存在隐患。如果某些异常节点缺失该属性,脚本将直接抛出 KeyError 并崩溃退出。标准做法是调用 tag.get('href', ''),在属性不存在时平稳返回空字符串或默认值。
2. 文本清洗:使用 get_text(strip=True)
直接读取 tag.text 会保留 HTML 原文中由于代码缩进产生的大量换行符(\n)和多余空格。调用 tag.get_text(strip=True) 可以自动完成内部剥离,返回干净整洁的段落文字。
3. 空值检查:避免 AttributeError: 'NoneType' object has no attribute
当某一小节结构与预期不符时,find() 会返回 None。如果紧接着调用 .get_text(),就会引发经典的 NoneType 错误。因此,在二级定位时应加入守卫判断:
# 防御性抽取示例
title_node = item.find('h2', class_='title')
title = title_node.get_text(strip=True) if title_node else "无标题"

link_node = item.find('a')
link = link_node.get('href', '').strip() if link_node else ""
五、端到端完整实战范例
下面给出一段整合了前述全部规范的完整爬虫程序。代码模拟从一个新闻列表页采集文章标题、链接与摘要,并持久化写入标准的 CSV 文件中:
import csv
import time
import requests
from bs4 import BeautifulSoup

def fetch_and_parse_articles(target_url):
    """
    爬虫标准执行函数:请求、解析、清洗与数据返回
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
    }

    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        response.raise_for_status()
        response.encoding = response.apparent_encoding
    except requests.exceptions.RequestException as err:
        print(f"[错误] 请求网页失败: {err}")
        return []

    soup = BeautifulSoup(response.text, "html.parser")
    # 假定每个文章条目由 class 为 post-card 的 div 包裹
    cards = soup.find_all("div", class_="post-card")
    print(f"[提示] 定位到 {len(cards)} 个文章节点")

    results = []
    for card in cards:
        # 1. 抽取标题
        title_el = card.find("h2", class_="post-title")
        title = title_el.get_text(strip=True) if title_el else "未知标题"

        # 2. 抽取链接
        link_el = card.find("a", href=True)
        link = link_el["href"].strip() if link_el else ""

        # 3. 抽取摘要信息
        desc_el = card.find("p", class_="post-summary")
        summary = desc_el.get_text(strip=True) if desc_el else "无摘要"

        results.append({
            "title": title,
            "link": link,
            "summary": summary
        })

    return results

def save_to_csv(data_list, output_filepath):
    """
    结构化保存为 CSV,使用 utf-8-sig 编码防止 Excel 打开中文乱码
    """
    if not data_list:
        print("[提示] 无数据可供保存")
        return

    fieldnames = ["title", "link", "summary"]
    with open(output_filepath, mode="w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fieldnames)
        writer.writeheader()
        writer.writerows(data_list)
    print(f"[成功] 成功导出 {len(data_list)} 条记录至 {output_filepath}")

if __name__ == "__main__":
    target = "https://example.com/blog/page/1"

    # 执行抓取
    extracted_data = fetch_and_parse_articles(target)

    # 持久化存储
    save_to_csv(extracted_data, "articles_data.csv")

    # 爬取礼节:如果有多页循环,务必添加停顿
    time.sleep(1.5)
六、稳健爬虫工程化准则总结
能够单次跑通的脚本距离真正工程化可用的爬虫还有一段距离。在编写实际任务时,应始终围绕伪装、容错、防空和频控四个维度进行自检。
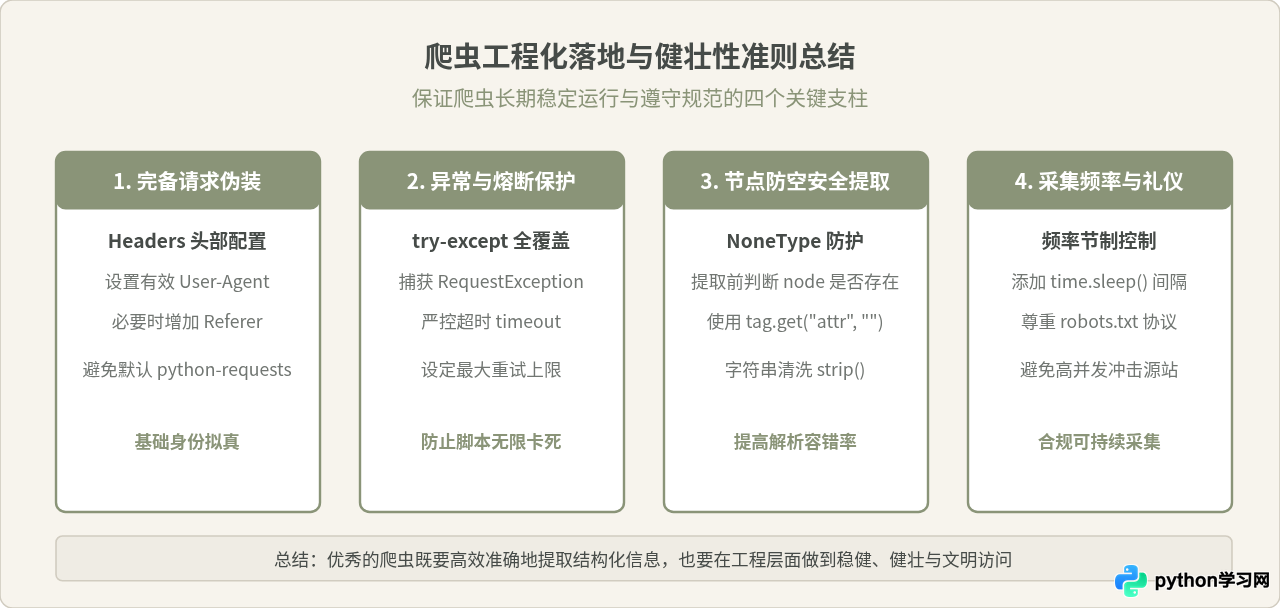
/robots.txt 协议,避开明确禁止抓取的目录;控制并发度与请求频率,在循环中加入适当的 time.sleep() 延时,不给源站服务器增加超额负载;对于涉及个人隐私、用户登录鉴权和受版权保护的内容,切勿随意抓取或用于非法商业用途。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















