


Python fnmatch实现字符串通配符匹配
深入解析Python标准库fnmatch模块,掌握*、?、[seq]通配符语法,理解fnmatch、fnmatchcase、filter及translate函数原理与跨平台大小写处理方案。
在日常数据清洗、日志筛选或配置文件解析过程中,我们常常需要根据特定模式匹配字符串。如果仅使用字符串的 startswith() 或 endswith() 方法,遇到多变或中间含有占位符的规则就会力不从心;而直接引入正则表达式模块 re 又往往会因规则繁琐、转义字符繁多而增加维护成本。Python 标准库自带的 fnmatch 模块提供了一种轻量高效的解决方案——它支持标准的 Unix Shell 风格通配符(Glob 语法),允许开发者直接在内存中使用 *、?、[seq] 等直观符号对任意字符串执行模式匹配。本文将系统拆解 fnmatch 的通配符语法、核心 API、跨平台大小写差异及其实际应用边界。
一、核心通配符语法与匹配规则
假设系统导出了大量业务报表,文件名包含业务名称、日期与版本后缀,如 order_report_202603.csv、user_summary_v2.xlsx、order_archive_2025.bak。若需要从上万条文件名记录中仅提取以 order_ 开头且为 CSV 格式的文件,使用通配符 order_*.csv 即可精准表达目标模式。
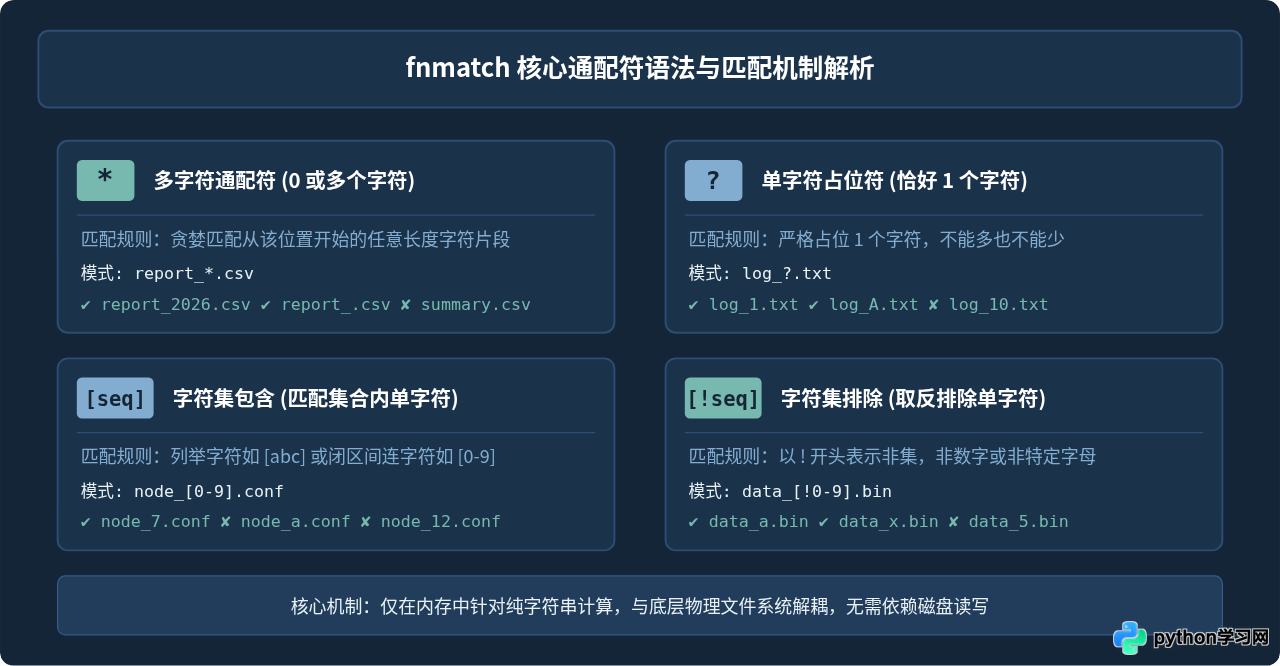
fnmatch 严格遵循 Unix 文件名通配规范(Filename Pattern Matching),支持的通配语法简洁明确,核心符号包括:
| 通配符 | 匹配规则描述 | 示例模式 | 匹配成功示例 | 匹配失败示例 |
|---|---|---|---|---|
* |
匹配 0 个或任意多个任意字符 | *.log |
app.log、sys.error.log |
app.log.bak |
? |
精确匹配恰好 1 个任意字符 | data_?.csv |
data_1.csv、data_A.csv |
data_12.csv、data_.csv |
[seq] |
匹配指定字符集中的任意 1 个字符,支持范围连字符 - |
node_[0-9].conf |
node_1.conf、node_8.conf |
node_a.conf、node_10.conf |
[!seq] |
匹配任意不在指定字符集中的 1 个字符(取反模式) | file_[!0-9].txt |
file_a.txt、file_Z.txt |
file_3.txt |
[^0-9];而在 Unix 通配符与 fnmatch 中,取反必须使用感叹号 [!0-9]。如果误写成 [^0-9],系统会将其视为匹配字符 ^ 以及 0-9 范围内的普通字符。
二、fnmatch 模块四个核心函数详解
fnmatch 模块的设计极为精炼,主要包含四个函数:fnmatch()、fnmatchcase()、filter() 和 translate()。理解它们各自的职责与行为边界,是写出稳定代码的前提。
1. fnmatch.fnmatch(name, pat):遵循操作系统的通用匹配
fnmatch.fnmatch(name, pat) 接收被检验的目标字符串 name 和通配规则 pat,返回布尔值(True 或 False)。该函数最突出的特点在于:它的大小写敏感性取决于底层操作系统。
- Windows 系统:文件系统通常大小写不敏感,因此在 Windows 上,
fnmatch.fnmatch('DATA.CSV', '*.csv')会返回True。 - Linux / macOS(POSIX):标准文件系统严格区分大小写,因此相同代码在 Linux 下会返回
False。
import fnmatch

# 检查文件名是否符合日志规则
filename = "server_error.LOG"

# 在 Windows 上返回 True,在 Linux/macOS 上返回 False
is_matched = fnmatch.fnmatch(filename, "*.log")
print(f"fnmatch 匹配结果: {is_matched}")

# 示例输出(Linux/macOS 环境):
# fnmatch 匹配结果: False
2. fnmatch.fnmatchcase(name, pat):严格区分大小写的确定性匹配
如果程序需要跨平台保持完全一致的运行结果,或者所匹配的字符串并不是文件名(例如 HTTP 头字段、Token、URL 查询参数、内部消息类型),必须使用 fnmatchcase()。它无论在任何操作系统下都严格区分大小写。
import fnmatch

filename_upper = "DATA_2026.CSV"
filename_lower = "data_2026.csv"
pattern = "*.csv"

# 跨平台严格区分大小写
print("Upper:", fnmatch.fnmatchcase(filename_upper, pattern))
print("Lower:", fnmatch.fnmatchcase(filename_lower, pattern))

# 示例输出:
# Upper: False
# Lower: True
3. fnmatch.filter(names, pat):高效批量列表过滤
当需要从一个包含数千个元素的字符串列表中筛选出符合条件的子集时,手动编写循环或列表推导式逐个调用 fnmatch() 虽然可行,但 fnmatch.filter(names, pat) 在 CPython 内部做了专门的优化,执行效率显著更高。该函数返回一个新的列表,其中仅包含匹配成功的项。
import fnmatch

file_list = [
    "backup_20260101.tar.gz",
    "backup_20260102.zip",
    "temp_dump.sql",
    "backup_20260103.tar.gz",
    "notes.txt"
]

# 批量提取所有以 backup_ 开头的 tar.gz 归档包
matched_backups = fnmatch.filter(file_list, "backup_*.tar.gz")
print("匹配的备份列表:", matched_backups)

# 示例输出:
# 匹配的备份列表: ['backup_20260101.tar.gz', 'backup_20260103.tar.gz']fnmatch.filter() 内部遵循的是与 fnmatch() 相同的系统规范(依赖底层操作系统的规范化函数 os.path.normcase)。如果需要严格区分大小写的批量过滤,可以通过列表推导式搭配 fnmatchcase 实现:[name for name in names if fnmatch.fnmatchcase(name, pat)]。
4. fnmatch.translate(pat):将通配符转换为正则表达式
fnmatch.translate(pat) 是 fnmatch 模块的底层基石。它的作用是将给定的 Shell 通配符模式编译翻译为与之完全等价的标准正则表达式字符串。返回的字符串可以直接传递给 Python 的 re.compile()。
import fnmatch
import re

pattern = "node_??.log"
regex_str = fnmatch.translate(pattern)
print("转换后的正则表达式:", regex_str)

# 配合 re 模块执行高级正则匹配或检索
regex_obj = re.compile(regex_str)
print("正则匹配结果:", bool(regex_obj.match("node_01.log")))

# 示例输出:
# 转换后的正则表达式: (?s:node_..\.log)\Z
# 正则匹配结果: True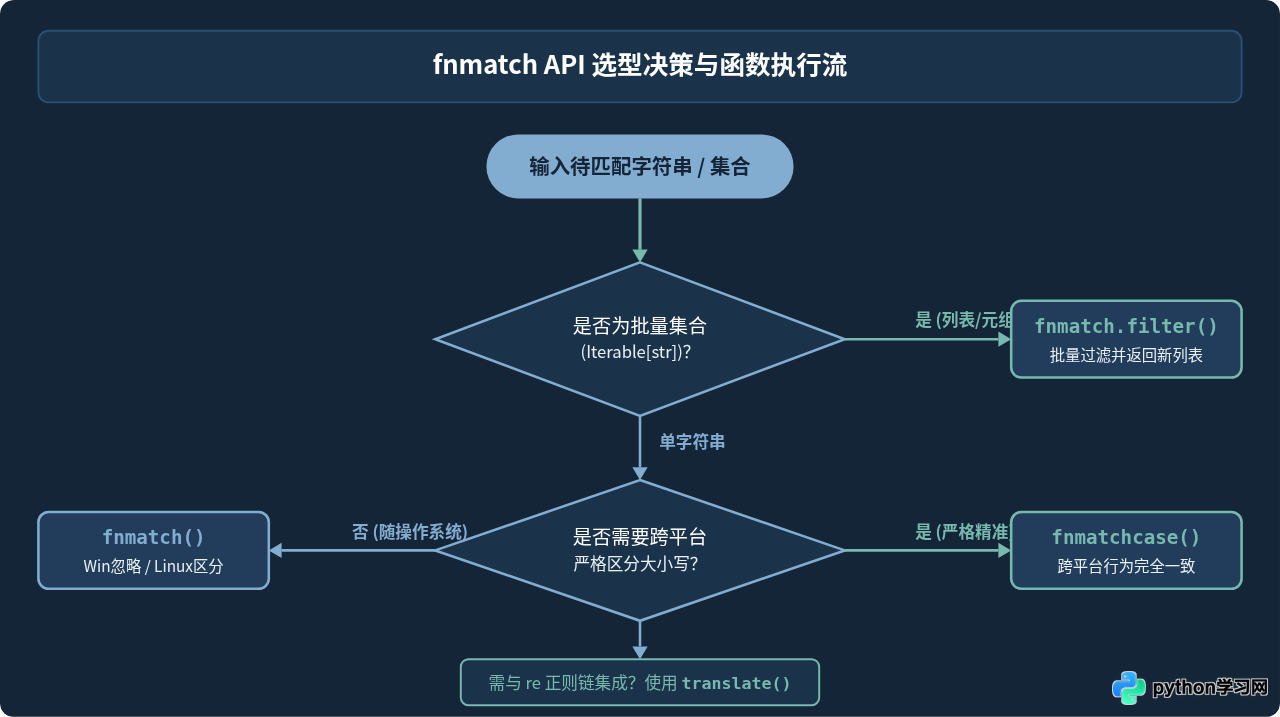
三、深入机制:translate() 翻译转换与底层原理
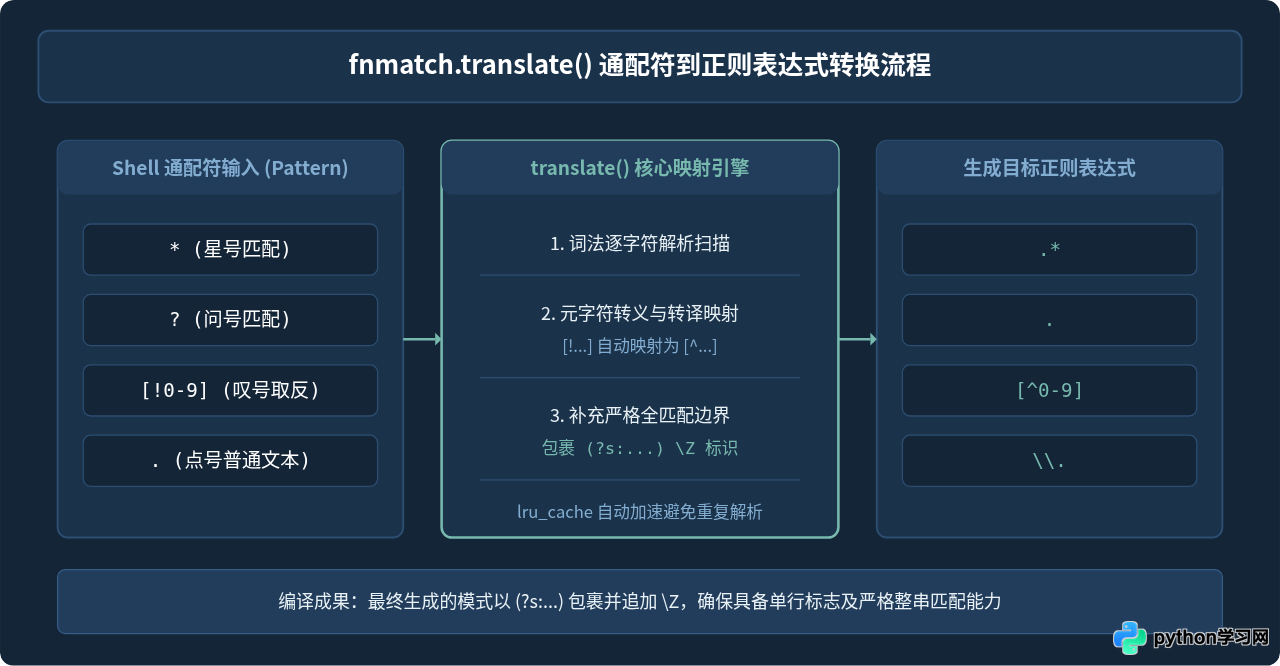
许多开发者好奇:fnmatch 既不是编译型 DSL,也没有自己实现复杂的语法解析器,它是如何做到快速匹配的?答案是:fnmatch 本质上是基于正则表达式引擎的一层优雅包装。
当调用 fnmatch('app.py', '*.py') 时,底层经历了以下三个阶段:
- 模式翻译:通过
fnmatch.translate('*.py'),通配符模式被自动翻译为正则表达式。在现代 Python(3.6+)中,*.py会被翻译为(?s:.*\\.py)\\Z。 - 正则表达式编译与缓存:
fnmatch内部使用functools.lru_cache维护了预编译正则对象(最多缓存 256 或更多规则)。这意味着频繁使用相同的模式不会造成重复编译开销。 - 全词正则匹配:利用编译好的正则对象调用
.match()方法匹配字符串。由于正则表达式末尾带有\\Z,它会从头到尾进行严格全匹配,不会只匹配子串。
以下是通配符符号与翻译后正则表达式元字符的对应关系:
| Shell 通配符模式 | 翻译后的正则表达式 | 转换意图解释 |
|---|---|---|
* |
(?s:.*) 或 .* |
允许点号匹配任意字符(包括换行符)且匹配零次或多次 |
? |
(?s:.) 或 . |
匹配任意恰好一个字符 |
[abc] |
[abc] |
保持原生字符集合 |
[!abc] |
[^abc] |
感叹号 ! 被自动转译为正则表达式的脱字符 ^ |
普通特殊字符(如 .) |
\\. |
自动添加反斜杠转义,防止点号被误当成正则任意匹配符 |
| 整体边界包裹 | (?s:...)\\Z |
\\Z 强制保证字符串必须完整匹配到末尾 |
四、实际开发中的常见陷阱与注意事项
虽然 fnmatch 语法直观,但在工程实践中若不注意以下细节,极易引发难以排查的问题。
1. 路径分隔符穿透问题(重要区别于 Shell)
在 Bash 或 Zsh 等 Shell 中,普通通配符 * 是不会跨越目录分隔符 / 的;若想跨级匹配通常需要开启 globstar(**)。但 fnmatch 纯粹将输入视为普通扁平文本,对 / 或 \ 没有特殊认知。这意味着:* 会直接匹配包含路径斜杠的整串字符!
import fnmatch

path = "controllers/v1/auth/login.py"

# 在 Bash 中 "controllers/*.py" 无法匹配到两层深度的文件
# 但在 fnmatch 中,由于 * 匹配任意字符,此处将返回 True!
result = fnmatch.fnmatch(path, "controllers/*.py")
print("穿透匹配结果:", result)

# 示例输出:
# 穿透匹配结果: True避坑指南:如果需要按物理文件路径的层级结构进行匹配,请使用标准库的 glob 或 pathlib.Path.glob();若必须用 fnmatch 校验路径,应先使用 os.path.basename() 或 pathlib.Path.name 剥离目录前缀,仅对文件名进行判定。
2. 跨平台测试一致性隐患
很多开发者在本地 Windows 设备上开发,使用 fnmatch.fnmatch(name, "*.jpg") 测试 photo.JPG 时一切正常通过;但一旦部署到 Linux 容器或生产服务器上,由于 Linux 文件系统区分大小写,代码立即出现找不到文件或漏匹配的严重故障。
避坑指南:凡是业务规则要求“必须忽略大小写”或“必须区分大小写”的场景,都不要依赖 fnmatch() 的默认行为。一律使用 fnmatchcase(),并在需要忽略大小写时显式预先转换:fnmatch.fnmatchcase(name.lower(), pattern.lower())。
五、模式匹配选型指南与全景总结
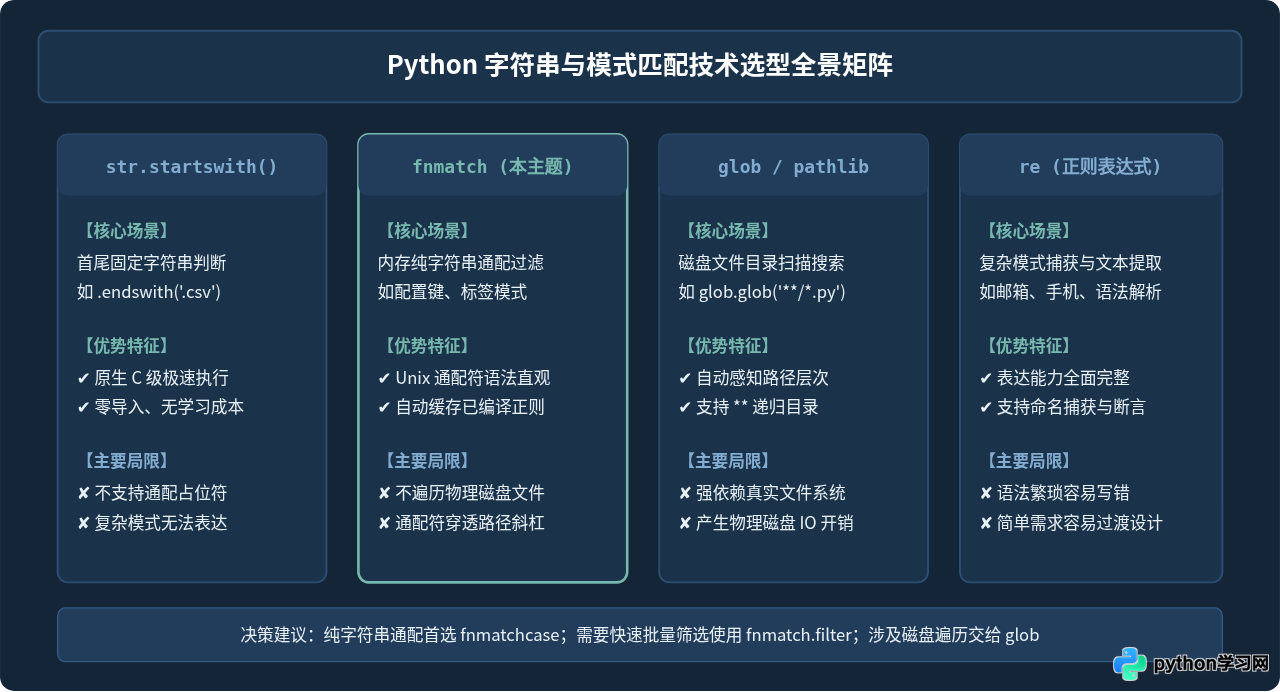
在 Python 体系中,涉及模式匹配与查找的工具有很多,明确各个方案的职责边界能够帮助我们以最低的代码复杂度完成任务:
str.startswith()/str.endswith():适用于模式固定、没有动态通配字符的场景。执行速度最快,开销最小。fnmatch模块:适用于内存中任意字符串的通配匹配,支持标准 Shell 语法。无需访问磁盘,轻量灵活。glob模块:专用于操作系统文件系统。它负责扫描物理磁盘目录并返回匹配的文件路径列表,其底层正是基于fnmatch与os.scandir构建。re模块:适用于复杂的文本解析、提取分组、条件断言或需要高度定制语法规则的场景。功能最强大,但开销与认知负担最高。
总结
Python fnmatch 模块在简单字符串判断与庞大复杂的正则表达式之间取得了完美的平衡。掌握 *、?、[seq] 与 [!seq] 四种通配符,能够在数据清洗、配置分发和批处理任务中极大地简化代码逻辑。牢记 fnmatchcase() 在跨平台开发中的确定性优势,并警惕通配符跨越路径斜杠的特性,就能在日常 Python 编程中游刃有余地实现精准的通配符匹配。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















