


Python快速初始化全0、全1或指定范围数组的技巧
深入讲解Python中快速初始化全0、全1、常数值及指定数值范围数组的实用技巧,涵盖标准库与NumPy方案,剖析多维列表浅拷贝陷阱与浮点步长误差。
在 Python 编程中,快速构建特定初值的数组或列表是高频的基础操作,无论是算法刷题、动态规划矩阵建表,还是科学计算与数据批处理,合理的初始化方式能够兼顾代码执行效率与可维护性。针对纯 Python 标准库和第三方科学计算库 NumPy 两种技术栈,初始化的具体手段、底层内存机制以及避坑要点各不相同。本文将系统拆解全 0、全 1、常数值及指定范围数值序列的高效初始化技巧,并深度剖析多维列表浅拷贝陷阱与浮点步长误差成因。
一、纯 Python 环境下的数组与列表初始化
在不引入外部库的前提下,Python 主要依靠内置列表(list)、bytearray 或 array 模块进行数组初始化。不同方式在语法简洁度、内存消耗与执行速度上存在明显差异。
1. 一维列表的简洁乘法初始化
对于一维列表,直接利用序列乘法运算符是最直观且性能优异的方式。该操作在底层直接完成内存块分配与连续指针赋值,执行速度远高于使用循环 append 操作:
# 初始化长度为 5 的全 0 列表
zeros_1d = [0] * 5
# 输出示例: [0, 0, 0, 0, 0]

# 初始化长度为 5 的全 1 列表
ones_1d = [1] * 5
# 输出示例: [1, 1, 1, 1, 1]

# 初始化任意指定常数值
filled_1d = [99] * 5
# 输出示例: [99, 99, 99, 99, 99]
由于数字 0、1 在 Python 中属于不可变标量(Immutable Objects),修改一维列表中的某个元素(如 zeros_1d[0] = 8)实际上是让索引 0 指向新的整数对象,完全不会影响其他索引位置的值。
2. 多维列表的致命陷阱:乘法浅拷贝
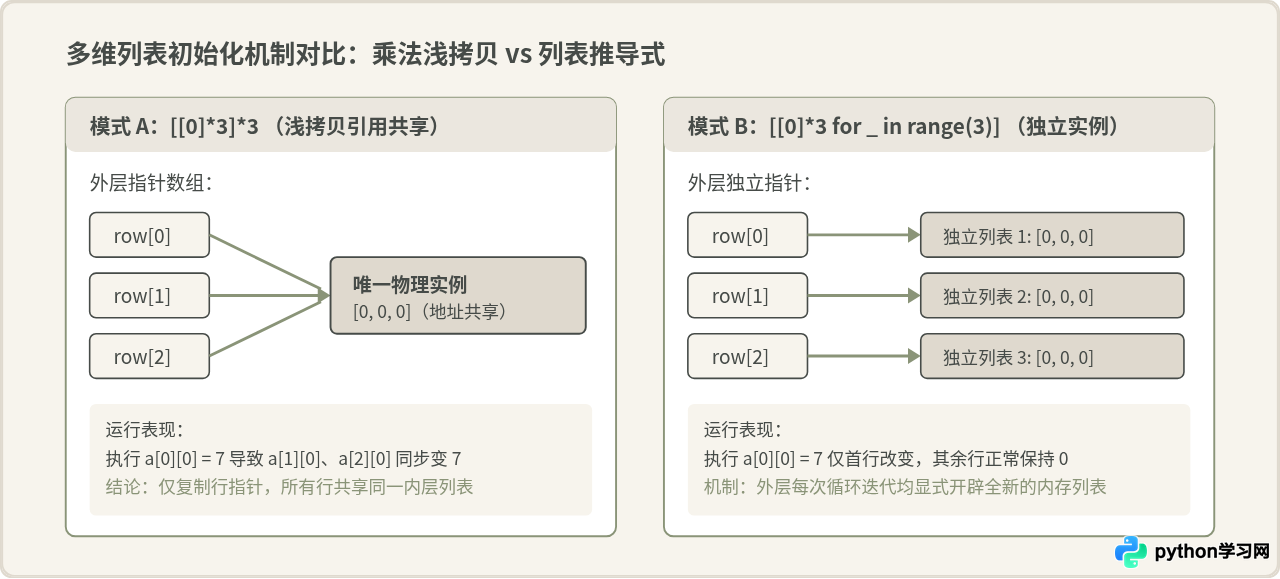
不少初学者在构建 m × n 的二维矩阵时,会直觉性地套用一维乘法语法,写出类似 [[0] * 3] * 3 的代码。这种写法能够生成表面结构正确的二维列表,但在进行元素修改时会暴露出灾难性的副作用。
# 错误示例:浅拷贝复制行引用
bad_matrix = [[0] * 3] * 3

# 试图只修改第 0 行第 0 列的元素
bad_matrix[0][0] = 7

# 输出实际结果
print(bad_matrix)
# 示例输出: [[7, 0, 0], [7, 0, 0], [7, 0, 0]]
从输出中可以看到,本意仅修改 bad_matrix[0][0],结果三行的首个元素全部变为了 7。其根本原因在于:[0] * 3 在内存中创建了一个包含三个 0 的列表对象,而外层的 * 3 只是复制了该列表对象的指针引用三次。外层列表中存储的三个元素,本质上全部指向同一个物理内存列表。下图直观展示了该引用共享机制与正确做法的差异:
3. 正确构造二维矩阵的列表推导式
构建 rows 行、cols 列的独立二维列表,标准且安全的方法是使用外层列表推导式:
rows = 3
cols = 4

# 正确写法:外层推导式确保每行均为全新对象
good_matrix = [[0] * cols for _ in range(rows)]

# 验证单点修改
good_matrix[0][0] = 5
print(good_matrix)
# 示例输出: [[5, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]在这个推导式中,[0] * cols 负责快速构造一维基本行,而外层的 for _ in range(rows) 则驱动 Python 在每次循环中分别执行一次独立的一维列表实例化,从而彻底切断各行之间的内存关联。
4. 追求超低内存占用的原生方案:bytearray 与 array.array
Python 原生 list 本质是指针数组,每个元素保存的是指向整型对象的指针,单个元素实际开销高达数十字节。若在无外部依赖环境下处理超大规模的全 0 字节或纯数值序列,标准库的 bytearray 与 array 模块能节省超过 80% 的内存:
import array

# 方案 A: 快速开辟 100 万个全 0 字节(内存占用正好为 1MB)
zero_bytes = bytearray(1_000_000)

# 方案 B: 构造 100 万个 32 位有符号整数的全 0 连续数组
zero_int_array = array.array('i', [0]) * 1_000_000
二、基于 NumPy 科学计算库的高性能初始化
当数组规模达到十万级以上,或需要参与矢量化线性代数运算时,标准库列表将难以满足计算吞吐需求。NumPy 底层由 C 语言连续内存块支持,提供了专用且高度优化的初始化 API。
1. 全 0、全 1 与指定常数矩阵
NumPy 提供了一组语义明确的构造函数,通过传入形状元组(shape)和可选的数据类型(dtype)即可瞬时分配:
import numpy as np

# 1. 初始化 3 行 4 列的全 0 浮点矩阵(默认 dtype=np.float64)
np_zeros = np.zeros((3, 4))

# 2. 初始化 3 行 4 列的全 1 整数矩阵
np_ones = np.ones((3, 4), dtype=int)

# 3. 初始化任意常数值矩阵(如全 7)
np_filled = np.full((3, 4), 7, dtype=float)np.zeros 和 np.ones 在未显式声明类型时,默认使用双精度浮点数 float64(单个元素占 8 字节)。若仅用于标记二值图、布尔掩码或整型计数,应明确指定 dtype=np.int32、dtype=np.uint8 或 dtype=bool,以将内存消耗缩减至 1/2 到 1/8。
2. 辨析:np.empty 的性能诱惑与残留脏数据风险
部分教程推崇使用 np.empty((rows, cols)) 进行初始化,理由是它只向系统申请虚拟内存空间而不执行填零操作,耗时更短。然而在工程实践中,必须清晰认识其前提条件:
- 机制特性:
np.empty申请到的内存单元保留着上一个进程或代码段释放的“脏数据”,其中的数值不可预测(可能是极小浮点数、NaN 甚至巨大数值)。 - 适用场景:仅当你紧接着会使用切片、计算结果完全覆盖该数组的每一个元素时,
np.empty才有意义。 - 风险代价:现代操作系统对未清零页面的分配效率极高,
np.zeros与np.empty在小规模数据下的耗时差异仅为微秒级;但若因逻辑遗漏导致某个位置未被覆盖,np.empty会引发难以排查的隐式数值错误。因此在严谨的生产代码中,推荐优先选用确定性初始化的np.zeros。
3. 参照现有数组形状:zeros_like 与 ones_like
在算法迭代中,经常需要开辟一个与输入数组维度和类型完全一致的缓冲区。使用 *_like 系列函数无需手动提取 shape 和 dtype:
source_arr = np.array([[1.5, 2.7], [3.1, 4.8]], dtype=np.float32)

# 自动沿用 source_arr 的形状 (2, 2) 和类型 float32
buffer_zeros = np.zeros_like(source_arr)
buffer_ones = np.ones_like(source_arr)
三、连续与等间距范围数组的高效生成
除了全相同元素的初始化,在时间序列、特征网格划分和坐标轴采样中,生成“指定范围”的数组同样至关重要。Python 提供了基于步长和基于点数的两类生成逻辑。
1. 原生 range:整数范围的惰性与显式求值
Python 3 的内置 range 函数是一个惰性序列对象,支持常数级别 O(1) 的内存开销。若需要物化为常规列表,需显式调用 list():
# 生成 [0, 1, 2, 3, 4](半开区间 [start, stop))
nums_int = list(range(5))

# 指定起始值、终止值与步长
step_nums = list(range(10, 30, 5))
# 输出示例: [10, 15, 20, 25]
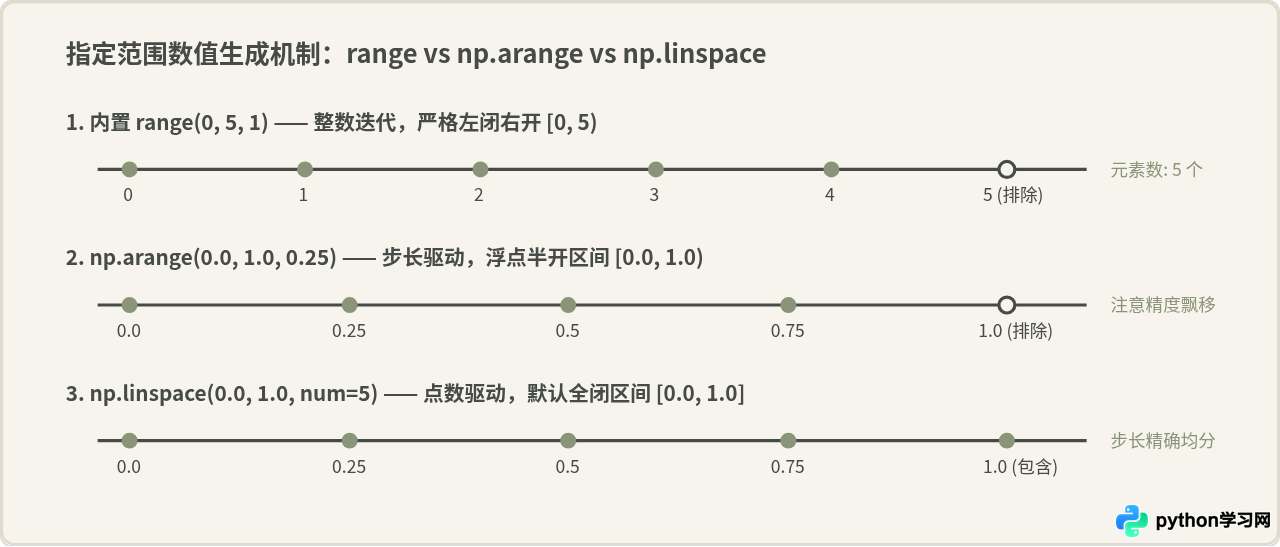
限制:原生 range 仅支持整数类型的起始、终止与步长。若传入浮点数(如 range(0, 1, 0.1)),解释器将直接抛出 TypeError: 'float' object cannot be interpreted as an integer。
2. np.arange vs np.linspace:浮点步长陷阱与端点控制
在涉及浮点数范围生成时,NumPy 提供了两个核心函数:基于步长的 np.arange 与基于采样点数的 np.linspace。二者设计逻辑截然不同,在边界判定上存在关键差异:
import numpy as np

# 方式 A: np.arange(半开区间,步长驱动)
arr_step = np.arange(0.0, 1.0, 0.25)
# 输出示例: array([0.  , 0.25, 0.5 , 0.75])

# 方式 B: np.linspace(全闭区间,点数驱动)
arr_points = np.linspace(0.0, 1.0, num=5)
# 输出示例: array([0.  , 0.25, 0.5 , 0.75, 1.  ])
易混淆辨析:为什么在浮点数序列生成中更推荐 np.linspace?计算机内部采用 IEEE 754 标准表示浮点数,十进制小数(如 0.1 或 0.2)在转换为二进制时往往是无限循环小数,累加过程中会产生微小的精度偏差。在使用 np.arange(0, 1.0, 0.1) 时,累加到最后一步的值可能因浮点舍入略微大于或小于 1.0,导致生成的数组长度偶发性多出或少掉一个端点值。而 np.linspace 直接通过 (stop - start) / (num - 1) 算得理论步长,严格保证首末两端精确对齐,避免了边界飘移。
四、方案选型决策流与避坑指南
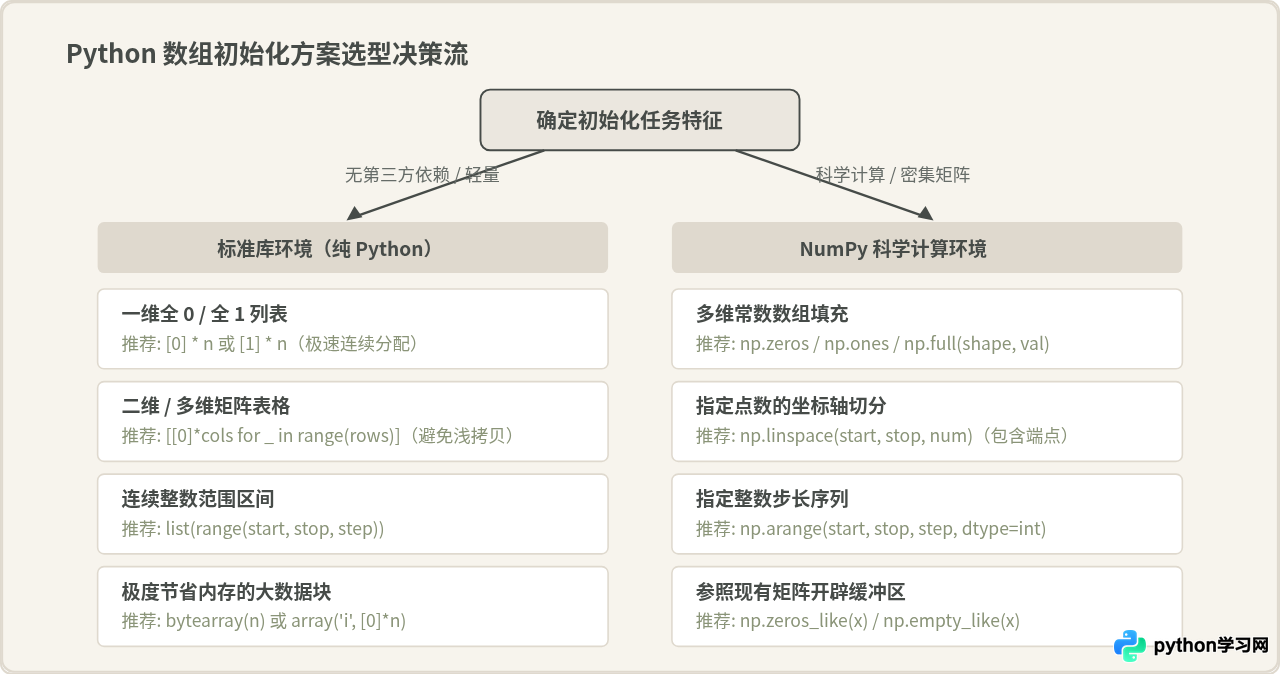
在工程项目中,选用哪种方式初始化数组往往取决于项目依赖限制、数据维度和后续运算负载。下图整理了从需求到选型的完整判断流程:
高频隐患与避坑清单
- 谨慎对待列表元素是可变对象的情况:不仅
[[0]*m]*n会触发浅拷贝共享,任何写成[{}] * n或[[]] * n的一维列表同样会引发同类问题——列表中所有元素均指向同一个空字典或空列表。包含可变对象时,一律使用推导式[[] for _ in range(n)]。 - 警惕大数组的动态 append 扩容:在已知数组最终大小的前提下,避免使用
res = []; for ...: res.append(0)。动态扩容会频繁触发底层数组对象的内存重新分配与数据搬移,耗时远逊于预先开辟好固定长度。 - 避免混淆浮点范围生成函数:当需要将
[0.0, 1.0]区间精确切分为 100 等份时,使用np.linspace(0.0, 1.0, 101)可以获得完全闭合且间隔相等的网格点;而若盲目使用np.arange(0.0, 1.0, 0.01),由于浮点精度舍入,常常出现缺失1.0的情况。
五、核心技巧特性速查与总结
为了便于日常编码快速查阅,下表与结构矩阵将各初始化方式的语法模式、内存机制及最佳适用场景进行了归纳总结:
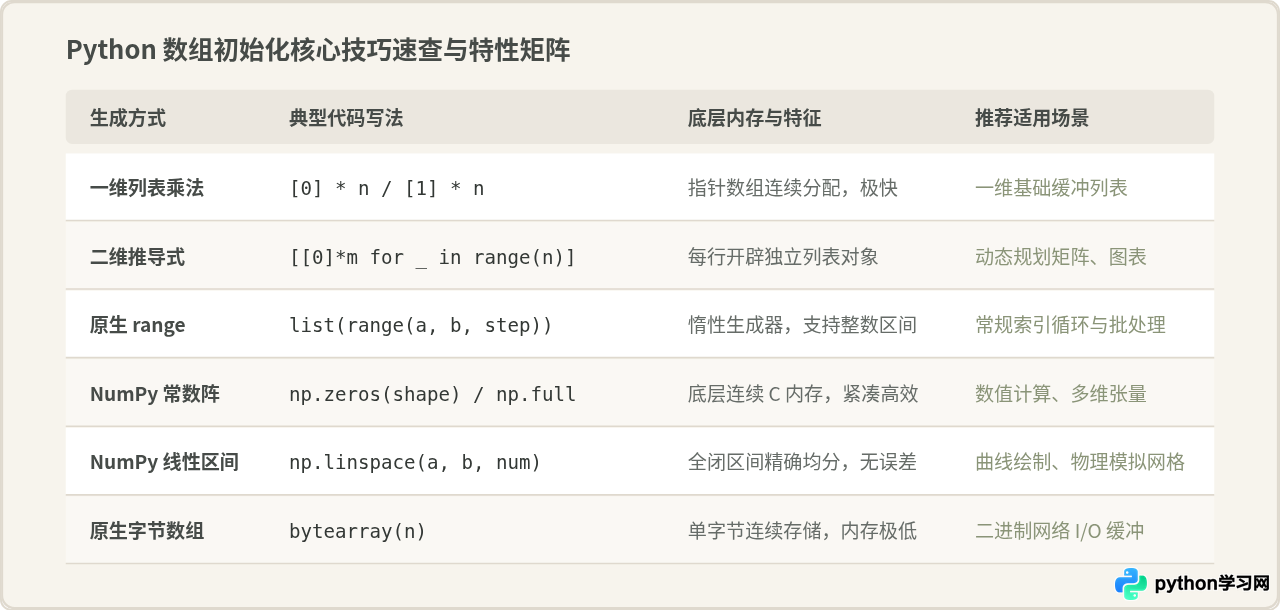
综上所述,Python 数组初始化的最佳实践可以归纳为明确的原则:纯 Python 一维数值数组首选乘法操作 [val] * n,二维及以上多维结构牢记使用列表推导式规避引用浅拷贝;而在科学计算与大规模数值矩阵场景中,始终利用 np.zeros、np.ones 及其 dtype 参数进行紧凑表达,生成连续浮点网格时坚决采用 np.linspace 保障端点一致性。结合这些核心要点,便能在保障代码健壮性的同时获取最优的初始化性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















