


Spark NLP库在PySpark中的安装与预训练模型使用指南
系统解析在PySpark环境下安装配置Spark NLP库的完整流程,涵盖Java与Spark版本兼容性约束、SparkSession内存与Maven依赖注入、Pipeline注解器数据流转原理,以及在线与离线预训练模型的调用与故障排查实践。
在分布式大数据架构中处理非结构化文本时,传统单机自然语言处理库(如 spaCy、NLTK)通常需要借助并行封装或分布式调度工具才能运作,不仅内存利用率低,且难以与批处理、流计算管道无缝融合。Spark NLP 是专为 Apache Spark 设计的生产级自然语言处理库,其核心算子直接基于 Spark ML 框架构建,能够在同一个集群内实现从数据清洗、特征提取、深度学习预训练模型推断到下游分析的一体化流水线。在 PySpark 中使用 Spark NLP 的核心实施路径包含三个关键环节:核查并匹配 Java、Spark 与 Spark NLP 三者之间的版本契约;配置 SparkSession 以正确注入底层 Scala JAR 包与序列化驱动;构建标准 Annotation 流水线并调用预训练模型执行批量推断。本文将按实际落地顺序拆解上述步骤与细节实现。
一、版本依赖契约与底层环境要求
Spark NLP 的底层核心完全由 Scala 编写并运行于 Java 虚拟机(JVM)之上,Python 端的 spark-nlp 仅是一层通过 Py4J 调用 Java 类库的高级接口。因此,在部署前必须严格核对宿主机环境的 JDK、Apache Spark(PySpark)以及 Spark NLP 三者的版本对应关系。若版本不兼容,通常会导致 JVM 初始化失败、NoSuchMethodError 运行时异常或依赖包无法下载。
- Java 环境要求:Spark NLP 强依赖于 Java 8 或 Java 11。目前大多数生产集群采用 OpenJDK 8 或 OpenJDK 11。更高级别的 Java 运行时(如 Java 17+)在没有额外显式配置 JVM 参数(如
--add-opens暴露内部模块)时,极易引发 Spark 内存管理模块的反射权限报错。 - PySpark 与 Spark NLP 版本对应:Spark NLP 的大版本号通常与特定 Apache Spark 发行版保持紧密对应。例如,Spark NLP 5.x 系列主要适配 Apache Spark 3.4.x 与 3.5.x;而 Spark NLP 4.x 系列主要用于 Spark 3.2.x 与 3.3.x。在安装前必须统一团队的 Spark 基线。
- Python 版本兼容:推荐使用 Python 3.8 至 3.11。过低版本已不受官方维护,过高版本可能与特定平台的二进制轮子不兼容。
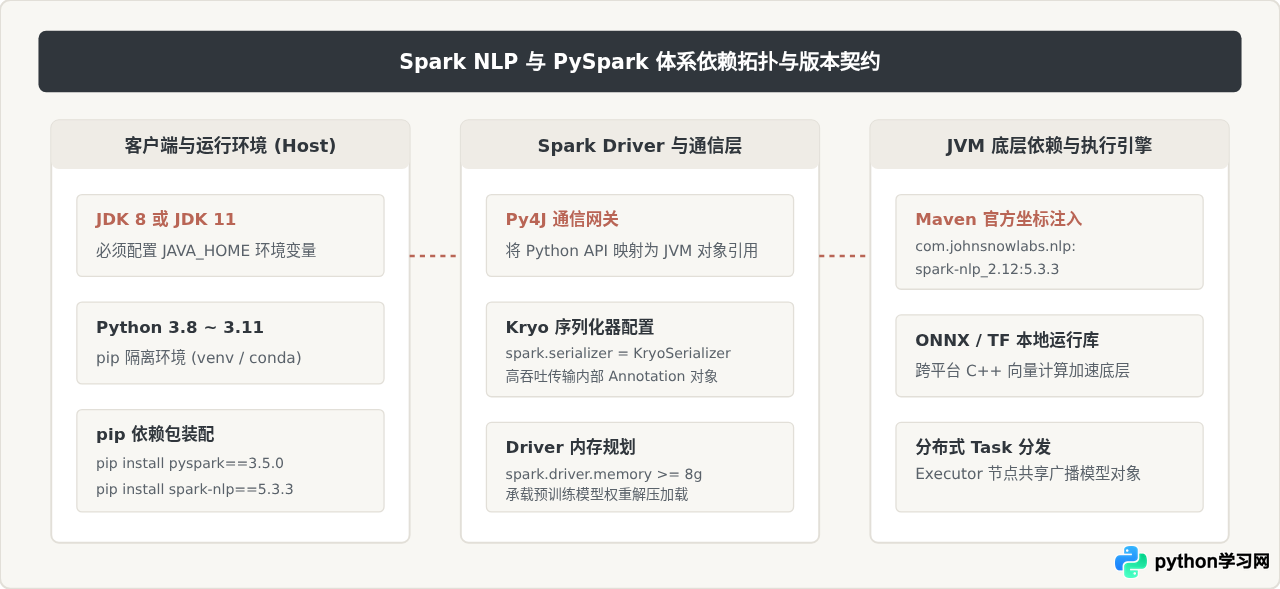
确定环境前,可通过终端命令验证当前系统内的 Java 版本。输出信息中必须明确标明为 64-Bit Server VM 且主要版本号为 1.8 或 11:
# 检查 Java 版本
java -version

# 示例正确输出:
# openjdk version "11.0.22" 2024-01-16
# OpenJDK Runtime Environment (build 11.0.22+7)
# OpenJDK 64-Bit Server VM (build 11.0.22+7, mixed mode)
二、Python 包安装与 SparkSession 容器初始化
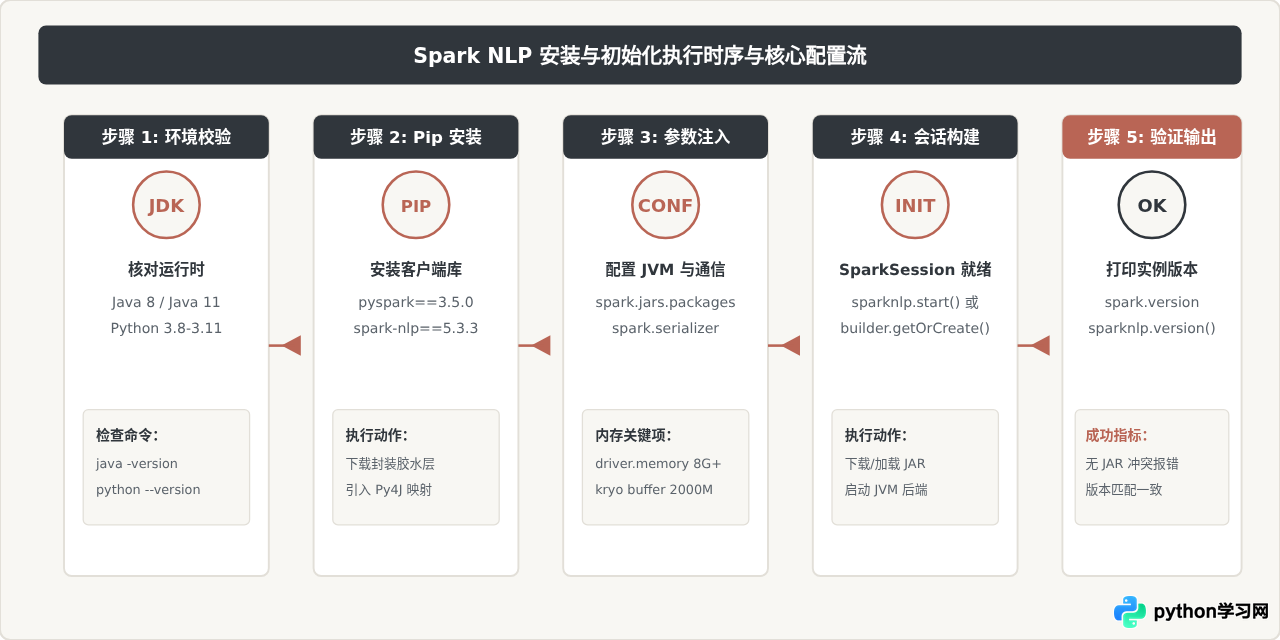
仅通过 pip install spark-nlp 安装 Python 包并不足以使程序正常运行。因为在调用算子时,Spark 集群中的 Driver 与 Executor 都需要访问 Spark NLP 的 Java 归档文件(JAR)。启动 SparkSession 有两种标准方式:适合快速验证的内置助手函数,以及面向生产环境的自定义构建器。
1. 依赖库安装
在独立的虚拟环境中安装匹配版本的 pyspark 与 spark-nlp:
pip install pyspark==3.5.0 spark-nlp==5.3.32. 方式 A:通过 sparknlp.start() 快速启动
对于单机开发、Jupyter 交互式笔记本或快速原型测试,Spark NLP 官方封装了 sparknlp.start() 函数。该函数会自动根据已安装的 spark-nlp Python 包版本,组装对应的 Maven 坐标、Kryo 序列化参数,并自动拉取缺失的 JAR 包。
import sparknlp

# 自动配置并初始化 SparkSession
# 可按需指定 driver 内存大小(默认为 16G,可调小)
spark = sparknlp.start(gpu=False, memory="8G")

print(f"Apache Spark 版本: {spark.version}")
print(f"Spark NLP 版本: {sparknlp.version()}")
3. 方式 B:企业级自定义 SparkSession 构建
在复杂的生产工程或集群提交(如 Yarn、Kubernetes、Standalone)场景中,通常需要精确控制各项 JVM 参数、日志级别和内存分配,必须使用标准的 SparkSession.builder 显式指定配置项:
from pyspark.sql import SparkSession

# 明确指定版本号与 Maven 坐标
SPARK_NLP_PACKAGE = "com.johnsnowlabs.nlp:spark-nlp_2.12:5.3.3"

spark = (
    SparkSession.builder
    .appName("SparkNLP-Production-Pipeline")
    .master("local[*]")
    # 注入 Spark NLP 的 Maven 坐标(集群首次启动将自动从 Maven Central 下载)
    .config("spark.jars.packages", SPARK_NLP_PACKAGE)
    # 分配充足的 Driver 堆内存,防止大模型加载时抛出 OOM
    .config("spark.driver.memory", "12g")
    .config("spark.executor.memory", "8g")
    # 限制 Driver 收集的最大结果体积
    .config("spark.driver.maxResultSize", "4g")
    # 开启 Kryo 序列化器以提高跨节点传输效率与减少内存占用
    .config("spark.serializer", "org.apache.spark.serializer.KryoSerializer")
    .config("spark.kryoserializer.buffer.max", "2000M")
    # 预留跨 JVM 对象反射开关(适用于 Java 11)
    .config("spark.driver.extraJavaOptions", "-XX:+UseG1GC")
    .getOrCreate()
)注意:如果执行机器处于无法连接外网的隔离网络环境,spark.jars.packages 会因为无法连接 Maven 仓库而超时失败。此时需提前下载离线 spark-nlp_2.12-5.3.3.jar,改用 .config("spark.jars", "/path/to/spark-nlp_2.12-5.3.3.jar") 参数加载本地文件。
三、核心机制:Annotation 数据结构与 Pipeline 流转
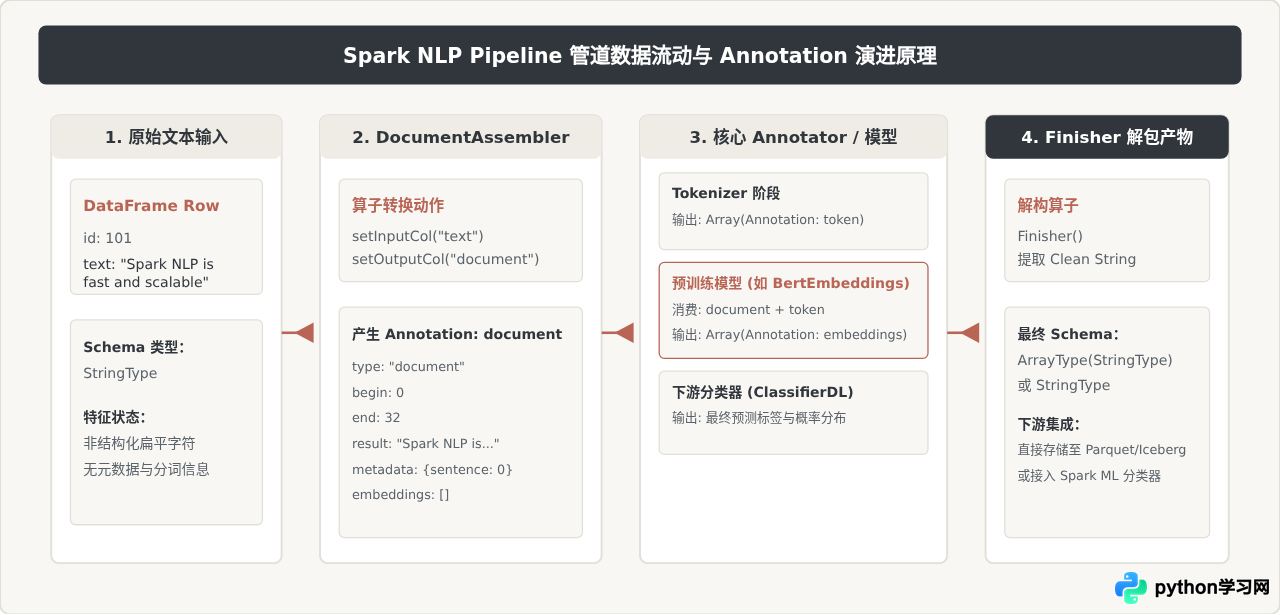
理解 Spark NLP 的关键在于掌握其特有的数据承载形式——Annotation(注解结构)。在标准的 Spark ML 流水线中,特征列通常是 Double、Vector 或 String。而在文本深度处理过程中,实体识别、词性标注、依存句法等任务需要频繁追溯每个单词或短语在原始文本中的字符偏移量(Begin、End)、置信度得分及附加元数据。
为了在分布式 DataFrame 中高效存储此类复杂结构,Spark NLP 定义了标准的 Annotation Struct:
# Spark NLP Annotation 结构在 DataFrame 内部的表现模式
struct<
    annotatorType: string,  # 注解类型,如 document, token, pos, ner, embeddings
    begin: int,             # 在原始文本中的起始字符索引
    end: int,               # 在原始文本中的结束字符索引
    result: string,         # 处理产物(如词干、词元、预测标签)
    metadata: map<string,string>, # 附加字典信息(置信度、句次、模型来源)
    embeddings: array<float>      # 稠密向量表示(若为嵌入算子)
>
任何非结构化字符串如果想进入 Spark NLP 管道,必须经历“装配(Assembler)- 注解处理(Annotator)- 收尾转换(Finisher)”三段式生命周期:
- 入口:DocumentAssembler:将普通的
StringType字段转换为包含元数据的document级 Annotation 结构。所有下游算子均以此为输入。 - 中间转换:Annotator 流水线:例如
Tokenizer消费document并输出token;BertEmbeddings消费document与token生成word_embeddings。 - 出口:Finisher:将复杂的 Annotation 结构解包,还原为 Spark SQL 原生的
ArrayType(StringType)或纯文本,供后续的 SQL 聚合或存储写库。
四、预训练模型调用实战
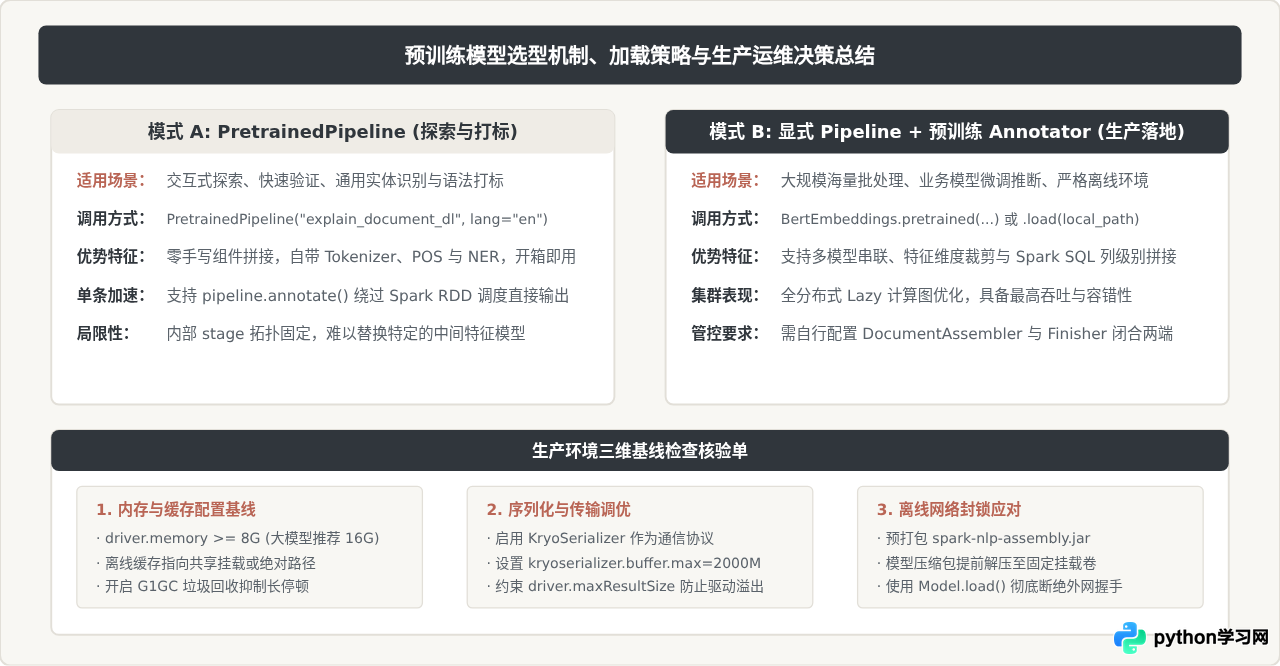
Spark NLP 提供了庞大的官方预训练模型库(包含 BERT、RoBERTa、DeBERTa、T5、Whisper 等主流模型),主要通过两种模式在 PySpark 中使用:一是极简的 PretrainedPipeline,二是完全可定制的 Pipeline 组合。
1. 模式一:使用 PretrainedPipeline 极速开箱使用
PretrainedPipeline 将数据装配、分词、词性标注、实体识别或情感预测等多个算子打包在一个预构建流水线中。在做数据探测、打标实验时最为高效:
from sparknlp.pretrained import PretrainedPipeline

# 下载并加载官方预构建流水线(如英文综合解析模型)
pipeline = PretrainedPipeline("explain_document_dl", lang="en")

# 1. 直接针对单条或多条字符串推断(内部使用 LightPipeline 执行,避免 Spark 开销)
test_text = "Google was founded in September 1998 by Larry Page and Sergey Brin."
annotations = pipeline.annotate(test_text)

# 打印提取到的命名实体与词性
print("分词列表:", annotations["token"])
print("命名实体识别结果:", annotations["entities"])

# 2. 针对海量 PySpark DataFrame 进行分布式转换
df = spark.createDataFrame([
    (1, "Spark NLP enables fast NLP on distributed clusters."),
    (2, "Apache Spark provides high-throughput big data processing.")
], ["id", "text"])

result_df = pipeline.transform(df)
# 查看输出的实体列
result_df.select("id", "entities.result").show(truncate=False)
2. 模式二:构建自定义 Pipeline 并加载特定预训练模型
在严肃的业务场景中,通常需要精准指定特定的向量模型(如利用 BERT 提取句子向量)并与下游任务串联。以下代码演示如何手动拼装一个完整的预训练情感分析流水线:
from pyspark.ml import Pipeline
from sparknlp.base import DocumentAssembler, Finisher
from sparknlp.annotator import (
    Tokenizer,
    BertSentenceEmbeddings,
    SentimentDLModel
)

# 1. 阶段一:将原始 string 转换为 document 结构
document_assembler = (
    DocumentAssembler()
    .setInputCol("review_text")
    .setOutputCol("document")
)

# 2. 阶段二:加载预训练的句子级 BERT 嵌入模型
# 首次调用会自动下载预训练权重并存入本地缓存
bert_embeddings = (
    BertSentenceEmbeddings.pretrained("sent_small_bert_L2_128", "en")
    .setInputCols(["document"])
    .setOutputCol("sentence_embeddings")
)

# 3. 阶段三:加载预训练的情感分类深度学习模型
sentiment_classifier = (
    SentimentDLModel.pretrained("sentimentdl_small_bert_L2_128", "en")
    .setInputCols(["sentence_embeddings"])
    .setOutputCol("sentiment_prediction")
)

# 4. 阶段四:使用 Finisher 提取出整洁的分类结果字符串
finisher = (
    Finisher()
    .setInputCols(["sentiment_prediction"])
    .setOutputCols(["final_sentiment"])
    .setOutputAsArray(False)
)

# 组装为标准 Spark ML Pipeline 并完成拟合(预训练模型无需训练数据)
nlp_pipeline = Pipeline(stages=[
    document_assembler,
    bert_embeddings,
    sentiment_classifier,
    finisher
])

# 准备测试 DataFrame
reviews_data = [
    (1, "The product quality exceeded all my expectations, truly wonderful!"),
    (2, "Terrible experience. The package arrived late and damaged."),
    (3, "Average item, neither good nor particularly bad.")
]
reviews_df = spark.createDataFrame(reviews_data, ["id", "review_text"])

# 拟合并应用转换
model = nlp_pipeline.fit(reviews_df)
predictions = model.transform(reviews_df)

# 查看最终预测列
predictions.select("id", "review_text", "final_sentiment").show(truncate=False)
输出示例(符合 Spark DataFrame 标准显示样式):
+---+------------------------------------------------------------------+---------------+
|id |review_text                                                       |final_sentiment|
+---+------------------------------------------------------------------+---------------+
|1  |The product quality exceeded all my expectations, truly wonderful!|positive       |
|2  |Terrible experience. The package arrived late and damaged.        |negative       |
|3  |Average item, neither good nor particularly bad.                  |neutral        |
+---+------------------------------------------------------------------+---------------+
五、生产环境部署策略与关键避坑指南
在离线机房、私有云或容器化运行环境中,使用 Spark NLP 时常会遇到网络受限和内存压力。以下为生产级运维必须注意的关键要点:
1. 离线缓存与模型持久化策略
默认情况下,当调用 .pretrained() 时,Spark NLP 会自动访问 AWS S3 上的官方存储桶下载模型压缩包,并解压到当前用户的宿主目录:~/cache_pretrained/ 中。若集群节点无法访问公网,可通过如下两种途径解决:
- 自定义缓存目录配置:通过配置项
spark.jsl.settings.pretrained.cache_folder重定向缓存路径至共享存储(如 NFS 或 HDFS 挂载点)。 - 显式离线加载:从官方模型中心(Spark NLP Models Hub)预先下载
.zip格式的模型文件,解压后使用.load("/path/to/extracted_model_folder")代替.pretrained()。
# 离线环境加载本地模型示例
bert_embeddings_offline = (
    BertSentenceEmbeddings.load("/opt/models/sent_small_bert_L2_128_en")
    .setInputCols(["document"])
    .setOutputCol("sentence_embeddings")
)
2. 常见运行报错排查对照
| 异常现象 / 报错日志 | 根本原因分析 | 精准解决路径 |
|---|---|---|
java.lang.OutOfMemoryError: Java heap space |
深度学习模型(如 BERT、RoBERTa)解压并加载至 JVM 堆内时,默认的 1GB Driver 内存耗尽。 | 启动前增加配置:.config("spark.driver.memory", "8g") 或更大。 |
java.lang.IllegalArgumentException: requirement failed: ... buffer size |
Spark 节点间传输大型向量特征或模型参数时超出了 Kryo 序列化默认缓冲区容量。 | 设置 .config("spark.kryoserializer.buffer.max", "2000M")。 |
Py4JJavaError: ClassNotFoundException: com.johnsnowlabs.nlp... |
PySpark 仅安装了 Python 端库,Spark 引擎未能成功加载底层 Maven JAR 包。 | 确保指定了正确坐标的 spark.jars.packages 或本地 spark.jars 绝对路径。 |
ModuleNotFoundError: No module named 'tensorflow' |
某些依赖 TensorFlow 算子的模型在无内置运行时环境中缺少运行时库。 | Spark NLP 5.x 推荐优先选用 ONNX 后端模型,或在宿主机安装匹配的跨平台二进制库。 |
结语
Spark NLP 通过将复杂深度学习模型打包为标准的 Spark ML 管道节点,彻底解决了大数据环境下海量非结构化文本处理吞吐量受限的瓶颈。在实际工程落地中,开发者应始终遵循“明确版本依赖、规范 JVM 会话配置、统一 Annotation 装配标准、按需选择开箱与自定义模型”的规范化开发范式。借助其完备的预训练模型生态,企业团队无需额外搭建独立推理服务,即可在既有的 Spark 计算引擎中高质量完成分布式文本分析任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















