


Python csv模块与pandas读取特定数据的对比

在Python开发与数据处理中,读取结构化文本文件是极高频的操作。当面对体量庞大的CSV文件且仅需获取其中特定列、特定行或满足特定业务条件的数据时,开发者通常会在标准库内置的 csv 模块与第三方数据分析库 pandas 之间进行选择。两者的核心差异在于:csv 模块采用轻量级的流式单行迭代模式,内存消耗极小且零外部依赖,但需要手动编写解析与筛选逻辑;而 pandas 则依托底层C引擎与内存向量化数组,提供高度表达力的列裁剪与布尔索引能力,开发效率极高,但对运行环境与内存规模有着明确的要求。本文围绕读取“特定数据”的典型场景,对两者的架构机制、实现路径、性能表现及适用边界展开深入对比。
一、底层处理机制与内存模型差异
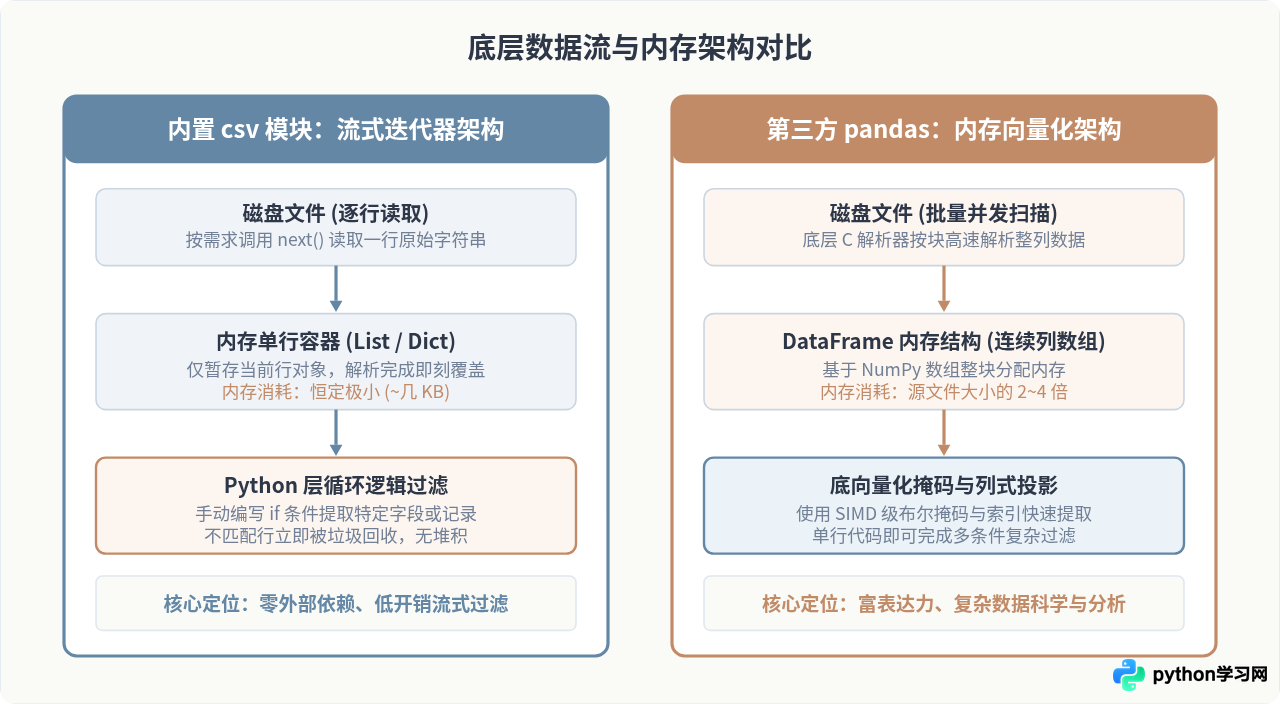
要理解两者读取特定数据时的行为差异,首先需要剖析它们在磁盘I/O与内存载入机制上的底层设计。
Python内置的 csv 模块是一个行级文本流解析器。它依托底层打开的文件句柄(File Object),通过生成器逐行读取文本,并将其按分隔符拆解为原生Python字符串列表(csv.reader)或字典(csv.DictReader)。在整个生命周期中,内存中在任意瞬间仅保留当前读取的单个文本行对象。一旦该行完成业务判断被丢弃,其占用的内存就会被Python垃圾回收器即时回收。这意味着无论CSV源文件是100MB还是100GB,使用 csv 模块读取特定记录的内存占用始终保持恒定(通常仅几KB至几MB)。
相比之下,pandas 库的 read_csv 函数在默认情况下采用批量加载与结构化映射机制。它调用底层编译优化的C解析器(或更快的PyArrow引擎),将整批数据直接解析为连续存储的NumPy数组或Series对象,并在内存中构建高阶二维数据容器 DataFrame。这种全量内存驻留的设计赋予了 pandas 极高的向量化切片与批量运算能力,但代价是昂贵的内存放大效应:一个1GB的CSV文件,全量加载进 DataFrame 后通常需要占用1.5GB至3GB的RAM空间。
二、提取特定列(Projection)的实现与性能差异
在实际生产中,CSV文件往往包含几十甚至上百个字段,但下游任务可能仅仅需要其中的两到三个关键列(例如交易记录中的 order_id 与 amount)。
1. csv 模块的列提取实现
使用 csv 模块提取指定列主要有两种方式:基于列索引的位置切片,或者基于 csv.DictReader 的字典键提取。
import csv

# 方式一:基于 csv.reader 与列索引截取
def extract_columns_by_index(file_path, target_indices):
    results = []
    with open(file_path, mode='r', encoding='utf-8') as f:
        reader = csv.reader(f)
        header = next(reader)  # 跳过或记录表头
        for row in reader:
            # 提取指定索引列
            results.append([row[i] for i in target_indices])
    return results

# 方式二:基于 csv.DictReader 与列名提取
def extract_columns_by_name(file_path, target_names):
    results = []
    with open(file_path, mode='r', encoding='utf-8') as f:
        reader = csv.DictReader(f)
        for row in reader:
            results.append({col: row[col] for col in target_names})
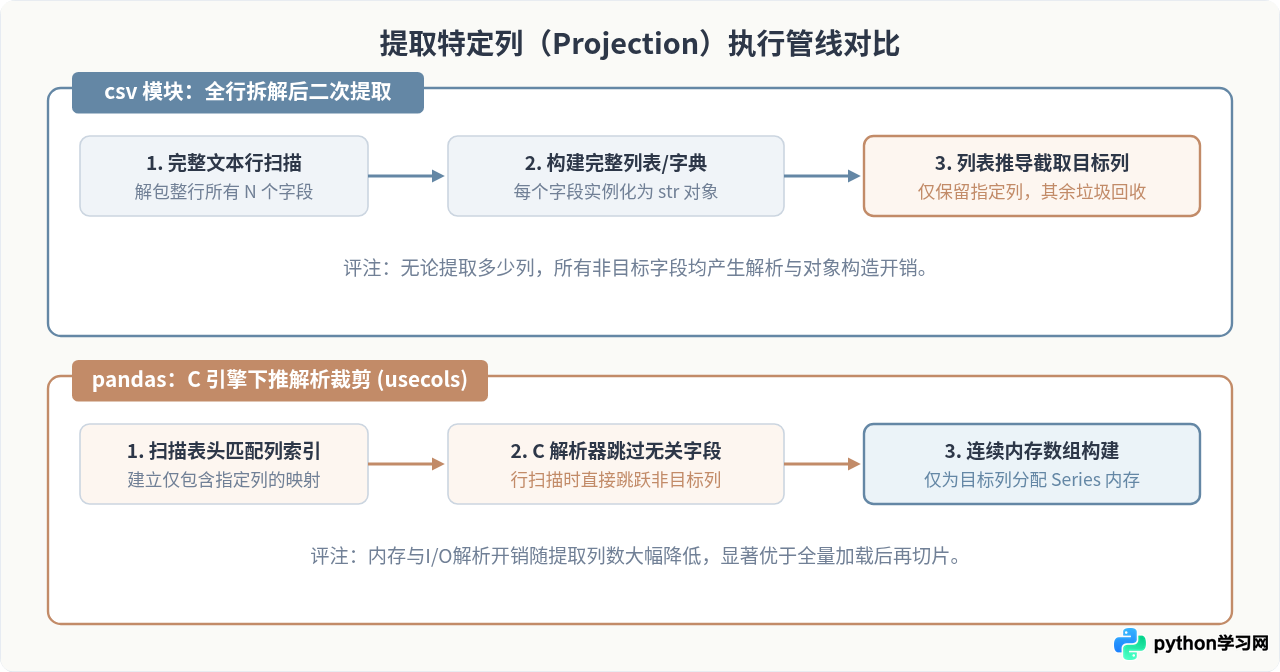
return results底层细节与限制:在 csv 模块中,即使我们只需要两列,底层的 reader 或 DictReader 也必须完整扫描整行文本,并按照逗号切分出全部列的Python字符串对象。特别是 DictReader,在每处理一行时都会为整行构建一个崭新的字典对象。这导致大量未被使用的字段在Python虚拟机层经历了“解析 → 封装成对象 → 未引用 → 垃圾回收”的全过程,造成了额外的CPU开销。
2. pandas 库的列提取实现
pandas 提供了经过高度优化的参数 usecols,可以在解析阶段直接对字段进行投影:
import pandas as pd

# 使用 usecols 参数直接在读取时裁剪列
def extract_columns_pandas(file_path, target_columns):
    # 只将 target_columns 列的数据解析入内存
    df = pd.read_csv(file_path, usecols=target_columns)
return df底层细节与优势:pandas 的 usecols 参数具有“下推(Push-down)”优化特性。底层C解析器在读取第一行表头确认列物理偏移量后,扫描后续行时会直接在二进制层面跳过未指定的列数据,仅为目标列分配内存并执行数据类型转换。这不仅显著降低了最终构建出的 DataFrame 内存占用,还直接缩短了I/O与文本解析耗时。
三、按条件筛选特定行(Filtering)的对比
当需要从成千上万条记录中提取符合特定业务规则的数据行时(例如筛选状态为 "completed" 且金额 amount > 1000 的交易单),两者的编码心智模型与执行效率表现出截然不同的风格。
1. csv 模块的逐行过滤
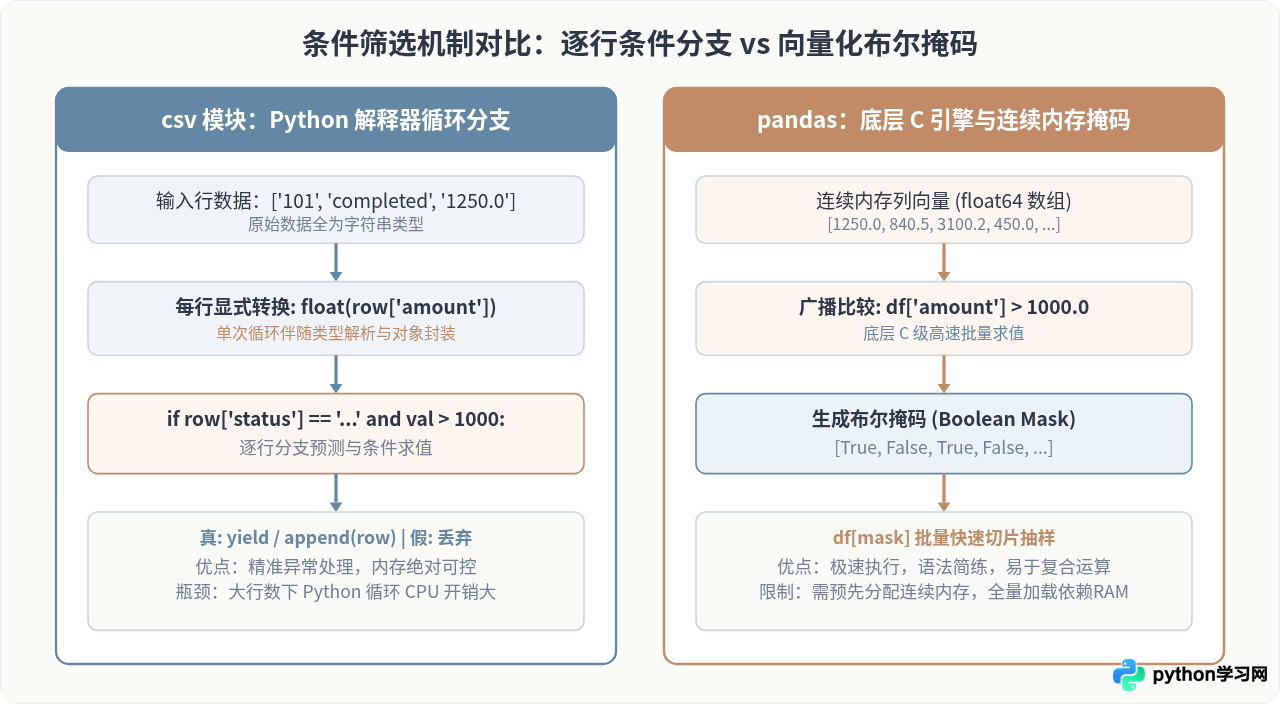
csv 模块本身不包含任何过滤语法,所有逻辑依赖 Python 的原生 if 分支判断。同时,由于 csv 读取的所有数据都是原生字符串,涉及数值或日期比较时,必须手动执行显式类型转换:
import csv

def filter_completed_large_orders(file_path):
    matched_records = []
    with open(file_path, mode='r', encoding='utf-8') as f:
        reader = csv.DictReader(f)
        for row in reader:
            # 数据校验与类型转换必须手工处理
            try:
                amount = float(row['amount'])
            except (ValueError, TypeError):
                continue  # 忽略脏数据或表头异常行

            # 条件分支筛选
            if row['status'] == 'completed' and amount > 1000.0:
                matched_records.append(row)
return matched_records特点分析:这种方式最大的优势是精确可控。如果数据源存在恶意的畸变数据,开发者可以在循环中加入精细的异常捕获与清洗机制。此外,如果配合 yield 编写为生成器,可以实现完全不占内存的端到端管道流。然而,当文件行数达到百万级时,每行代码都要在 Python 解释器中经历数次指令调度与类型转换,性能会遇到明显的 CPU 瓶颈。
2. pandas 的向量化布尔掩码与分块过滤
pandas 借由向量化比较提供了简洁的声明式语法:
import pandas as pd

# 场景一:内存充足时直接读取与向量化布尔索引
def filter_pandas_in_memory(file_path):
    df = pd.read_csv(file_path)
    # 向量化布尔筛选
    condition = (df['status'] == 'completed') & (df['amount'] > 1000.0)
    return df[condition]

# 场景二:超大文件下的分块迭代过滤(兼顾内存与速度)
def filter_pandas_chunked(file_path, chunk_size=100000):
    chunks = []
    for chunk in pd.read_csv(file_path, chunksize=chunk_size):
        condition = (chunk['status'] == 'completed') & (chunk['amount'] > 1000.0)
        chunks.append(chunk[condition])
    # 将过滤后的有效记录合并为最终结果
return pd.concat(chunks, ignore_index=True)底层细节与优势:在 df['amount'] > 1000.0 这一语句中,计算过程是在底层连续内存中通过 C 循环甚至 SIMD 向量化指令执行的,而不是通过 Python 虚拟机的字节码解释。它瞬间生成一个紧凑的布尔掩码(Boolean Mask),再直接通过底层地址偏移批量提取目标行。即使文件过大无法一次性载入,利用 chunksize 参数也能保持极高的吞吐率,其数据清洗与转换速度往往是原生 Python 循环的 5 到 15 倍。
四、读取特定行范围与切片截取(Slicing)
除了按值筛选外,业务中经常需要读取指定行号范围的数据,例如分页拉取(读取第1000到第1500行)或仅提取前100行(Top-N 探测)。
1. csv 模块结合 itertools.islice
由于 csv.reader 本质上是标准迭代器,配合 Python 标准库的 itertools.islice,可以在不载入目标区间之前或之后数据的情况下,实现零冗余的范围截取:
import csv
from itertools import islice

def read_row_range_csv(file_path, start_line, end_line):
    # start_line 从 0 开始计算(不含表头)
    with open(file_path, mode='r', encoding='utf-8') as f:
        reader = csv.reader(f)
        header = next(reader)  # 消费表头
        # 仅迭代获取 [start_line, end_line) 区间的行
        sliced_rows = list(islice(reader, start_line, end_line))
return header, sliced_rows执行特点:对于前置的 start_line 行,迭代器在底层快速扫描换行符跳过,只在达到区间时才构造列表对象,达到 end_line 后立即停止读取,避免了对文件后续多余内容的无谓扫描。
2. pandas 的 skiprows 与 nrows 参数
pandas 提供了 skiprows 与 nrows 两个原生参数,直接在读取阶段完成行范围控制:
import pandas as pd

def read_row_range_pandas(file_path, skip_count, row_count):
    # 跳过指定数量的行(可配合表头参数调整),读取随后的 row_count 行
    df = pd.read_csv(file_path, skiprows=range(1, skip_count + 1), nrows=row_count)
return df执行特点:底层 C 解析器直接利用 nrows 限制内存分配规模,解析器在计数达到 nrows 后立即终止文件句柄扫描返回,非常适合大文件快速抽样与结构校验。
五、综合指标对比与选型决策指南
为了给实际工程选型提供清晰的判断依据,我们将两者的关键维度进行了系统归纳:
| 对比维度 | Python 内置 csv 模块 | 第三方 pandas 库 |
|---|---|---|
| 外部依赖 | 零依赖(Python 内置标准库) | 依赖庞大(需预装 pandas, numpy 及编译组件) |
| 内存开销 | 极低且恒定(流式处理,仅保留当前行) | 较高(全量载入约需文件体积的 2~4 倍物理内存) |
| 数据类型支持 | 仅支持原生字符串,需手动类型转换 | 自动推断丰富数据类型(int, float, datetime等) |
| 提取指定列效率 | 全行解析后由 Python 切片,无 I/O 跳过优化 | usecols 由 C 解析器下推跳过,吞吐率高 |
| 按条件过滤效率 | 受限于 Python 解释器循环,大行数耗时较长 | 底层 SIMD 级向量化布尔掩码,吞吐率极高 |
| 超大文件(>内存) | 天生支持,可轻松处理 100GB+ 级文本 | 需显式使用 chunksize 分块,配置要求较高 |
| 代码表达力 | 命令式风格,需编写显式循环与条件分支 | 声明式语法,单行链式调用即可完成复合筛选 |
| 后续数据分析 | 能力弱,需手动实现或依赖其他工具 | 原生提供聚合(groupby)、透视、多表合并等 |
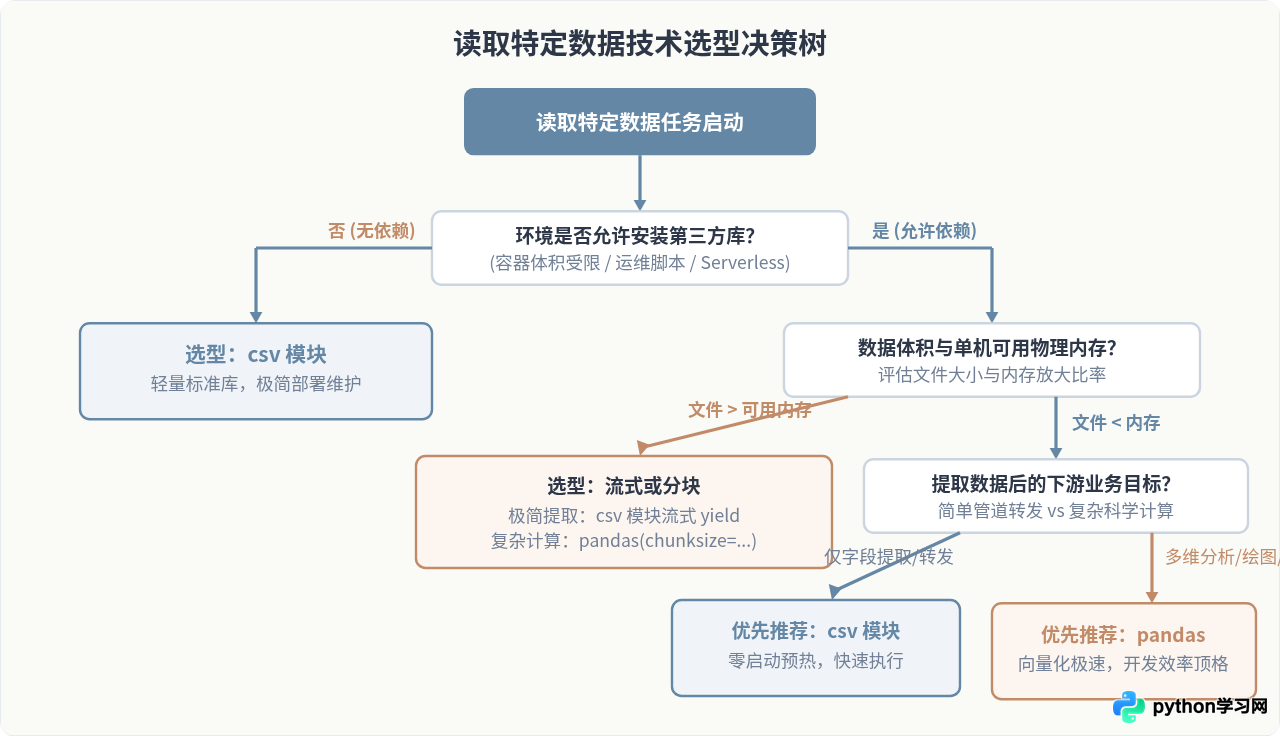
pandas,因为冷启动导入 pandas 和 numpy 本身就需要数十毫秒到数百毫秒的时间,且容易因内存分配策略引起宿主机内存抖动;反之,在进行探索性数据分析、多表关联过滤或需要进行统计聚合的场景下,pandas 带来的开发效率与运行时速度提升是原生的 csv 模块无法企及的。
六、结语
综上所述,Python 内置的 csv 模块与第三方库 pandas 并不是相互取代的关系,而是对应着不同维度的工程平衡:
- 关注轻量化与资源确定性:选择
csv模块。它是典型的流式(Streaming)工具,通过显式控制换取了恒定的内存占用与零依赖的灵活性。 - 关注开发效率与批量计算性能:选择
pandas。它是典型的内存驻留(In-Memory)分析平台,利用usecols与向量化布尔掩码提供了极高表达力的 API 与极速计算体验。
根据硬件条件、运行环境、数据体量以及下游使用方式权衡这两者的特长,是写出优雅且高性价比数据处理程序的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















