


用Python能做哪些具体的人工智能应用?计算机视觉、NLP与推荐系统实战方向
深入解析使用Python落地人工智能的具体实战方向,全面覆盖计算机视觉、自然语言处理与推荐系统的业务场景、核心技术栈、实现流程与代码原型。
一、三大方向全景映射与核心技术链
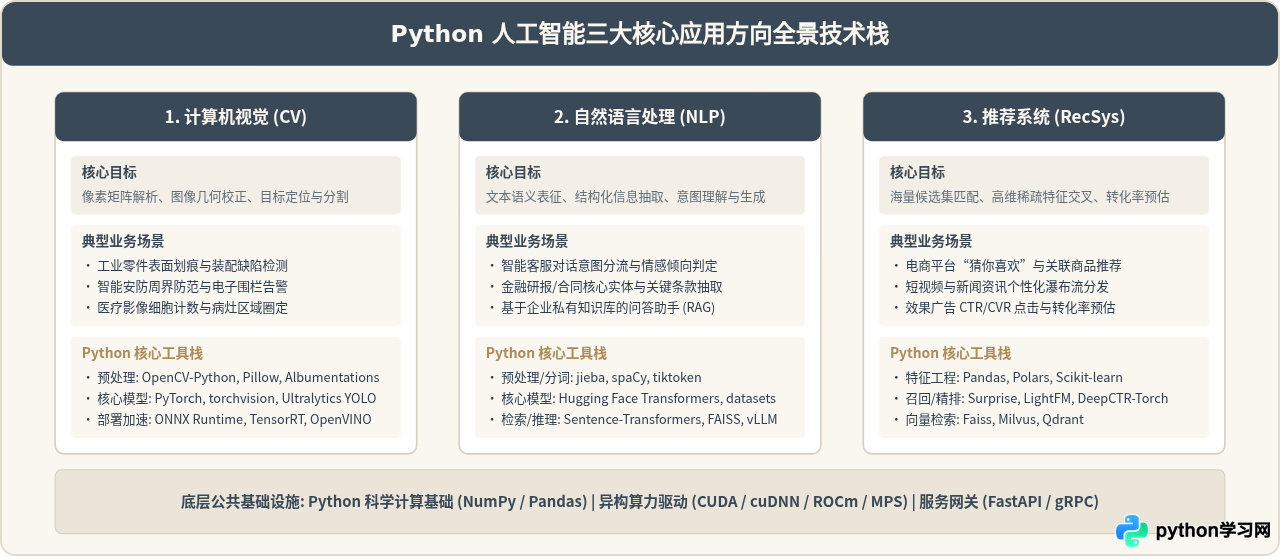
人工智能并不是单一孤立的算法,而是根据输入数据的模态(图像/视频、非结构化文本、用户行为日志)与业务目标划分的具体工程领域。Python 凭借成熟的科学计算生态(NumPy、Pandas、SciPy)与底层 C/C++ 绑定的深度学习框架,成为了贯通这三大方向的标准工程语言。
二、计算机视觉(CV):目标检测与生产推理流水线
计算机视觉解决的是“让机器看懂图像和视频”的问题。在工业界,纯粹的图像分类(例如判断图片是猫还是狗)由于业务价值有限,绝大部分实战任务集中在目标检测(Object Detection)、图像分割(Instance Segmentation)以及光学字符识别(OCR)上。
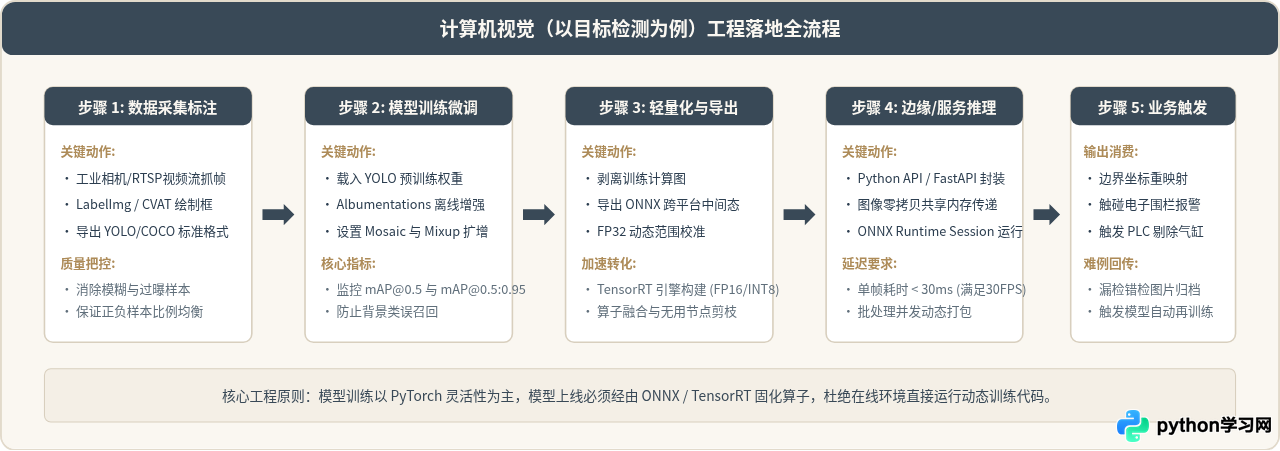
最典型的实战需求是车间产线中的工件缺陷检测或安防摄像头中的周界入侵检测。其工程标准作业流程可以抽象为包含数据清洗、模型训练、算子优化与服务化推理的五级流水线。
实战代码:基于 Ultralytics YOLOv8 的工业目标检测推理原型
以下是使用 Python 构建的目标检测完整推理代码。代码展示了如何加载模型、执行批推理、过滤低置信度噪点,并将目标边界框、类别与置信度转化为结构化数据,以便后续业务系统直接使用。
import cv2
from ultralytics import YOLO

def run_vision_inference(image_path: str, conf_threshold: float = 0.5):
    """
    计算机视觉目标检测推理原型
    依赖库: pip install ultralytics opencv-python
    """
    # 1. 加载官方预训练权重或本地微调后的缺陷检测权重
    model = YOLO("yolov8n.pt")

    # 2. 读取输入图像(支持图像路径、numpy数组或视频流帧)
    image = cv2.imread(image_path)
    if image is None:
        raise FileNotFoundError(f"无法读取指定图像: {image_path}")

    # 3. 执行前向推理
    # iou: NMS非极大值抑制重叠度阈值; device: 'cpu' 或 '0' (指定显卡)
    results = model.predict(source=image, conf=conf_threshold, iou=0.45, verbose=False)

    detections = []
    # 4. 解析检测结果
    for box in results[0].boxes:
        coords = box.xyxy[0].tolist()  # 边界框坐标 [xmin, ymin, xmax, ymax]
        conf = float(box.conf[0])      # 识别置信度
        class_id = int(box.cls[0])     # 类别索引
        class_name = model.names[class_id] # 类别名称

        detections.append({
            "label": class_name,
            "confidence": round(conf, 4),
            "bbox": [round(c, 2) for c in coords]
        })

    return detections

# 执行示例 (示例调用)
if __name__ == "__main__":
    # 实际运行前请确保当前目录存在测试图片 sample.jpg
    # results = run_vision_inference("sample.jpg", conf_threshold=0.6)
    # print("结构化检测结果:", results)
    pass
三、自然语言处理(NLP):文本理解与检索增强生成(RAG)
自然语言处理用于解析文本的语法结构与潜在语义。过去该领域主要依赖基于规则的正则匹配或词袋统计模型,而当前工业界已经完全转向以 Transformer 架构 为底座的深度语义网络。
在业务落地中,Python 最常见的 NLP 应用包括两大支柱:
- 判别式任务(Discriminative NLP):工单分类、敏感词合规审核、合同关键要素命名实体识别(NER)。特点是速度快、输出结果确定、推理成本极低。
- 生成式与检索任务(Generative & RAG):企业本地私有知识库问答。通过将海量 PDF、Word 文档拆解分块、使用向量模型(Embedding)转为数字向量,存入向量数据库,最后将最相关的片段作为上下文输入大语言模型,生成精准可靠的回答。
实战代码:基于 Hugging Face Transformers 的工业文本意图识别
以下代码演示了如何使用 Python 的 transformers 库快速加载工业级中文情感与意图分析模型,并完成批量文本推理。
from transformers import pipeline

def analyze_customer_intent(texts: list[str]) -> list[dict]:
    """
    使用 Hugging Face 预训练流水线进行中文文本情感与意图分析
    依赖库: pip install transformers torch
    """
    # 1. 声明分类流水线(这里使用成熟的多语言或中文情感分类预训练权重)
    # 在生产环境中,通常替换为企业在领域数据上微调后的本地权重目录
    classifier = pipeline(
        task="sentiment-analysis",
        model="uer/roberta-base-finetuned-jd-binary-chinese",
        device=-1  # -1 表示 CPU,0 表示第一张 GPU
    )

    # 2. 批量推理
    predictions = classifier(texts)

    results = []
    for text, pred in zip(texts, predictions):
        results.append({
            "text": text,
            "intent_label": pred["label"],
            "score": round(pred["score"], 4)
        })

    return results

if __name__ == "__main__":
    test_cases = [
        "这个系统响应速度很快,导出的报表非常清晰!",
        "上传附件老是提示格式错误,联系客服也没有响应,太耽误事了。"
    ]
    # intent_results = analyze_customer_intent(test_cases)
    # print(intent_results)
四、个性化推荐系统(RecSys):双塔召回与深度精排
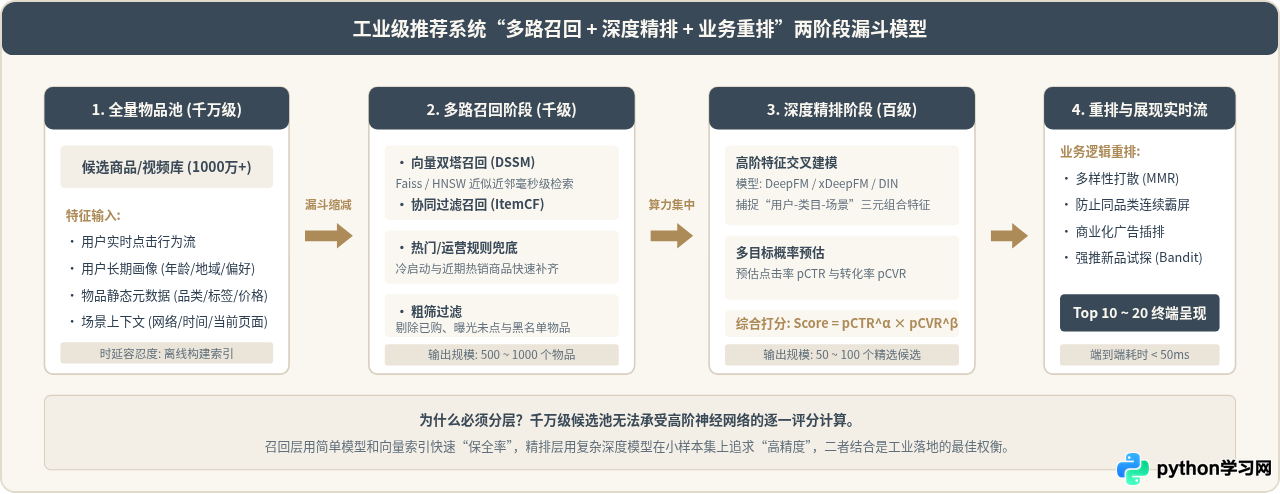
推荐系统的本质是在信息过载的场景下,解决用户需求与物品特征的精准匹配问题。无论是电商平台的“猜你喜欢”,还是短视频应用的内容推荐,工业级推荐架构通常不会采用单一算法,而是采用经典的“召回(Candidate Generation)+ 精排(Ranking)”两阶段漏斗架构。
实战代码:基于物品协同过滤(ItemCF)的相似推荐算法原型
以下是使用 Python 原生计算环境实现的经典基于物品的协同过滤推荐算法。其核心思路是:如果大部分喜欢物品 A 的用户也同时喜欢物品 B,则说明 A 与 B 具有强相关性。
import numpy as np
import pandas as pd

def build_item_cf_recommender(ratings_matrix: pd.DataFrame, target_user: str, top_k: int = 3):
    """
    基于物品协同过滤 (Item-based Collaborative Filtering) 原型
    ratings_matrix: 行为矩阵,行代表用户,列代表物品,数值代表评分或点击行为
    """
    # 1. 均值归一化,消除用户评分偏置
    user_ratings = ratings_matrix.loc[target_user]

    # 2. 计算物品与物品之间的余弦相似度矩阵
    # 填充缺失值为 0
    filled_matrix = ratings_matrix.fillna(0)
    item_vectors = filled_matrix.values.T  # 转置后每行为一个物品的向量

    # 计算点积与向量模长
    dot_product = np.dot(item_vectors, item_vectors.T)
    norms = np.linalg.norm(item_vectors, axis=1, keepdims=True)
    similarity_matrix = dot_product / (np.dot(norms, norms.T) + 1e-9)

    item_names = ratings_matrix.columns.tolist()
    item_sim_df = pd.DataFrame(similarity_matrix, index=item_names, columns=item_names)

    # 3. 针对目标用户未交互过的物品预测感兴趣得分
    unrated_items = user_ratings[user_ratings.isna()].index
    rated_items = user_ratings[user_ratings.notna()].index

    predicted_scores = {}
    for item in unrated_items:
        # 寻找该物品与用户已评分物品之间的相似度加权和
        sim_weights = item_sim_df.loc[item, rated_items]
        user_scores = user_ratings[rated_items]

        weight_sum = sim_weights.sum()
        if weight_sum > 0:
            predicted_scores[item] = np.dot(sim_weights, user_scores) / weight_sum
        else:
            predicted_scores[item] = 0.0

    # 4. 按预测得分降序排列并截取 Top-K
    ranked_recommendations = sorted(predicted_scores.items(), key=lambda x: x[1], reverse=True)[:top_k]
    return ranked_recommendations

if __name__ == "__main__":
    # 构建模拟用户-物品交互矩阵
    data = {
        "Python入门": [5.0, 4.0, np.nan, 1.0],
        "机器学习实战": [4.0, 5.0, 4.0, np.nan],
        "深度学习图解": [np.nan, 4.0, 5.0, np.nan],
        "烘焙指南": [1.0, np.nan, np.nan, 5.0]
    }
    df = pd.DataFrame(data, index=["用户A", "用户B", "用户C", "用户D"])

    # 为用户A推荐未阅读过的书籍
    # recs = build_item_cf_recommender(df, target_user="用户A", top_k=2)
    # print("推荐候选:", recs)
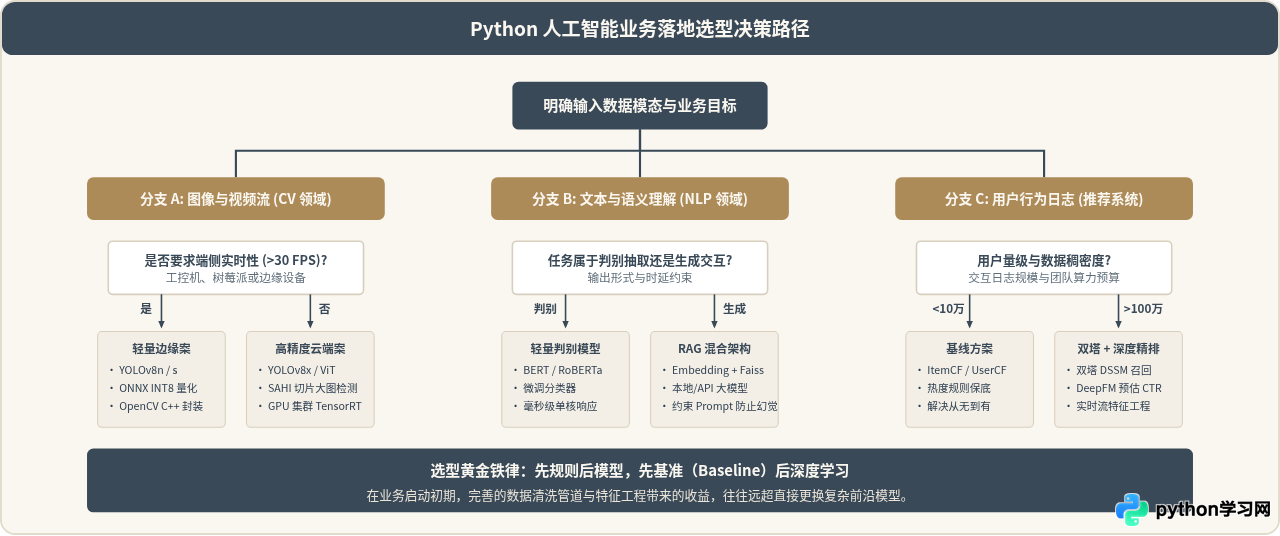
五、工业级落地技术选型与演进决策树
初涉人工智能工程化的团队极易陷入“盲目追求最前沿大模型”的误区。实际上,模型的复杂度、训练成本、部署硬件要求以及推理时延之间存在严格的工程互斥。根据业务现阶段的吞吐量、准确率要求及硬件成本制定理性选型,是项目能否落地的关键。
六、总结与落地建议
回到核心问题:用 Python 到底能做哪些具体的人工智能应用?
答案是明确的:在计算机视觉方向,你可以用 Python 实现工业缺陷在线筛查、视频周界入侵报警与文档图文抽取;在自然语言处理方向,你可以搭建智能客服分流引擎、合同要素结构化提取器以及挂载内部文档的精准知识库(RAG);在推荐系统方向,你可以开发电商个性化选品矩阵、资讯信息流个性化推荐以及效果广告点击率预估系统。
| 实战方向 | 核心解决问题 | 入门到生产推荐栈 | 主要算力与性能瓶颈 |
|---|---|---|---|
| 计算机视觉 (CV) | 图像/视频中的定位、分割与缺陷识别 | OpenCV + Ultralytics YOLOv8 + ONNX Runtime | 工业现场光照剧变、视频流高并发编解码耗时 |
| 自然语言处理 (NLP) | 文本语义理解、分类、抽取与精准知识问答 | jieba + Hugging Face Transformers + FAISS | 长文本显存开销、专业领域词汇歧义、生成幻觉 |
| 推荐系统 (RecSys) | 海量物品与用户画像的高效匹配与点击预估 | Pandas + Surprise / LightFM + DeepCTR-Torch | 数据稀疏性严重、冷启动无历史交互、同质化严重 |
在实际技术推进中,建议开发者遵循“三步走”的落地策略:
- 先把数据链路走通:确保输入数据(图像清晰度、文本编码规范、用户埋点日志完整性)具备真实性和代表性,严禁在未清洗的数据上做无效训练;
- 用最简单的模型建立基线:CV 先跑通 YOLO 轻量模型,NLP 先跑通简单微调判别模型,推荐系统先跑通协同过滤。用基准指标作为后续技术迭代的标准线;
- 严控推理部署延迟:将模型导出为 ONNX 或 TensorRT,脱离训练框架直接挂载高性能推理服务,确保在业务 SLA 允许的时延范围内稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















