


Python内置sqlite3无需单独下载:直接使用本地数据库的方法
详细讲解Python内置sqlite3模块的使用方法。无需单独下载和安装数据库服务器,直接通过标准库创建、读写和管理本地数据库文件。
在绝大多数日常脚本、单机软件、数据缓存或初学者练习场景中,很多开发者习惯性地去寻找 MySQL、PostgreSQL 等独立数据库管理系统,却常常被烦琐的软件安装、端口占用和账号权限配置劝退。实际上,Python 官方安装包中就已经内置了轻量级关系型数据库模块 sqlite3。开发者无需运行 pip install,也无需在操作系统中启动任何数据库守护进程,只要一条 import sqlite3 语句,就能在本地磁盘上直接生成、连接并读写标准化数据库文件。
一、为什么 Python 使用 SQLite 无需单独安装?
许多开发者初次听到“内置数据库”时会有疑问:数据库软件通常体积庞大且结构复杂,为什么 Python 能随装随用?这里的核心在于 SQLite 独特的运行架构。
传统的 MySQL、SQL Server 或 PostgreSQL 采用的是客户端/服务端(C/S)架构。应用程序必须借助驱动模块,通过 TCP/IP 网络协议或本地套接字向数据库后台守护服务发起连接,所有的 SQL 解析、数据存取都由独立的数据库进程完成。而 SQLite 是嵌入式(In-Process)数据库,它的核心引擎由简洁高效的 C 语言编写,直接作为动态链接库嵌入到 Python 解释器中。在底层,SQLite 并不监听端口,也没有独立服务,它将整张数据表、索引和元数据存放在本地的一个单体文件中,读写操作直接由当前 Python 进程的磁盘 I/O 驱动完成。
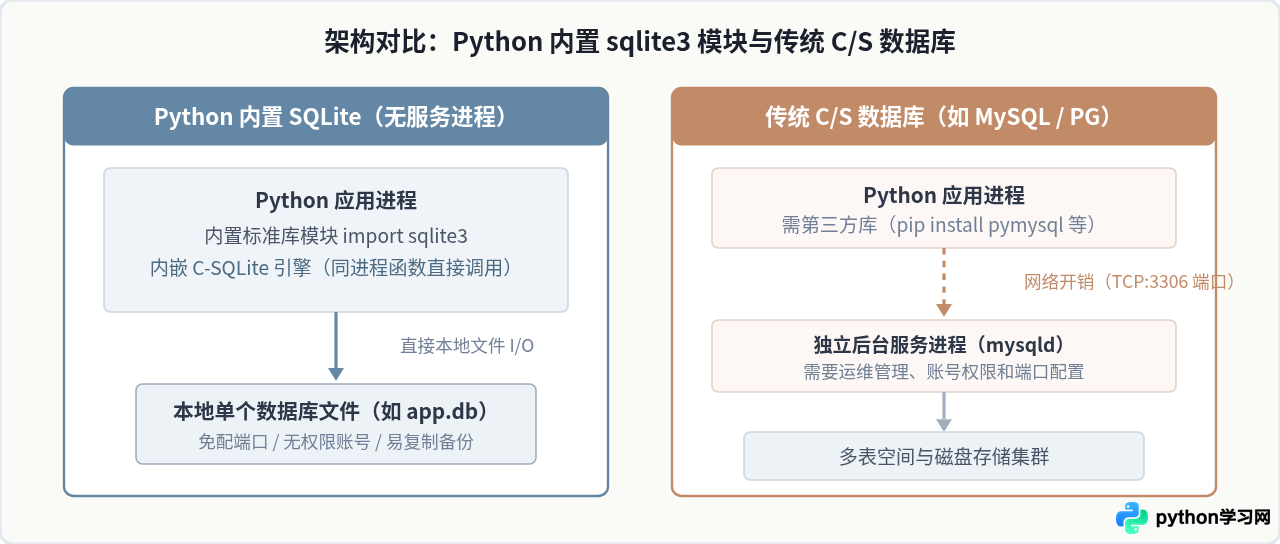
因此,只要安装了标准的 Python 环境(无论是 Windows、macOS 还是各类 Linux 发行版),就已经具备了完整的关系型数据库能力。开发者不需要运行数据库安装包,也不必配置 IP 地址、端口或 root 密码。
二、直接使用本地数据库的核心操作流程
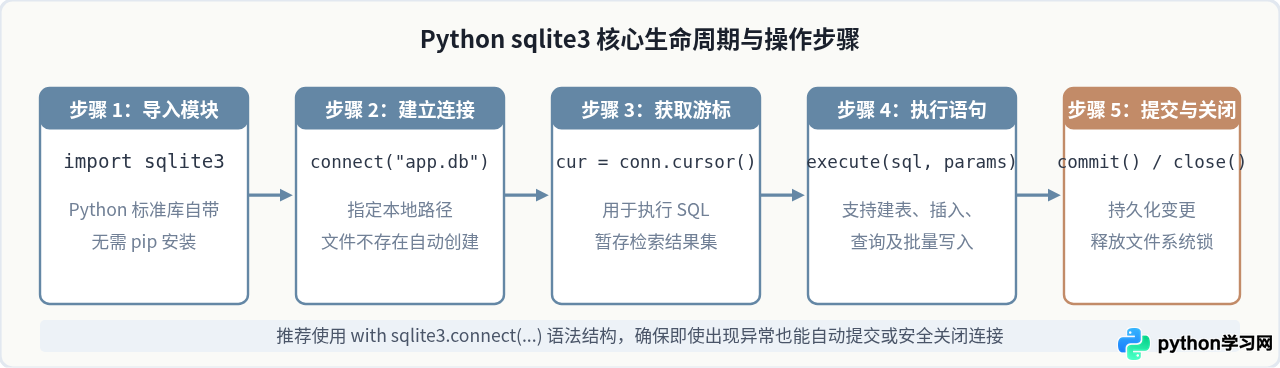
使用 sqlite3 操作本地数据库遵循标准的关系型数据库工作流:建立物理连接、获取游标对象、执行标准 SQL、提交事务、关闭并安全释放句柄。整个生命周期清晰可控。
1. 连接与自动创建数据库文件
在 Python 中建立数据库极其直接:调用 sqlite3.connect(database_path) 即可。如果指定的数据库文件在当前目录或目标路径中不存在,SQLite 引擎会自动在磁盘上新建该文件;如果文件已存在,则直接打开并建立会话。
import sqlite3

# 建立连接:如果 student_records.db 不存在,会自动创建
conn = sqlite3.connect("student_records.db")

# 检查当前驱动的 SQLite 库版本
print(f"当前 SQLite 核心版本: {sqlite3.sqlite_version}")

# 操作结束后关闭连接
conn.close()
注意:若传入的文件名包含目录层级(如 data/student_records.db),父级目录 data/ 必须预先存在,否则会抛出 OperationalError: unable to open database file 错误。
2. 创建数据表(DDL)
建立连接后,需要获取一个游标(Cursor)对象来执行 SQL 语句。SQLite 支持标准 SQL 的主要类型(INTEGER、REAL、TEXT、BLOB、NULL)。
import sqlite3

conn = sqlite3.connect("student_records.db")
cursor = conn.cursor()

# 创建一张学生成绩表
cursor.execute("""
CREATE TABLE IF NOT EXISTS students (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    age INTEGER,
    score REAL
)
""")

# 提交结构变更并释放连接
conn.commit()
cursor.close()
conn.close()
3. 插入数据与批量写入(DML)
单条写入使用 cursor.execute(),多条记录写入使用 cursor.executemany()。在 SQLite 中,执行新增(INSERT)、修改(UPDATE)和删除(DELETE)等涉及数据落盘的操作后,必须显式调用 conn.commit(),否则这些改动只会停留在内存事务缓冲区中,程序退出后将被自动丢弃回滚。
import sqlite3

conn = sqlite3.connect("student_records.db")
cursor = conn.cursor()

# 1. 插入单条记录(使用问号占位符防注入)
cursor.execute(
    "INSERT INTO students (name, age, score) VALUES (?, ?, ?)",
    ("张三", 20, 89.5)
)

# 2. 批量插入多条记录
student_list = [
    ("李四", 21, 93.0),
    ("王五", 19, 76.5),
    ("赵六", 20, 88.0)
]
cursor.executemany(
    "INSERT INTO students (name, age, score) VALUES (?, ?, ?)",
    student_list
)

# 显式提交事务
conn.commit()

print(f"成功插入记录数: {cursor.rowcount}")

cursor.close()
conn.close()
4. 数据查询(DQL)
执行 SELECT 语句时无需调用 commit()。执行查询后,游标对象本身就是一个可迭代对象,也可以通过 fetchone() 获取单行、通过 fetchall() 获取全部行列表。
import sqlite3

conn = sqlite3.connect("student_records.db")
cursor = conn.cursor()

cursor.execute("SELECT id, name, age, score FROM students WHERE score >= ?", (85.0,))

# 方式一:直接迭代游标(节省内存,推荐用于大量数据)
print("成绩优秀学生名单:")
for row in cursor:
    print(f"学号: {row[0]}, 姓名: {row[1]}, 年龄: {row[2]}, 分数: {row[3]}")

# 方式二:获取单行记录
cursor.execute("SELECT MAX(score) FROM students")
highest_score = cursor.fetchone()[0]
print(f"最高分是: {highest_score}")

cursor.close()
conn.close()
三、核心避坑指南:参数化查询与防 SQL 注入
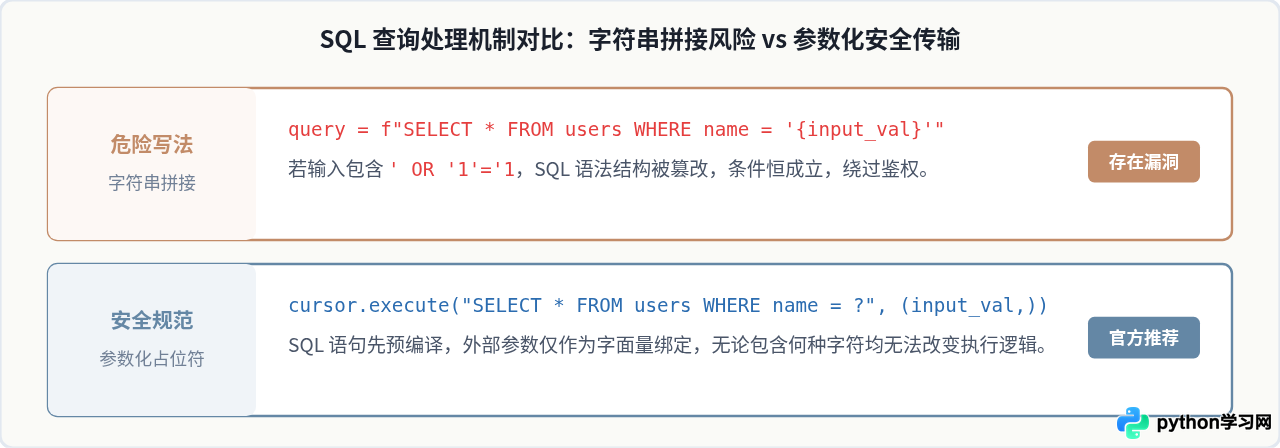
许多刚接触 sqlite3 的开发者由于图省事,习惯使用 Python 的字符串格式化(例如 f"SELECT ... WHERE name = '{user_name}'")拼接 SQL 语句。这是一种极度危险的做法。虽然 SQLite 运行在本地,但只要接收了不受信的外部输入(如 Web 表单、命令行参数或外部解析文件),拼接字符串就会瞬间引发 SQL 注入漏洞。
SQLite 支持参数化查询:在 SQL 文本中仅保留占位符 ?,而具体的值通过第二个元组或列表参数传递给 execute()。数据库引擎会将 SQL 结构先编译成执行树,参数严格作为数据字面量解析,从根本上阻断注入风险。
当执行单参数查询时,传给 execute() 的必须是序列(元组或列表)。例如写成 ("张三",) 时切记后面的英文逗号;如果写成 ("张三"),Python 会将其识别为普通字符串,并在内部将字符串拆解为字符序列遍历,导致参数数量不匹配错误。
四、进阶实用技巧:提升开发效率的两大特性
1. 自动事务管理(上下文管理器 with)
在生产代码中,手动书写 conn.commit() 和 conn.close() 容易遗漏,尤其是在抛出异常时可能导致事务处于未决状态或文件锁未被释放。Python 的 sqlite3.Connection 对象原生支持上下文管理器:
import sqlite3

# 使用 with 管理事务
with sqlite3.connect("student_records.db") as conn:
    cursor = conn.cursor()
    cursor.execute("UPDATE students SET score = score + 5 WHERE score < 90")
    # 代码块执行成功后会自动调用 conn.commit()
    # 一旦发生任何异常,自动触发 conn.rollback() 回滚变更
2. 将查询结果作为字典读取(sqlite3.Row)
默认情况下,sqlite3 查询返回的是普通元组(Tuple),开发者必须靠数字索引(如 row[0]、row[1])读取字段,字段较多时极易出错。通过设置连接对象的 row_factory = sqlite3.Row,可以使行对象支持像字典一样通过列名访问,同时仍保持元组的高性能:
import sqlite3

conn = sqlite3.connect("student_records.db")
# 启用 Row 工厂模式
conn.row_factory = sqlite3.Row

cursor = conn.cursor()
cursor.execute("SELECT name, score FROM students LIMIT 1")
row = cursor.fetchone()

# 既可以通过列名访问,也可以通过索引访问
print(f"学生姓名: {row['name']}, 成绩: {row['score']}")
print(f"也可以转为真实字典: {dict(row)}")

conn.close()
3. 超轻量测试:纯内存数据库(:memory:)
如果在进行单元测试、算法验证或临时数据聚合时不需要真正保存文件,只需在连接时传入特殊的数据库名 ":memory:"。SQLite 会在 RAM 中构建数据库,测试结束后直接释放,读写速度达到微秒级且不留下任何磁盘垃圾:
import sqlite3

# 纯内存数据库,不写入磁盘
mem_conn = sqlite3.connect(":memory:")
mem_cur = mem_conn.cursor()
mem_cur.execute("CREATE TABLE temp_cache (k TEXT PRIMARY KEY, v TEXT)")
mem_cur.execute("INSERT INTO temp_cache VALUES ('session_id', 'xyz-9988')")
# 进程结束即随之销毁
mem_conn.close()
五、使用场景边界与局限性认知
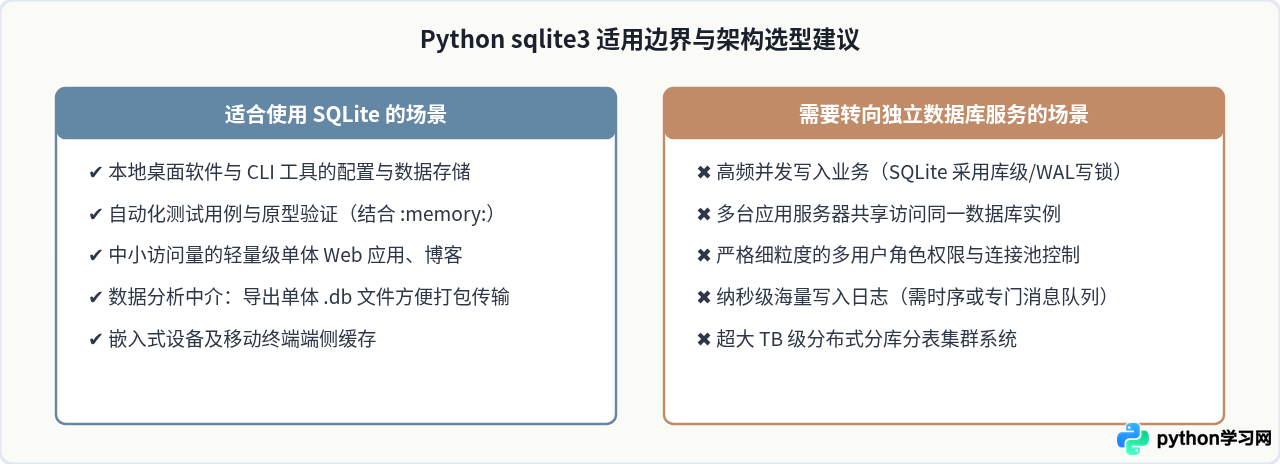
虽然 SQLite 极其方便且完全免费免装,但工程设计必须根据场景权衡。清晰认知其能力边界是合理选型的关键。
| 特性维度 | Python 内置 sqlite3 | 独立数据库(如 MySQL / PostgreSQL) |
|---|---|---|
| 安装与依赖 | 随 Python 解释器内置,0 外部依赖 | 需单独下载、安装并维护后台进程 |
| 数据载体 | 单体本地磁盘文件(例如 .db) |
复杂的文件存储集群与后台服务管理 |
| 网络开销 | 无网络延迟,直接进程级函数调用与文件读写 | 跨进程或跨主机 TCP/IP 通信 |
| 并发写入支持 | 写入时锁定整个数据库(适合读多写少) | 支持行级锁与高并发多节点分布式读写 |
| 运维与备份 | 直接拷贝文件即可完成整库备份迁移 | 需专用备份工具(如 mysqldump、WAL归档) |
六、总结
Python 标准库中的 sqlite3 提供了一套真正零门槛、开箱即用的本地数据持久化方案。对于日常的数据抓取留存、单机工具开发、桌面 GUI 程序存储、配置文件升级以及开发测试环境搭建,它完全省去了安装配置数据库软件的时间成本与运维负担。
掌握以下几项核心实践,即可高效稳妥地在项目中运用 SQLite:
- 无需额外安装:直接
import sqlite3即可启用,传入文件名即完成库连接或创建; - 坚持参数化查询:使用
?传递外部参数,严禁字符串拼接构造 SQL; - 善用上下文管理器:使用
with sqlite3.connect(...)保证事务自动提交与异常回滚; - 活用特性:利用
conn.row_factory = sqlite3.Row获得直观的字典式读取体验,使用:memory:进行闪电般的内存测试; - 明确边界:在单应用、单文件、读多写少的轻量级场景下坚定使用 SQLite,在涉及复杂多机网络并发、高吞吐写入时再顺畅过渡到独立数据库服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















