


Python用pandas还是openpyxl做Excel汇总?
深入对比Python处理Excel汇总时pandas与openpyxl的核心差异、底层原理与适用场景,提供多表批量合并、模板回填与协同流水线的完整实现与选型指南。
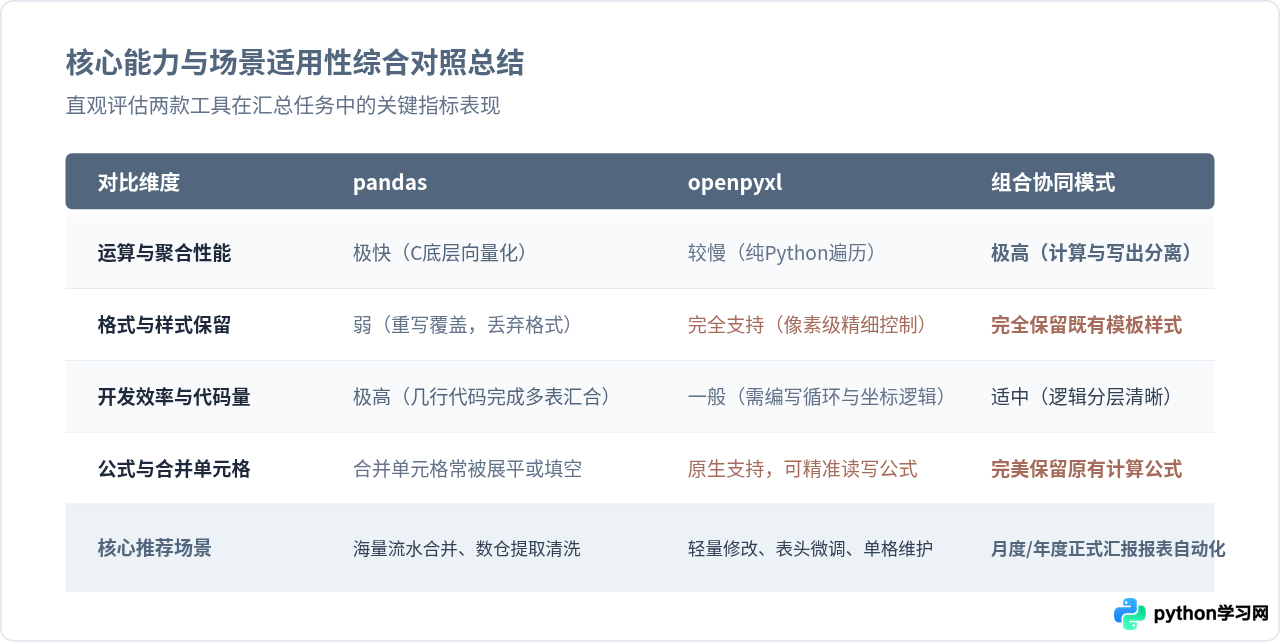
面对分散在数十个部门、成百上千张 Excel 报表的汇总任务,初学者常常陷入两难:直接用 openpyxl 逐个单元格读取累加,代码冗长且运行耗时漫长;改用 pandas 几行代码完成合并与透视,却发现原有报表精心设置的表头颜色、单元格边框、合并单元格以及动态公式荡然无存。核心结论十分明确:如果汇总的诉求是纯粹的数据合并、清洗、统计与分析,不需要保留原文件样式,首选 pandas;如果汇总目标是保留或生成具有精美排版、特定样式、合并单元格或嵌入既有公式的正式交付模板,必须使用 openpyxl;而在工业级自动化任务中,最具生产力的解法是“pandas 负责高速数据运算,openpyxl 负责模板回填与格式收尾”的组合模式。
一、底层模型差异:二维数据表与 Office 文档对象
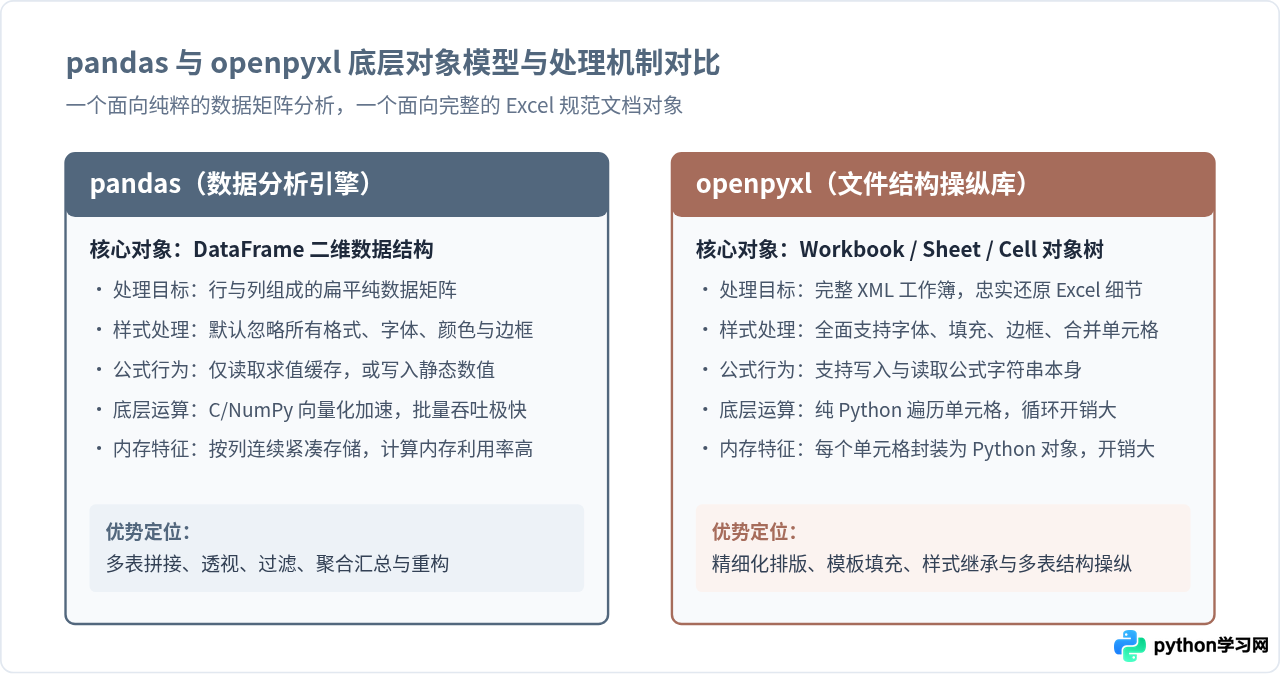
理解技术选型的关键,在于认清两个库对 Excel 文件完全不同的抽象视角。在计算机底层,.xlsx 文件本质上是一个打包了若干 XML 文档的 ZIP 压缩包,里面记录了工作簿结构、工作表坐标、单元格取值、字体样式、边框、打印区域以及计算公式等全部元数据。
pandas 是一个高性能数据分析引擎,它的核心目标是矩阵计算。当它通过 pd.read_excel() 加载文件时,会直接抛弃所有非数据元素(如单元格背景色、字体磅值、图表和条件格式),将二维单元格区域解析为内部连续内存中的 DataFrame。这种舍弃换来了基于 C 和 NumPy 底层向量化运算的极致性能,使得多列过滤、求和与分组汇总仅需几个毫秒。
与此相对,openpyxl 是一个严格遵循 OpenXML 规范的文档对象模型(DOM)操纵库。在 openpyxl 眼中,Excel 是由 Workbook、Worksheet、Row 和 Cell 构成的层级树。每一个单元格都被封装成一个独立的 Python 对象,拥有完整的 value、font、border、fill、number_format 等属性。openpyxl 的使命是保证文件结构的保真度,无论读取还是修改,都能最大程度还原 Excel 软件本身的操作行为,但这种颗粒度带来了更高的内存与解释器调度开销。
二、场景一:多源海量数据批量汇总,pandas 的高效实践
日常业务中最常见的汇总需求是:收集各分支机构或按日期生成的月度销售报表(如 sales_branch_*.xlsx),结构统一或相近,需要将它们拼接合并后,按产品大类统计出累计销售金额、订单总数和平均客单价。
如果用 openpyxl 实现该任务,开发者必须先打开各个文件,获取活动工作表,跳过表头行逐行读取单元格坐标,将各行字典或元组追加到列表,最后在 Python 中手写求和逻辑。而使用 pandas,整个流程可以标准化为目录扫描、批量读取、数据拼接、聚合计算和导出写出五步:
import pathlib
import pandas as pd

# 1. 扫描目录下所有分店月度 Excel 文件
data_dir = pathlib.Path("./monthly_reports")
file_list = list(data_dir.glob("sales_*.xlsx"))

data_frames = []
for file_path in file_list:
    # 2. 读取目标列,并通过文件名解析分店标识
    df = pd.read_excel(file_path, usecols=["产品类别", "销售数量", "销售金额"])
    df["数据来源"] = file_path.stem
    data_frames.append(df)

# 3. 纵向合并所有分表
total_df = pd.concat(data_frames, ignore_index=True)

# 4. 聚合计算:按产品类别汇总总销量、总销售额与平均客单价
summary_result = total_df.groupby("产品类别").agg(
    总销售数量=("销售数量", "sum"),
    总销售金额=("销售金额", "sum"),
    平均订单额=("销售金额", "mean")
).reset_index()

# 5. 导出结构化汇总表
summary_result.to_excel("annual_sales_summary.xlsx", index=False)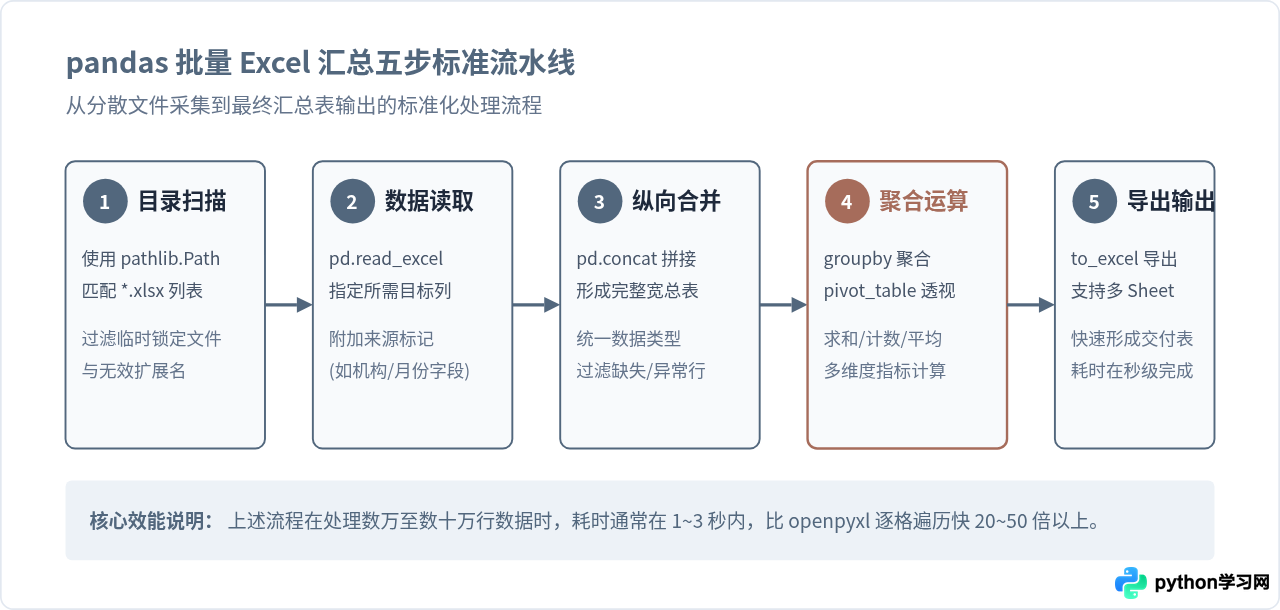
三、场景二:复杂格式与模板回填,openpyxl 的不可替代性
并非所有 Excel 任务都追求单纯的数据清洗。在企业财务、审计或管理层汇报中,报表格式往往有极其严苛的标准:第一行是加粗大字号的合并标题,第二行带有填报单位与生成日期的元信息,表头具备专属主题色填充与加粗双下划线,末尾还预设了 =SUM(D4:D15) 这样的动态公式以及签字盖章区域。
如果使用 pandas 写回该文件,现有的表头合并会被强行拆分,原有预设公式会被破坏为静态字符或被直接清除,表格样式也会退化为无格式的默认白底黑字。此时,必须使用 openpyxl 打开既有模板,仅在指定坐标填入数据,同时完整保留模板既有的一切设计:
import openpyxl
from openpyxl.styles import Font, Alignment

# 1. 打开公司预设的标准汇总模板(保留所有原有公式与格式)
wb = openpyxl.load_workbook("template_monthly_report.xlsx")
ws = wb["汇总报表"]

# 2. 定位指定单元格填入汇总信息
ws["C2"].value = "2026年10月"
ws["E2"].value = "财务数据中心"

# 3. 假设计算所得的各项汇总数值
summary_data = [
    ("华东大区", 1250000, 3420),
    ("华北大区", 980000, 2180),
    ("华南大区", 1430000, 4010)
]

start_row = 5
for row_idx, (region, sales, orders) in enumerate(summary_data, start=start_row):
    ws.cell(row=row_idx, column=2, value=region)
    ws.cell(row=row_idx, column=3, value=sales)
    ws.cell(row=row_idx, column=4, value=orders)
    # 为新增单元格应用指定格式
    ws.cell(row=row_idx, column=3).number_format = "¥#,##0.00"

# 4. 在汇总行填入原生 Excel 公式,由 Excel 打开时自动动态计算
total_row = start_row + len(summary_data)
ws.cell(row=total_row, column=2, value="合计")
ws.cell(row=total_row, column=3, value=f"=SUM(C{start_row}:C{total_row-1})")
ws.cell(row=total_row, column=4, value=f"=SUM(D{start_row}:D{total_row-1})")

# 5. 保存为新报表,模板完整无损
wb.save("final_report_october.xlsx")避坑提示:openpyxl 在读取包含公式的单元格时,如果设置了 data_only=True,读取到的将是 Excel 上一次保存时的数值缓存;如果该文件是由程序直接生成且从未在 Excel 桌面端打开保存过,缓存可能为空(读取结果为 None)。如果设置 data_only=False(默认),读取到的则是公式字符串(如 =SUM(...))。
四、关键差异与技术选型决策树
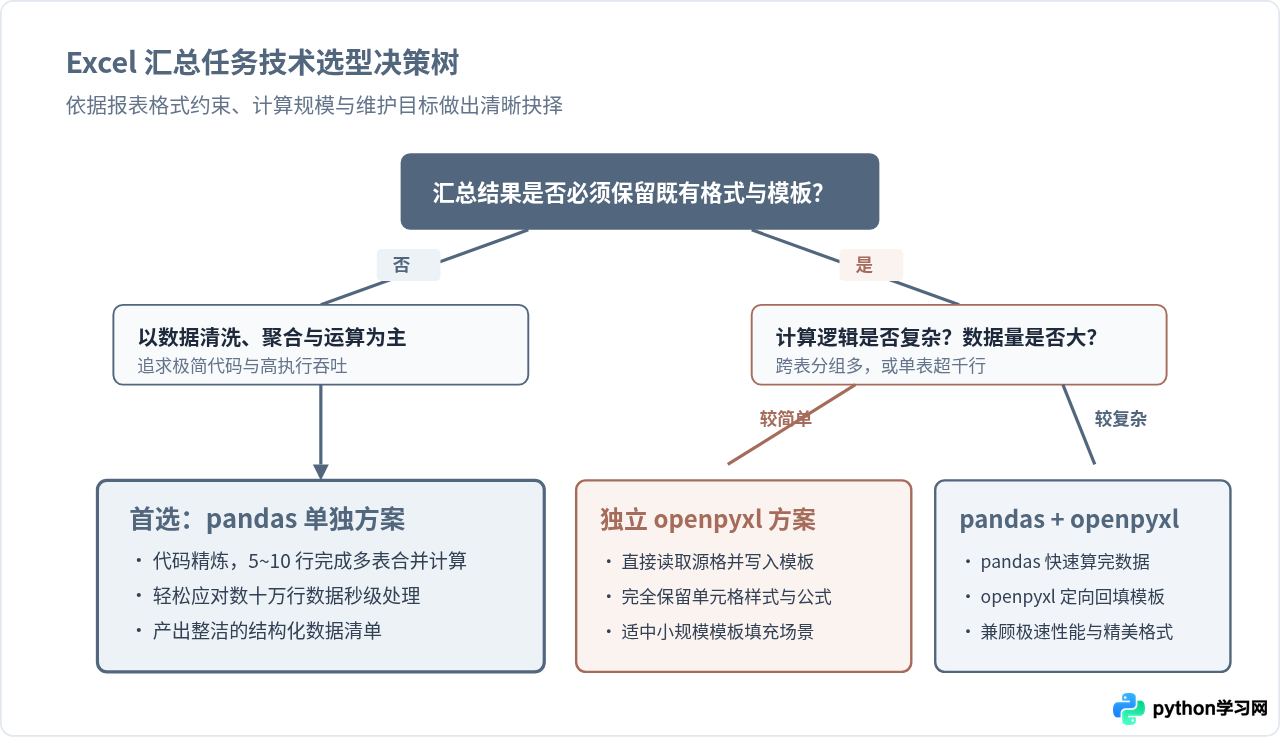
选择 pandas 还是 openpyxl,本质上取决于“产物的主要受众是系统还是人类审阅者”,以及“计算吞吐量与排版保真度谁是首要瓶颈”。通过以下决策维度可以快速厘清分界线:
五、工程最佳实践:组合流水线(pandas 算数据 + openpyxl 刷格式)
在实际工程项目中,最成熟的方案往往不是二选一,而是两者的强强联合:用 pandas 处理所有复杂的多表关联、字段清洗和分组统计,将产出的规整结果交给 openpyxl 写入现成的业务模板。借助 openpyxl.utils.dataframe.dataframe_to_rows,两个库之间的数据传递完全在内存中完成,无缝衔接:
import openpyxl
from openpyxl.utils.dataframe import dataframe_to_rows
import pandas as pd

# 第一阶段:pandas 负责批量汇总计算
raw_data = pd.read_excel("raw_transactions.xlsx")
summary_df = raw_data.groupby("销售代表").agg(
    成交总额=("订单金额", "sum"),
    成单笔数=("订单号", "count")
).reset_index()

# 第二阶段:openpyxl 加载规范格式模板并写入
wb = openpyxl.load_workbook("report_template.xlsx")
ws = wb["业绩汇总"]

# 从第 4 行开始写入,跳过 pandas 自动生成的表头
start_row = 4
for r_idx, row in enumerate(dataframe_to_rows(summary_df, index=False, header=False), start=start_row):
    for c_idx, val in enumerate(row, start=1):
        cell = ws.cell(row=r_idx, column=c_idx, value=val)

wb.save("monthly_performance_final.xlsx")
这种分工模式将“业务计算逻辑”与“视觉排版逻辑”清晰解耦。业务指标变动时只需调整 pandas 聚合规则,前端排版升级时也只需替换 Excel 模板,无需在 Python 代码中堆叠繁琐的样式坐标控制。
六、总结与选型速查
综上所述,Python 做 Excel 汇总不存在非此即彼的优劣,而是职责分明的工具分工:
- 只用 pandas:适合数据量大(数万至百万行)、涉及多表关联/透视/聚合、输出为纯数据供后续系统消费的场景;
- 只用 openpyxl:适合数据量不大、需要精准修改已有特定单元格、保留原有公式、合并单元格与精细排版的场景;
- 组合协同:适合企业级标准化报表产出,充分发挥 pandas 的计算性能与 openpyxl 的保真呈现能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















