


Python函数基础练习题答案:常见经典例题代码与解析
精选Python函数基础常见经典例题与标准答案,涵盖多返回值、动态参数解包、变量作用域、可变对象默认参数陷阱等核心知识点,提供完整可运行代码与深度图文解析。
例题一:统计数值列表的核心指标(多返回值与元组拆包)
题目要求:编写一个名为 calculate_stats 的函数,接收一个数字列表作为参数,计算并同时返回该列表的最小值、最大值和平均值(保留两位小数)。若传入列表为空,返回 None 或明确抛出异常。
解题思路与考点分析
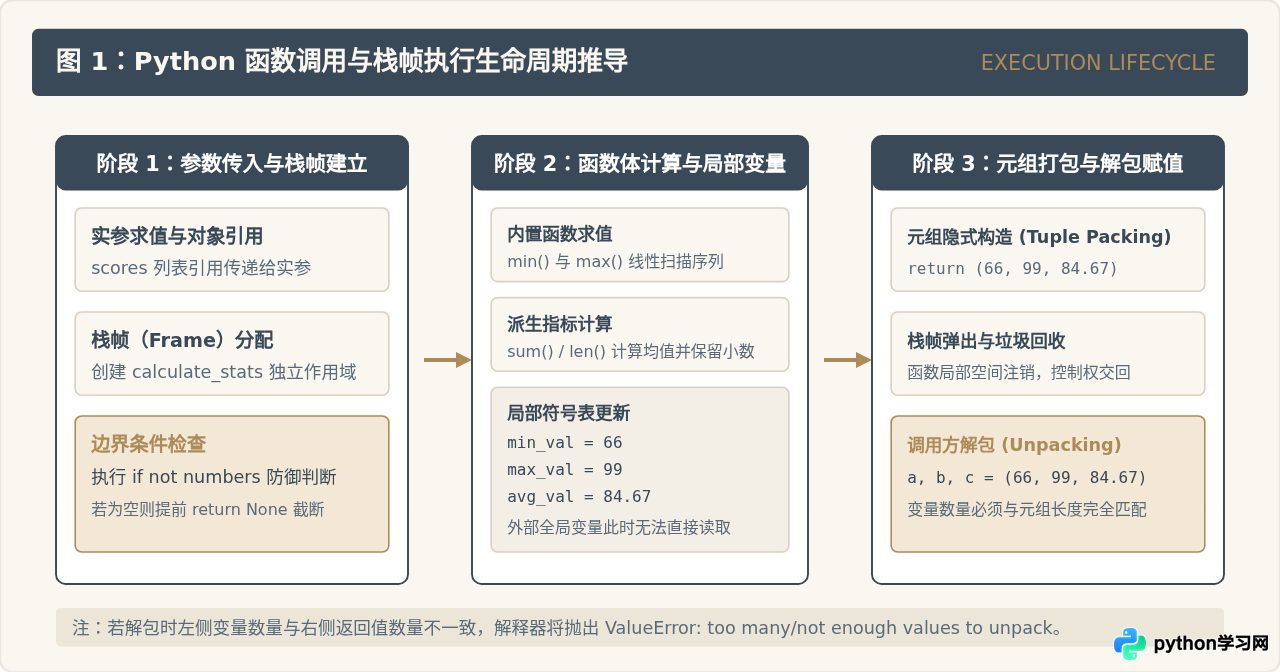
本题重点考察 Python 函数的返回值机制。Python 表面上支持通过逗号返回多个值(如 return min_val, max_val, avg_val),但底层实质是将其打包为一个元组(Tuple)返回。调用者可以在接收端利用多元赋值(Tuple Unpacking)直接将各项指标解构成独立变量。
def calculate_stats(numbers):
    """
    计算数字列表的最小值、最大值和平均值

    参数:
        numbers: 包含数字的列表
    返回:
        tuple: (min_val, max_val, avg_val) 或 None
    """
    # 边界防御:检查传入参数是否有效且非空
    if not numbers:
        return None

    min_val = min(numbers)
    max_val = max(numbers)
    avg_val = round(sum(numbers) / len(numbers), 2)

    # 逗号分隔直接打包为元组返回
    return min_val, max_val, avg_val

# 示例测试
scores = [78, 92, 85, 66, 99, 88]
min_score, max_score, avg_score = calculate_stats(scores)

print(f"最低分: {min_score}")
print(f"最高分: {max_score}")
print(f"平均分: {avg_score}")
控制台运行示例:
最高分: 99
平均分: 84.67
理解函数被调用的具体执行过程,有助于理清参数如何传入以及结果如何被返回。以下图示梳理了从入参检验到栈帧退出的完整生命周期:
例题二:动态日志打印器(位置参数、默认参数、*args与**kwargs)
题目要求:设计一个通用的日志打印函数 format_log。要求具备以下特性:
- 必须接收一个事件名称
event(位置参数); - 允许指定日志级别
level,默认值为"INFO"(默认参数); - 允许传入任意数量的附加标签
*tags; - 允许传入任意键值对
**metadata记录事件详细上下文; - 最后将所有要素组装成一段格式规范的字符串并返回。
解题源码与参数分类
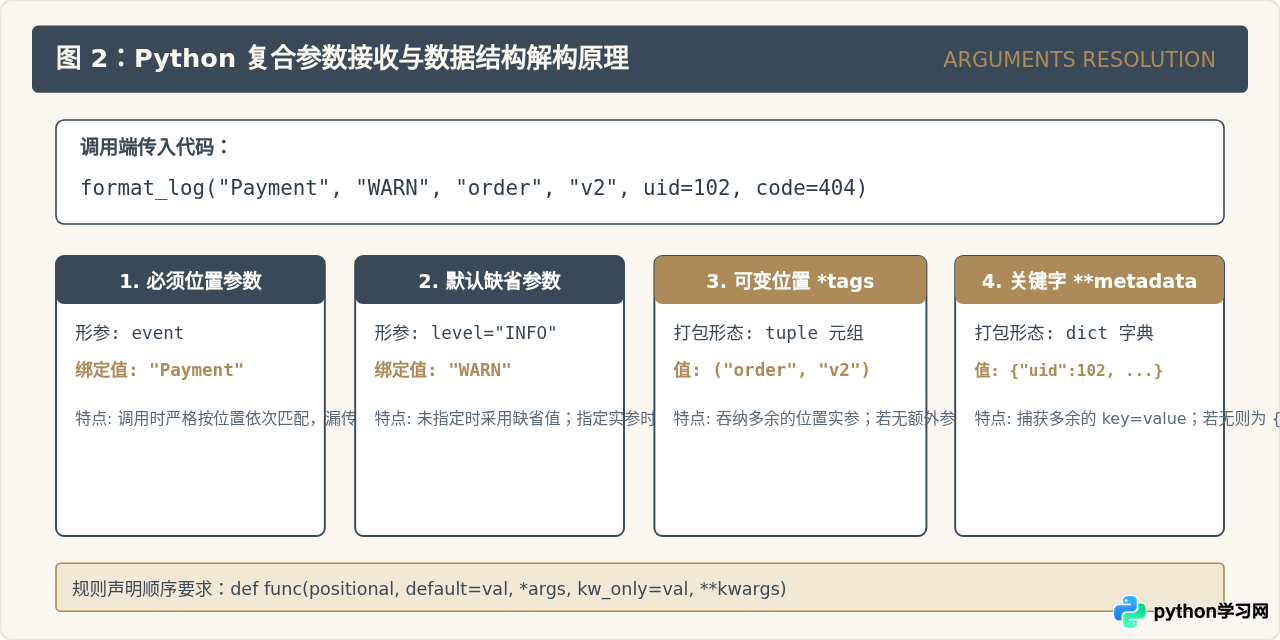
在 Python 参数体系中,声明顺序至关重要,必须严格遵守:位置参数 -> 默认参数 -> *args (元组) -> 关键字参数 / **kwargs (字典)。
def format_log(event, level="INFO", *tags, **metadata):
    """
    格式化事件日志信息
    """
    # 标签部分:若存在标签则用方括号包裹,逗号拼接
    tag_str = f" [{', '.join(tags)}]" if tags else ""

    # 元数据部分:遍历字典拼接 key=value
    meta_parts = [f"{k}={v}" for k, v in metadata.items()]
    meta_str = f" | {', '.join(meta_parts)}" if meta_parts else ""

    return f"[{level.upper()}] {event}{tag_str}{meta_str}"

# 场景 1:仅传入必须的位置参数,其余使用默认值
log1 = format_log("SystemStart")

# 场景 2:传入位置、覆盖默认参数、追加不定长标签
log2 = format_log("UserLogin", "DEBUG", "auth", "web_v2")

# 场景 3:同时传入标签与扩展元数据(关键字键值对)
log3 = format_log("PaymentFailed", "ERROR", "order", "urgent", user_id=10086, code="ERR_TIMEOUT")

print(log1)
print(log2)
print(log3)
控制台运行示例:
[DEBUG] UserLogin [auth, web_v2]
[ERROR] PaymentFailed [order, urgent] | user_id=10086, code=ERR_TIMEOUT
初学者容易对 *args 与 **kwargs 的打包逻辑产生混淆。图 2 直观展示了实参传入时解释器是如何根据语法形态进行自动归类的:
例题三:计数闭包与变量作用域(LEGB规则与nonlocal关键字)
题目要求:实现一个自增计数器生成函数 create_counter(start=0)。每次调用返回的计数器函数时,计数递增 1 并返回当前最新数字。要求不使用全局变量(global),保持计数状态独立封装。
解题思路与作用域陷阱
在 Python 中,当在内层函数对变量进行赋值时(如 count += 1),解释器默认将其视作内层函数的局部变量。但在尚未给局部变量赋初始值时就试图读取并递增它,会直接抛出 UnboundLocalError: local variable referenced before assignment。为了打破这一限制,必须使用 nonlocal 关键字告知解释器该变量来自外层嵌套作用域(Enclosing Scope)。
def create_counter(start=0):
    """
    闭包计数器生成器
    """
    count = start  # 位于 Enclosing 作用域的自由变量

    def counter():
        nonlocal count  # 显式声明修改外层作用域变量
        count += 1
        return count

    return counter

# 实例化两个独立的计数器
counter_a = create_counter(10)
counter_b = create_counter(100)

print("A 的调用:", counter_a())  # 11
print("A 的调用:", counter_a())  # 12
print("B 的调用:", counter_b())  # 101
print("A 的调用:", counter_a())  # 13
控制台运行示例:
A 的调用: 12
B 的调用: 101
A 的调用: 13
Local(局部) -> Enclosing(闭包外层) -> Global(全局) -> Built-in(内置)。如果仅仅是“读取”外层变量,无需加任何关键字;但若要对其实施“重新赋值绑定”,则必须按层级显式声明 nonlocal 或 global。
例题四:购物车列表添加项(经典“可变默认参数”陷阱及修复)
题目要求:排查并修复以下常见业务代码中的严重隐患:编写一个向用户购物车添加商品的函数 add_to_cart(item, cart=[]),确保每次调用时若未显式传入购物车列表,均创建独立的新购物车,互不干扰。
缺陷复现与原理解析
很多初学者会写出如下代码:
# 错误写法:使用可变对象(list)作为默认参数
def add_to_cart_buggy(item, cart=[]):
    cart.append(item)
    return cart

# 连续调用测试
user1_cart = add_to_cart_buggy("Apple")
user2_cart = add_to_cart_buggy("Banana")

print("User 1:", user1_cart)
print("User 2:", user2_cart)
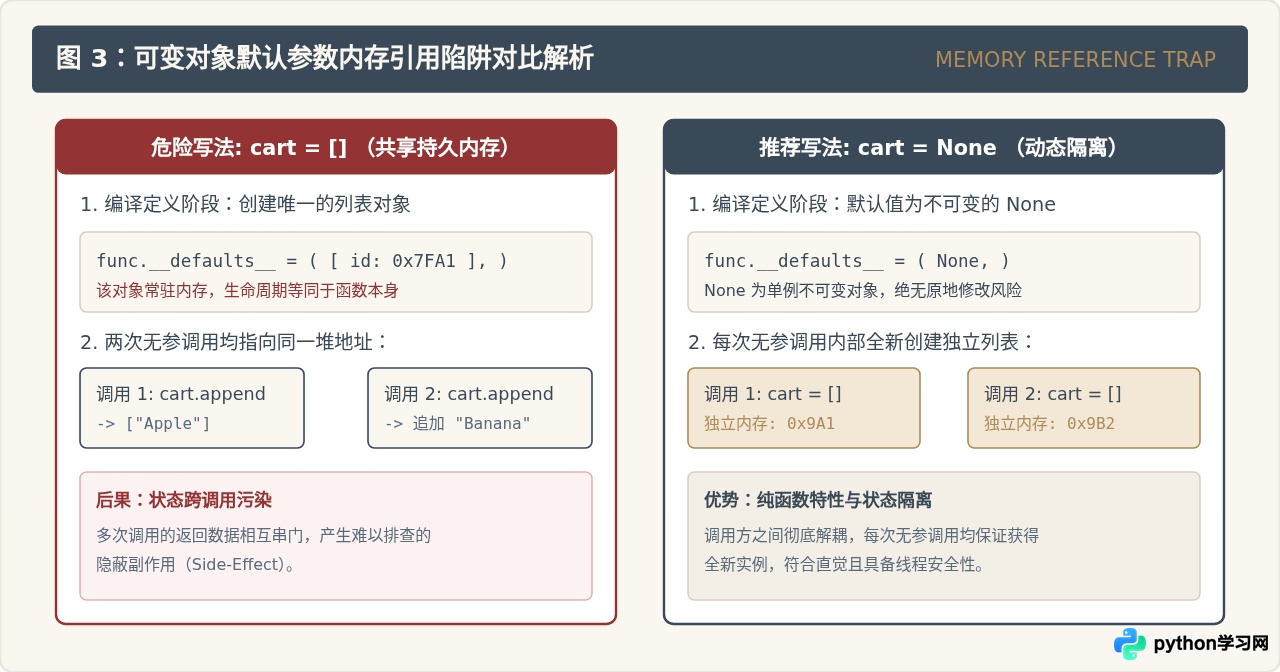
运行结果令人意外:User 1: ['Apple', 'Banana'] 且 User 2: ['Apple', 'Banana']!用户2的购物车竟然混入了用户1的商品。根本原因在于:Python 中的默认参数是在函数“定义解析阶段”被计算并创建的,且仅创建一次。该默认列表对象绑定在函数的 __defaults__ 属性中,所有未提供参数的调用都在修改同一个列表对象的内存空间。
标准修复方案
行业标准规范做法是:永远不要使用可变对象(列表、字典、集合)作为默认参数。统一将其缺省值设为不可变的 None,在函数体内部进行动态初始化:
def add_to_cart(item, cart=None):
    """
    标准规范写法:使用 None 作为占位符,内部动态创建新列表
    """
    if cart is None:
        cart = []  # 每次未传参调用时,独立申请全新的堆内存
    cart.append(item)
    return cart

# 重新验证
u1 = add_to_cart("Apple")
u2 = add_to_cart("Banana")

print("User 1 修复后:", u1)
print("User 2 修复后:", u2)
控制台运行示例:
User 2 修复后: ['Banana']
为了直观对比两种写法的内存实质差异,图 3 详细拆解了两者的内存指向过程:
例题五:递归扁平化任意嵌套的序列(递归基础与基线条件)
题目要求:编写一个递归函数 flatten_list(nested_list),能够接收任意层级嵌套的列表(例如 [1, [2, [3, 4], 5], [6, 7]]),将其展开并返回一个单一的一维平整列表 [1, 2, 3, 4, 5, 6, 7]。
解题思路与递归要素
编写递归函数的两大核心支柱是:基线条件(Base Case)与递归推进(Recursive Step)。针对列表中每一项元素,若当前元素是列表,则对其发起递归调用;若当前元素是非列表标量,则直接归入结果集中。
def flatten_list(nested_list):
    """
    递归展开多层嵌套的列表
    """
    result = []
    for item in nested_list:
        # 类型判断:如果是嵌套列表,则向下递归解开
        if isinstance(item, list):
            # 将下一层递归的返回值合并入当前列表
            result.extend(flatten_list(item))
        else:
            # 基线情况:如果是普通元素,直接追加
            result.append(item)
    return result

# 测试数据
complex_data = [1, [2, [3, 4], 5], 6, [[7, 8], 9]]
flat_data = flatten_list(complex_data)

print("原始数据:", complex_data)
print("扁平化后:", flat_data)
控制台运行示例:
扁平化后: [1, 2, 3, 4, 5, 6, 7, 8, 9]
Python函数规范与解题核心要诀总结
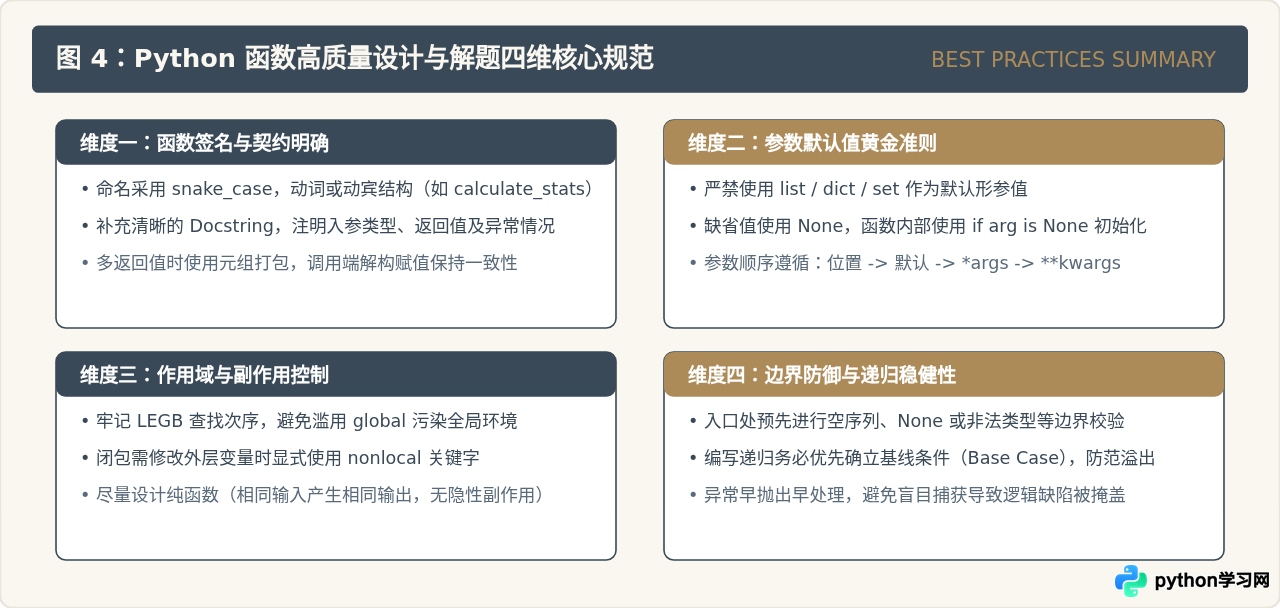
掌握 Python 函数编写,关键不仅在于语法的正确拼写,更在于树立清晰的工程规范意识。下图对函数设计的四大维度(签名规范、参数防坑、作用域边界、异常处理)进行了全景总结,作为日常编写与审阅代码的速查指南:
在日常练习和实际开发中,先理清数据结构如何在栈内存与堆内存中流动,再下笔写代码,能大幅减少调试定位Bug的时间。通过以上5道经典题目的推导与实操,读者可以建立起对 Python 函数本质的清晰认识。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















