


编程教学中使用Python中文变量名的利弊分析
深入分析在Python编程教学中使用中文变量名的利弊,从PEP 3131底层支持机制、初学者认知负荷、输入法与环境兼容性到工程衔接,提供切实可行的阶梯式教学过渡方案与场景决策指南。
学生成绩 = 95 或 圆周率 = 3.14 的代码。Python 3 早期就原生支持了 Unicode 标识符,语法层面完全允许使用中文给变量和函数命名。但在真实的教学实践中,中文变量名究竟是帮助学员跨过入门门槛的加速器,还是阻碍后续进阶的沉重负担?本文将从底层技术机制、认知负荷控制、日常编码摩擦以及工程规范衔接四个维度,全面拆解中文变量名的利弊,并给出清晰可执行的分阶段教学策略。
一、Python中文标识符的底层支持与语法边界
探讨教学利弊之前,首先需要明确一个技术事实:Python 对中文变量名的支持并不是某种第三方外挂或语法糖,而是源自 Python 3.0 正式生效的 PEP 3131(Supporting Non-ASCII Identifiers)标准。
在 Python 2 时代,标识符被严格限制在 ASCII 字符集内的英文字母、数字和下划线。而 Python 3 采用 Unicode 标准,其词法解析器在读取源码时,会将所有属于 Unicode 字符集中的“字母类”(包含汉字、平假名、希腊字母等)视为合法的标识符组成部分。解析器在构建符号表前,还会对字符进行 NFKC(兼容性等价分解与规范重组)规范化处理。
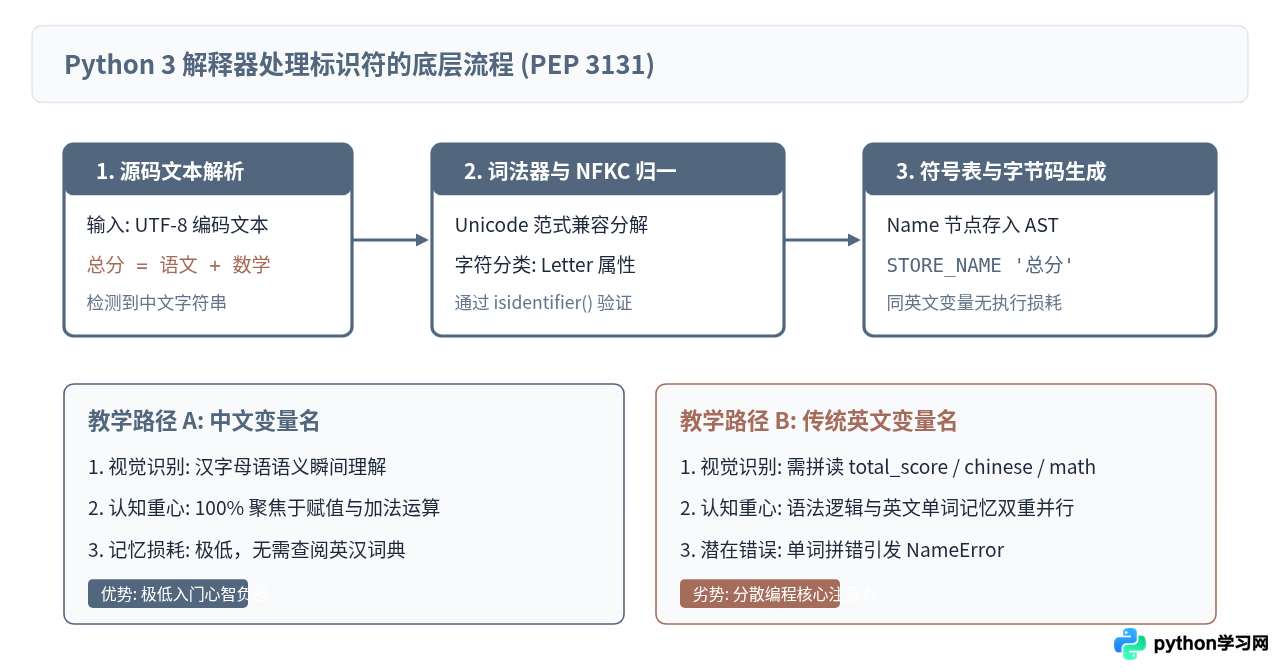
可以使用 Python 内置的 str.isidentifier() 方法检验标识符的合法性。例如:
# 验证中文标识符的合法性
print("学生姓名".isidentifier())    # 输出: True
print("单价_元".isidentifier())     # 输出: True
print("1班总人数".isidentifier())   # 输出: False (数字不能作为标识符开头)
print("学生 姓名".isidentifier())   # 输出: False (包含非法空白符)
print("学生,姓名".isidentifier())  # 输出: False (包含全角中文标点符号)
需要明确的是,虽然汉字本身是合法的标识符,但中文标点符号(如顿号、全角逗号、中文分号)并不在合法的标点或标识符范围内。这是后续课堂中各种报错的根源之一。
二、在教学中使用中文变量名的核心优势
在实际课堂环境下,推崇或尝试使用中文变量名的教师,其核心目标是降低认知门槛,提升直观反馈。具体体现在以下几个方面:
1. 消除“语言障碍 + 逻辑构建”的双重认知负荷
认知负荷理论指出,人类工作记忆的容量极其有限。对于小学阶段的儿童或未系统学习过英语的初学者而言,同时处理“英文词汇记忆/拼写”和“变量赋值/控制流逻辑”会产生严重的超载。
当使用 total_amount = unit_price * quantity 时,学生往往需要耗费精力思考:unit 是什么意思?price 怎么拼写?下划线怎么按出来?而一旦换成 总金额 = 单价 * 数量,语言理解被瞬时完成,学生的全部精力可以集中在等号的“赋值语义”和乘法计算上。
2. 公式与业务模型的直接映射
在中小学信息科技课或非计算机专业(如财务、统计、地理信息)的通识课中,编程是解决特定领域问题的计算工具。
例如,在讲解初中物理公式时,直接书写 速度 = 距离 / 时间 或 动能 = 0.5 * 质量 * 速度 ** 2,能够直接呼应学生已有的学科知识体系。学生无需建立一套“现实概念 → 英文简写 → 变量名”的三级映射,代码如同公式草稿纸一样直观易懂。
3. 显著降低初学者代码调试的视觉疲劳
刚入门的学生在阅读多行代码时,常常分不清哪些是“语言自带的保留关键字”(如 for、if、in、while),哪些是“自己定义的变量名”。
当变量名为汉字时,代码结构在视觉上天然分层:英文字母全部是保留关键字和内置函数,汉字全部是业务数据载体。这种高反差的视觉呈现,极大方便了初学者在黑板或投影仪上理清控制流脉络。
三、教学实践中的现实痛点与隐患
然而,中文变量名并非灵丹妙药。随着教学进度稍微深入,一系列难以回避的“副作用”就会显现出来:
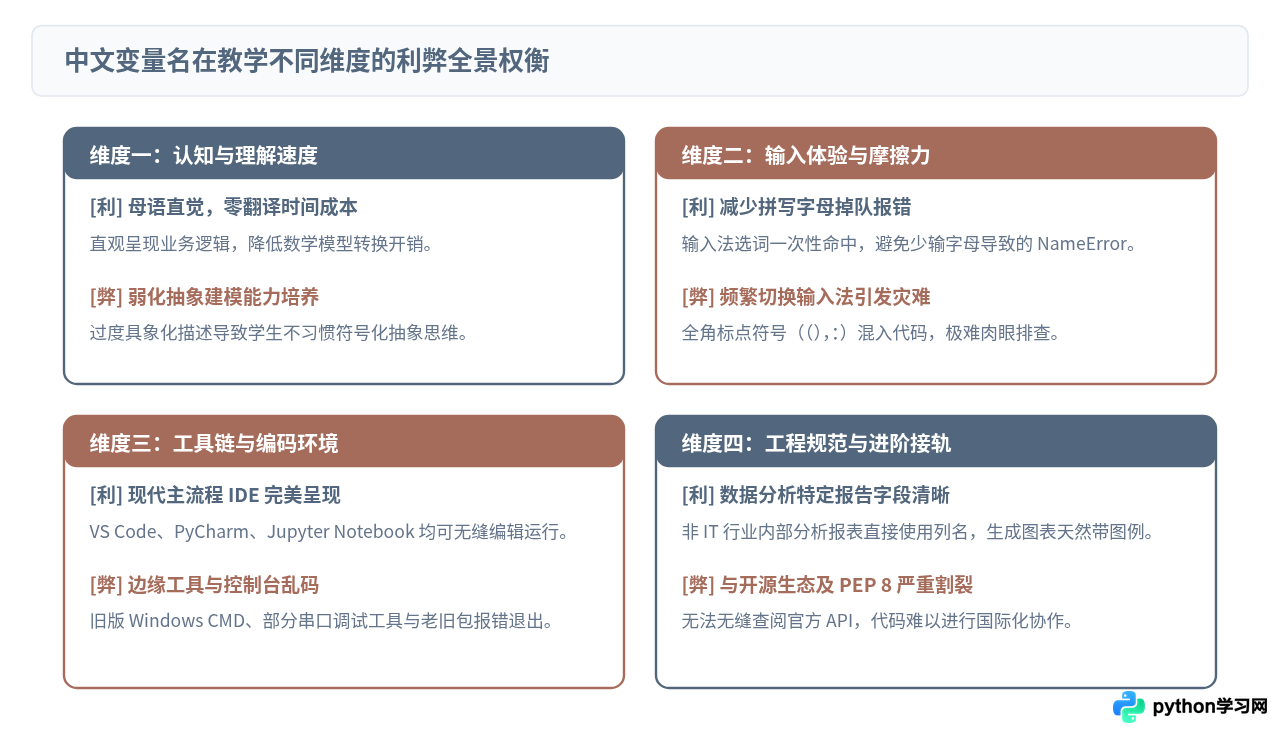
1. 输入法状态反复切换引发的“隐形挫败”
编写 Python 代码必须输入大量的半角符号:冒号 :、括号 ()、等号 =、中括号 []。如果变量名是中文,学生就必须在中文拼音输入法与英文半角输入法之间进行高频切换(例如按 Shift 键)。
初学者对输入法状态感知极弱,往往在没有切换回英文状态时输入了冒号或括号,结果打出全角符号 : 或 ()。Python 解释器会直接抛出:
SyntaxError: invalid character ':' (U+FF1A)在许多编辑器的等宽字体下,全角冒号与半角冒号的微小视觉间距极难被初学者肉眼察觉。这种因输入法切换带来的排错耗时,常常远超过拼写英文单词的耗时。
2. 与社区规范及 PEP 8 严重冲突
Python 社区官方风格指南 PEP 8 明确指出:虽然 Python 3 允许非 ASCII 标识符,但标准库的所有标识符必须使用 ASCII 字符,且推荐在开源项目与通用代码库中始终使用英文命名。
习惯了中文变量名的学生,在接触类名大驼峰(StudentScore)、变量小写蛇形(student_score)、常量全大写(MAX_CONNECTIONS)等工程规约时,往往缺少直接的语感过渡。汉字天然没有大小写概念,无法通过视觉形态承载作用域或常量语义。
3. 阅读官方文档与第三方库生态时的断层
现实中的 Python 开发离不开海量第三方库(如 requests、math、pandas)。官方 API 无论方法名、属性名还是返回字典的 Key,无一例外是英文。
如果长期用中文做“温室教学”,学生在第一步调用 math.sqrt() 或处理 response.status_code 时,依然要回到英文语境中。这种“变量全中文、库函数全英文”的拼贴代码,反而加重了思维割裂感。
注意:中文变量名还会在特殊技术场景产生隐形问题,例如:部分未升级的轻量级串口终端(MicroPython 嵌入式板卡)、生成带有变量名的动态 SQL 语句、或者序列化到部分对 UTF-8 字符键支持不健全的老旧系统时,容易出现偶发性编码崩溃。
四、关键代码案例与典型报错比对
为了让利弊分析更加具体,我们来看两段典型的课堂教学案例。
案例一:中文变量名适用的初学体验场景
# 场景:面向小学六年级的趣味算法课(BMI健康计算器)
身高_米 = 1.65
体重_公斤 = 52.0

体质指数 = 体重_公斤 / (身高_米 ** 2)

if 体质指数 < 18.5:
    评估结果 = "偏瘦"
elif 体质指数 < 24:
    评估结果 = "正常"
else:
    评估结果 = "偏胖"

print(f"您的BMI为: {体质指数:.1f},健康状态: {评估结果}")分析:这段代码对于初学者而言近乎于自然语言。学生能立刻明白每一行是在做什么,变量名称与其生活常识紧密融合,课堂上完全没有“这个单词是什么意思”的额外打扰。
案例二:输入法引发的隐蔽语法错误
# 易错对比示例:注意第 4 行与第 6 行的隐形差异
def 检查分数(成绩):
    if 成绩 >= 60:    # 正确: 使用英文半角冒号
        return "及格"
    else:            # 错误: 切换回中文输完“否则”后直接打了中文全角冒号
        return "不及格"
运行输出:
  File "check.py", line 4
    else:
        ^
SyntaxError: invalid character ':' (U+FF1A)
学生在编写上述代码时,由于刚刚输入了中文变量名“成绩”,注意力处于输入法开启状态,紧接着敲击冒号,极易直接产生全角错误。在数十人的大班教学中,教师往往需要逐个座位排查全角字符,极度消耗课堂辅导资源。
五、从零到一的阶梯式教学进阶方案
既然中文变量名利弊并存,最佳的教学实践就不应是一刀切的“全面提倡”或“彻底封杀”,而应实施按学时渐进过渡的阶梯式教学法。
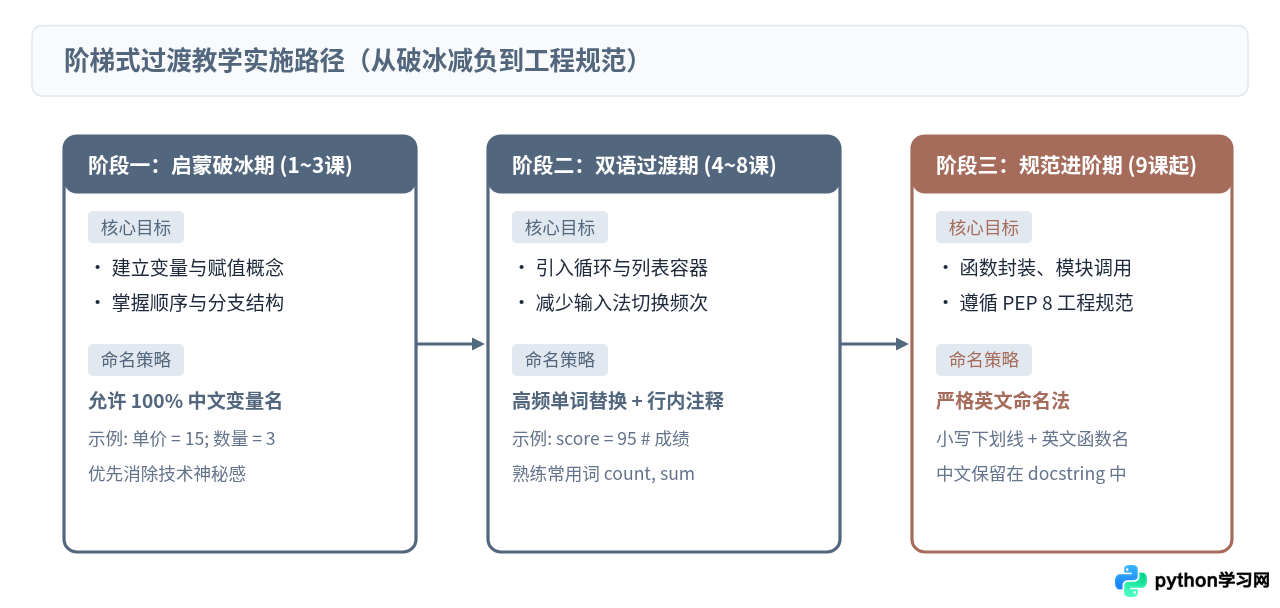
步骤 1:前 1~3 次课 —— 允许中文变量名(破冰减负)
在学生第一次接触 print()、变量赋值、简单的 if/else 条件判断时,教学的核心矛盾是“建立计算思维”而非“背单词”。
在此阶段,教师不仅无需纠正中文变量名,反而可以主动鼓励使用中文。让学生将自己的名字、爱好、零花钱写进代码,以极高的新奇感和成就感跨越最开始的畏难心理。
步骤 2:第 4~8 次课 —— 双语过渡(注入高频词与行内注释)
随着循环结构(for / while)和列表容器(list)的引入,代码行数增多,输入法频繁切换带来的全角标点报错开始大幅增加。
此时教师顺水推舟,指出全半角切换的问题,并适时引入编程领域最核心的 20~30 个高频基础单词(如 score、price、count、sum、item、result)。
# 过渡期推荐代码写法:英文变量名搭配中文清晰注释
count = 0        # 计数器
total_sum = 0    # 累加总和

for score in [85, 92, 78]:
    total_sum += score
    count += 1

average = total_sum / count  # 计算平均分
print(f"平均分是: {average:.2f}")
这种写法保持了键盘始终处于半角英文状态,杜绝了全角标点,同时中文注释依然起到了即时理解的作用。
步骤 3:第 9 次课之后 —— 严格遵循 PEP 8 规范(工程化接轨)
当课程进入函数自定义(def)、类与对象(class)以及调用第三方库时,全面执行 PEP 8 命名标准:
- 变量与函数名:使用小写字母加下划线(
calculate_bmi); - 类名:使用驼峰式大小写(
UserProfile); - 中文的使用场景严格收缩至:代码注释(Comments)、函数说明文档(Docstrings)和终端打印输出(UI/Prompt 文本)。
六、不同教学场景的选用决策依据
教学对象的年龄结构、课程目标和软硬件环境,决定了是否应该开放中文变量名。教师或课程设计者可以参考以下决策路径:
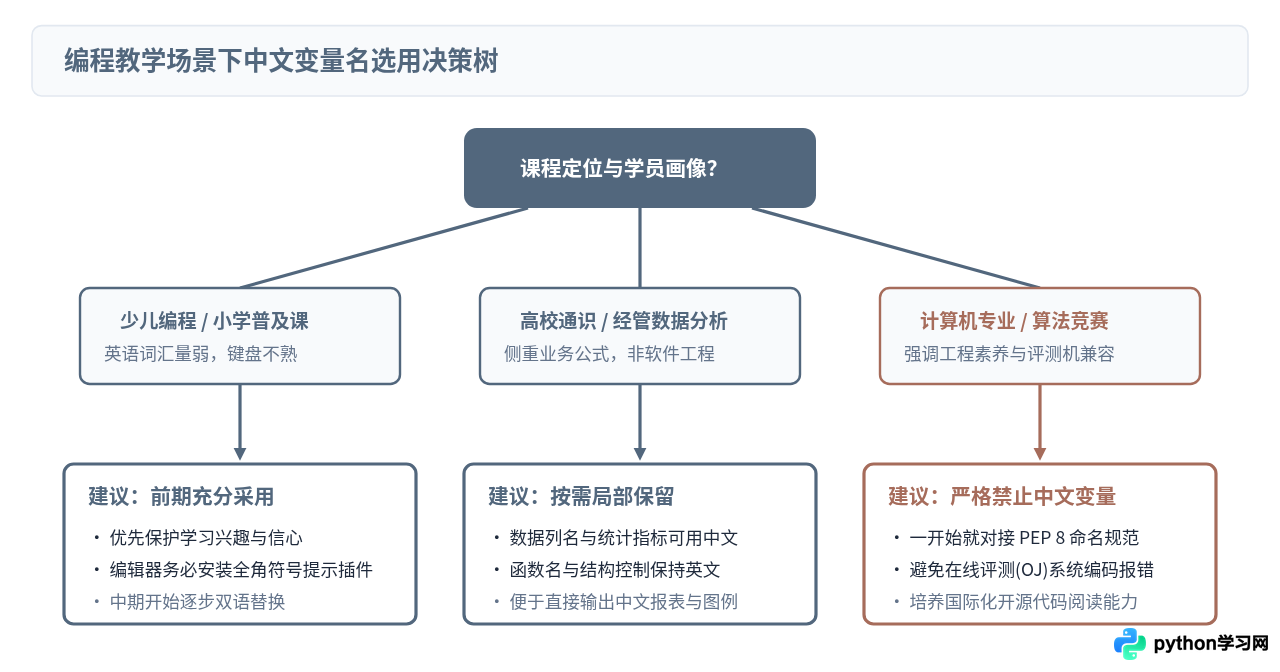
| 教学场景 | 推荐策略 | 配套预防措施 |
|---|---|---|
| 小学少儿编程 (8~12岁) | 允许并鼓励使用中文变量名 | 在编辑器中开启高亮显示全角字符功能,提前讲解全角符号错误排查方法。 |
| 高校非计算机通识 (文科/经管) | 公式与数据字段允许中文,控制流使用英文 | 配合 Jupyter Notebook 使用,中文字符在表格数据列名中天然具备可视化优势。 |
| 青少年信息学奥赛 (CSP-J/S) | 严禁使用中文变量名 | 竞赛评测机系统多为 Linux 原生终端环境,中文变量名极易在自动化评测中引发非预期的编译/编码错误。 |
| 成人转行或计算机专业基础课 | 第一节课即使用英文命名 | 提供附带常见词汇对照表的学习卡片,从第一天起养成严谨的工程编码规范与大小写敏感意识。 |
七、总结
Python 3 原生支持 Unicode 标识符,是编程语言包容性与全球化发展的一大进步。在编程教学的特定阶段,中文变量名就像是自行车后轮两侧的“辅助轮”:它能在学生最容易摔跤、最容易对平衡产生恐惧的起步阶段,提供稳固的心理安全感,让初学者把注意力全部放在体会“前进”的快乐上。
但教育者必须清楚,辅助轮的终极使命是“被拆卸”。当学生已经理解了程序如何运转、能够顺畅构建基础算法时,适时、有步骤地引导其过渡到规范的英文标识符与 PEP 8 规范,才能让他们真正具备在更广阔的开源生态与软件工程领域中自由骑行的能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















