


单片机运行Python报MemoryError怎么办?内存优化与排查方法
针对单片机运行MicroPython或CircuitPython时出现的MemoryError报错,全面解析诱发原因、快速排查定位流程、代码级优化与固件级冻结等实用解决手段。
在ESP32、ESP8266、RP2040或STM32等单片机上运行MicroPython时,最常遇到的阻碍之一就是 MemoryError。单片机的SRAM通常仅有数十KB到数百KB,除去底层系统与解释器运行开销后,留给Python堆(Heap)的空间往往非常有限。解决这一报错的核心路径在于:先定位报错是发生在模块导入期还是业务运行期,区分纯粹的物理堆耗尽与内存碎片化,再通过主动垃圾回收、预分配缓冲、生成器流式处理以及固件冻结等针对性手段予以化解。
一、认识诱因:单片机Python内存为何会耗尽
单片机运行Python不同于计算机。电脑端有虚拟内存和充裕的物理内存支持,而单片机使用的是微型垃圾收集堆。当Python程序请求分配一块新的内存空间(如创建字符串、列表或实例化类),但堆空间无法满足该请求时,MicroPython解释器便会直接抛出 MemoryError。
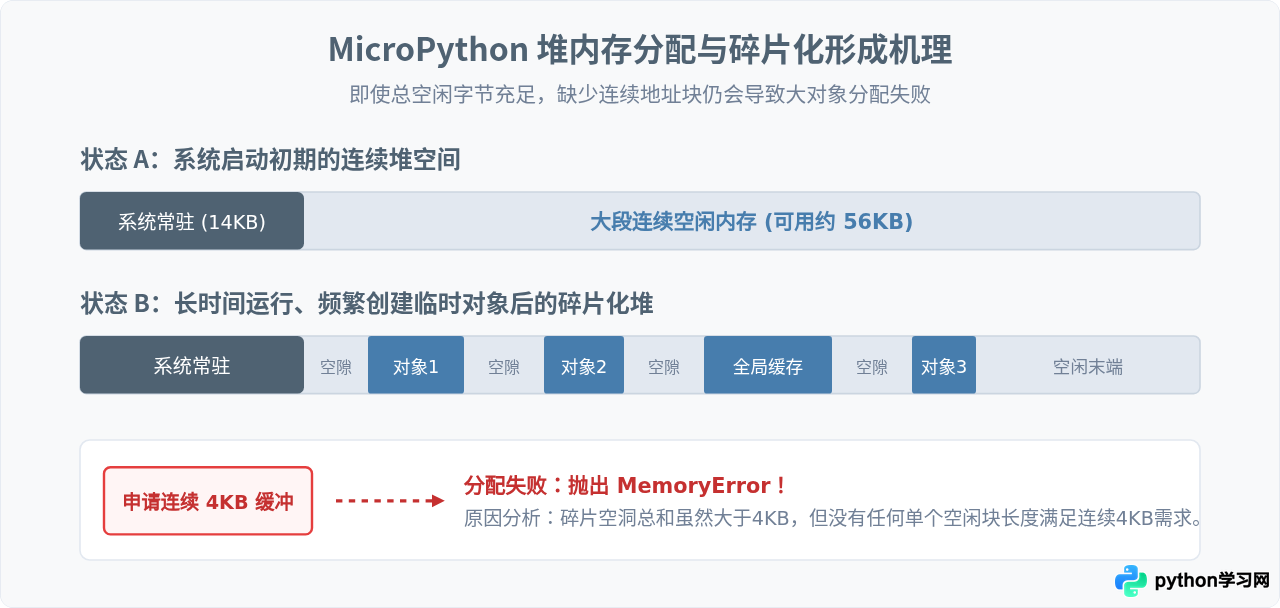
值得注意的是,单片机上的 MemoryError 往往不等于“总空闲内存为零”。常见的原因分为以下两类:
- 真实堆耗尽:程序持有了过多常驻对象(如庞大的字典、未释放的历史传感器数据列表),可用内存确实降到了临界点以下。
- 堆内存碎片化(Heap Fragmentation):这是最隐蔽也是最常见的诱因。程序频繁创建并丢弃大小不一的短生命周期对象,使连续的空闲内存被切割成散落的狭小空洞。此时,即使系统总空闲内存还有几十KB,但当需要分配一块较大的连续空间(例如读取传感器数据帧所需的2KB缓冲区)时,依然会因找不到足够长的连续内存块而抛出
MemoryError。
二、快速排查:三步定位内存瓶颈
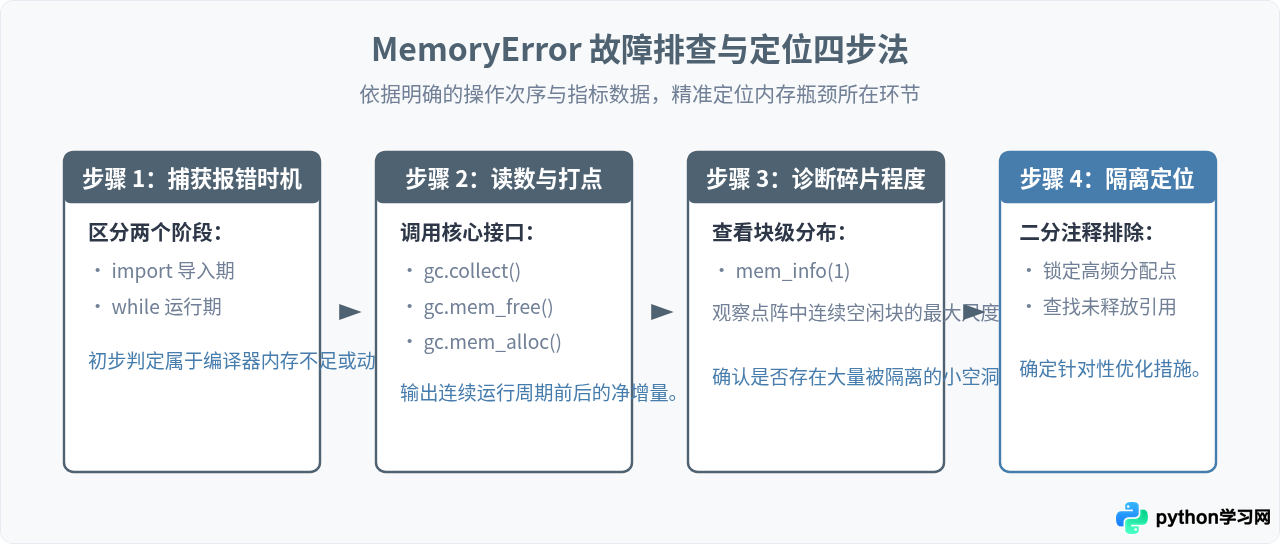
遇到报错时,盲目精简代码往往收效甚微。按照以下三个步骤,可以快速锁定内存问题的源头:
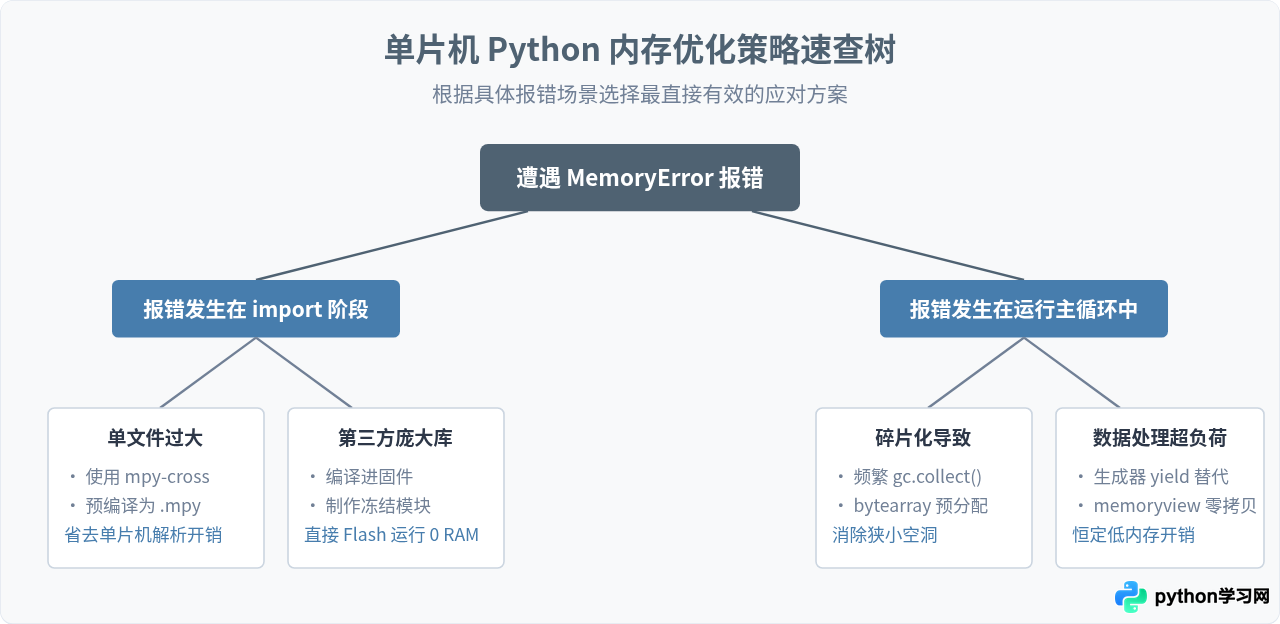
1. 确认报错发生的阶段
观察控制台的 Traceback 报错栈:
- 导入阶段报错:如果代码刚启动,在执行
import xxx时就报错,说明在将.py文本编译为字节码或构建模块抽象语法树的过程中消耗了过多内存。 - 运行循环中报错:如果设备正常运行一段时间后,在特定的函数调用或数据通信处崩溃,通常属于动态内存泄漏或内存碎片累积。
2. 使用内置接口监测内存变化
MicroPython 内置了 gc 模块与 micropython 模块,可以用于实时输出当前内存状态:
import gc
import micropython

# 执行垃圾回收
gc.collect()

# 查看内存分配与空闲字节数
alloc_bytes = gc.mem_alloc()
free_bytes = gc.mem_free()
print("已分配:", alloc_bytes, "字节,剩余空闲:", free_bytes, "字节")

# 打印详细的堆内存块布局分布
micropython.mem_info(1)
调用 micropython.mem_info(1) 会在终端打印出一串由字符表示的内存布局图(其中 . 表示空闲块,字符字母表示占用块)。如果看到大量散乱的 . 穿插在占用块之间,即证明碎片化非常严重。
3. 隔离法与单步注入检测
在怀疑出现内存泄漏的主循环或函数前后,分别插入内存打印代码。通过计算 gc.mem_free() 的差值,如果某一操作执行完毕并强制 gc.collect() 后,可用内存持续递减且未恢复,即可确认该代码块内部保留了未被解绑的全局引用或容器缓存。
三、代码层优化:降低动态内存开销的四大技巧
在明确了内存瓶颈的具体表现后,通过修改代码实现方式,通常可以在不改变硬件的前提下释放数倍的可用堆空间。
1. 预分配固定缓冲区,杜绝动态字符串与字节拼接
在 Python 中,字符串和 bytes 属于不可变对象。每一次使用 data = data + chunk 拼接数据,解释器都会在堆中申请一块容纳新长度的连续空间,并将旧数据复制过去,旧空间则变为等待垃圾回收的孤立块。高频进行拼接是引发严重碎片的根源。
推荐做法:使用可变的 bytearray 配合 memoryview 进行预分配和就地读写:
# 优化前:频繁拼接,产生大量临时对象
received = b""
for _ in range(50):
    chunk = uart.read(10)
    if chunk:
        received += chunk  # 每次都分配新内存!

# 优化后:预分配连续缓冲区,零动态分配
buf = bytearray(500)
mv = memoryview(buf)
ptr = 0
for _ in range(50):
    n = uart.readinto(mv[ptr:ptr+10])
    if n:
        ptr += n
2. 主动介入垃圾回收机制
MicroPython 的自动垃圾回收通常只在尝试分配新内存且空间不足时才会触发。这种被动回收会导致堆在大部分时间内保持拥挤,从而加剧碎片化。
推荐做法:在关键业务循环的起点或较重的数据处理函数退出后,主动调用 gc.collect():
import gc

def process_batch():
    gc.collect()  # 处理前主动回收,腾出规整连续空间
    # 执行业务逻辑...
    gc.collect()  # 局部对象丢弃后立刻回收
3. 使用生成器(Generator)替代大型列表
在单片机上处理传感器序列或文件行时,避免使用一次性返回整个列表的列表推导式:
# 优化前:一次性将1000个数据载入内存,占用大段堆空间
data = [read_sensor(i) for i in range(1000)]

# 优化后:使用生成器表达式逐项计算,内存开销恒定为单个对象
def sensor_stream():
    for i in range(1000):
        yield read_sensor(i)

for val in sensor_stream():
    handle(val)
4. 使用 micropython.const() 优化常量
普通全局变量或类属性在运行时作为字典键值存储在 RAM 堆中。将常量定义为 micropython.const() 后,编译器会直接将数值作为字面量编译到字节码中,完全不占用堆内存:
from micropython import const

# 声明编译期常量
REG_CONTROL = const(0x01)
BUFFER_SIZE = const(128)
四、工程层手段:从编译与固件突破硬件物理上限
当代码层优化已达到极限,但项目依赖的第三方驱动库(如大型屏幕驱动、MQTT客户端)体积庞大,在 import 阶段就会耗尽内存时,必须借助工程化手段解决:
1. 使用 mpy-cross 编译为 .mpy 字节码
在单片机直接执行 .py 文件时,MicroPython 解释器必须在单片机内存中完成文本解析、词法分析并生成语法树。这一过程需要消耗源码数倍的临时堆内存。
操作步骤:在电脑端使用官方编译工具 mpy-cross,预先将源码编译为二进制字节码 .mpy 文件,再上传到单片机文件系统:
# 在电脑主机终端中执行
mpy-cross sensor_driver.py -o sensor_driver.mpy
单片机导入 .mpy 时会直接读取已编译指令,完全跳过了源码解析阶段的内存消耗,可节约 30% 到 60% 的导入期峰值内存。
2. 将模块冻结到固件中(Frozen Modules)
这是 MicroPython 最彻底的终极内存解决方案。单片机的 Flash 存储空间(通常有 4MB 到 16MB)远大于 SRAM(几十到几百KB)。
普通 .py 或 .mpy 文件保存在文件系统中,运行时仍需被读取加载到 RAM 堆中执行。而通过将 Python 脚本放置在 MicroPython 源码树的 ports/<平台>/modules 目录下并重新编译固件,这些脚本会被转化为“冻结字节码”。运行时解释器直接在 Flash 中原位读取并执行指令(XIP,Execute In Place),几乎不占用任何 RAM 堆内存,从而将宝贵的 SRAM 全部留给动态业务数据。
五、确认与验证:如何判断内存问题已经彻底解决
对代码完成针对性调整后,不能仅以单次运行不崩溃作为依据,需要通过长时间压力与指标趋势进行验证:
- 长期稳态测试:在单片机的主循环中加入内存采样日志。让设备连续运行 1 到 2 小时,观察每次循环执行
gc.collect()后的gc.mem_free()数值。如果可用字节数在波动后稳定在一个固定水平(如保持在 32KB 上下浮动),说明内存已经收敛,无泄漏与失控碎片;若数值呈现持续下降趋势,则表明仍有对象被未清除的全局列表或闭包隐式引用。 - 极端数据边界验证:向单片机注入可能发生的最大网络包或最长传感器数据流,确认在峰值吞吐状态下依然留有安全裕量(通常建议常态下保留至少 8KB 到 15KB 的空闲堆)。
排查要点小结:面对单片机的 MemoryError,不必急于更换更大 RAM 的硬件。首先看报错栈区分导入期还是运行期;导入期优先借助 mpy-cross 预编译或固件冻结;运行期则果断消除字符串拼接、利用 bytearray 配合 memoryview 预分配固定缓冲,并在循环中定期主动 gc.collect()。规范的资源管理习惯足以让 Python 在资源受限的微控制器中长久稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















