


Python类属性在继承中的覆盖与扩展技巧
深入解析Python类属性在面向对象继承中的覆盖机制与扩展技巧,剖析类属性查找链、可变对象共享陷阱,并详解利用字典解包与__init_subclass__进行自动化属性扩展的最佳实践。
在Python面向对象编程中,类属性是由类对象持有并在所有实例之间共享的数据。当引入类的继承体系时,子类对类属性的处理主要分为两类需求:覆盖(Override)即用子类专属的定义替代基类的初始设定;扩展(Extend)即在保留基类既有配置的基础上追加新项。处理不当时,往往会导致“实例属性意外遮蔽类属性”或“子类操作意外污染基类全局状态”等隐蔽Bug。本文将系统梳理类属性的底层查找路径,剖析可变属性的共享陷阱,并给出涵盖标量重写、集合浅拷贝合并以及基于 __init_subclass__ 自动扩展的标准解法。
一、类属性的本质与继承链查找机制
要熟练控制类属性的继承行为,首先必须明确类属性在内存中的存储位置及解析顺序。在Python中,类自身也是一个独立的运行时对象。定义在类体顶层(而非 __init__ 等实例方法内)的变量,会被存放在该类对象的 __dict__ 字典中。
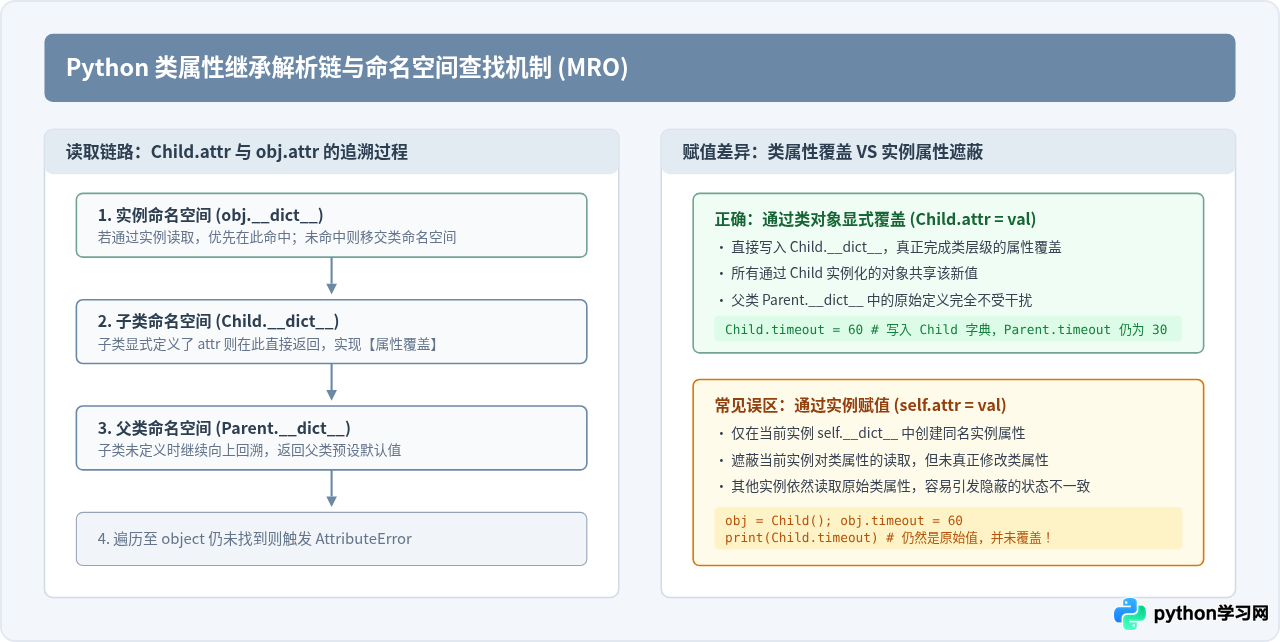
当通过类名或实例访问一个属性(例如 obj.attr 或 Child.attr)时,Python解释器会按照确定性的解析顺序逐层寻找:
- 实例命名空间查找:若是通过实例
obj.attr访问,先检查obj.__dict__是否存在该属性名。若存在直接返回,若不存在则进入类层级。 - 子类命名空间查找:进入当前实例所属的类(或通过类名直接访问的类),检查其
__dict__。 - MRO(方法解析顺序)向上追溯:若子类中未定义,则严格沿着继承链(即当前类的
__mro__顺序)依次向各个父类查找,直到找到第一个同名属性或到达根类object。
二、类属性的覆盖(Override)技巧
所谓覆盖,是指子类明确需要一个不同于父类的全新属性值。这在定义子类专属配置(如不同的超时时间、不同日志标签或不同的数据库表名)时非常常见。
1. 正确的类级覆盖写法
最直接、清晰的方式是在子类的定义体内,直接对同名变量重新赋值。当子类声明被解释执行时,Python 会将该键值对写入子类命名空间 Child.__dict__。
class BaseWorker:
    timeout: int = 30
    worker_type: str = "generic"

class FastWorker(BaseWorker):
    # 直接在类体显式覆盖父类属性
    timeout: int = 5
    worker_type: str = "fast"

# 验证覆盖效果
print(BaseWorker.timeout)  # 30 (基类不受影响)
print(FastWorker.timeout)  # 5  (子类生效)

w1 = FastWorker()
print(w1.timeout) # 5 (通过实例访问命中子类类属性)如果在子类的方法内部使用 self.timeout = 5,这并不会修改 FastWorker.timeout,而仅仅是在 w1 这个具体对象的字典里加了一个 timeout 键。当其他代码直接通过 FastWorker.timeout 访问类属性时,读取到的依然是未覆盖的状态。如果要以动态方式覆盖类属性,务必使用 type(self).timeout = 5 或显式使用类名 FastWorker.timeout = 5。
三、类属性的扩展(Extend)技巧与可变对象共享陷阱
与不可变的标量(如整数、字符串)不同,实际项目中类属性常常是可变集合对象(如 list、dict 或 set),例如权限列表、路由映射表或字段验证规则。此时若操作不当,极易落入引用共享陷阱。
1. 典型反例:原地修改导致基类被意外污染
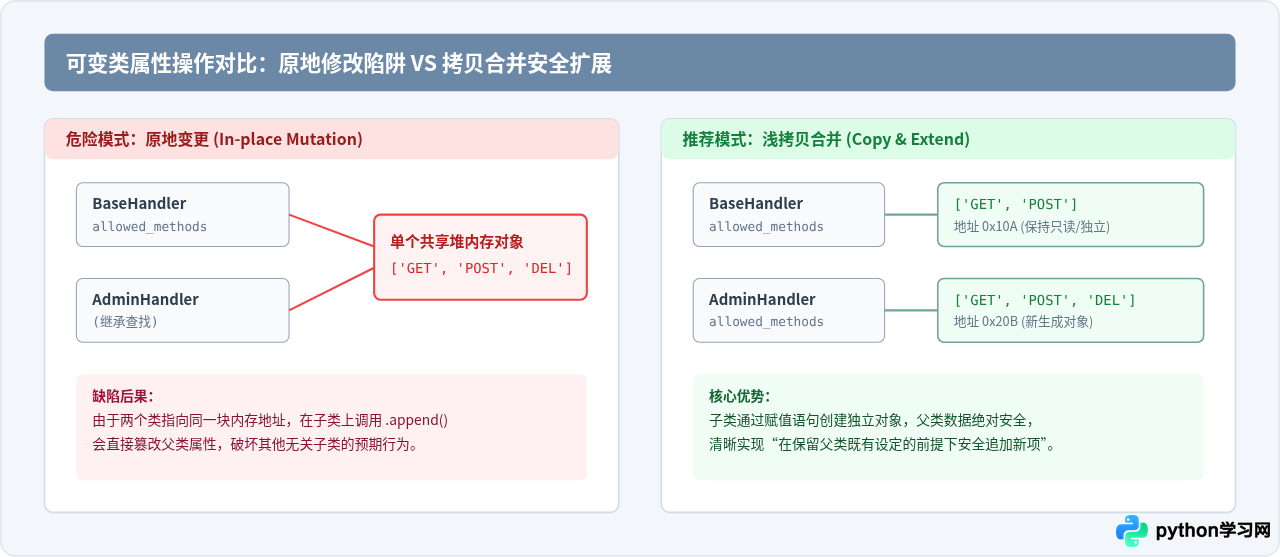
子类如果没有重新给属性赋值,而是直接调用列表的 .append() 或字典的 .update(),修改的其实是父类中那份唯一的内存对象。
class BaseHandler:
    allowed_methods = ["GET", "POST"]

class AdminHandler(BaseHandler):
    pass

# 危险操作:试图在子类上扩展方法
AdminHandler.allowed_methods.append("DELETE")

# 检查结果:
print("AdminHandler:", AdminHandler.allowed_methods)  # ['GET', 'POST', 'DELETE']
print("BaseHandler :", BaseHandler.allowed_methods) # ['GET', 'POST', 'DELETE'] —— 基类被污染!出现该问题的根本原因在于:AdminHandler.allowed_methods 在查找时顺着 MRO 回溯到了 BaseHandler.__dict__['allowed_methods']。由于没有执行“赋值”动作,解释器并不会为子类创建新的属性,后续的 append 是对同一个列表对象的原地修改。
2. 安全的显式扩展方式
处理列表或字典类型时,标准做法是通过不可变运算、浅拷贝或解包操作生成全新的容器对象,并在子类中完成赋值绑定:
class BaseConfig:
    # 列表:序列类型
    plugins = ["logger", "metrics"]
    # 字典:映射类型
    headers = {"Content-Type": "application/json", "Accept": "*/*"}

class CustomConfig(BaseConfig):
    # 技巧1:列表使用加法运算拼接,生成新列表对象
    plugins = BaseConfig.plugins + ["tracer", "cache"]

    # 技巧2:字典使用解包语法合并父类配置与自定义项
    headers = {
        **BaseConfig.headers,
        "X-Custom-Auth": "Bearer token123",
        "Accept": "application/json"  # 同时支持局部键值覆盖
    }

# 验证安全性
print("BaseConfig plugins  :", BaseConfig.plugins)
# 输出: ['logger', 'metrics'] —— 完全不受影响

print("CustomConfig plugins:", CustomConfig.plugins)
# 输出: ['logger', 'metrics', 'tracer', 'cache'] —— 成功扩展
四、高级自动化扩展:利用 __init_subclass__ 自动继承与扩展
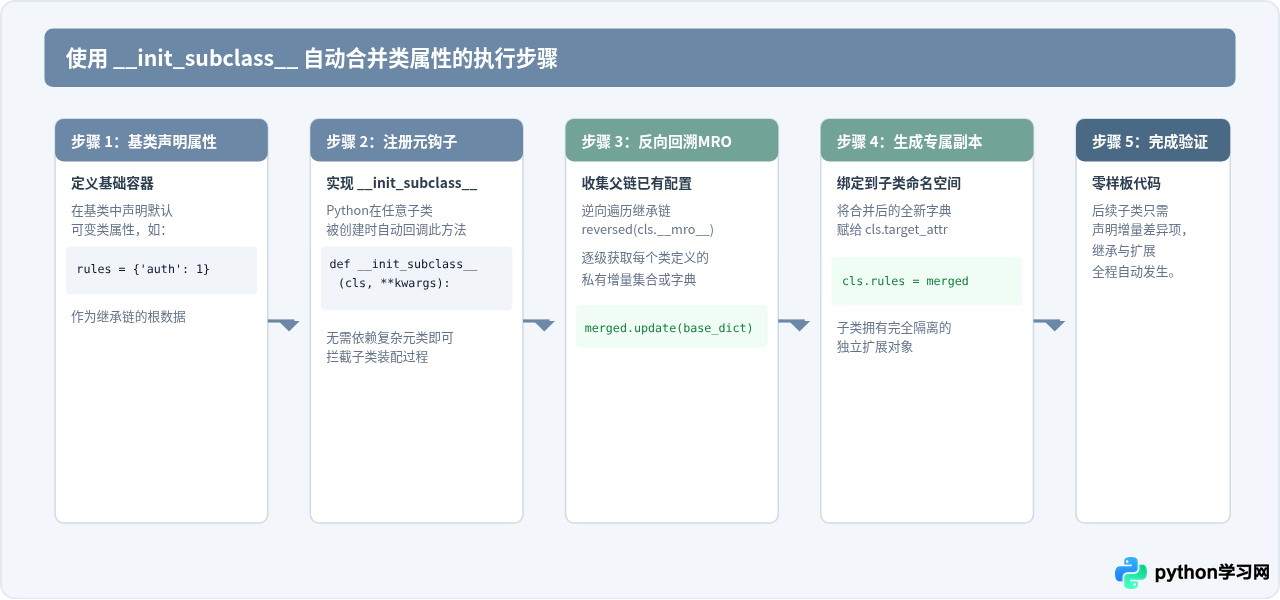
当一个框架或库需要被多次多层继承时,要求每个子类都显式书写 **Parent.config 会产生大量机械重复代码,并且一旦有子类遗漏就会引发静默异常。自 Python 3.6 起,标准推荐使用 __init_subclass__ 钩子方法,在子类被解释器创建时自动收集并合并整条继承链上的属性。
1. 自动化扩展的实现步骤
以下流程图展示了从定义基类钩子到子类声明时的自动化属性收集与合并过程:
2. 完整代码示例
下面是一个构建插件处理管道的生产级范例。每个子类只需要声明自己要追加或微调的 extra_rules,基类的钩子会自动将其与整条上游继承链的规则合并:
class RulePipeline:
    # 基类预置的基础规则
    rules: dict = {
        "sanitize_input": True,
        "max_size_mb": 10
    }
    extra_rules: dict = {}

    def __init_subclass__(cls, **kwargs):
        super().__init_subclass__(**kwargs)

        # 1. 创建全新的字典容器,防止向父类渗透
        merged_rules = {}

        # 2. 依照 MRO 逆序向上回溯,确保上层基础规则先加载,下层子类规则后覆盖
        for base in reversed(cls.__mro__):
            # 获取当前基类自身声明的规则(若有)
            if hasattr(base, "rules") and isinstance(base.rules, dict):
                merged_rules.update(base.rules)
            if hasattr(base, "extra_rules") and isinstance(base.extra_rules, dict):
                merged_rules.update(base.extra_rules)

        # 3. 将合并后的新字典明确赋给子类命名空间
        cls.rules = merged_rules

# 子类 1:只需声明自己的增量配置
class ImagePipeline(RulePipeline):
    extra_rules = {
        "max_size_mb": 50,           # 覆盖父类既有值
        "supported_formats": ["png", "jpg"]  # 扩展新字段
    }

# 子类 2:在子类 1 基础上进一步派生
class HighResImagePipeline(ImagePipeline):
    extra_rules = {
        "max_size_mb": 200,          # 进一步放宽限制
        "color_profile": "sRGB"      # 再次追加特性
    }

# 验证各层级的独立性与继承结果
print("Base rules   :", RulePipeline.rules)
# {'sanitize_input': True, 'max_size_mb': 10}

print("Image rules  :", ImagePipeline.rules)
# {'sanitize_input': True, 'max_size_mb': 50, 'supported_formats': ['png', 'jpg']}

print("HighRes rules:", HighResImagePipeline.rules)
# {'sanitize_input': True, 'max_size_mb': 200, 'supported_formats': ['png', 'jpg'], 'color_profile': 'sRGB'}
通过这种方式,继承体系获得了两项关键保证:一是子类永远拥有完整、立即可用的合并配置;二是任意层级的修改都在其独立命名空间内完成,上层父类属性始终纯净。
五、类属性覆盖与扩展的综合决策总结
面对不同的业务数据结构与继承层级,开发者应选用最为恰当的覆盖或扩展策略。下方的全景总结图概括了不同场景下的推荐选型路径:
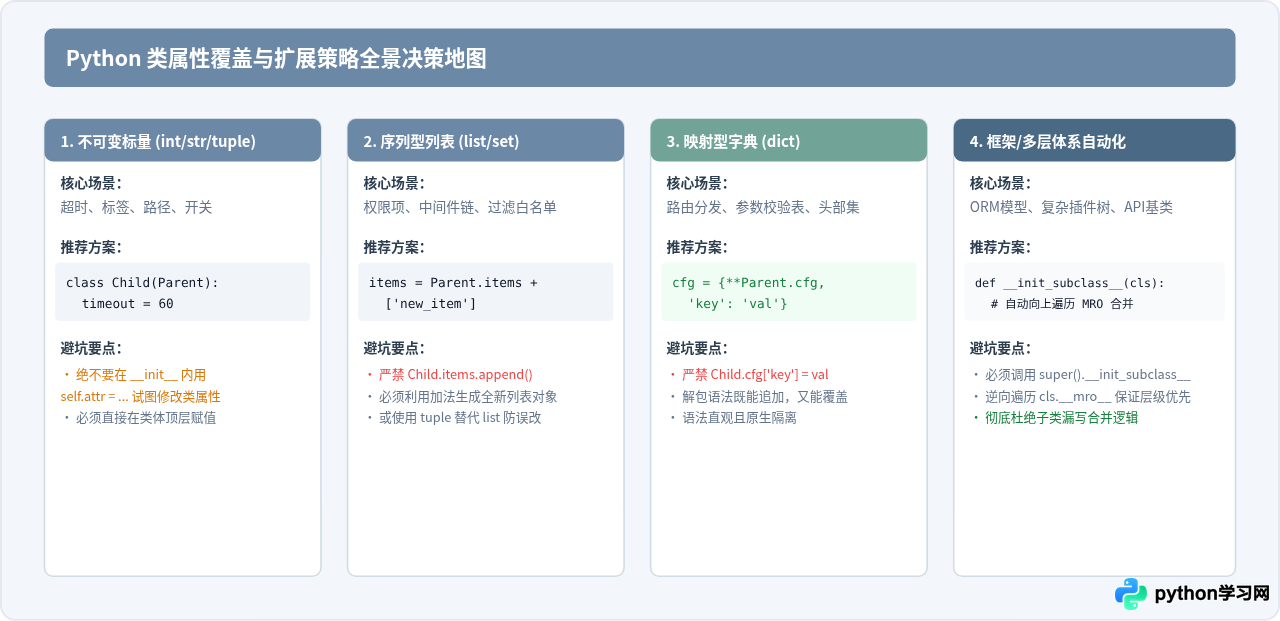
为了便于速查与团队代码审查,常见处理手段及其技术特征对比如下表所示:
| 处理类型 | 典型语法 | 父类安全性 | 适用数据类型 | 代码侵入度 |
|---|---|---|---|---|
| 直接赋值覆盖 | class Sub(Base): attr = val |
绝对安全(写入子类字典) | 标量(数字、字符串、元组) | 极低,清晰直观 |
| 解包/加法扩展 | items = Base.items + [...]cfg = {**Base.cfg, ...} |
绝对安全(生成全新对象) | 列表 (list)、集合 (set)、字典 (dict) | 低,子类需显式引用父类名 |
| 原地追加(反例) | Sub.items.append(x)Sub.cfg['k'] = v |
极度危险(父类被污染) | 所有可变类型 | 反模式,禁止在生产中使用 |
| 元钩子自动合并 | __init_subclass__ 逆序解析 MRO 并赋新值 |
绝对安全(自动化工厂模式) | 需要层级累加的复杂字典或列表 | 基类集中处理,子类零额外样板代码 |
六、注意事项与最佳实践清单
在日常开发与架构设计中,保持以下几条纪律可以从根本上杜绝类属性继承带来的状态污染:
- 优先考虑不可变类型:若类属性在生命周期中无需动态增减,优先使用
tuple替代list,使用frozenset替代set。这能在语法层面上防止任何人误调.append()或.add()。 - 谨记“赋值创建,查找回溯”:只有在赋值时左侧为
ClassName.attr = ...时,才是真正的类属性覆盖。通过self.attr = ...赋值永远只会创建实例属性。 - 深浅拷贝的边界:如果类属性字典中嵌套了更深层的列表或子字典(如多层配置项),简单的浅拷贝
{**Base.cfg}无法保护第二层数据。对于多层嵌套配置,应在扩展时使用copy.deepcopy()进行完全深拷贝,或者重构为扁平化的属性结构。 - 善用类方法与描述符:若希望类属性的读取带有动态计算逻辑或实现只读保护,可配合
@classmethod或编写自定义类级别的描述符,对属性的赋值和修改行为提供强约束拦截。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















