


JavaScript与Python之间怎么传递复杂JSON数据
深入解析JavaScript与Python之间传递复杂JSON数据的全流程,涵盖通信协议选择、特殊类型转换、精度保护、自定义序列化与反序列化以及生产级避坑指南。
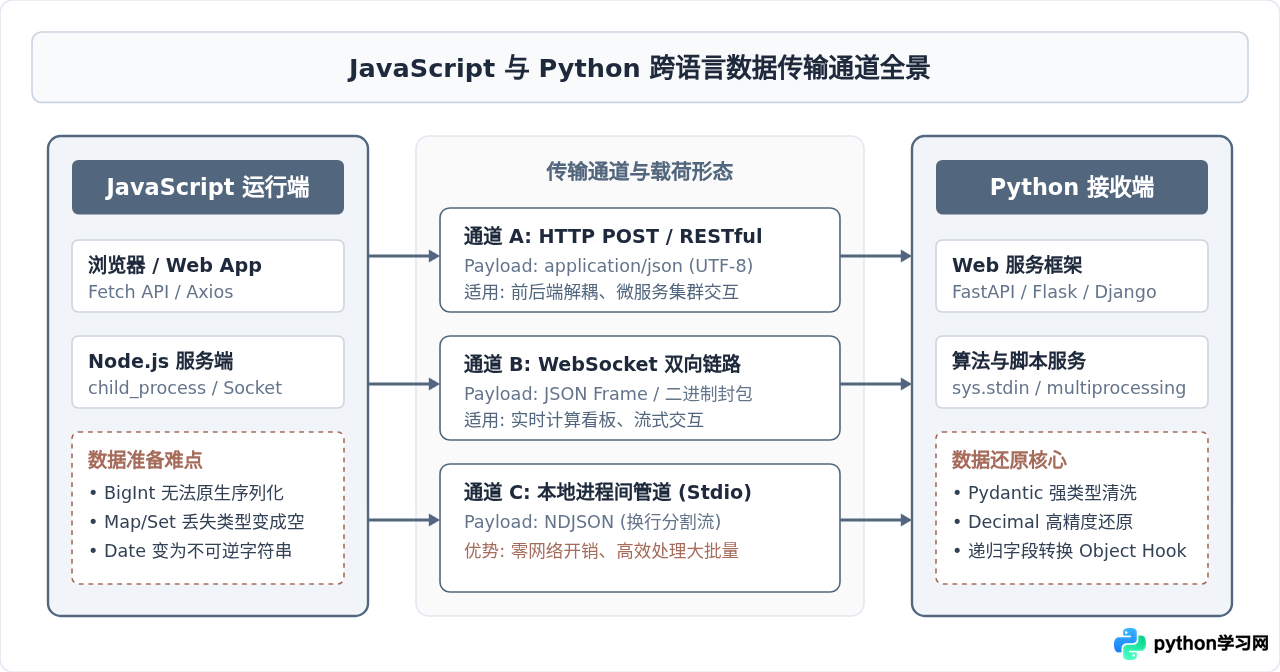
在现代全栈开发与跨语言系统中,JavaScript 与 Python 之间的协作非常频繁。无论是前端 Web 页面向 Python 后端(如 FastAPI、Flask)提交分析请求,还是 Node.js 主服务拉起 Python 离线脚本处理算法,JSON 都是事实上的数据交换通用语。然而,传递“简单”的扁平字典或纯字符串数组非常直观,一旦数据结构变得“复杂”——包含数十层深层嵌套、高精度 64 位大整数、时间日期对象、集合(Set)、字节二进制数据或特殊浮点值(如 NaN/Infinity)时,开发者就会频繁遭遇数据被静默吞没、精度截断或序列化报错的困境。
实现两端稳健通信的核心解决路径分为三步:一是根据运行拓扑选择合理的物理或网络传输通道;二是统一两端对于非标准 JSON 原生类型的折叠规约,并显式实现自定义序列化与反序列化逻辑;三是引入强类型契约校验机制,杜绝脏数据侵蚀下游逻辑。本文将从通信机制、类型断层、核心代码实现及高可靠架构逐一展开。
一、为什么“复杂”JSON 传递容易在隐蔽处踩坑?
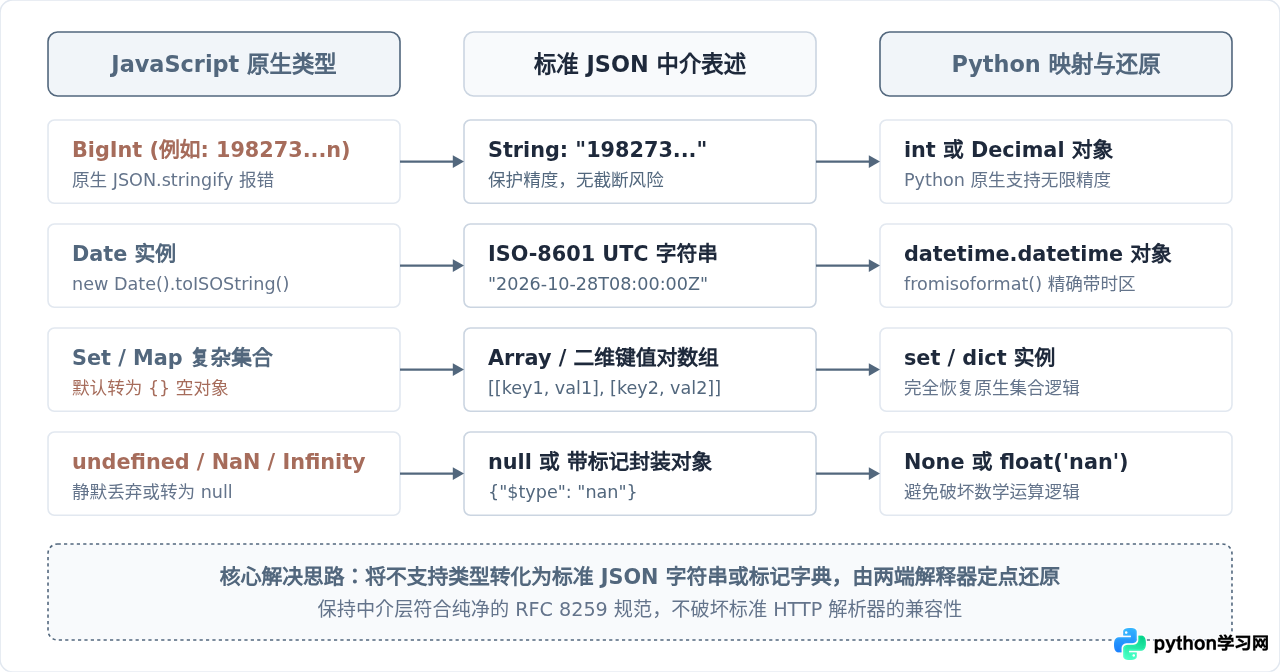
很多初学者会认为,既然两端都内置了 JSON 库(JavaScript 的 JSON.stringify() 和 Python 的 json.loads()),通信就只是把对象转成字符串再解析回来这么简单。但在实际工程中,真正带来系统崩溃和脏数据的,往往不是常规的字符串或布尔值,而是语言特有类型与 JSON 规范之间的“断层”。
根据 RFC 8259 规范,标准 JSON 只支持六种核心数据形态:对象(Object)、数组(Array)、字符串(String)、数字(Number)、布尔值(true/false)以及 null。这意味着现实业务中的复杂类型在进入序列化管道时会被动变形:
- 64 位大整数精度丢失: JavaScript 的数值基于 IEEE 754 双精度浮点数标准,安全整数上限为
Number.MAX_SAFE_INTEGER(即 253 - 1,9007199254740991)。一旦涉及数据库分布式雪花算法 ID(如 64 位无符号长整型),JavaScript 会使用BigInt承载,但调用JSON.stringify()时会直接抛出TypeError: Do not know how to serialize a BigInt异常。 - 时间戳与日期歧义: JavaScript 的
Date对象在序列化时会被转为 ISO 8601 字符串(如"2026-10-28T08:00:00.000Z"),而在 Python 解析后它仅仅是一个纯字符串,如果不进行显式反解析,它将无法直接参与 Python 的datetime计算。 - 集合与键名约束: JavaScript 的
Map允许任意对象或数值作为键,但 JSON 对象规范要求“所有键必须是双引号包裹的字符串”。普通的JSON.stringify(new Map())甚至只会输出空对象{}。同样,Set也会直接被折叠为空对象。 - 特殊数值的静默抹除: JavaScript 中的
undefined、函数引用、Symbol 在序列化时会被静默忽略或转换为null;NaN和Infinity则会被直接转换成null,导致 Python 端接收后丢失了原本的数值异常语义。
二、核心操作步骤:实现全链路生命周期
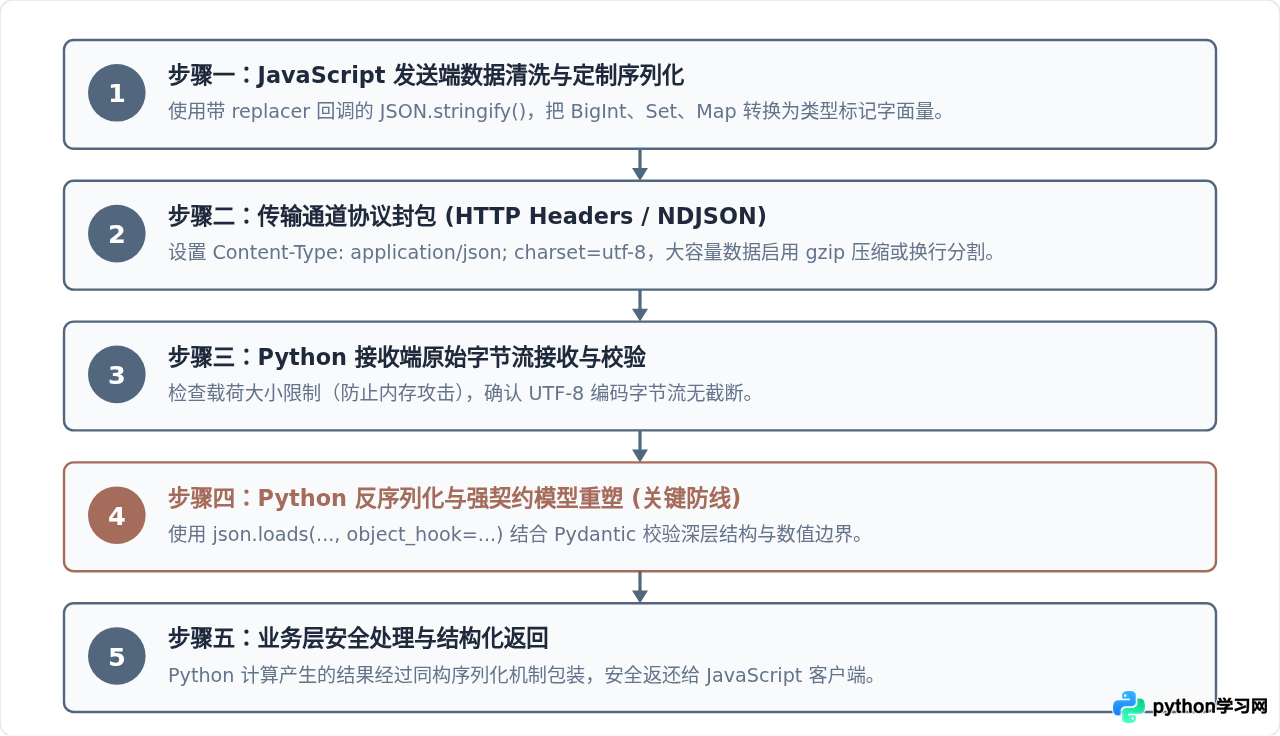
为了在 JavaScript 与 Python 之间无损流转深层嵌套及复杂数据,完整的处理生命周期必须覆盖五个阶段:客户端预处理(Replacer 注入)、网络或管道安全封装、服务端解码校验、反序列化(Object Hook 还原)以及业务计算后响应。
步骤 1:JavaScript 端的序列化定制
JSON.stringify() 接受第二个参数作为 replacer 处理函数。利用这一特性,我们可以拦截无法序列化的对象,并显式打上类型标签:
// client.js - JavaScript 发送端
function safeStringify(data) {
  return JSON.stringify(data, (key, value) => {
    // 1. 处理 64 位大整数
    if (typeof value === 'bigint') {
      return { $type: 'BigInt', value: value.toString() };
    }
    // 2. 处理 ES6 Set 集合
    if (value instanceof Set) {
      return { $type: 'Set', value: Array.from(value) };
    }
    // 3. 处理 ES6 Map 键值对集合
    if (value instanceof Map) {
      return { $type: 'Map', value: Array.from(value.entries()) };
    }
    // 4. 处理非法浮点数语义
    if (typeof value === 'number' && Number.isNaN(value)) {
      return { $type: 'NaN' };
    }
    return value;
  });
}

// 模拟构建一个复杂嵌套数据
const complexPayload = {
  taskId: "T-98214",
  distributedId: 9223372036854775807n, // 64位无符号上限大整数
  timestamp: new Date(),
  userTags: new Set(["admin", "ai_cluster", "beta"]),
  metricsMap: new Map([
    ["cpu_usage", 82.5],
    ["memory_ratio", 0.67]
  ]),
  nestedDetails: {
    level1: {
      level2: {
        rawScore: NaN,
        status: "active"
      }
    }
  }
};

const payloadString = safeStringify(complexPayload);
// 随后通过 fetch API 发出 POST 请求
步骤 2:Python 端的精准反序列化
Python 标准库的 json.loads() 提供了 object_hook 机制。当解析器每解析完成一个 JSON 对象节点(字典)时,就会先将该字典传给 object_hook,我们可以在此完成类型的逆向映射与自动实例化:
# server.py - Python 接收端
import json
from datetime import datetime
import math

def custom_decoder(dct):
    """
    解码递归过程中的特殊类型标记对象
    """
    if "$type" in dct:
        type_flag = dct["$type"]
        if type_flag == "BigInt":
            return int(dct["value"])
        elif type_flag == "Set":
            return set(dct["value"])
        elif type_flag == "Map":
            # 将二维数组还原为 Python 字典
            return {k: v for k, v in dct["value"]}
        elif type_flag == "NaN":
            return float("nan")
    return dct

def parse_complex_json(raw_str: str):
    return json.loads(raw_str, object_hook=custom_decoder)

# 测试还原
received_json = '''
{
  "taskId": "T-98214",
  "distributedId": {"$type": "BigInt", "value": "9223372036854775807"},
  "userTags": {"$type": "Set", "value": ["admin", "ai_cluster", "beta"]},
  "metricsMap": {"$type": "Map", "value": [["cpu_usage", 82.5], ["memory_ratio", 0.67]]},
  "nestedDetails": {
    "level1": {
      "level2": {
        "rawScore": {"$type": "NaN"},
        "status": "active"
      }
    }
  }
}
'''

data = parse_complex_json(received_json)
print(type(data["distributedId"])) # <class 'int'>,无精度丢失
print(type(data["userTags"]))      # <class 'set'>
print(data["userTags"])            # {'admin', 'ai_cluster', 'beta'}
print(math.isnan(data["nestedDetails"]["level1"]["level2"]["rawScore"])) # True
三、深层嵌套与海量数据的工业级方案
当 JSON 数据不仅内部类型复杂,同时体积达到数十兆字节(MB)或嵌套深度超过上百层时,简单的全内存加载会带来两类严重隐患:一是爆栈与递归深度上限;二是垃圾回收风暴导致的内存耗尽(OOM)。
1. 递归深度防御(Recursion Limit)
Python 默认的递归调用深度为 1000。如果攻击者刻意构造恶意深层嵌套的 JSON 字典(例如 {"a":{"a":{"a":...}}}),解析过程可能会导致 Python 进程栈溢出崩溃。在生产环境中,应在反序列化前通过定制有限状态扫描器或校验规则,拒绝嵌套深度大于阈值(如超过 30 层)的无效请求。
2. 超大批量:采用 NDJSON(换行分割流)
如果需要在 Node.js 与 Python 脚本之间传递数十万条复杂对象,绝对不要把所有对象放进一个巨大的数组 [...] 中一次性解析。标准做法是采用 NDJSON (Newline Delimited JSON):每一行是一个独立的紧凑 JSON 字符串。
// Node.js 端:使用流式按行写入子进程管道
const { spawn } = require('child_process');
const pyProcess = spawn('python3', ['worker.py']);

// 分批循环写入,不占用超大内存
for (const item of bigDataset) {
  pyProcess.stdin.write(safeStringify(item) + '\n');
}
pyProcess.stdin.end();
# Python 端 worker.py:按行迭代消费,常驻内存极低
import sys
for line in sys.stdin:
line = line.strip()
if not line:
continue
item = parse_complex_json(line)
# 流式执行计算,无需在内存中拼装巨大全量列表
process(item)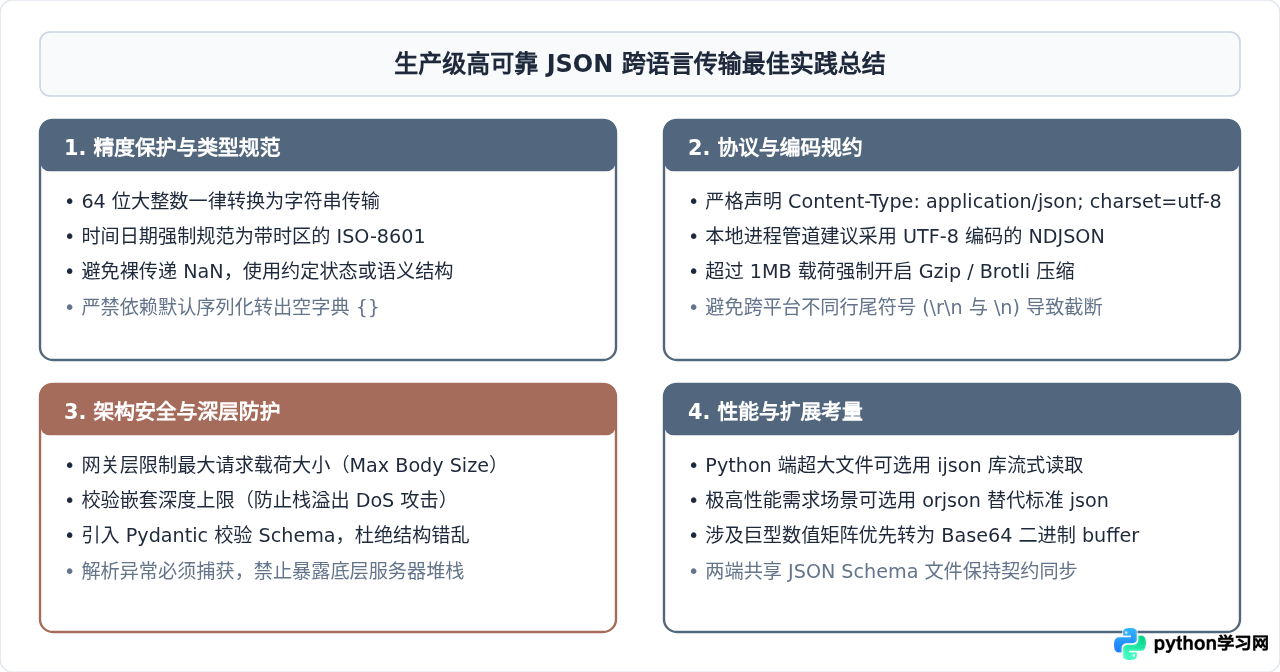
四、避坑清单与最终总结
在工程排错时,如果遇到数据不对劲,建议按照以下优先级逐条核验:
| 隐患现象 | 根本原因 | 标准应对方案 |
|---|---|---|
| 分布式 ID 尾数全变成 0 | JS 端数字超过 253-1 触发精度折叠 | 发送前统一转为字符串格式,服务端用 int() 接收。 |
Set / Map 变成空对象 {} |
JSON.stringify 对原生容器无法识别 |
使用 Array.from(set) 或定制 replacer 打包为数组。 |
| 后端收到时间相差 8 小时 | 前后端未声明时区,误用本地时间字符串 | 一律调用 toISOString() 传输 UTC,Python 用 fromisoformat()。 |
| 进程频繁崩溃报栈溢出 | 未限制深层嵌套结构或内存单次加载超限 | 采用 NDJSON 换行流式解析,网关层配置最大深度拦截。 |
总的来说,JavaScript 与 Python 之间的高可靠复杂 JSON 传递,关键在于打破两端默认序列化行为的盲区。通过规范标准中介字段、在 JS 端通过 Replacer 明确大整数与容器结构、在 Python 端使用 Object Hook 与 Schema 校验层严格还原,便能在享受 JSON 极高兼容性与可读性的同时,彻底消除隐蔽的数据失真与精度损耗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















