


Python读取文件报错UnicodeDecodeError怎么解决?
深入解析Python读取文件时报UnicodeDecodeError的原因与排查步骤,提供显式指定编码、GBK/GB18030处理、UTF-8 BOM解析、编码自动检测及容错策略的完整解决方案。
UnicodeDecodeError 的本质是文件在磁盘上的实际字节编码与 open() 函数所采用的解码规则不匹配。解决这个问题的标准路径是:先明确文件真实编码,再在 open() 中显式传入对应的 encoding 参数(最常见为 'utf-8' 或 'gbk');对于带有字节顺序标记的文件使用 'utf-8-sig';在源数据存在不可逆损坏的应急场景下,合理配置 errors 参数平滑读取。
一、认识报错现象与根本原因
当运行读取文件的代码时,终端经常会抛出类似下面的错误回溯(Traceback):
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xce in position 0: invalid continuation byte或者:
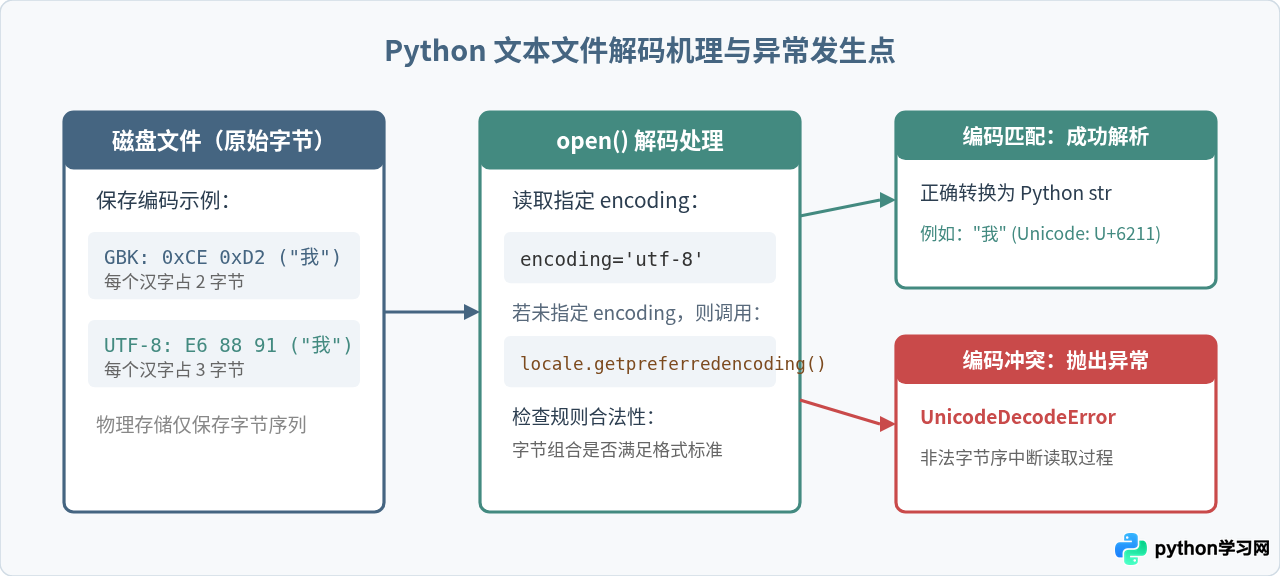
UnicodeDecodeError: 'gbk' codec can't decode byte 0xad in position 14: illegal multibyte sequence这个报错信息由三部分关键内容构成:
- 指定的解码器名称:如
'utf-8'或'gbk',代表 Python 当前正试图用哪套规则把二进制字节转换成字符串。 - 冲突的十六进制字节:如
byte 0xce,说明读取到这个字节时,它在当前规则下不是一个合法的起始字节或后续字节。 - 错误发生的位置:如
position 0,指明了文件具体在第几个字节触发了规则冲突。
磁盘上的文件本质上只是由 0 和 1 组成的二进制字节流(bytes)。当我们以文本模式(默认 'r')读取文件时,Python 必须依靠某种编码表(encoding)把这些字节映射成内存中的 Unicode 字符(str)。若未指定编码,Python 会读取操作系统当前的默认编码(Windows 中文版通常是 GBK/CP936,而 Linux 和 macOS 默认是 UTF-8)。当文件保存时使用的是 UTF-8,而读取时使用了 GBK;或者文件保存为 ANSI/GBK,读取时使用了 UTF-8,解码过程就会立刻失败。
二、解决该报错的四个标准步骤
排查和解决 UnicodeDecodeError 时,应遵循由浅入深、先规范后容错的顺序。盲目修改或者直接忽略错误可能会导致后续数据出现乱码或静默丢失。
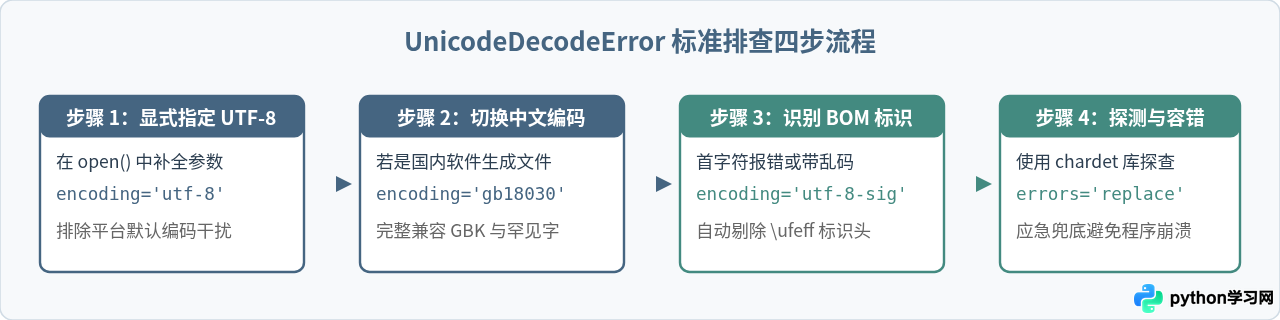
第一步:显式传入 encoding='utf-8' 参数
很多初学者写文件读取时习惯直接写 open('data.txt', 'r')。在很多 Linux 和 macOS 环境下,系统默认编码是 UTF-8,因此代码能够正常运行;但一旦把代码移到 Windows 环境下运行,系统默认编码变成了 cp936,读取 UTF-8 编码的文件就会立刻抛出 UnicodeDecodeError。
第一步操作就是为 open 显式指定 UTF-8 编码:
# 规范写法:必须使用 with 语句并显式指定 encoding
with open('data.txt', 'r', encoding='utf-8') as f:
    content = f.read()
    print("成功读取文件内容,字符数:", len(content))
第二步:尝试常见中文编码(GBK 与 GB18030)
如果指定了 encoding='utf-8' 依然报错,通常说明该文件是使用早期的中文 Windows 系统、记事本默认 ANSI 保存,或者由国内某些工业系统、办公软件导出的。这些文件通常采用 GBK 系列编码。
此时应将编码更换为 gbk。更推荐的做法是直接使用 gb18030,因为它是 GBK 的超集,不仅包含了所有 GBK 字符,还收录了我国国家标准规定的少数民族文字与生僻字,兼容性更广:
# 针对 Windows ANSI / GBK 格式导出的中文文件
with open('data.txt', 'r', encoding='gb18030') as f:
    content = f.read()
    print("使用 gb18030 成功解码!")
第三步:处理带 BOM 的文件(使用 utf-8-sig)
如果文件是在 Windows 平台下的记事本保存为 UTF-8 格式,或者由 Excel 导出为 CSV,文件开头可能会被悄悄添加三个字节的“字节顺序标记”(BOM,十六进制为 0xEF 0xBB 0xBF)。
如果用普通 utf-8 解码,虽然有时不会直接报错,但读取出的第一个字符串前会带有一个不可见的字符 \ufeff,这会导致字典键匹配失败或数值转换异常;在某些特定环境或结合截断读取时也会引发解码异常。Python 提供了专门的 utf-8-sig 编码名称,它会在解码时自动识别并移除开头的 BOM 标记:
# 自动识别并剥除开头的 BOM 头信息
with open('excel_export.csv', 'r', encoding='utf-8-sig') as f:
    first_line = f.readline()
    print("第一行内容(已自动去除 BOM 头):", first_line)
第四步:使用工具库自动探测未知编码
在面对外部用户上传、来源不清晰的历史日志或批量处理不同来源的文本时,硬编码某一种编码容易频繁踩坑。此时可以先以二进制模式('rb')读取少量文件前缀字节,借助成熟的编码检测库来推断编码格式:
# 需要先安装:pip install charset-normalizer (或 chardet)
import charset_normalizer

def detect_file_encoding(file_path):
    with open(file_path, 'rb') as f:
        # 只读取前 10KB 即可完成高概率判定,无需加载全量大文件
        raw_data = f.read(10240)
    result = charset_normalizer.detect(raw_data)
    return result['encoding']

# 结合检测结果安全读取
file_name = 'unknown_source.txt'
detected_enc = detect_file_encoding(file_name) or 'utf-8'
print(f"检测到的可能编码为: {detected_enc}")

with open(file_name, 'r', encoding=detected_enc) as f:
    text = f.read()
三、常见编码与应用场景对比
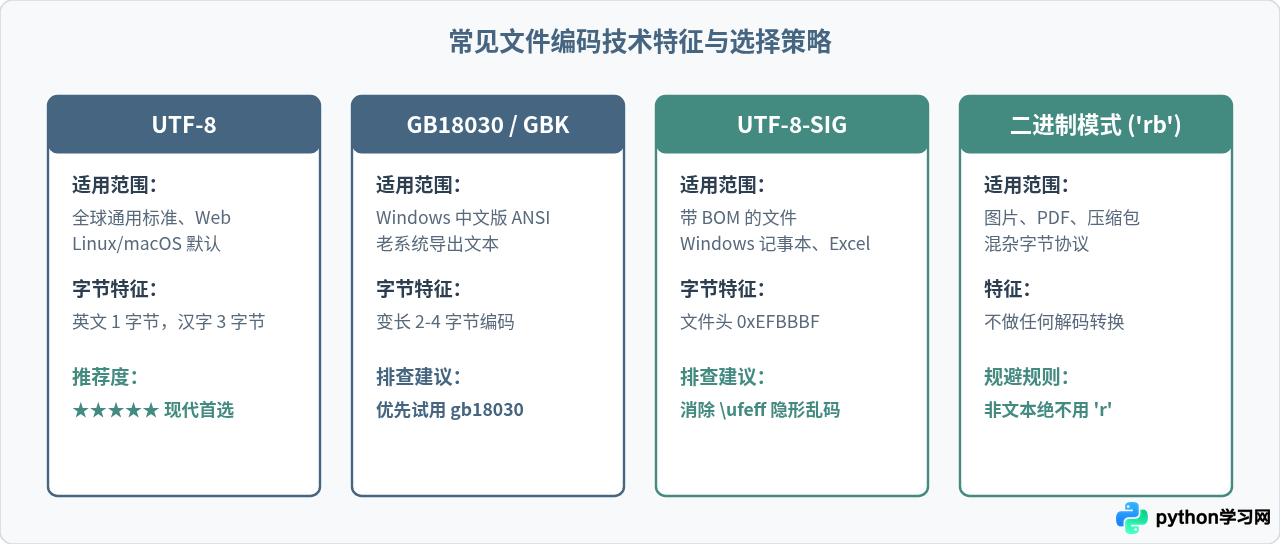
下表总结了在 Python 文件处理中最常见的字符编码、典型适用场景及处理建议:
四、无法修改源文件时的容错读取策略
在实际生产环境中,有些文件可能是在网络传输中发生过截断,或者是由多个不同编码系统拼合而成的历史日志,里面夹杂着个别损坏或无法识别的脏字节。如果因为几个损坏字节就导致整个离线数据清洗任务崩溃,业务代价过高。此时可以使用 open() 提供的 errors 参数。
1. 替换非法字节:errors='replace'(推荐)
遇到解码规则外的字节时,将其替换为专用的 Unicode 替换字符 (U+FFFD),保证文件其余部分能够被完整读取,并且在后续查看时能明确知道哪里出现了脏数据:
with open('messy_log.txt', 'r', encoding='utf-8', errors='replace') as f:
    for line in f:
        # 损坏的字节会被显示为 ,而不会中断整个流程
        process_line(line)
2. 忽略非法字节:errors='ignore'(谨慎使用)
遇到无法解码的字节时直接跳过丢弃:
with open('messy_log.txt', 'r', encoding='utf-8', errors='ignore') as f:
content = f.read()errors='ignore' 会直接吞掉字节,可能导致中文字符的某一截被丢弃,引起上下文串位或信息丢失。只有在对个别字符完整性不敏感的大规模文本统计、词频分析等任务中才考虑使用;对于财务、配置文件或结构化数据,应优先排查正确编码。
五、其他引发该报错的典型陷阱
- 把二进制文件当做文本读取:试图用
open('picture.png', 'r')读取图片、Word(.docx)、Excel(.xlsx)或压缩包。这些是纯二进制文件,并不是纯文本,必须使用'rb'模式读取,或者借助专门的第三方库(如openpyxl、python-docx)解析。 - 写入与读取编码不一致:在程序写入阶段使用了系统默认编码,而在读取阶段指定了
utf-8。在写入时务必同样显式指定open('out.txt', 'w', encoding='utf-8')。 - 只替换了错误,没有保存为统一格式:如果排查出源文件是 GBK 并成功读取,建议在处理完毕重新保存时统一转存为标准 UTF-8,避免后续链路中的其他程序再次报错。
六、稳健文件操作的最佳实践总结
为了在开发与运维中彻底远离 UnicodeDecodeError,建议在所有涉及文件读写的地方执行以下标准操作范式:
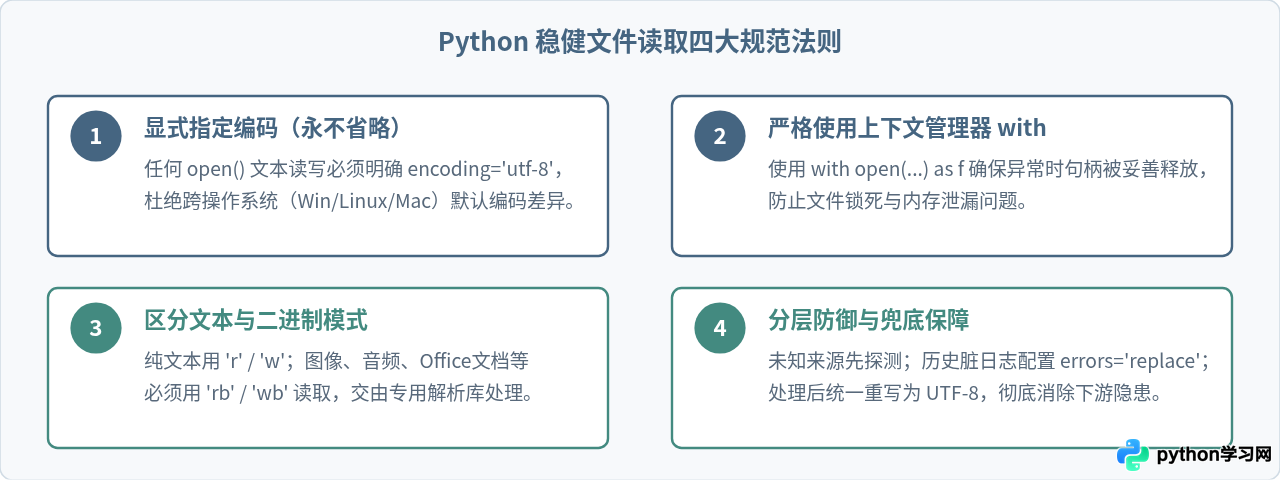
遵循这套规范,绝大多数由编码冲突导致的异常都可以被快速消除,保障程序在各个操作系统与复杂数据环境下稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















