


Python将字符串空格替换为下划线或连字符的方法
详细讲解在Python中将字符串空格替换为下划线(_)或连字符(-)的三种主要方法:str.replace()、split与join组合,以及正则表达式re.sub(),包含原理分析、适用场景对比及避坑指南。
在 Python 中将字符串中的空格替换为下划线(_)或连字符(-),最基础的解决路径是使用字符串内置方法 str.replace();若字符串中存在连续多空格或不规则制表符且希望规整为单个连接符,标准做法是组合使用 split() 与 join();而在处理复杂文本清洗、生成合规 URL 或文件名时,使用正则表达式 re.sub() 则是最严谨的方案。本文将详细讲解这三种实现方法、底层差异、适用场景以及实际编码中容易忽略的边界问题。
一、基础方案:使用 str.replace() 进行逐字替换
Python 字符串属于不可变序列,任何修改方法都会返回一个新的字符串对象,而不会在原地修改原变量。str.replace(old, new, [count]) 方法提供精确的字符查找与替换机制。当目标仅仅是将单一空格字符直接对应替换为指定符号时,该方法运行效率最高,语义也最为直观。
# 示例代码:使用 str.replace() 替换单空格
text = "python string replace tutorial"

# 替换为空格转下划线(常用于变量名或标识符构造)
snake_result = text.replace(" ", "_")
print("下划线形式:", snake_result)
# 输出结果: python_string_replace_tutorial

# 替换为空格转连字符(常用于构造可读性 URL)
kebab_result = text.replace(" ", "-")
print("连字符形式:", kebab_result)
# 输出结果: python-string-replace-tutorial
如果只想替换前几个空格,可以传入第三个参数 count。例如 text.replace(" ", "-", 2) 只会处理前两个遇到的空格字符,后续空格保持原样。
机械替换的局限性与潜在问题
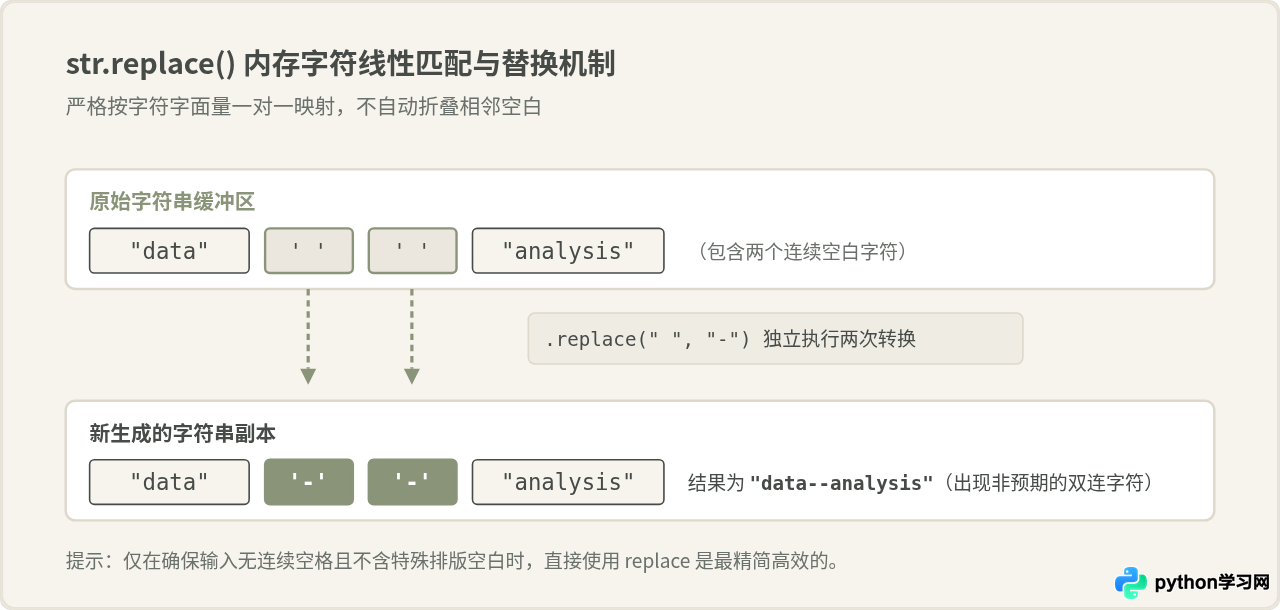
str.replace() 采取严格的一对一字面匹配机制。很多初学者容易默认“把空格替换为连字符”等同于“将词语以连字符连接”,但这在输入包含连续空格或制表符时会产生意外结果。例如字符串 "data analysis"(中间含有两个空格),执行 replace(" ", "-") 后会得到 "data--analysis",产生了不符合排版规范的连续双破折号。此外,它无法识别 \t(制表符)或 \n(换行符)等其他空白符。
二、标准方案:使用 split() 与 join() 自动规整多余空白
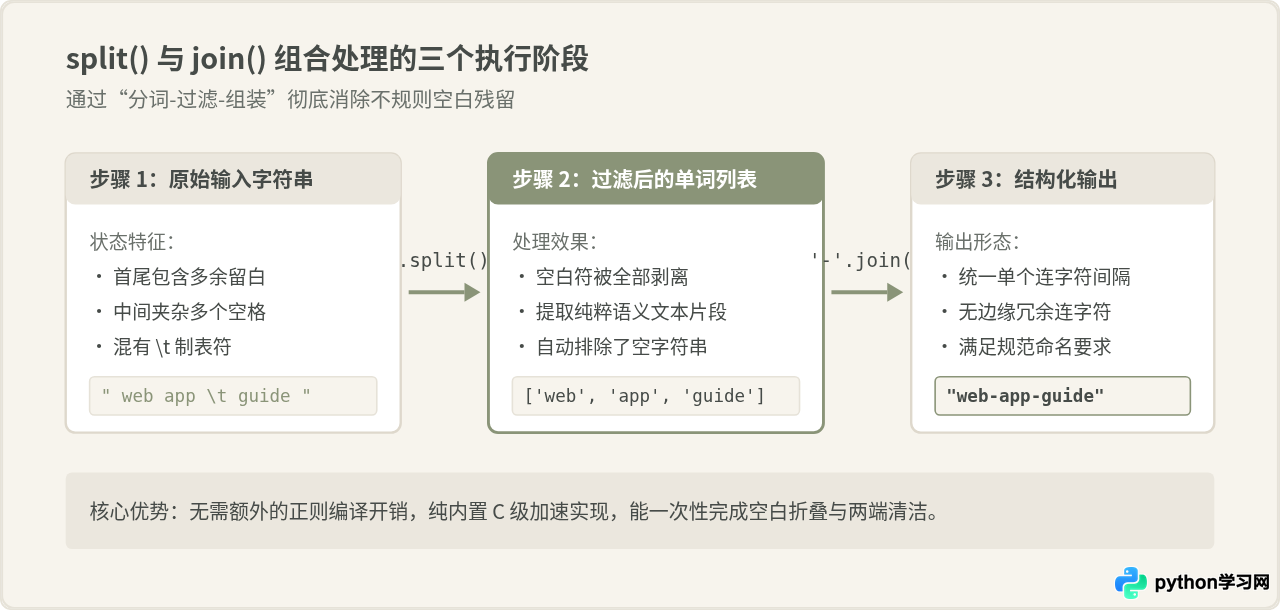
当处理由用户输入、爬虫抓取或文件解析得到的非规范文本时,连续空格以及夹杂的制表符非常普遍。若目标是将“词与词之间所有的多余空白合并,统一转为一个连字符或下划线”,推荐采用 Pythonic 风格的 split() 配合 join()。
当字符串方法 split() 不传任何参数调用时,具有两项极为关键的内置特性:
- 自动将任何连续的空白符(包括单空格、多空格、
\t制表符、\n换行符等)整体视为一个分隔符; - 自动忽略字符串最开头和最末尾的多余空白,无需提前调用
strip()。
# 示例代码:split 与 join 规整化替换
raw_title = "   Machine   Learning   Basics \t and Practice \n  "

# 第一步:split() 自动按任意连续空白切词并清理两端
words = raw_title.split()
print("切分后的词元列表:", words)
# 输出: ['Machine', 'Learning', 'Basics', 'and', 'Practice']

# 第二步:使用目标连接符将列表元素拼合
snake_case = "_".join(words)
kebab_case = "-".join(words)

print("标准下划线形式:", snake_case)
# 输出: Machine_Learning_Basics_and_Practice

print("标准连字符形式:", kebab_case)
# 输出: Machine-Learning-Basics-and-Practice
避坑提示: 切勿写成 raw_title.split(" ")(传入单个空格作为参数)。一旦显式指定了分隔符 " ",Python 就会退化为严格字符匹配,遇到连续两个空格时会在列表中产生大量空字符串元素 "",随后拼接出来的结果依然会包含多重连字符。
三、高级方案:使用正则表达式 re.sub() 应对复杂清洗
当需求进一步延伸到“既要替换空格,又要将特殊字符或不可见字符转换,并确保生成合规的文件路径或 URL Slug”时,标准库 re 模块能提供最精确的控制。
正则表达式 r'\s+' 可以匹配一个或连续多个连续空白符。通过 re.sub(pattern, repl, string),能精确控制替换逻辑:
import re

raw_string = "User   Interface   Design & Layout"

# 1. 仅将所有一个或多个空白替换为单个下划线
clean_step1 = re.sub(r'\s+', '_', raw_string.strip())
print("正则简单替换:", clean_step1)
# 输出: User_Interface_Design_&_Layout

# 2. 进一步需求:将空白及非字母数字字符全部替换为连字符(经典 Slug 化操作)
slug = re.sub(r'[^a-zA-Z0-9]+', '-', raw_string.lower()).strip('-')
print("合规 URL Slug:", slug)
# 输出: user-interface-design-layout
在上述第二个例子中,正则表达式 r'[^a-zA-Z0-9]+' 匹配任何非英文字母及非数字的字符组(包括空格、&、标点符号),并统一替换为单个 -。最后的 .strip('-') 则确保开头和末尾不会遗留连字符。
四、三种方案的核心特性横向对比
选择哪种方法,核心取决于输入数据的清洁程度以及对于边界情况的预期容错能力。下表汇总了三种方式的关键区别:
| 考量维度 | str.replace(" ", "-") | "-".join(text.split()) | re.sub(r'\s+', '-', text) |
|---|---|---|---|
| 单空格处理 | 直接替换,效率极高 | 直接替换,过程规范 | 直接替换,有微小正则开销 |
| 连续多空格 | 机械产生 -- 多个符号 |
自动折叠为单个 - |
依赖 \s+ 自动折叠为单个 - |
| 制表符/换行符 | 无法识别,原样保留 | 自动识别并合并 | \s 全面匹配并合并 |
| 首尾多余空格 | 首尾被替换为连字符 | 自动剔除首尾空白 | 需配合 .strip() 清理 |
| 非空白特殊字符 | 不支持复杂模式 | 不支持复杂模式 | 天然支持各类字符集过滤 |
五、工程实践中的选型路径与总结
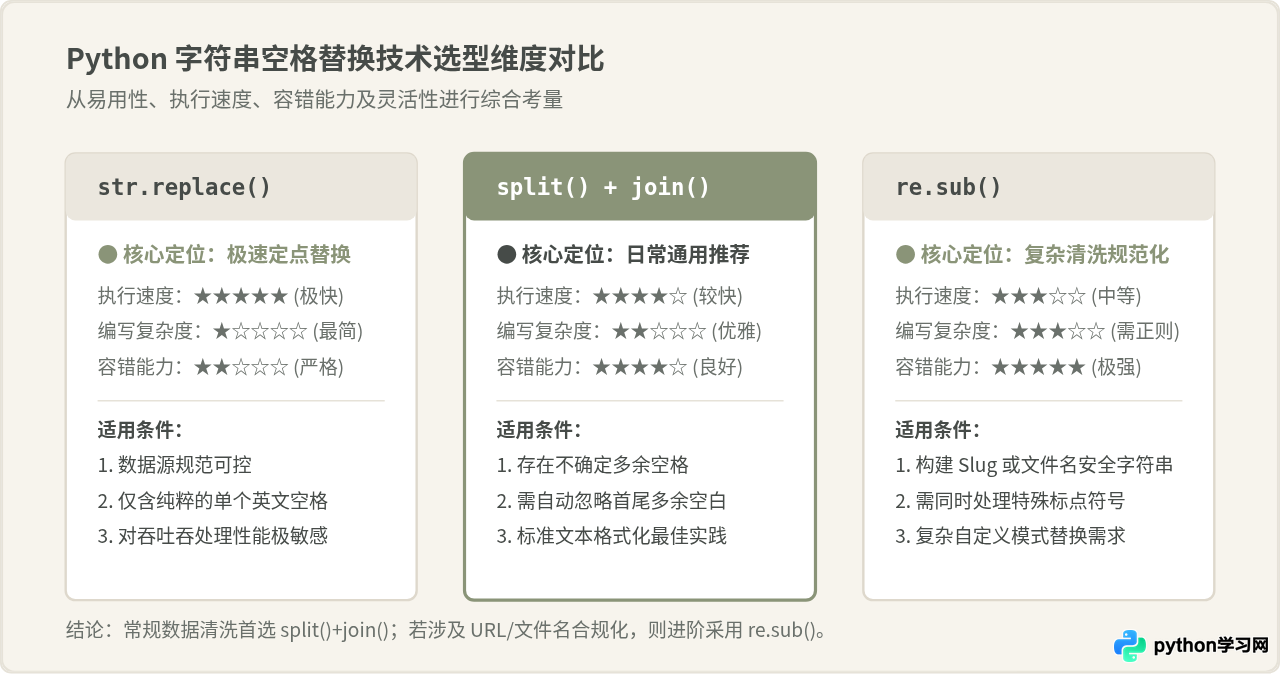
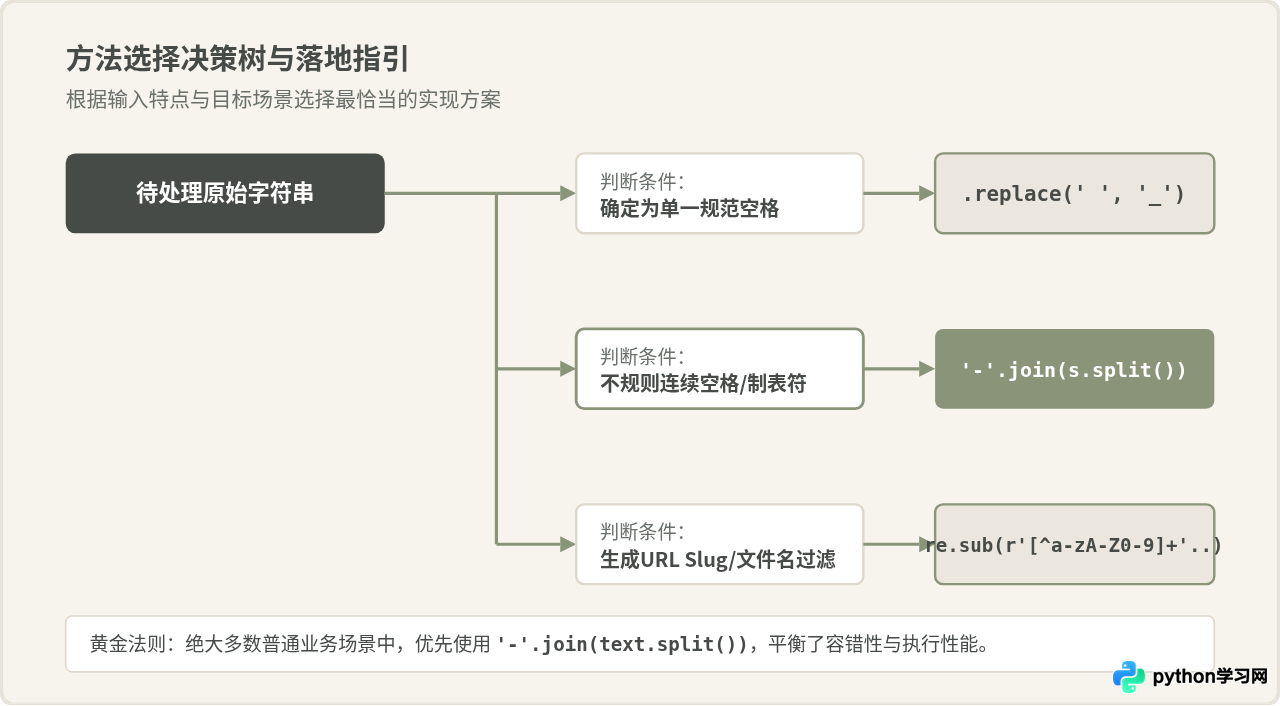
为了在实际开发中少走弯路,可以依据输入文本来源和最终用途快速决策:
- 固定格式的内部字符串:如果字符串来自于系统受控生成的单键名,且确定单词之间只用单一 ASCII 空格分隔,直接调用
s.replace(' ', '_')是代码最少、性能最高的方式。 - 外部可变文本与普通展示:如果字符串来源于表单输入、用户文章标题或日志,可能包含不小心多按的空格,使用
'-'.join(s.split())是最稳妥的 Pythonic 解法。 - 文件系统与 Web 路由合规处理:如果要将标题直接转化为磁盘文件名或网页链接,除了将空格转为连字符外,还需同步处理大小写(
.lower())及过滤特殊非法字符(如/ \ : * ? " < > |),此时封装一个专用的正则清洗函数最为稳健。
六、常见问题排查 (FAQ)
1. 为什么替换后打印结果没有任何变化?
初学者容易忘记 Python 中字符串是不可变类型(immutable)。例如写了 text.replace(" ", "-") 但没有将返回值重新赋给变量(如 text = text.replace(...)),原变量 text 本身是不会发生变动的。
2. 如何同时将空格和已有下划线统一替换为连字符?
如果字符串中原本同时混合存在空格和下划线(例如 "user_name first login"),需要全部统一转换为连字符,可以使用正则表达式:
import re

text = "user_name first login"
unified = re.sub(r'[\s_]+', '-', text)
print(unified)
# 输出: user-name-first-login
正则字符集 [\s_]+ 可以匹配连续出现的任意空白或下划线,并一次性归一化为单个连字符。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















