


Python字符串中的转义字符列表及使用规范
全面解析Python字符串中的转义字符列表、底层语法解析机制、原始字符串(r-string)的使用场景与限制,以及现代Python版本中的转义避坑规范。
\)是语言层面的转义引导符。当程序需要表示无法通过键盘直接键入的不可见控制符(如换行、回车、制表符)、消除字符本身与字符串定界符的语法冲突(如单双引号嵌套),或精确指定特定 Unicode 码位时,转义字符是基础且核心的机制。本文梳理 Python 官方完整的转义字符列表,深入剖析其词法分析原理,并给出工程实践中的规范用法与常见陷阱。
一、转义字符的产生背景与底层工作原理
Python 字符串是由 Unicode 字符构成的不可变序列。在源代码编写阶段,文本字面量必须被包裹在单引号 '...' 或双引号 "..." 中。这种定义方式直接引发了两个实际问题:其一,如何在字符串内部直接表达一个引号本身而不破坏语法边界;其二,如何在文本中表达如换行(ASCII 10)、退格(ASCII 8)等非打印控制字符。
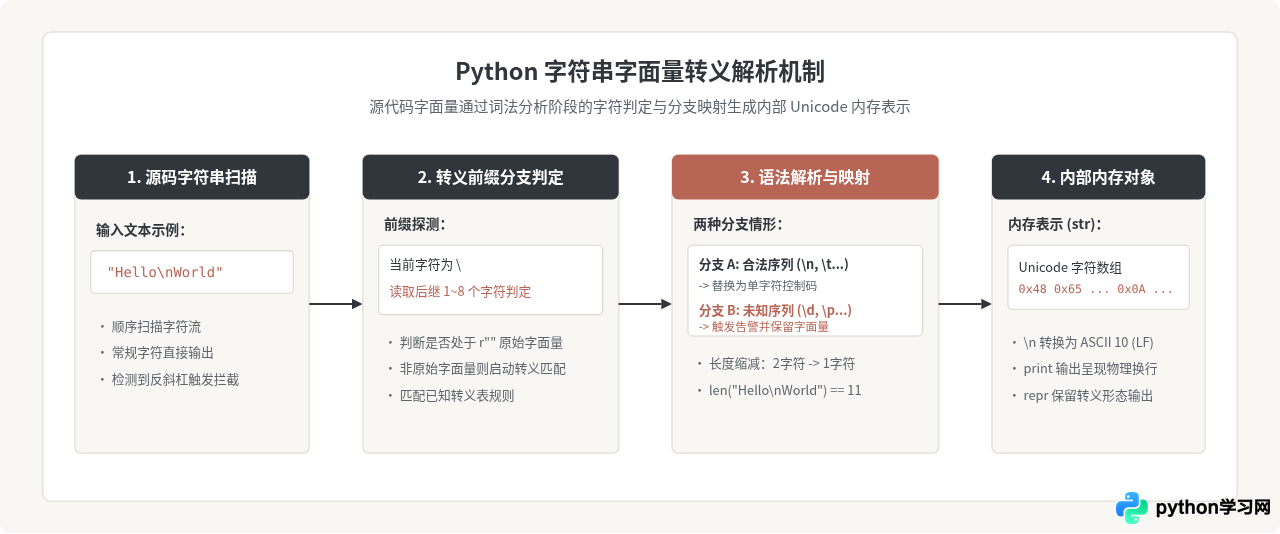
Python 的词法解析器(Lexer)在扫描字符串字面量时,一旦遇到反斜杠 \,便会暂停常规字符的收集,转而读取随后的若干个字符,将其组合判定为一个特殊的“转义序列”(Escape Sequence)。若该序列符合 Python 语法规范,词法分析器会将其替换为对应的一个具体字符对象(例如 \n 转换为码位为 10 的单个换行符);若不匹配已知规则,在现代 Python 中则会触发弃用警告或语法警告。
二、标准转义字符分类与完整列表
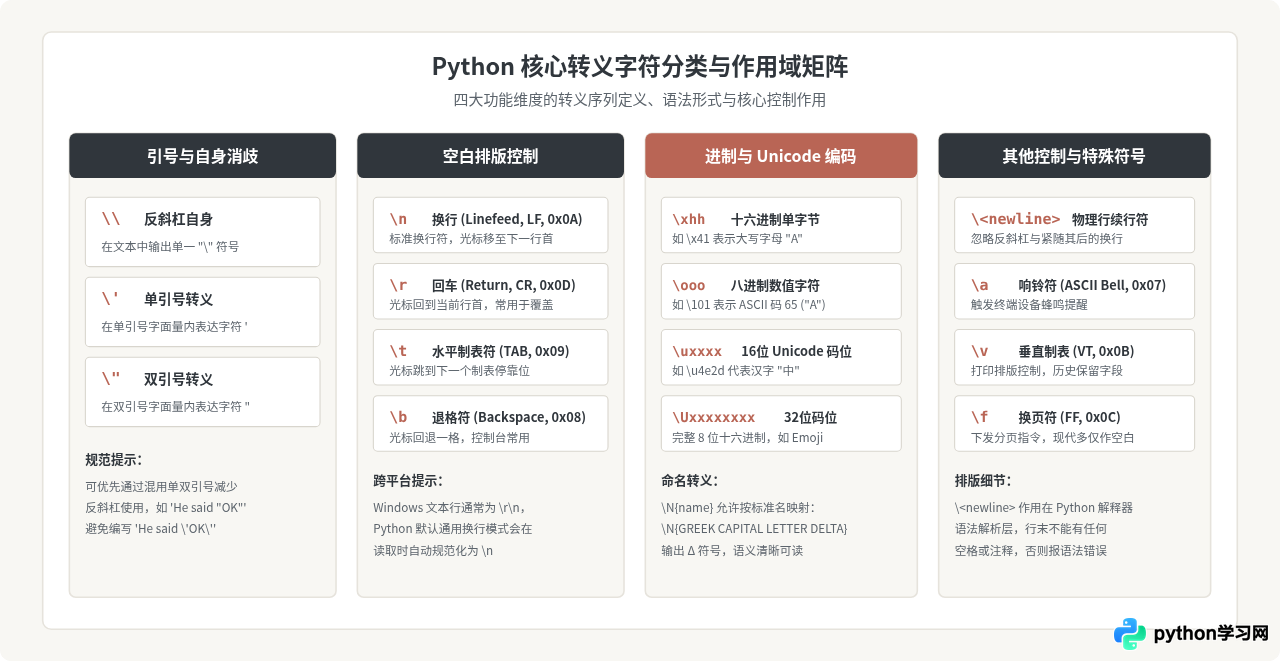
根据 Python 官方语言参考手册(Python Language Reference),Python 支持的转义字符可以分为四大功能类别:边界消歧与反斜杠自身、常见空白与控制符、进制数值与 Unicode 字符映射,以及物理行续行符。
官方转义字符速查表
| 转义序列 | 含义 / ASCII / Unicode 名称 | 典型示例与说明 |
|---|---|---|
\\ |
反斜杠字面量(Backslash) | "C:\\Windows\\System32" 输出单一反斜杠路径 |
\' |
单引号(Single Quote) | 'It\'s fine' 在单引号字符串中安全输出单引号 |
\" |
双引号(Double Quote) | "He said: \"Hello\"" 在双引号字符串中安全输出双引号 |
\a |
响铃符(ASCII Bell, 0x07) | print("\a") 触发终端警告铃声 |
\b |
退格符(ASCII Backspace, 0x08) | "ABC\bD" 输出为 "ABD"(光标回退并覆盖) |
\f |
换页符(ASCII Formfeed, 0x0C) | 传统打印机控制分页,在终端中通常显示为分页标记 |
\n |
换行符(ASCII Linefeed, 0x0A) | "Line1\nLine2" 文本断行并在下一行继续 |
\r |
回车符(ASCII Carriage Return, 0x0D) | "Loading...\rDone!" 光标回到行首,常用于进度条动态刷新 |
\t |
水平制表符(ASCII Tab, 0x09) | "Name\tAge\tScore" 按列对齐终端制表数据 |
\v |
垂直制表符(ASCII Vertical Tab, 0x0B) | 使输出在垂直方向跳转到下一个制表位 |
\ooo |
八进制数值字符(1 到 3 位八进制) | "\101" 对应 ASCII 65,即大写字母 "A" |
\xhh |
十六进制数值字符(2 位十六进制) | "\x41" 对应十六进制 0x41,即大写字母 "A" |
\uxxxx |
16 位十六进制 Unicode 字符 | "\u4e2d\u6587" 输出汉字 "中文" |
\Uxxxxxxxx |
32 位十六进制 Unicode 字符 | "\U0001F600" 输出表情符号 "😀"(高位必须补齐8位) |
\N{name} |
Unicode 字符数据库标准名称 | "\N{WHITE SMILING FACE}" 输出 "☺" |
\<newline> |
物理行拼接(反斜杠后直接换行) | 连接长代码行,该反斜杠及之后的换行符均被解释器忽略 |
三、原始字符串(Raw String)的使用规范与限制
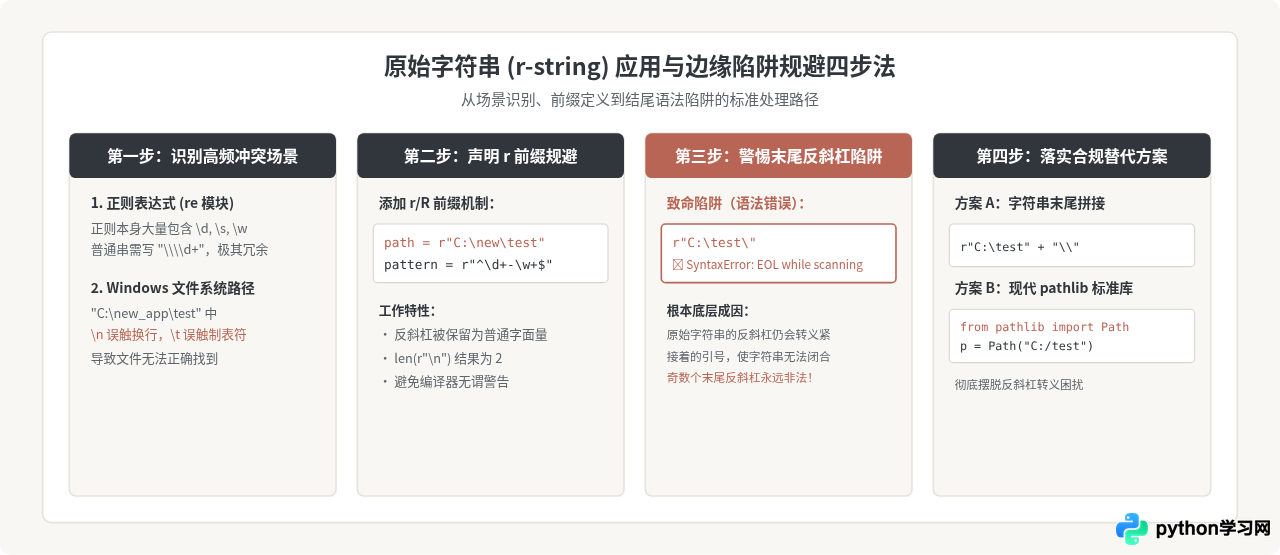
在处理含有大量反斜杠的场景(如正则表达式与 Windows 路径)时,频繁编写双反斜杠 \\ 不仅降低代码可读性,还极易出现转义遗漏。为此,Python 提供了原始字符串(Raw String)机制,只需在字符串前添加 r 或 R 前缀。
在原始字符串中,反斜杠被当作字面量字符对待,不会将 \n 解析为换行,也不会将 \t 解析为制表符。例如,r"C:\new_project\test" 中的 \n 和 \t 均保持两个独立字符原样输出。
重点排查:原始字符串不能以奇数个反斜杠结尾
许多开发者在编写路径时容易写出类似 dir_path = r"C:\data\" 的代码,从而导致解释器抛出 SyntaxError: unterminated string literal。必须深刻理解这一底层逻辑:原始字符串并不是完全禁用转义,它仅仅是保留反斜杠自身作为字符,但反斜杠对紧随其后的定界引号依然生效。
当词法分析器读到末尾的 \" 时,它认为该引号是被转义的普通字符,而不是字符串结束的右边界,导致该字符串一直向后寻找闭合引号直至文件结束报错。
# ❌ 错误示范:抛出 SyntaxError
invalid_path = r"C:\project\"

# ✅ 正确做法一:拆分并在末尾追加转义反斜杠
valid_path_1 = r"C:\project" + "\\"

# ✅ 正确做法二:正斜杠跨平台写法(Windows 核心 API 完全兼容)
valid_path_2 = "C:/project/"

# ✅ 正确做法三:面向对象的 pathlib 方案(官方首选推荐)
from pathlib import Path
project_dir = Path("C:/project")
四、现代 Python 版本中的转义规范演进与避坑指南
1. 无效转义序列的严厉化:从 DeprecationWarning 到 SyntaxWarning
在早期的 Python 版本中,若编写了一个非标准转义序列(例如普通字符串中写了 "\d" 或 "\p"),Python 会容忍这种写法,直接原样保留反斜杠与后续字母。这种宽容机制导致了大量潜藏 Bug。
从 Python 3.8 开始,未识别的转义序列被正式标记为 DeprecationWarning。而在 Python 3.12+ 中,这一行为被进一步升级为默认可见的 SyntaxWarning,并计划在后续的主版本中彻底提升为 SyntaxError。因此,任何包含非标准转义的普通字符串都必须重构:
import re

# ⚠️ Python 3.12+ 报 SyntaxWarning: invalid escape sequence '\d'
pattern_bad = "\d+\.\d+"

# ✅ 规范写法:显式指定为 raw 字符串
pattern_good = r"\d+\.\d+"
2. f-string(格式化字符串)中的转义规范升级
在 Python 3.11 及更早版本中,格式化字符串表达式 f"{...}" 的花括号内部严格禁止出现任何反斜杠 \。这意味着诸如 f"{'\n'.join(lines)}" 的表达式在语法层面是非法的,开发者必须提前将 "\n" 提取为外部中间变量。
Python 3.12 引入了全新的 PEP 701 词法分析器,全面解除了对花括号内转义字符的限制。现在,在 {} 表达式内部可以合法使用包含反斜杠的代码:
# Python 3.12+ 完全合法
data_lines = ["Apple", "Banana", "Cherry"]
formatted_output = f"Items:\n{'\n'.join(data_lines)}"
print(formatted_output)\n 等转义的 join 逻辑)提取到 f-string 外部完成,以维持跨版本的向后兼容性。
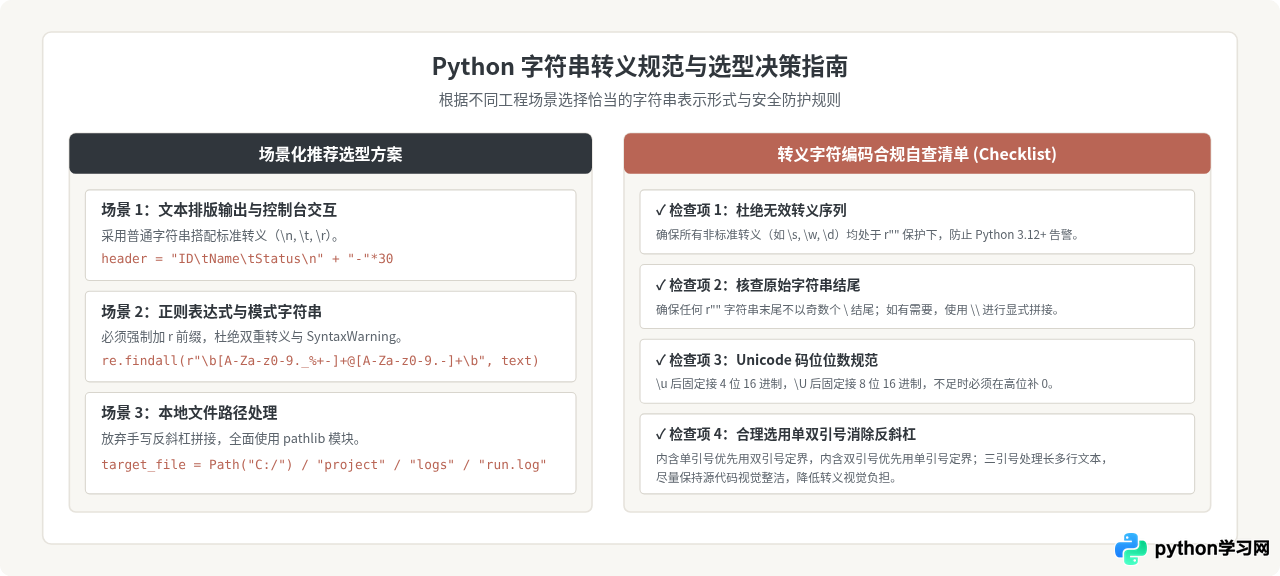
五、总结与核心编码建议
转义字符是连接源码可读性与计算机底层字符编码的关键桥梁。在实际项目开发中,建议牢记以下四条黄金法则:
- 明确转义边界:牢记
\n、\t等转义发生在词法解析期。字面量"\n"在内存中的长度(len)是 1 而不是 2。 - 正则表达式必带
r:所有re模式串一律使用r"..."前缀,将转义解析权完整交由正则引擎,杜绝编译器无效转义警告。 - 文件路径抛弃手动转义:在跨平台开发中,使用
pathlib.Path或标准正斜杠/,这是消除 Windows 反斜杠转义问题的最彻底方案。 - 善用引号混用与多行字符串:通过外层单双引号的交替定义,以及三引号
"""..."""承载大段多行文本,减少不必要的\"、\'与\n转义,保持代码简洁清爽。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















