


Python序列通用操作指南:索引、切片与成员检查
详细讲解Python中序列类型(字符串、列表、元组等)的通用核心操作,涵盖正负双向索引、三参数切片执行逻辑、栅栏边界模型与in成员检查性能分析。
in 的成员检查机制,是编写稳健、地道 Python 代码的基本前提。
一、序列的基础概念与内存寻址逻辑
Python 序列是指一组按照特定顺序排列的值的集合,每个元素在序列中都具有确定的位置编号。标准库中的典型序列包含不可变序列(如 str、tuple、bytes)与可变序列(如 list、bytearray)。
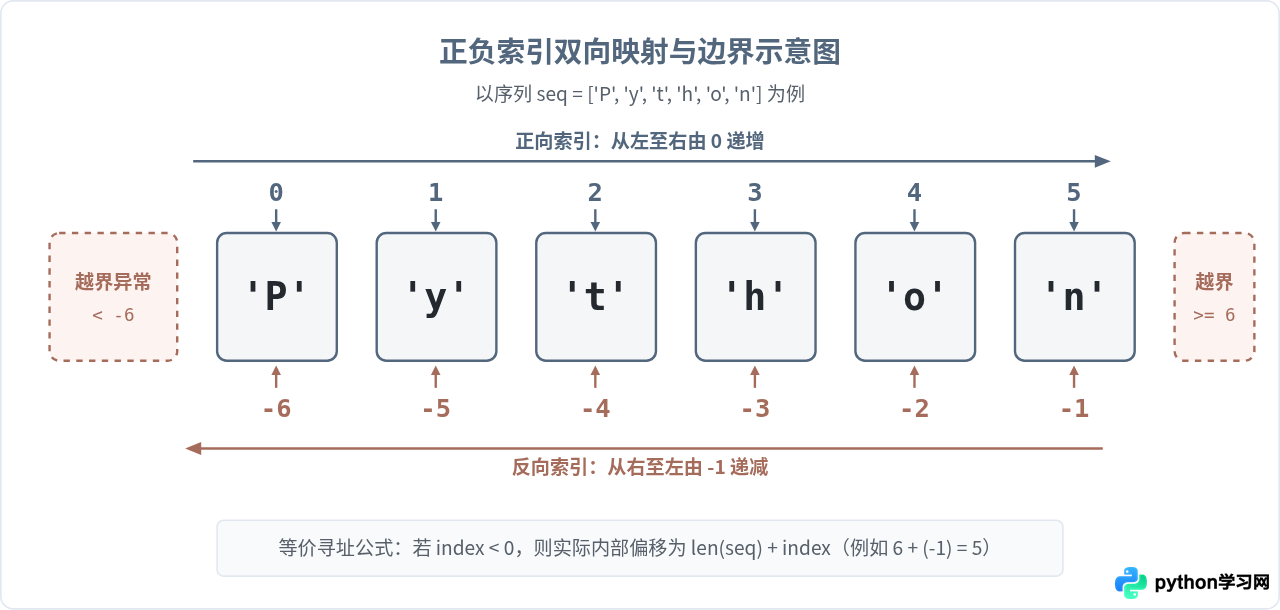
尽管不同序列的底层内存分布存在差异——例如字符串通常存储为紧凑的字符编码数组,而列表存储的是指向对象的连续指针数组——但在语法层面上,Python 统一提供了两套对称的位置索引系统:自左向右的正向索引(从 0 递增)与自右向左的反向索引(从 -1 递减)。
1. 单元素访问语法与边界检查
通过方括号 seq[i] 语法可直接取出下标为 i 的单一对象。正负索引具有一一对应的等价关系。设序列长度为 $n$,对于任意负数索引 $i$(满足 $-n \le i \le -1$),其访问效果完全等同于正向索引 $n + i$。
# 示例代码:正负索引访问
sample_text = "Python"
print(sample_text[0])    # 输出示例: P
print(sample_text[-1])   # 输出示例: n (最后一个字符)
print(sample_text[-6])   # 输出示例: P (等价于 sample_text[0])
与后文的切片不同,单元素索引访问具有严格的边界检查。只要给定的索引值不在 $[-n, n-1]$ 的闭区间范围内,Python 解释器便会立即抛出 IndexError: string index out of range(或 list index out of range)。在未确认序列长度前直接按绝对索引取值,是生产环境中常见的一类隐蔽异常。
二、切片操作:语法规则与执行流
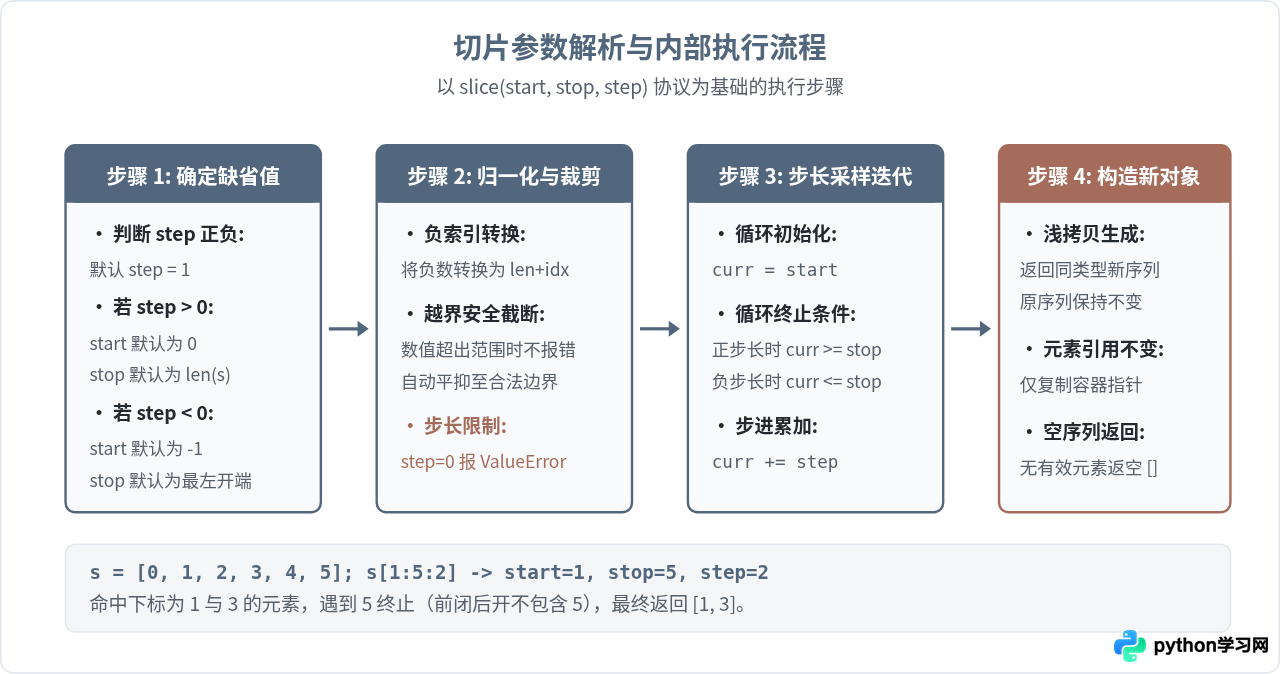
当需要从序列中提取一段连续或有规律间隔的子序列时,切片(Slicing)是最地道的解决手段。切片的完整形式为 sequence[start:stop:step],接收三个由冒号分隔的整数参数。
2. 前闭后开区间:设计初衷与数学对称性
Python 切片最核心的原则是“前闭后开”,即区间范围包含 start 所在位置,但不包含 stop 所在位置(数学表示为 $[start, stop)$)。这种设计并非偶然,它带来了若干优雅的语言学特性:
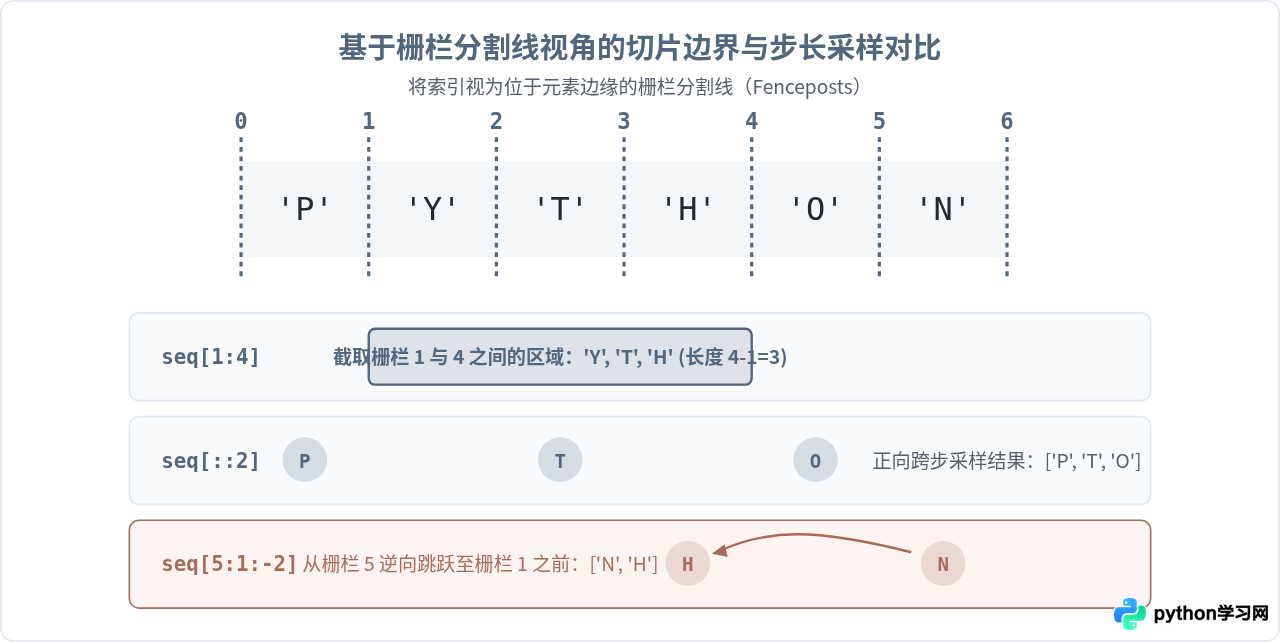
- 切片长度可直接计算:在正步长为 1 的情况下,截取结果的元素个数恰好等于
stop - start。例如s[1:4]的长度即为 $4 - 1 = 3$。 - 相邻切片自然拼接:以任意下标
i为分割点,切片s[:i]与s[i:]能够无缝分割整个序列且无任何重叠或遗漏,恒有s[:i] + s[i:] == s。
3. 步长与逆序操作
第三个参数 step 指定采样步长与前进方向。当 step 为负数时,采样方向将完全倒置,从右向左移动。
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 基础提取:下标 2 到 6(不含 6)
print(data[2:6])      # 输出示例: [2, 3, 4, 5]

# 间隔采样:每隔 2 个元素提取一次
print(data[1:8:2])    # 输出示例: [1, 3, 5, 7]

# 逆序提取:start 必须在 stop 右侧
print(data[6:2:-1])   # 输出示例: [6, 5, 4, 3]

# 完整翻转整个序列
print(data[::-1])     # 输出示例: [9, 8, 7, 6, 5, 4, 3, 2, 1, 0]
三、深层理解:栅栏分割线模型与容错机制
在初学切片时,许多人常因反向切片或边界值产生困惑。解决此类问题最有效的思维模型是“栅栏分割线模型”(Fencepost Model)。不要将索引看作元素本身,而是看作元素之间的垂直分割缝隙。
4. 切片的自动截断与容错特性
与索引访问不同,切片操作对越界是完全宽容的。如果给定的 start 或 stop 超过了序列两端的有效范围,解释器会自动将其平抑截断至最靠近的有效端点,而不会抛出任何 IndexError:
text = "Python"

# start 远小于 -100,stop 远大于 100
print(text[-100:100])   # 输出示例: Python

# start 超过实际最大长度
print(text[10:20])      # 输出示例: '' (返回空字符串,不报错)
这一特性为批量文本截断和安全分片提供了极大的便利,但在特定场景下也可能悄悄掩盖业务逻辑中的计算错误,需结合场景审慎利用。
四、成员检查:in 与 not in 的判断机制与复杂度
用于验证特定元素是否存在于序列中的操作符是 in 和 not in。其语法简单直观,但其内部实现机制因序列底层类型的不同而有着明显的性能分水岭。
1. 通用序列的线性扫描
在列表(list)与元组(tuple)中,x in seq 本质上是通过遍历底层指针数组,逐一调用等价性比较(item == x)来进行判定的。这意味着:
- 时间复杂度为 $O(n)$:最坏情况下必须完整遍历所有元素才能确认目标不存在。
- 短路评估特性:一旦遍历中首次遇到相等的元素,比较过程即刻终止并返回
True。
2. 字符串中的子串匹配优化
在字符串中,sub in main_str 的功能不仅限于检查单字符,更常用于检索连续子字符串。CPython 底层对字符串的包含检查进行了深度优化(采用了结合 Boyer-Moore 与 Horspool 思想的高效字符串匹配算法),在大文本匹配场景下比朴素逐字符扫描具备更优的平均时间性能。
# 成员检查基础用例
frameworks = ["Flask", "Django", "FastAPI"]
print("Django" in frameworks)       # 输出示例: True
print("Tornado" not in frameworks)   # 输出示例: True

document = "Python sequence operations guide"
print("sequence" in document)       # 输出示例: True
print("java" in document.lower())   # 输出示例: False
如果在庞大的列表(例如包含上万条记录的 list)中,在循环体内部反复执行 if item in large_list:,算法整体复杂度会迅速退化至 $O(n^2)$。此时应在检索前将列表转换为集合(set),利用哈希表将成员判定的单次时间复杂度降低至 $O(1)$。
五、序列通用操作全景对比与速查矩阵
为了在日常开发中准确选择最合适的语法并预知其边界行为,下表与全景图对索引、切片与成员检查的核心特征进行了系统性归纳。
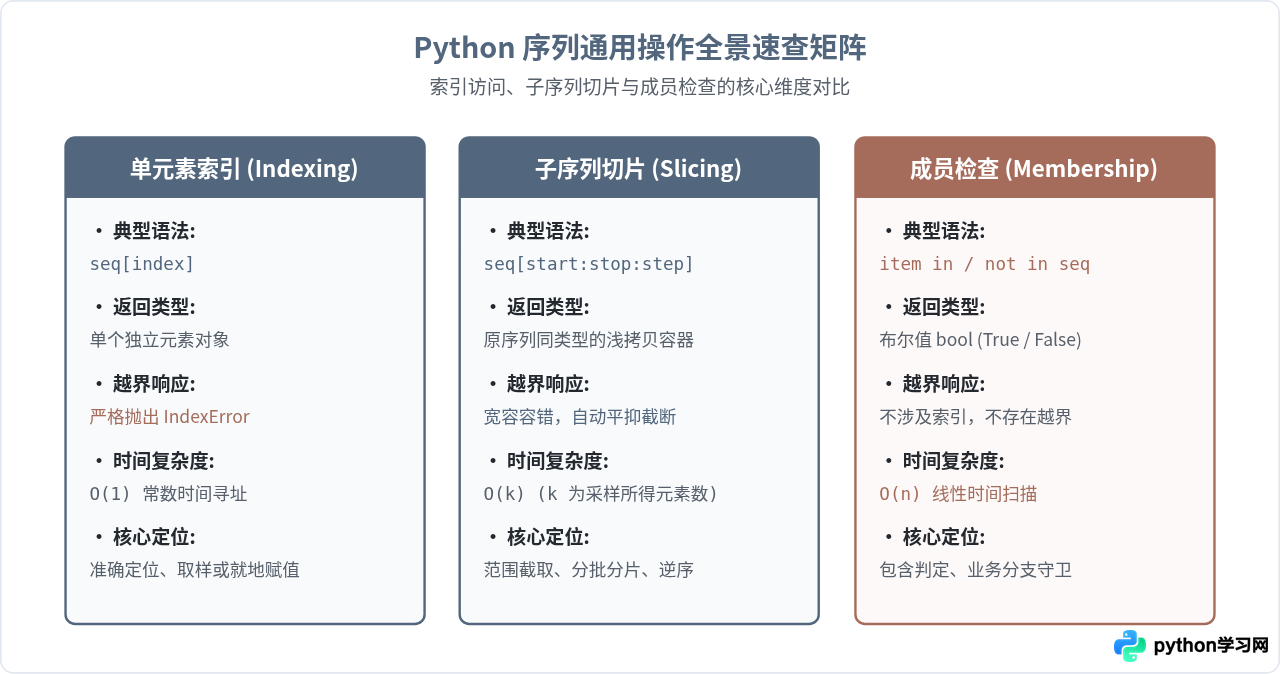
| 操作类型 | 示例语法 | 合法取值 / 条件 | 典型用途 | 关键异常 |
|---|---|---|---|---|
| 正向索引 | seq[0] |
0 <= idx < len(seq) |
按绝对位次提取首部或指定项 | IndexError |
| 反向索引 | seq[-1] |
-len(seq) <= idx <= -1 |
提取尾部或倒数项 | IndexError |
| 基本切片 | seq[start:stop] |
任何整数或 None |
前闭后开范围截取、浅拷贝容器 | 无(自动截断) |
| 步长切片 | seq[::-1] |
step != 0 |
隔位跳跃提取、序列整体逆序 | ValueError(step=0 时) |
| 成员检查 | x in seq |
元素对象或有效子串 | 分支前置有效性与包含判断 | TypeError(类型不可比时) |
六、实践总结
Python 序列的索引、切片与成员检查展现了优雅而统一的设计哲学。在工程实践中,把握以下三条原则能够有效避免常见错误:
- 防御单元素索引越界:在动态数据流中直接取
seq[i]前,先通过len(seq)判定或直接使用for循环迭代,避免引发IndexError。 - 熟练运用前闭后开区间:在进行分片批处理(如数据分页、滑动窗口采样)时,依赖
stop - start计算批量大小,并确保步长与起止方向相吻合。 - 权衡容器类型与查询性能:当序列庞大且需要频繁执行
in成员检查时,优先评估是否应引入set或dict进行哈希优化,避免低效的 $O(n)$ 线性轮询。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















