


Python并发编程工具库:threading、multiprocessing与asyncio怎么选择
详细解析Python主流并发工具库threading、multiprocessing与asyncio的核心机制、适用场景与选型判断标准,包含原理图解、代码示例及常见踩坑规避。
在 Python 中编写并发程序,核心决策依据非常明确:如果任务瓶颈在于 CPU 算力消耗(如图像压缩、大型矩阵运算、数据加密),选用 multiprocessing 绕过全局解释器锁(GIL)调用多核;如果任务瓶颈在于 海量网络 I/O 等待(如成千上万的高并发 HTTP 抓取、即时长连接推送),且代码依赖支持异步生态,优先选用 asyncio;如果面对的是 常规并发规模(数十到几百个连接)的网络或磁盘 I/O,或者重度依赖传统同步第三方库(如 requests、pymysql),选用 threading 是上手最快、改造代价最小的方案。
一、底层模型差异:它们如何处理计算与等待
理解三者选型的关键,在于看清它们各自背后的内存布局、调度方式以及与 Python GIL(全局解释器锁)的互动关系。CPython 解释器内置的 GIL 规定:在同一个进程内,任何时刻只允许一个原生系统线程执行 Python 字节码。这意味着仅依靠线程无法实现多核 CPU 上的 Python 代码真正并行。
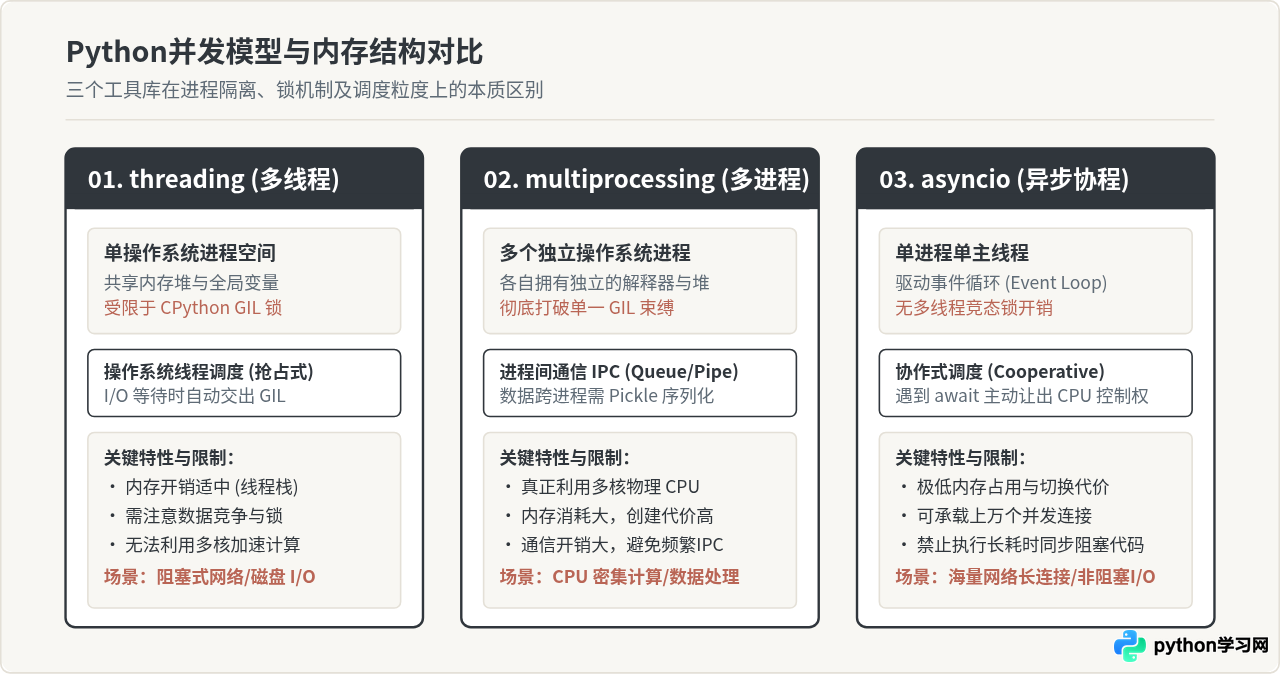
图1:Python 三大并发工具库的内存结构与底层执行机制对照
具体来看,三者的运行逻辑体现出不同的设计权衡:
threading(线程):由操作系统管理。虽然无法靠多个线程并行跑 Python 代码计算,但在进行文件读写、套接字网络收发或执行 C 扩展(如 NumPy 矩阵计算释放 GIL)时,当前线程会主动释放 GIL,从而允许其他线程继续执行。因此它能够有效掩盖 I/O 阻塞时间。multiprocessing(进程):直接启动多个独立的 Python 解释器。每个子进程都有独立的地址空间和独立的 GIL,因此能在多核机器上实现完全并行的计算。但代价是进程启动较慢,内存占用成倍增加,且跨进程交换数据需要经过 Pickle 序列化与系统 IPC 通道。asyncio(异步):完全运行在单线程内。通过底层操作系统的多路复用机制(如 Linux 的 epoll 或 macOS 的 kqueue),由单个事件循环统一监听上千个套接字的状态。当协程发起 I/O 请求时,执行await主动挂起当前任务,事件循环转而执行其他就绪任务。由于没有线程上下文切换和内核锁调度,它的并发吞吐上限极高。
二、选型决策流程:三步确定最佳工具
在工程实践中,判断该使用哪个工具,并不需要盲目追求新技术,而是通过一个逻辑严密的决策路径依次过滤。下图展示了完整的选型步骤:
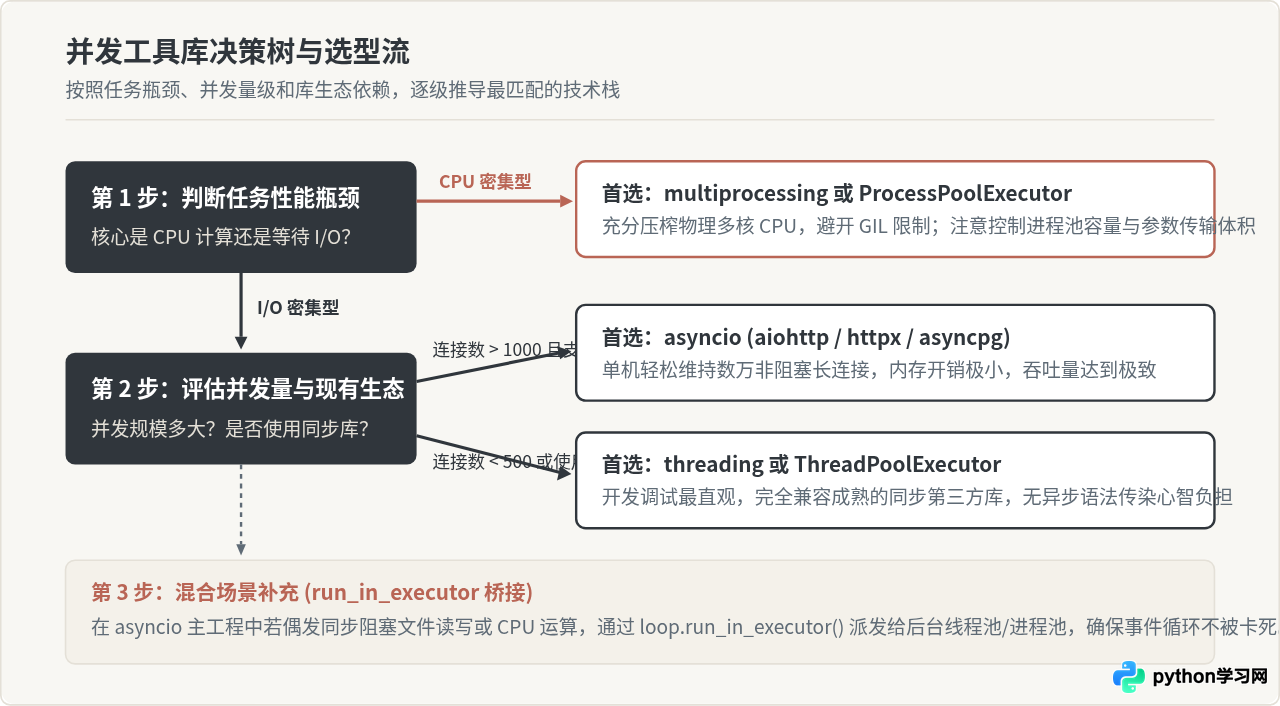
图2:根据任务瓶颈与生态环境的推导决策流
选择建议归纳:
- 第一优先判定算力瓶颈:如果不确定是否为 CPU 密集,可以在任务运行时观察系统监控。如果单个 CPU 核心持续 100% 满载,且使用多线程后总运行耗时没有显著减少甚至反向变慢,此时必须果断切到
multiprocessing。 - 第二评估生态兼容性:
asyncio具有强烈的“代码传染性”(即调用异步函数必须在异步函数中使用await)。如果你项目中使用的数据库驱动、外部 SDK 只有传统的同步阻塞版本(例如requests),强行包裹只会带来各种事件循环阻塞问题。此时使用concurrent.futures.ThreadPoolExecutor往往是工程收益最高、风险最低的选择。 - 第三评估并发数量级:线程受制于操作系统调用栈和内核调度,单机维持 500 到 1000 个线程就已接近资源瓶颈;而
asyncio的每个协程在内存中仅需几百字节,支撑单机几万个活跃网络套接字轻而易举。
三、执行时序与代码对比
为了直观观察不同并发模型在时间轴上的运转差异,我们对比它们在处理典型工作负载时的调度行为:
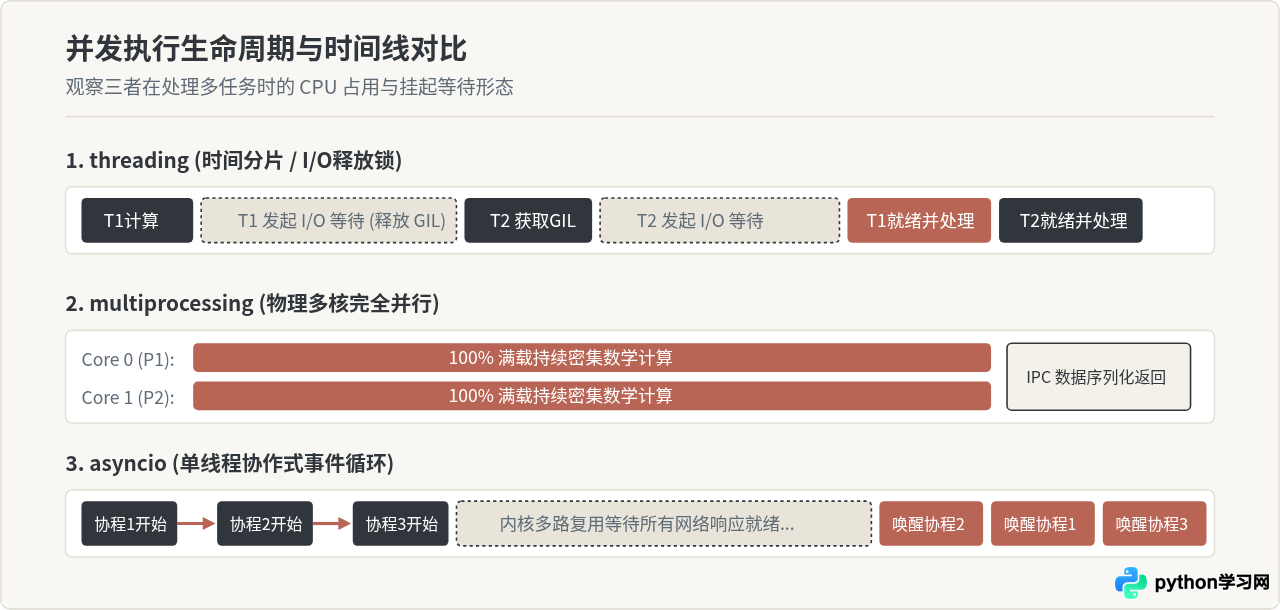
图3:三大工具库在执行任务时的时序与调度动作细部图解
1. CPU 密集型任务:multiprocessing 实现
对大数组进行哈希校验或数值积分时,使用多进程池可以线性缩短执行耗时:
from concurrent.futures import ProcessPoolExecutor
import hashlib
import os

def calculate_hash(chunk_id, data_block):
    # 纯 CPU 密集运算:多次哈希迭代
    result = data_block
    for _ in range(500000):
        result = hashlib.sha256(result).digest()
    return f"任务 {chunk_id} 由进程 {os.getpid()} 完成"

if __name__ == '__main__':
    data_list = [b"python_concurrent_data" for _ in range(8)]
    # 使用与物理核数匹配的进程池
    with ProcessPoolExecutor(max_workers=os.cpu_count()) as executor:
        futures = [executor.submit(calculate_hash, i, data) for i, data in enumerate(data_list)]
        for f in futures:
            print(f.result())
2. I/O 密集型任务:threading 与 asyncio 实现对比
针对批量并发请求 100 个 HTTP 接口的场景:
方案 A:使用 ThreadPoolExecutor(同步生态,平滑迁移)
from concurrent.futures import ThreadPoolExecutor
import urllib.request

def fetch_url(url):
    # 阻塞式网络请求,I/O 等待期间自动交出 GIL
    with urllib.request.urlopen(url, timeout=5) as response:
        return url, response.status

urls = ["https://httpbin.org/delay/1"] * 20

with ThreadPoolExecutor(max_workers=10) as executor:
    results = list(executor.map(fetch_url, urls))
    print(f"成功完成 {len(results)} 个请求")
方案 B:使用 asyncio + aiohttp(高吞吐,大规模并发)
import asyncio
import aiohttp

async def fetch_url(session, url):
    # 非阻塞网络 I/O,通过 await 挂起协程
    async with session.get(url, timeout=5) as response:
        return url, response.status

async def main():
    urls = ["https://httpbin.org/delay/1"] * 20
    async with aiohttp.ClientSession() as session:
        tasks = [asyncio.create_task(fetch_url(session, u)) for u in urls]
        # 并发聚合等待所有协程完成
        results = await asyncio.gather(*tasks)
        print(f"成功完成 {len(results)} 个异步请求")

if __name__ == '__main__':
    asyncio.run(main())
四、常见认知误区与避坑指南
误区一:只要加了多线程,Python 代码就能跑得更快?
事实并非如此。若任务本身是纯 Python 的数值计算(如对列表求和、死循环自增),加上多线程后由于 GIL 的频繁争夺与线程上下文切换,执行总耗时反而会比纯单线程更长。多线程仅在任务耗时主要由 I/O 阻塞主导时才能提速。
误区二:在 asyncio 协程里直接调用 time.sleep() 或 requests.get()?
这是编写异步程序最致命的错误。asyncio 依靠单线程运作,任何没有使用 await 的同步阻塞方法都会直接霸占整个主线程,导致事件循环中排队的其他几千个协程全部停滞。必须使用对应的异步非阻塞替代品(如 asyncio.sleep()、aiohttp 或 httpx)。
误区三:multiprocessing 创建的进程越多性能越好?
多进程创建子进程的资源开销远大于线程。进程数一般建议设置为主机的 物理 CPU 核心数(os.cpu_count())。盲目开启上百个子进程会导致频繁的进程上下文切换,且跨进程传输大对象时(如几百 MB 的列表或 DataFrame),Pickle 序列化与反序列化的时间可能直接抵消并行带来的收益。
五、全维度选型对照与总结
综合考虑资源消耗、开发成本及场景特征,下表归纳了三者的核心技术指标:
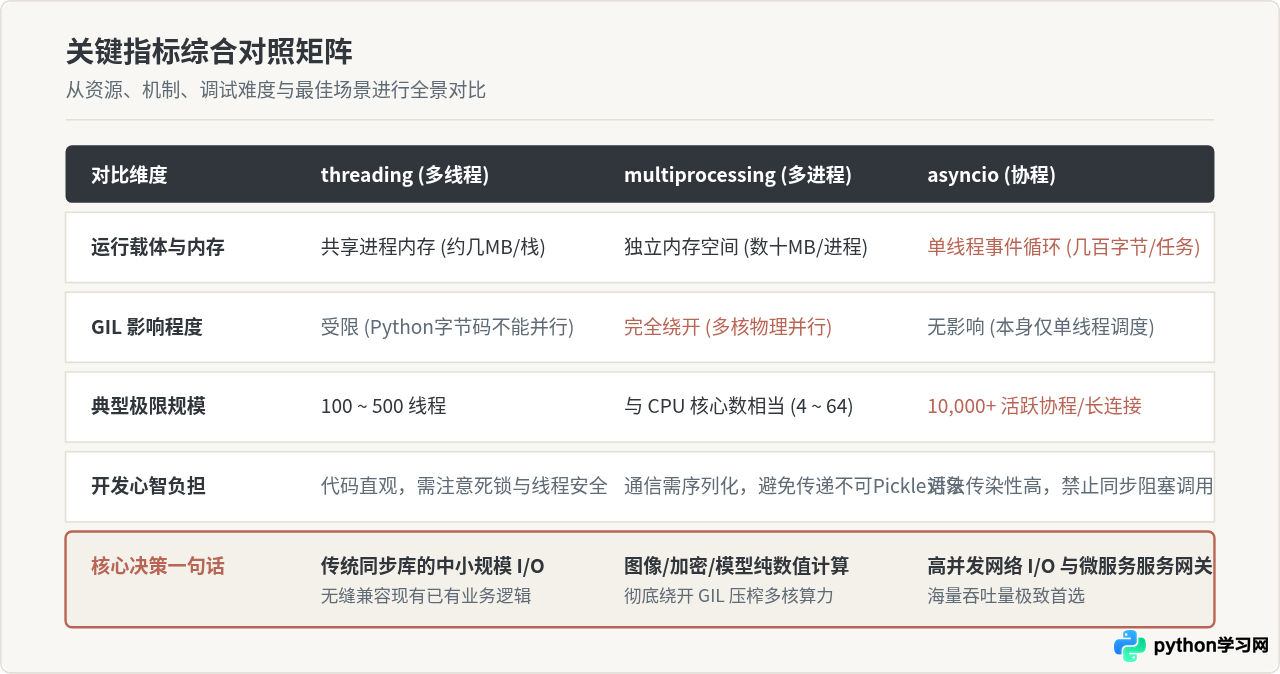
图4:Python 并发库全景综合对照总结
在日常实际开发中,推荐优先使用标准库提供的 concurrent.futures(如 ThreadPoolExecutor 和 ProcessPoolExecutor)来组织代码,它们屏蔽了底层线程和进程的生命周期管理细节,能够以统一的 submit 和 map 接口平滑切换。当任务规模扩张到单机上万连接级别、或者需要开发实时 WebSocket/SSE 广播服务时,再系统性引入 asyncio 及其全套异步生态,以获得最大的系统吞吐收益。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















