


Python列表推导式与传统for循环对比:何时更推荐使用?
深入对比Python列表推导式与传统for循环在语法语义、底层执行机制、作用域隔离及性能上的核心差异,提供清晰量化的选型决策树与工程最佳实践。
for 循环都是构造序列的常用手段。两者的核心选择依据非常明确:若核心诉求是基于现有可迭代对象,通过简洁的映射或过滤运算生成一个全新的列表,优先推荐列表推导式;若逻辑中包含复杂的业务流程控制(如异常捕获、多层分支)、多重副作用(如文件读写、日志记录)或超过两层的嵌套循环,则应坚决保留传统的 for 循环。
一、语法形态与编程范式差异
列表推导式不仅是语法糖,更代表了一种从“过程式指令”向“声明式表达”的转变。在传统的 for 循环中,程序员必须显式定义一个空的列表容器,逐步遍历数据源,手动通过条件语句过滤,并在循环体内调用 append() 方法追加元素。这个过程强调的是“怎么做”(How to do)。
而列表推导式则将这个操作归纳为一个直接表达最终结果的公式,其基本结构为 [expression for item in iterable if condition]。它强调的是“得到什么”(What to get),省略了中间容器初始化和逐步追加的机械代码。
# 传统 for 循环写法
squares = []
for x in range(10):
    if x % 2 == 0:
        squares.append(x ** 2)

# 等价的列表推导式写法
squares = [x ** 2 for x in range(10) if x % 2 == 0]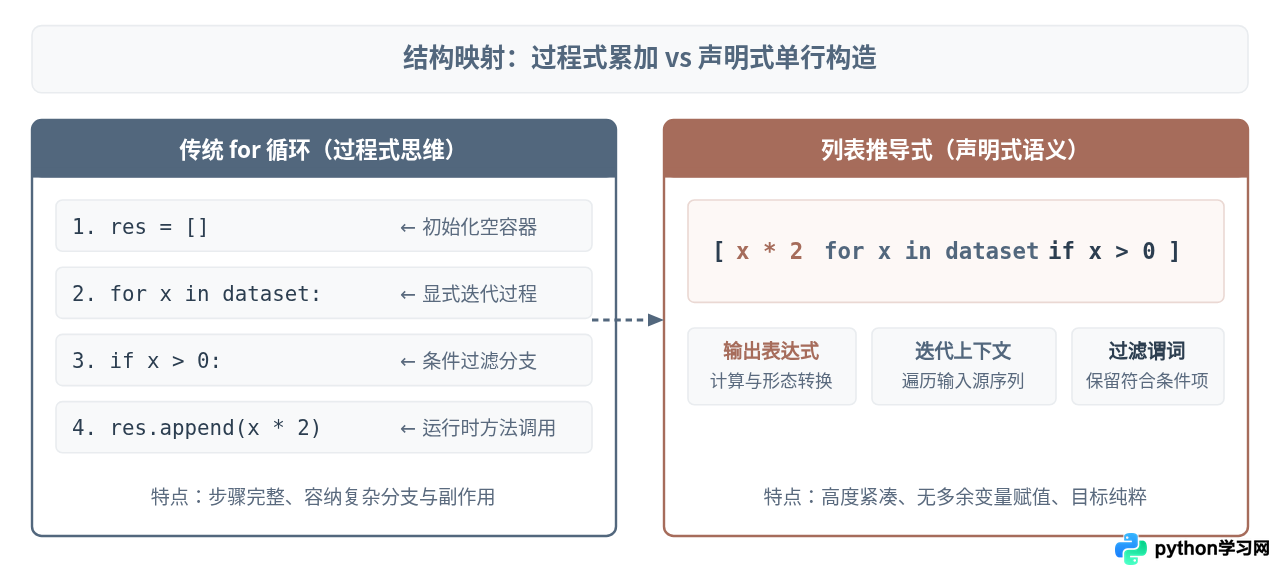
二、底层机制与执行性能剖析
在实际基准测试中,列表推导式的执行效率通常比同等逻辑的传统 for 循环高出 20% 到 35%。这种性能优势并非来自神秘黑魔法,而是 CPython 解释器在字节码生成和执行层面的优化差异。
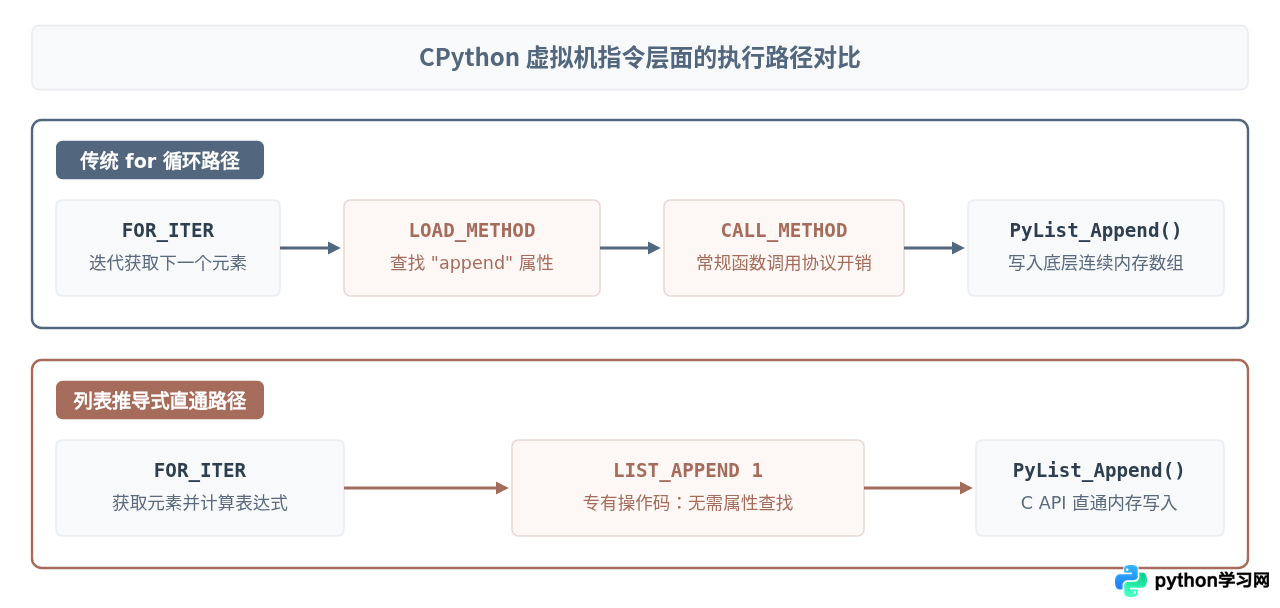
通过 Python 的 dis 模块反编译两者的字节码,可以观察到两个核心差异:
- 方法查找开销(Attribute Lookup): 在
for循环中,每次迭代都会触发LOAD_METHOD(或LOAD_ATTR)来定位列表对象的append方法,随后执行CALL_METHOD。即使在局部变量缓存了方法引用,依然存在栈帧压栈与弹栈的函数调用开销。 - 专有字节码优化: 列表推导式由解释器直接编译为专用的
LIST_APPEND操作码。该指令在 CPython 虚拟机内部直接调用 C 语言级别的PyList_Append(),绕过了方法解析与通用的函数调用机制,极大地缩短了热循环内的指令路径。
三、变量作用域安全性演进
在早期 Python 2 版本中,列表推导式存在一个臭名昭著的设计缺陷:推导式内部的循环变量会泄漏到外层作用域,导致同名变量被无意覆盖。
自 Python 3 起,这一行为得到了根本性修正。Python 3 将每个列表推导式编译为一个隐式的独立函数代码块(Code Object)。这意味着推导式内部声明的迭代变量严格限制在局部作用域内,执行完毕后立即销毁,彻底消除了变量污染的隐患。相反,传统的 for 循环至今仍会保留循环变量在外层作用域中:
# 传统 for 循环:变量泄漏
for item in [1, 2, 3]:
    pass
print(item)  # 输出 3,变量 item 依然存活在外层作用域中

# 列表推导式:局部作用域隔离(Python 3+)
[elem for elem in [1, 2, 3]]
# print(elem)  # 会引发 NameError: name 'elem' is not defined
四、更推荐使用列表推导式的典型场景
当任务满足以下特征时,列表推导式是 Pythonic 编码风格的首选实现:
- 纯粹的数据映射(1对1转换): 例如将字符串列表统一转小写、提取对象中的特定属性、进行简单的数值换算。
- 单一维度的条件过滤: 从数据集合中排除无效值、筛选特定状态的记录。
- 即时生成需要多次访问的小规模列表: 如果生成的序列较小,且需要切片、索引或反复迭代,列表推导式是最直接的表达。
# 场景示例 1:对象属性提取与清洗
raw_users = [{"id": 1, "name": " Alice "}, {"id": 2, "name": "Bob"}]
cleaned_names = [u["name"].strip() for u in raw_users if u.get("id")]

# 场景示例 2:搭配内置函数作为高效计算载体
matrix = [[1, 2, 3], [4, 5, 6]]
flat_even = [n for row in matrix for n in row if n % 2 == 0]
五、应坚决使用传统 for 循环的边界与反模式
滥用列表推导式是 Python 开发中最容易引起维护噩梦的反模式之一。遇到以下情况时,必须放弃推导式,回归传统的 for 循环:
1. 仅为产生副作用(Side Effects)而执行迭代
列表推导式的核心使命是构建并返回一个新列表。如果循环的目的只是打印输出、写入数据库、发起网络请求或修改外部全局状态,使用推导式会凭空创建一个包含大量无意义 None 的临时列表,不仅造成内存浪费,更严重违背代码可读性原则。
# 错误反模式:为了副作用使用推导式
[print(user.name) for user in users]  # 生成了无意义的 [None, None, ...] 列表

# 正确做法:显式 for 循环清晰表达动作
for user in users:
    print(user.name)
2. 包含异常处理(try-except)或流程跳转
列表推导式语法规范不允许在表达式内部直接使用 try...except 语句,也不支持 break 或 continue。强行在推导式中通过封装 lambda 函数或黑魔法实现异常捕获,会使代码难以阅读和维护。
3. 超过两层的嵌套循环与多条件交织
虽然语法允许编写类似 [x for a in A for b in B for x in C] 的三重嵌套,但这类代码极难在脑海中建立思维模型。排版规范通常建议:一旦推导式单行长度超过 80 字符,或包含多于一个 for 语句,就应重构为多行缩进的 for 循环。
六、选型决策指南
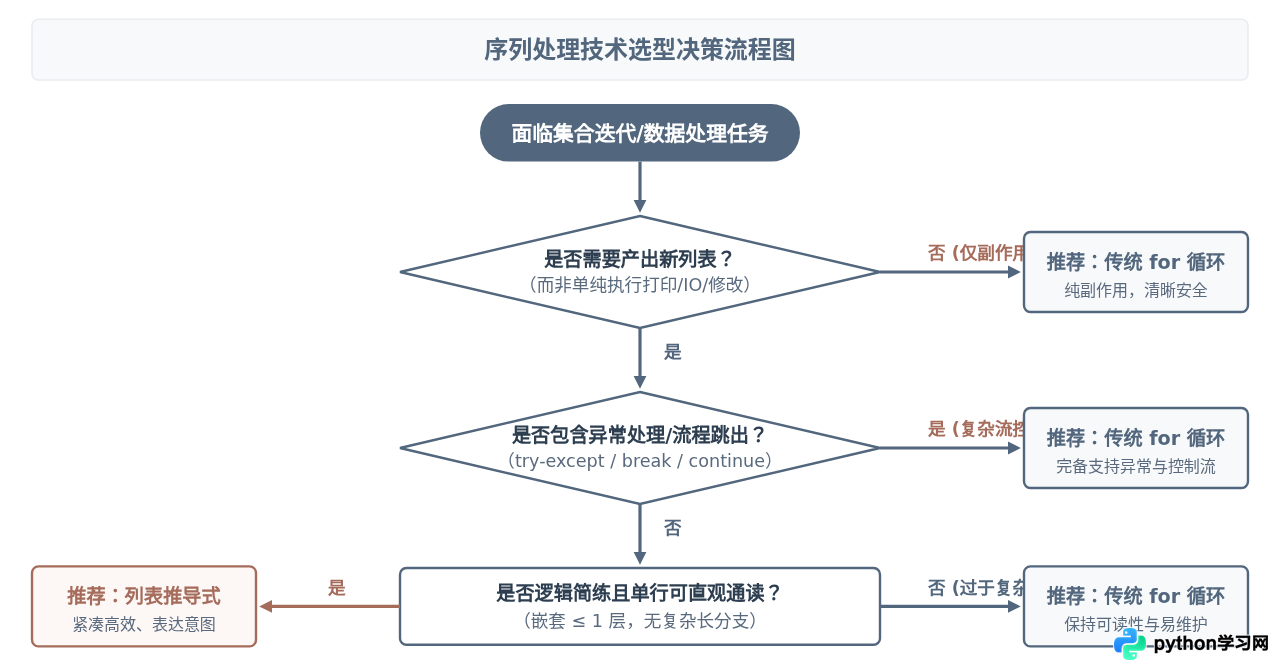
面对具体业务场景时,可以通过下面的逻辑判定路径快速确定最佳方案:
七、多维度特性横向对比与总结
为了帮助团队建立一致的编码规范,下表梳理了两种语法在日常开发中最关心的核心指标差异:
| 评估维度 | 列表推导式 (List Comprehension) | 传统 for 循环 (for Loop) |
|---|---|---|
| 设计意图 | 专注于转换、过滤并输出新列表(表达式) | 执行通用的连续逻辑与控制流(语句块) |
| 代码体量 | 极低,通常单行解决 | 较高,需初始化、迭代及显式追加 |
| 底层执行效率 | 高(CPython 专有 LIST_APPEND 指令优化) |
常规(每次迭代需属性查找与方法调用) |
| 作用域行为 | 独立作用域(Python 3+ 不泄漏循环变量) | 共享外层作用域(循环变量在外层残留) |
| 复杂逻辑承载 | 极差(不支持 try-except、break、continue) | 极佳(支持任意 Python 语法与控制结构) |
| 断点调试便利性 | 低(难以在表达式中间单步追踪状态) | 高(可在任意循环步骤设置断点与日志) |
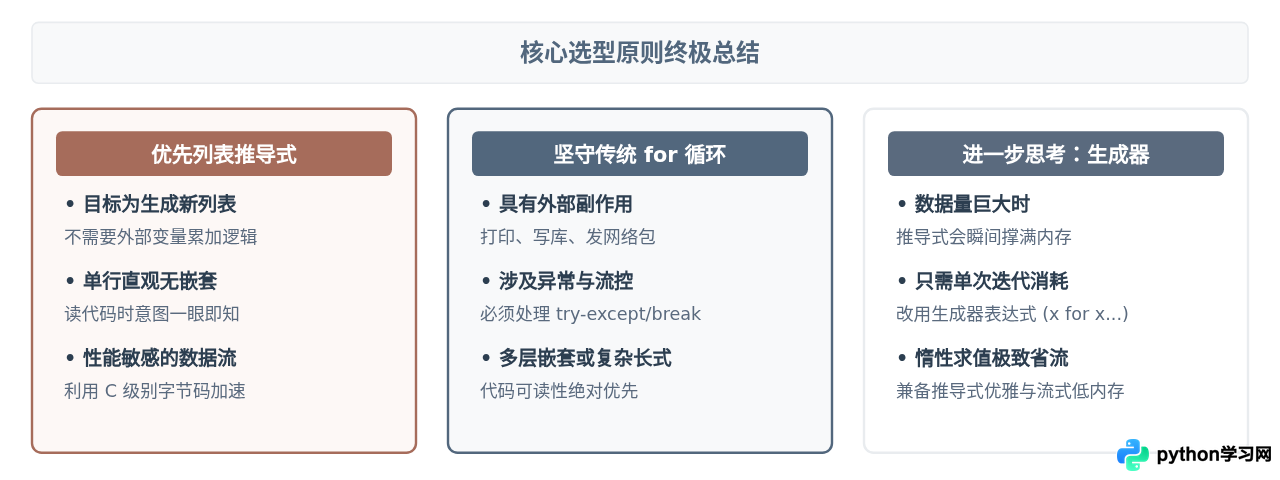
掌握两者的分界线,关键在于对“代码意图”的敏锐感知。当你希望读者将精力聚焦在“产生的结果列表”上时,使用列表推导式;当你希望读者看清“每一步骤的逻辑推进与异常拦截”时,使用传统的 for 循环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















