


pip和conda有什么区别?Python包管理工具选择建议
深入对比 pip 与 conda 的核心差异,涵盖包管理机制、环境隔离原理、底层依赖解析与实操工作流,并提供针对 Web 开发、数据分析与深度学习的明确选型建议及避坑指南。
很多 Python 开发者在配置开发环境时,常常对选择 pip 还是 conda 感到困惑。简而言之:pip 是专属于 Python 语言的包管理器,专注于从 PyPI 下载与安装 Python 模块,环境隔离需配合 venv 或 virtualenv;而 conda 是跨语言的通用包管理器与虚拟环境管理器,不仅能管理 Python 库,还能独立安装 Python 解释器本身以及 CUDA、OpenBLAS、C/C++ 动态链接库等底层二进制依赖。如果你从事纯 Web 开发、微服务或轻量自动化,选择 pip + venv 最轻巧灵活;若涉及深度学习、数据科学或需频繁处理复杂 C/C++ 依赖,conda 则是省去编译配置成本的利器。
定位与架构差异:为什么两者不是简单的替代关系
理解两者的差异,首先要看它们在软件栈中所处的位置。很多人误以为 conda 只是 pip 的“升级版”或“图形版”,这种看法并不准确。它们从设计之初就服务于不同的技术生态。
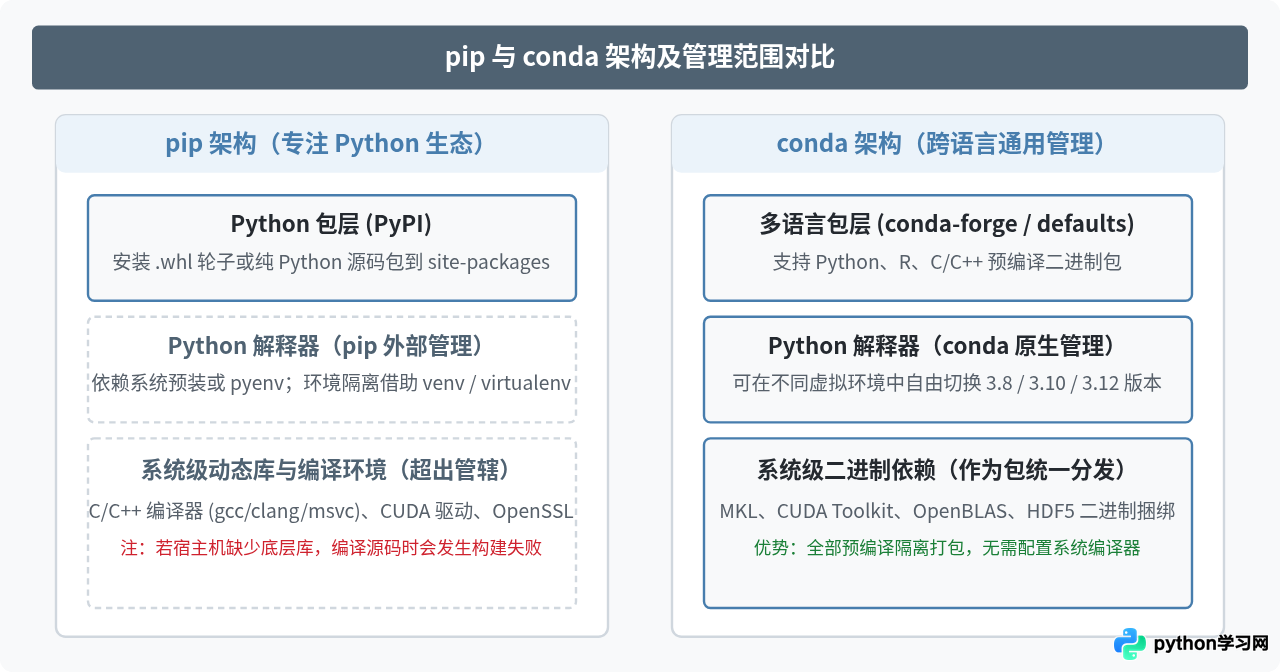
pip 的全称是“Pip Installs Packages”,它是 Python 官方推荐的包分发与安装工具。pip 直接与官方索引库 PyPI(Python Package Index)对接。当你在终端运行 pip install 时,pip 寻找的是预编译的 Wheel 文件(.whl)或源码分发包(.tar.gz)。如果某个 Python 扩展模块是用 C/C++ 编写的,且 PyPI 上没有对应操作系统的二进制 Wheel,pip 就会在本地尝试调用系统的编译工具链(如 gcc 或 MSVC)进行即时编译。如果宿主机缺少头文件或依赖的动态链接库,安装就会直接中断报错。
conda 则诞生于科学计算领域。科学计算(如 NumPy、SciPy、PyTorch、GDAL)严重依赖底层 C/C++、Fortran 基础库以及硬件加速支持(例如 Intel MKL 线性代数库、NVIDIA CUDA Toolkit)。如果每个开发者都去自己编译这些底层库,配置成本极高。因此,Anaconda 团队将 Python 解释器、科学计算库以及所有底层的二进制依赖全部打包成预编译二进制文件,统一放在 conda 的仓库(如 defaults、conda-forge)中供用户按需获取。
关键维度对比:机制、环境与依赖解析
为了让选择依据更加清晰,我们可以从以下几个关键维度展开对比:
| 对比维度 | pip | conda |
|---|---|---|
| 本质定位 | Python 官方语言级包管理器 | 跨语言的二进制包管理器 + 环境管理器 |
| 默认仓库 | PyPI(包含最新、最全的第三方 Python 库) | defaults(Anaconda 官方)或 conda-forge(社区维护) |
| 安装产物类型 | Wheel(.whl)或源码(.tar.gz) |
预编译二进制包(.tar.bz2 或 .conda) |
| 虚拟环境管理 | 不具备环境管理能力,需结合 venv 模块 |
原生内置(conda create / conda activate) |
| Python 版本切换 | 无法安装 Python 解释器本身,依赖系统已装环境 | 可在创建环境时指定任意支持的 Python 版本 |
| 依赖解析方式 | 新版 pip(20.3+)引入严格解析,但仅限于 Python 包内部 | 采用基于 SAT 求解器的全局依赖解析,覆盖底层动态库 |
| 磁盘与占用 | 轻量,每个虚拟环境拷贝或软链接少量引导文件 | 体量较大,包含独立的二进制工具链与依赖库 |
依赖解析与构建机制的深层差异
很多开发者在安装大型库时遇到过“为什么用 pip 装报错,用 conda 装却直接成功”的情况。这背后的核心在于依赖解析与分发机制。
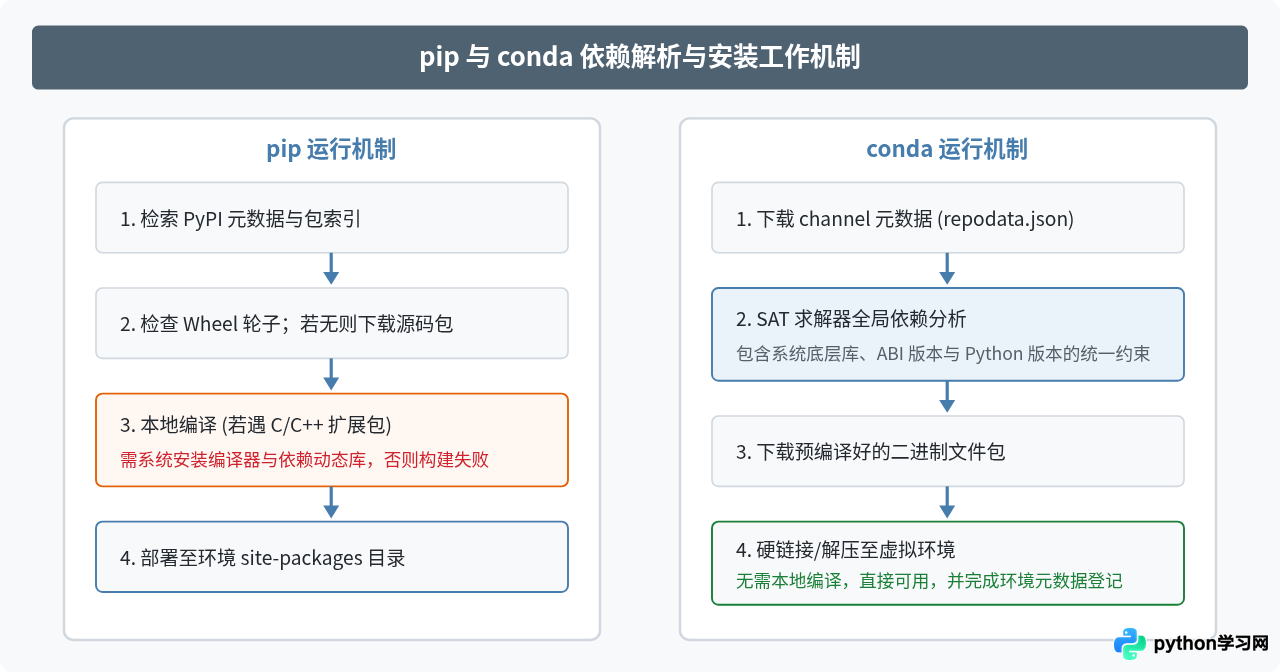
在 pip 机制下,如果一个包发布在 PyPI 上并且需要调用 C 代码,作者通常会提供对应主要操作系统版本的编译好的 Wheel。然而,如果你的操作系统、Python 次版本或 CPU 架构较新(例如刚发布的 Python 版本或特定的 ARM 架构),PyPI 上可能只有源码包。此时 pip 就会在本地尝试编译。如果你的系统没有配置 C++ 编译器(如 Windows 下缺少 Visual C++ Build Tools,或 Linux 缺少 build-essential),安装流程就会直接中断。
而在 conda 机制下,所有的包都是经过统一构建系统打包的二进制文件。conda 使用专门的布尔可满足性(SAT)求解器,在安装前对目标环境中已有的全部软件、底层 ABI、C 运行时库以及目标包的版本约束进行全局统筹计算。一旦找到可行解,直接下载预编译二进制文件并硬链接或解压到对应环境目录,彻底绕过了本地编译环节。
实操对比:常用工作流与命令速查
为了直观感受两者的日常使用差异,我们来看两种方案从零创建项目环境的典型命令流程。
方案 A:标准 pip + venv 工作流
在现代 Python 开发中,通常不建议直接在全局系统环境中运行 pip,而是使用标准库自带的 venv 创建隔离环境:
# 1. 在当前项目目录下创建虚拟环境 (.venv)
python3 -m venv .venv

# 2. 激活虚拟环境 (macOS / Linux)
source .venv/bin/activate
# Windows PowerShell 下为: .venv\Scripts\Activate.ps1

# 3. 安装依赖包
pip install requests flask

# 4. 导出依赖清单
pip freeze > requirements.txt

# 5. 在新机器上复现安装
pip install -r requirements.txt
pip freeze 会导出当前环境中所有已安装包的精确版本。如果项目中引入了多个包的传递依赖,导出的列表会比较长。在大型项目中,也可以使用 pip-tools(如 pip-compile)将直接依赖与锁定的间接依赖清晰区分。
方案 B:标准 conda 工作流
conda 原生管理环境,在创建环境时可以直接指定所需的 Python 版本:
# 1. 创建指定 Python 版本的独立环境
conda create -n my_project python=3.10 -y

# 2. 激活环境
conda activate my_project

# 3. 从 conda-forge 安装科学计算库
conda install -c conda-forge numpy pandas scikit-learn -y

# 4. 导出完整环境配置文件 (包含 Python 版本与底层依赖)
conda env export > environment.yml

# 5. 在新机器上复现环境
conda env create -f environment.yml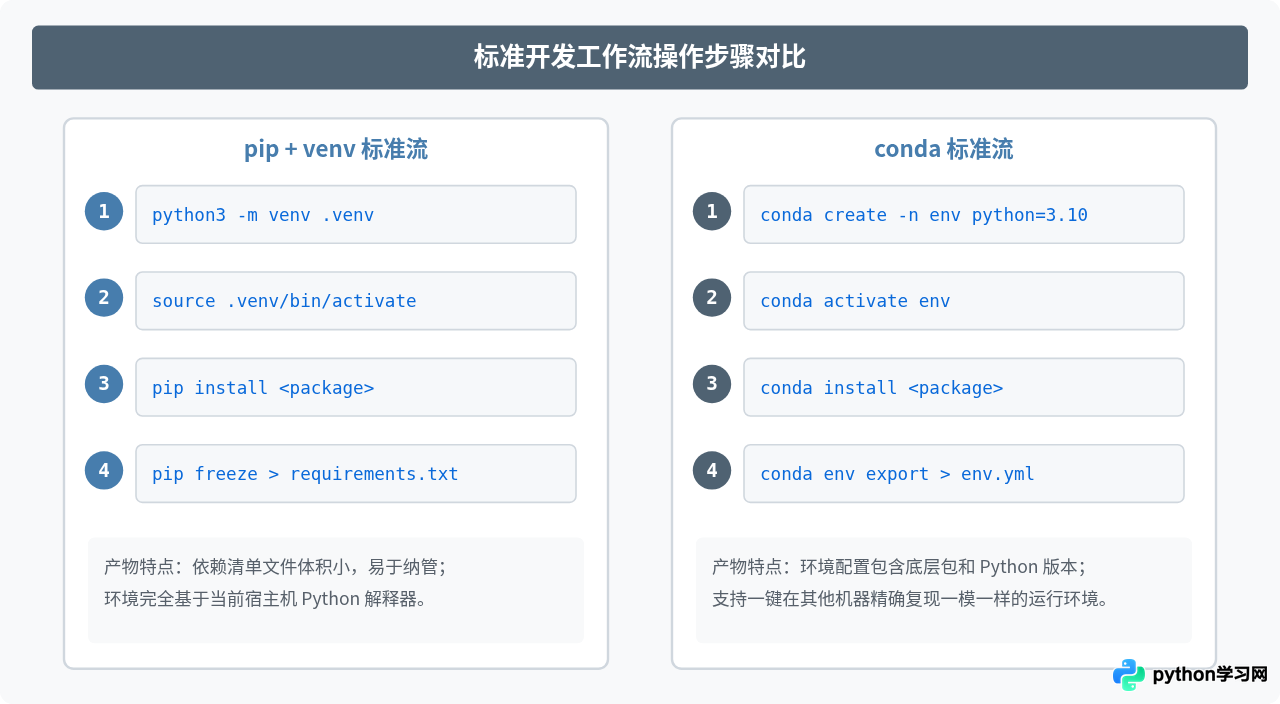
混用场景与避坑指南
在实际开发中,经常会遇到这样的问题:“在 conda 环境中,某些小众的包在 conda-forge 里找不到,我可以接着用 pip 安装吗?”
答案是:可以混用,但必须遵守严格的先后次序与隔离规则。
conda 虽然具备强大的二进制管理能力,但由于其官方与社区收录包的速度天然慢于 PyPI,PyPI 上拥有最及时的纯 Python 库。在 conda 环境中运行 pip 是完全支持的,因为 conda 环境本身就是一个完整的 Python 运行树。但是,由于 pip 并不感知 conda 的元数据依赖图谱,一旦混用顺序不当,就极易破坏 conda 环境的依赖平衡。
混用三原则
- 先 conda,后 pip:在创建环境后,务必先用
conda install装完所有主要的科学计算库、数据分析框架以及底层有 C 依赖的大型模块(如 PyTorch、TensorFlow、NumPy、OpenCV),最后才使用pip install补充安装那些仅存在于 PyPI 上的纯 Python 包。 - pip 安装后,不要再对该环境执行 conda update:一旦你用 pip 安装了包,pip 可能会覆盖掉某些 conda 已经安好的依赖文件。如果此时你再运行
conda update --all或使用 conda 安装新包,conda 的求解器可能会发现部分文件与元数据不一致,进而引发未定义的冲突。 - 使用独立隔离环境,避免污染 base 环境:无论使用 pip 还是 conda,都严禁在 conda 的
base环境下直接混用 pip。一旦 base 环境损坏,修复往往需要重装整套 conda。始终为每一个项目创建独立的 named environment。
场景化选型建议与总结
在选择具体工具时,不需要追求“唯一正确答案”,而应根据当前项目的开发目标、依赖复杂度以及部署场景来确定最优解:
场景 1:Web 后端开发、微服务与 Docker 容器化(首选 pip + venv)
如果你主要从事 Django、FastAPI、Flask 开发,或者编写自动化爬虫脚本并准备打包为 Docker 容器,请优先使用 pip + venv(或者现代升级方案 Poetry、uv)。这些项目中的依赖绝大多数是纯 Python 包或已拥有成熟 manylinux Wheel 的标准包。使用 pip 构建的容器镜像只有几十到几百兆,拉取和构建速度极快。若在容器中引入体积庞大的 Anaconda/Miniconda,会带来不必要的镜像冗余。
场景 2:数据科学、机器学习与 GPU 深度学习(首选 conda / micromamba)
如果你在本地进行深度学习模型训练、处理地理信息数据(GIS)或者需要频繁调用 CUDA 和 C++ 科学计算库,conda 绝对是首选方案。它能为你省去安装 NVIDIA CUDA Toolkit、配置 cuDNN 路径以及处理系统动态链接库冲突的大量繁琐时间。针对 conda 原生解析速度稍慢的问题,建议优先使用轻量且用 C++ 重写的替代客户端 micromamba 或配置 libmamba 求解器,解析速度会有质的飞跃。
场景 3:本地单机多版本 Python 维护(灵活搭配)
如果你既需要维护老旧的 Python 3.8 项目,又想在新项目中体验 Python 3.12 的新特性,使用 conda create -n py38 python=3.8 可以在几秒钟内获得干净的指定版本解释器;如果你更喜欢轻量工具流,也可以使用 pyenv 管理 Python 解释器版本,再配合 venv + pip 开展开发。
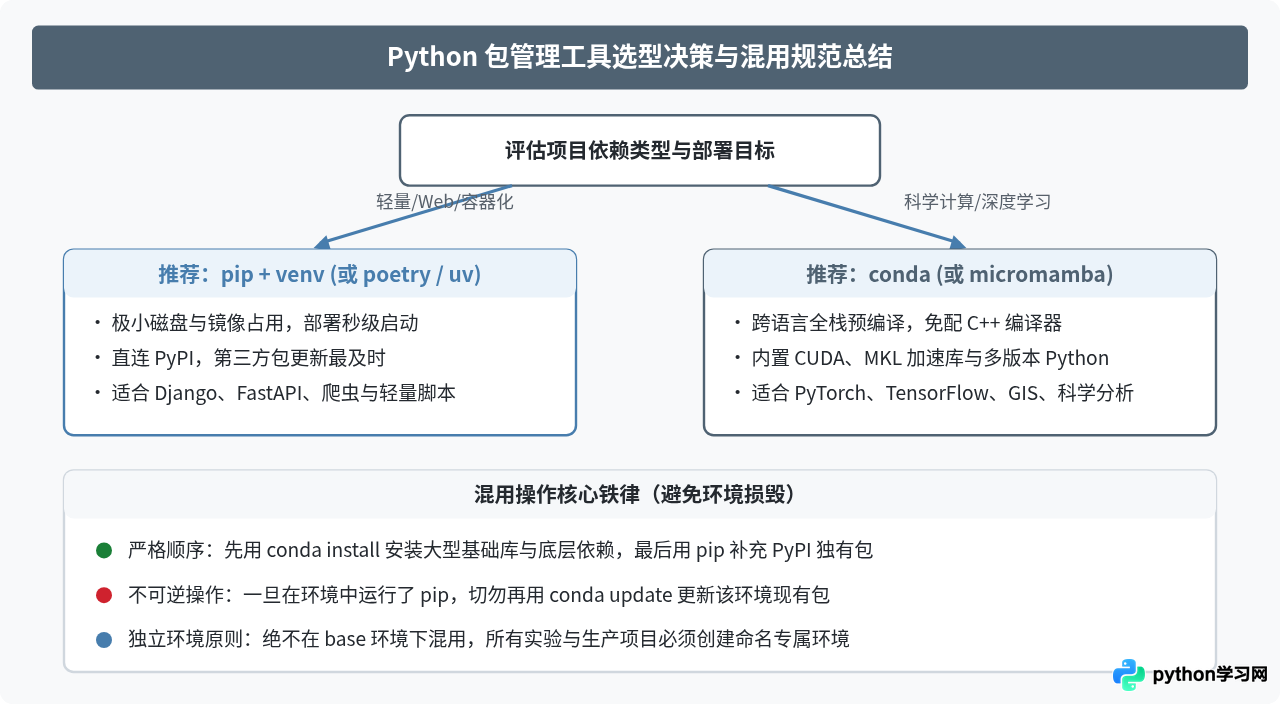
归结起来,pip 与 conda 各司其职:pip 是 Python 语言生态的标准工具,专注、轻巧且生态最新;conda 则是面向系统与科学计算的集成式管理者,稳健、全能且屏蔽了底层异构环境的复杂性。看清项目的本质需求,合理选择工具或规范混用,是构建高效、稳定 Python 开发流程的第一步。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















