


为什么Python官方不建议使用os.linesep写入文件
深入剖析为什么Python官方明确禁止在文本模式下使用os.linesep写入文件。详解通用换行符转换机制、Windows系统下双重回车(\r\r\n)的底层成因与标准文本写入最佳实践。
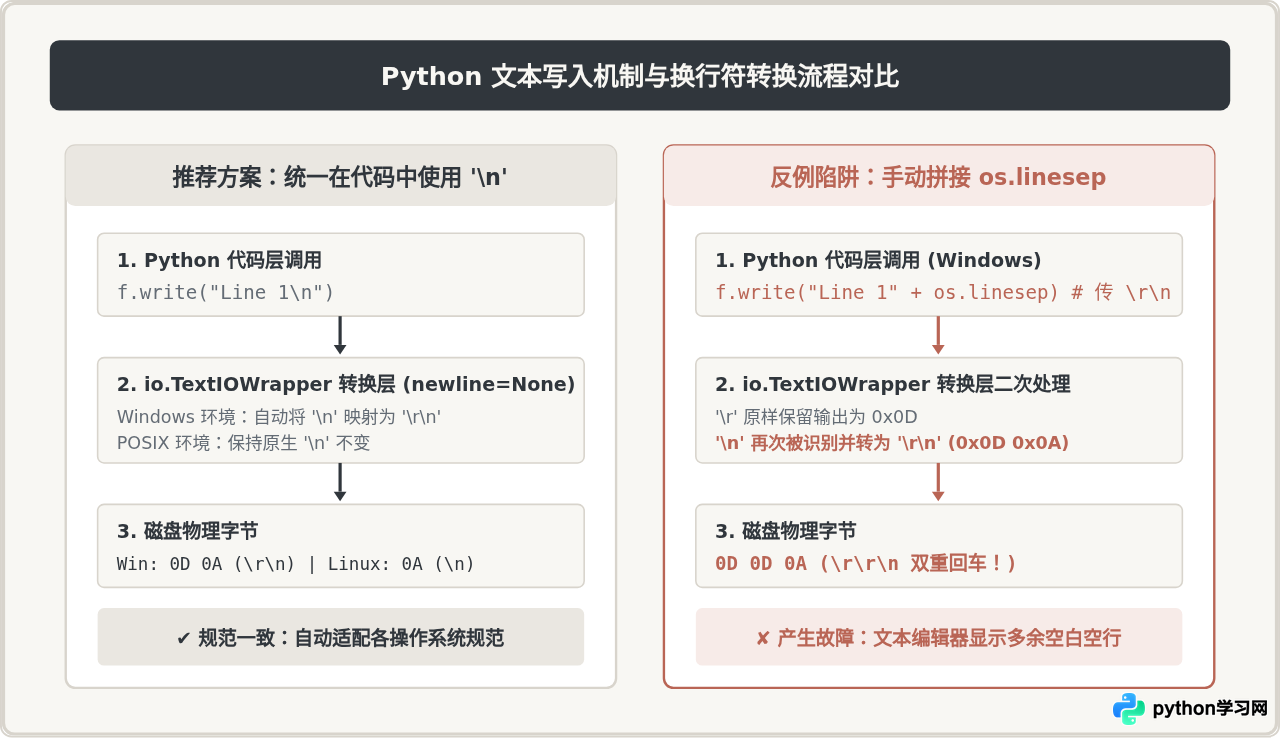
os.linesep 的说明中,有一条非常醒目的警示:“写入以文本模式打开的文件时,不要使用 os.linesep 作为换行符;请在所有平台上统一使用单个 '\n'”。核心原因在于:Python 文本流默认启用了通用换行符转换机制(Universal Newlines)。在 Windows 平台上,如果开发者手动拼接了 os.linesep(即 \r\n),底层 I/O 层会将末尾的 \n 再次转译为 \r\n,最终向磁盘写入恶劣的 \r\r\n(双重回车),导致文件格式损坏或在编辑器中产生多余的空行。
一、文档警告:直觉与底层机制的偏差
初学者在编写跨平台代码时,很容易产生一种自然的推理:既然 Windows 的换行符是 \r\n,Linux 和 macOS 的换行符是 \n,而标准库提供了 os.linesep 返回当前操作系统的原生换行字符串,那么写入文件时使用 os.linesep 一定是最标准、最兼容的做法。
然而,这种看似稳妥的直觉恰恰与 Python 内置的文本 I/O 抽象层发生了正面冲突。Python 官方文档在 os 模块中明确指出:
“Do not use os.linesep as a line terminator when writing files opened in text mode (the default); use a single '\n' instead, on all platforms.”
(在写入以文本模式打开的文件时,不要使用 os.linesep 作为行终止符;在所有平台上请统一使用单个 '\n'。)
为什么官方会制定如此强硬的规则?关键就在于 Python 的标准文件操作并非直接把字符原封不动倾倒至磁盘,而是由 io.TextIOWrapper 进行自动的换行符转换。
二、深入底层:双重回车(\r\r\n)的生成机理
为了透彻理解为什么会产生多余的回车符,我们需要观察 Python 3 的 I/O 层次结构。
当我们使用默认语法 open("data.txt", "w") 打开文件时,返回的是一个由 io.TextIOWrapper 封装的文本流。该类负责在 Unicode 字符串与底层二进制字节之间进行编解码,并执行换行符转换。
在默认情况下(即 newline=None),写入文本的规则是:输入流中的所有 '\n' 字符都会被自动替换为系统的默认换行符(由 os.linesep 决定)。
- 在 Linux 或 macOS 上,系统的原生换行符是
'\n'。因此,传入'\n'会被映射为'\n'。如果写入os.linesep,由于其值恰好也是'\n',转换后依然是'\n'。因此在 POSIX 环境下测试时,程序看似“毫无问题”。 - 在 Windows 上,系统原生换行符是
'\r\n'。此时如果开发者写下f.write("text" + os.linesep),实际传递给TextIOWrapper的字符串末尾就是\r\n。
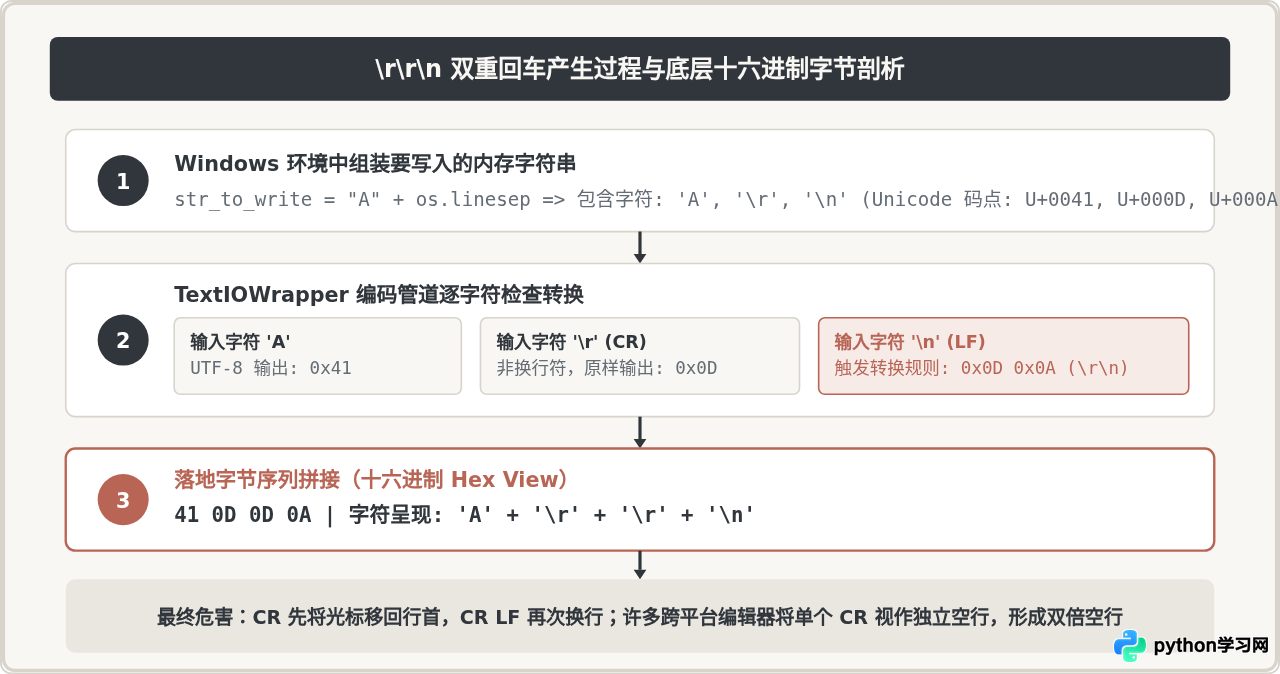
此时,TextIOWrapper 逐字符扫描:首先遇到 \r(回车符,ASCII 码 0x0D),它不是逻辑换行符 \n,因此被原封不动地写出;随后遇到 \n(换行符,ASCII 码 0x0A),触发了平台的转换规则,将该字符转为 Windows 平台默认的 \r\n(0x0D 0x0A)。
两者拼接后,实际落盘的字节序列就变成了 0x0D 0x0D 0x0A,即 \r\r\n。
实测代码验证:观察真实字节
我们可以通过一段简短的脚本,用二进制模式读取刚才写出的文件,查看底层落盘情况:
import os

# 模拟错误做法:在文本模式下写入 os.linesep
with open("bad_output.txt", "w", encoding="utf-8") as f:
    f.write("第一行" + os.linesep)
    f.write("第二行" + os.linesep)

# 使用二进制模式 'rb' 读取真实字节
with open("bad_output.txt", "rb") as f:
    content = f.read()
    print("实际落盘字节:", content)

# 在 Windows 平台上的输出结果示例:
# 实际落盘字节: b'\xe7\xac\xac\xe4\xb8\x80\xe8\xa1\x8c\r\r\n\xe7\xac\xac\xe4\xba\x8c\xe8\xa1\x8c\r\r\n'
# 注意末尾出现的连续两个 \r (\r\r\n)
如果将生成的 bad_output.txt 传输到 Linux 服务器或使用对换行符严格敏感的工具(例如某些 CSV 解析器、Git 差异工具或老版本 C 库),该文件就会被判定为格式畸形。在 Linux 终端下用 cat -A 查看时,行末会显式暴露出难看的 ^M^M$ 字符。
三、核心机制:详解 open() 的 newline 参数
既然不能使用 os.linesep,Python 是如何实现灵活控制换行符的?答案就在内置函数 open() 的 newline 参数中。
open() 在处理文本时,读模式和写模式下的 newline 表现有所不同。对于写入模式,newline 参数的具体行为如下表所示:
| newline 取值 | 代码中写入 '\n' 时的翻译行为 | 适用典型场景 |
|---|---|---|
None(默认值) |
自动将代码中的 '\n' 转换为当前系统的默认换行符(Windows 为 \r\n,Linux 为 \n)。 |
绝大多数日常文本文件、日志输出。开发者只需写 '\n',跨平台自动适配。 |
''(空字符串) |
不执行任何转换。代码中写什么字符,磁盘就收到什么字符。 | 使用 csv 模块读写表格数据时的官方强制要求。 |
'\n' |
不执行转换。强制将行终止符统一为 POSIX 规范的换行符 \n。 |
在 Windows 上生成必须运行于 Linux 容器或跨平台 Git 仓库的代码/配置文件。 |
'\r\n' |
强制转换为 Windows 格式。将代码中的 '\n' 统统替换为 \r\n。 |
在 Linux/Mac 上生成必须供 Windows 专有旧系统读取的批处理或文本文件。 |
典型场景:为什么标准库 CSV 写入必须指定 newline=''
理解了上述转换原理后,就能彻底明白 Python csv 模块的经典报错问题。
根据官方推荐,写入 CSV 文件时必须使用:
import csv

# 正确规范:必须显式传入 newline=""
with open("records.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerow(["ID", "Name", "Score"])
    writer.writerow([101, "Alice", 95])
这是因为按照 CSV 的国际标准 RFC 4180 规定,每行记录必须严格以 \r\n 结束。因此,csv.writer 在内部组装数据时,已经自带了 \r\n。如果开发者打开文件时省略了 newline=""(使用了默认的 newline=None),外层的 TextIOWrapper 在 Windows 上就会将 csv.writer 输出的 \r\n 再次转译为 \r\r\n。这就是为什么无数初学者在 Windows 下写出来的 CSV 文件每隔一行就会凭空多出一个空白行。
四、边界澄清:什么时候才需要使用 os.linesep?
既然在写入普通文本文件时 os.linesep 没有任何正面作用,标准库为什么还要保留这个属性?它真正的使用场景是什么?
os.linesep 的本质只是一个环境变量级别的常量定义,它反映了底层操作系统的原生惯例:
- 在 POSIX 兼容系统(Linux、macOS、FreeBSD)上,其值为
'\n'; - 在 Windows 系统上,其值为
'\r\n'。
它的合理适用场景仅限于非文件流的系统层交互:
- 底层进程通信(IPC)与管道:通过
subprocess向一个原生的 Windows 命令行程序传递标准输入参数,且该程序底层用 C 语言裸写、要求严格匹配原生回车格式时; - 原始协议报文解析:在特定网络套接字或自定义报文通信中,需要根据宿主系统特性进行原始字符比对;
- 文本解析时的备用参考:虽然对于字符串分割,Python 官方更推荐使用自动识别所有换行符的
str.splitlines(),但某些特定校验工具可能会读取os.linesep作为当前系统的参考指纹。
五、总结:工程避坑清单
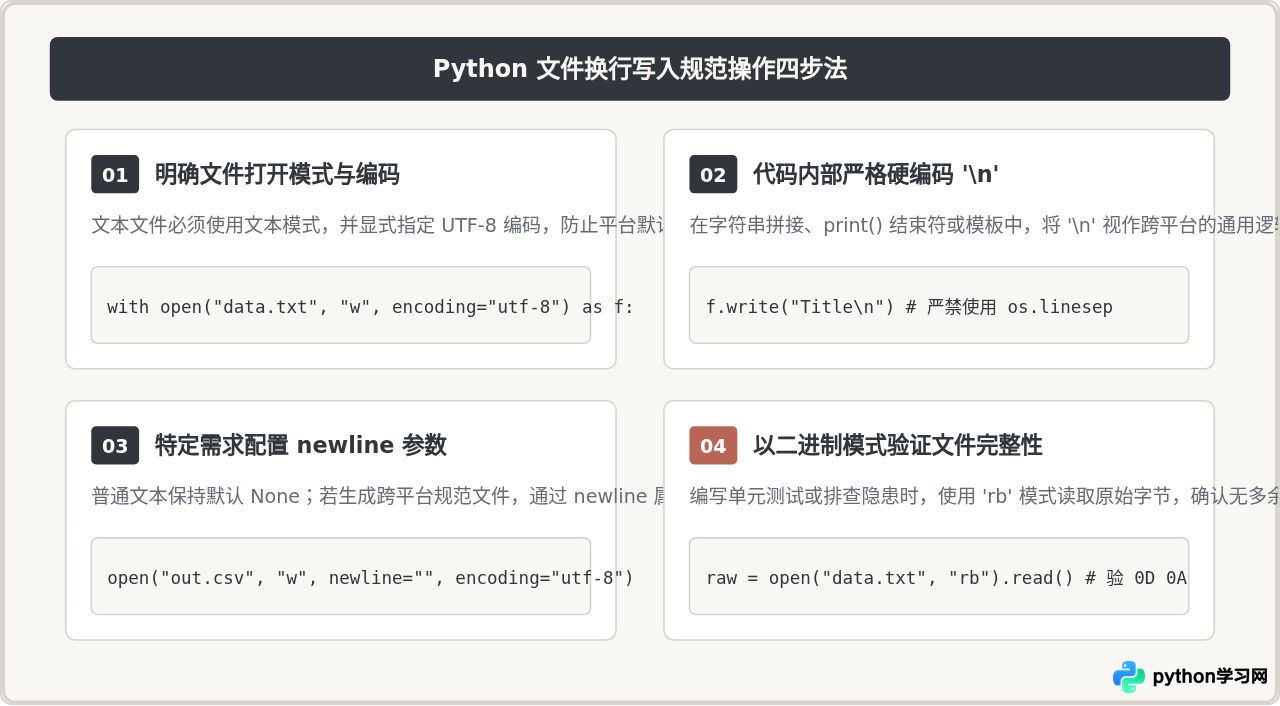
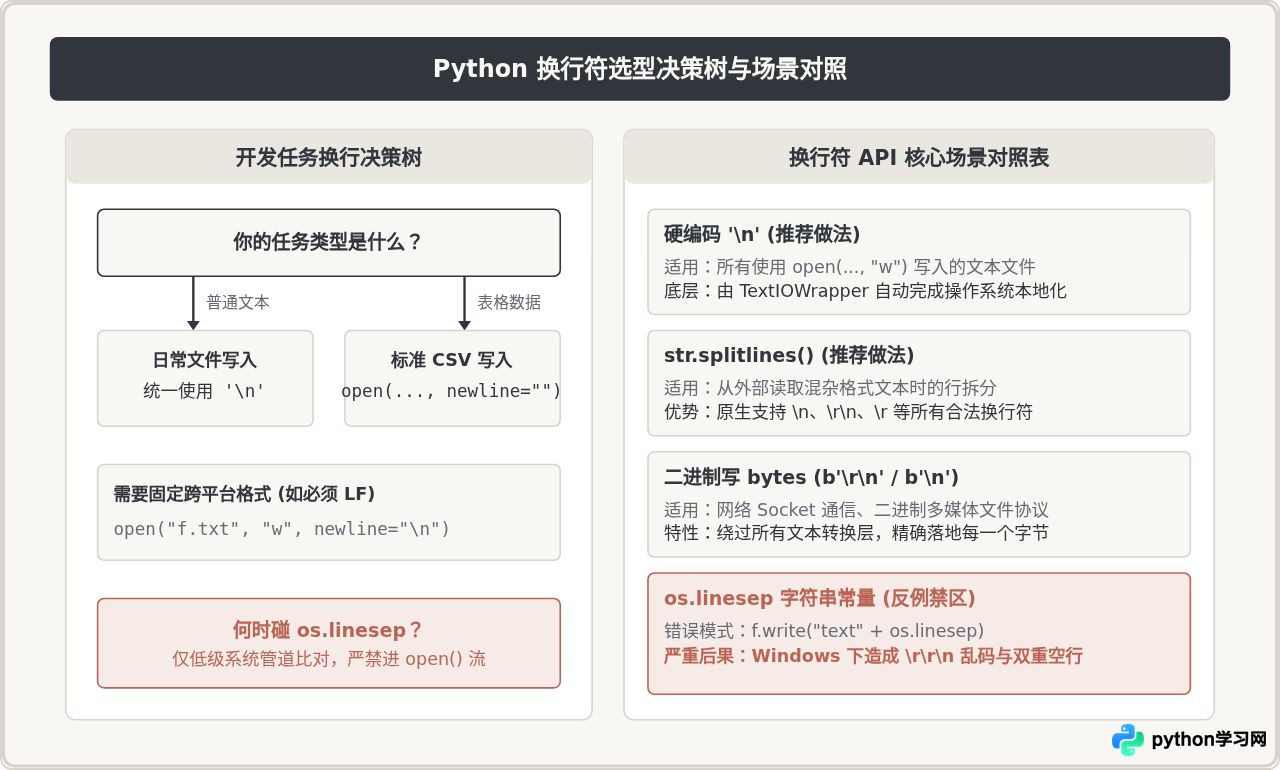
归纳起来,处理 Python 文件写入与换行符问题时,只需牢记以下四项确定性准则:
- 文本写入只认
'\n':无论你的代码运行在 Windows、Linux 还是 macOS 上,只要以默认文本模式写入文件,字符串末尾一律使用'\n'。跨平台兼容性是 Python 运行时内部抽象层的责任,无需在应用层过度设计。 - 永远不要在文本写入中引入
os.linesep:手动拼接os.linesep不仅不能增强跨平台能力,反而是破坏 Windows 平台文件完整性的元凶。 - 结构化文本(如 CSV)严格遵从模块约定:使用
csv.writer时必须显式声明open(..., newline=""),杜绝多层转换导致的空白行。 - 排查换行符疑难杂症,从二进制着手:当遇到文本多出空白行或格式解析报错时,不要在富文本编辑器中猜测,直接使用
open(file, 'rb').read()观察实际字节序列,重点排查是否存在连续的0x0D 0x0D 0x0A。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















