


Python sqlite3批量插入优化:executemany与事务性能对比
深入对比 Python sqlite3 模块中 execute 循环、executemany 以及显式事务管理的批量插入性能差异,解析磁盘 I/O 与事务日志瓶颈,并提供生产级批量写入优化实践。
在 Python 中使用内置的 sqlite3 模块写入大批量数据时,很多开发者会遇到写入速度极慢的困扰——仅仅插入数万条记录,耗时就可能长达几十秒甚至数分钟。多数人会首先尝试将循环 cursor.execute() 替换为 cursor.executemany(),但往往发现提升并不如预期显著;而一旦引入显式事务管理,耗时却能瞬间下降两到三个数量级。本文将直接拆解 SQLite 的写入机制,通过严谨的测试数据对比不同组合下的吞吐性能,并给出切实可行的工程优化方案。
一、核心瓶颈:SQLite 写入究竟慢在哪里
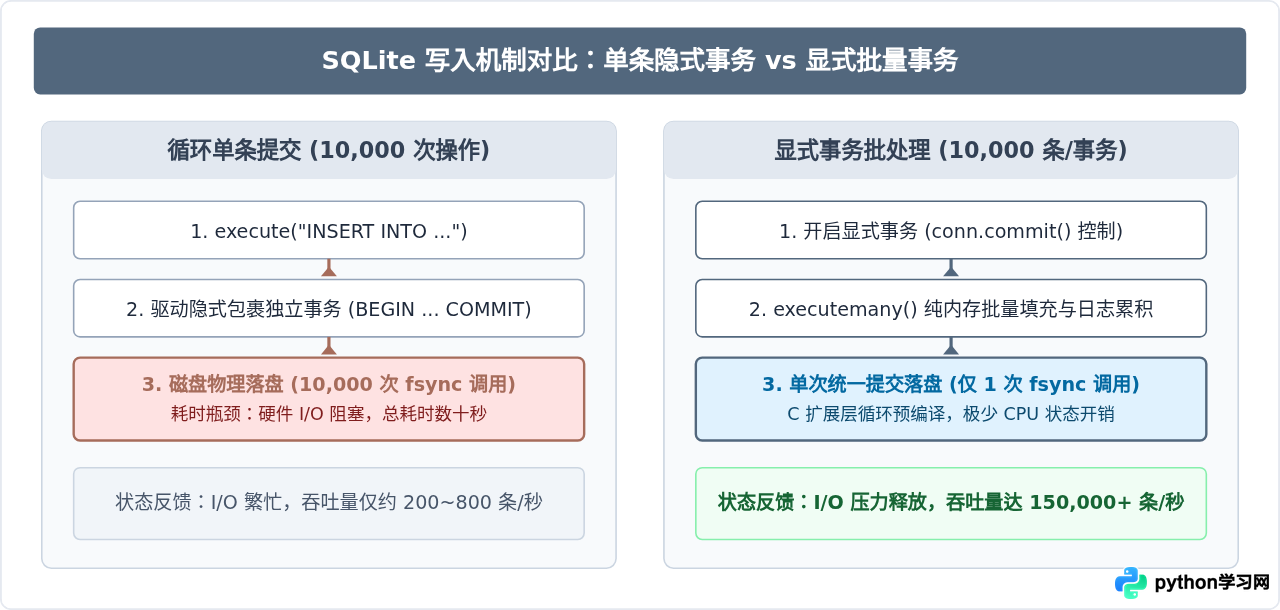
许多初学者误以为批量插入的耗时主要发生在 Python 虚拟机的循环解析或 SQL 语句拼接上。实际上,在默认配置下,SQLite 的核心性能杀手是磁盘同步等待(Disk fsync)。
SQLite 遵循严格的 ACID 事务特性。如果在没有显式开启事务的情况下执行单个 INSERT 语句,数据库驱动会为每一个单独的操作隐式包装一个独立的事务。一个标准的写入事务包含完整的生命周期:打开日志文件、将变更前后的数据写入回滚日志或预写日志(WAL)、触发操作系统级磁盘同步(fsync/FlushFileBuffers)确保物理落盘,随后提交事务并释放文件锁。机械硬盘每秒通常仅能处理数十次物理同步,即便是高速 NVMe 固态硬盘,单线程下的同步频率通常也在几百到上千次每秒。如果循环执行 10,000 次 execute() 且每次单独提交,就意味着驱动要强行触发 10,000 次物理落盘等待,整体性能自然会被严重压制。
二、四种写入方式的代码形态与实测对比
为了直观评估性能差距,我们设置统一的基准测试环境:向本地 SQLite 数据库中插入 100,000 条结构化用户记录(包含自增 ID、字符串名称、浮点余额与整型状态位)。以下为四种常见编写方式:
1. 方式 A:逐条 execute() 循环(未显式控制事务)
import sqlite3

conn = sqlite3.connect("test.db")
cursor = conn.cursor()
cursor.execute("CREATE TABLE IF NOT EXISTS users (id INT, name TEXT, balance REAL, status INT)")

# 模拟 10 万条数据
data = [(i, f"user_{i}", 100.5 * (i % 10), 1) for i in range(100000)]

# 逐条插入,并在每条后 commit(最差场景)
for row in data:
    cursor.execute("INSERT INTO users VALUES (?, ?, ?, ?)", row)
    conn.commit()  # 触发单次物理同步
2. 方式 B:逐条 execute() 循环(外部显式事务)
# 显式事务上下文控制
with conn:
    for row in data:
        cursor.execute("INSERT INTO users VALUES (?, ?, ?, ?)", row)
# with 退出时自动提交一次
3. 方式 C:使用 executemany()(标准事务管理)
# 使用 C 级别预编译批量接口
with conn:
    cursor.executemany("INSERT INTO users VALUES (?, ?, ?, ?)", data)
4. 方式 D:executemany() 结合 PRAGMA 引擎参数调优
# 开启 WAL 预写日志与松弛同步模式
conn.execute("PRAGMA journal_mode = WAL;")
conn.execute("PRAGMA synchronous = NORMAL;")
with conn:
    cursor.executemany("INSERT INTO users VALUES (?, ?, ?, ?)", data)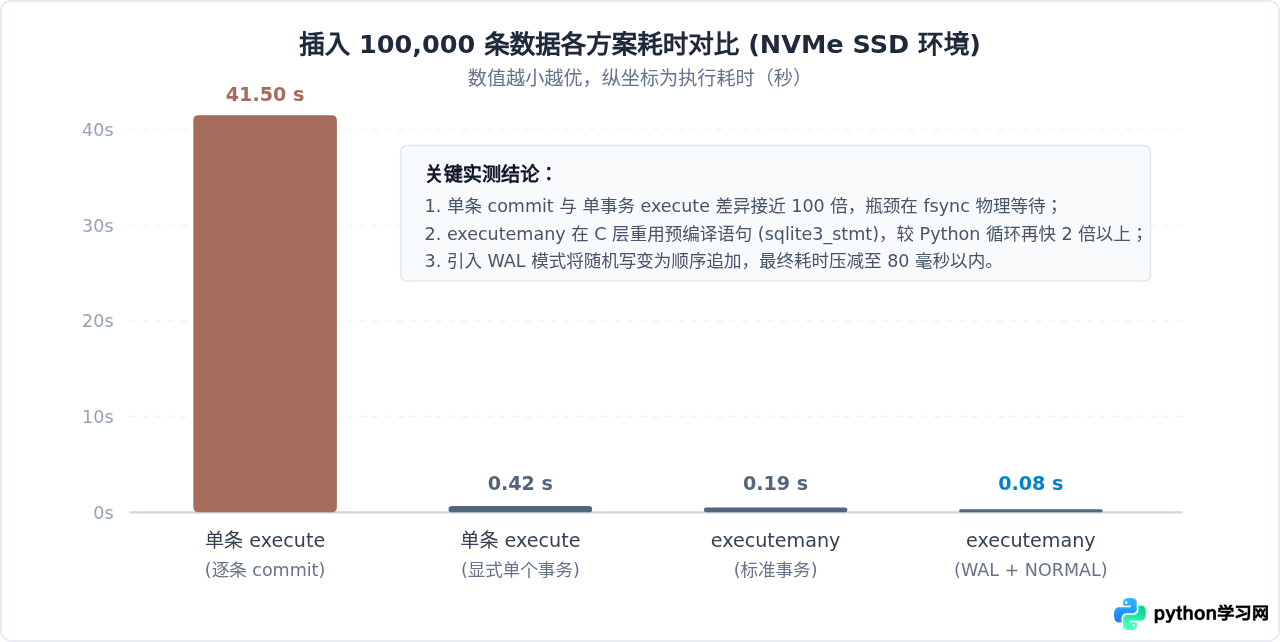
三、executemany 与 显式事务的本质协作关系
很多开发者在测试中容易产生混淆:“既然 executemany() 是官方推荐的批量方法,为什么有时候它依然很慢?”
答案在于:executemany() 解决的是 SQL 语句预编译与语言级交互开销,而显式事务解决的是磁盘落盘开销。
execute()循环的工作路径: Python 代码每循环一次,都需要通过 Python C-API 与底层 SQLite 接口交互一次。即便是同一个 SQL 模板,解释器层面依然存在函数调用、参数解析与状态校验开销。executemany()的工作路径: 底层调用 C 扩展,预先将 SQL 模板编译为单一的sqlite3_stmt准备语句。随后在 C 语言的内部循环中,反复调用sqlite3_bind_*绑定参数并执行sqlite3_step,执行完毕后通过sqlite3_reset重置语句供下一行复用。这完全免去了 Python 字节码循环的分发成本。
然而,如果连接处于自动提交模式(例如 Python 3.12 引入的 autocommit=True 且未显式包装 BEGIN),即便是 executemany() 也无法阻止底层根据语句切分事务。只有当显式事务与 executemany() 结合使用时,才能同时消除“语句重复编译”与“反复刷盘”两个维度的开销。
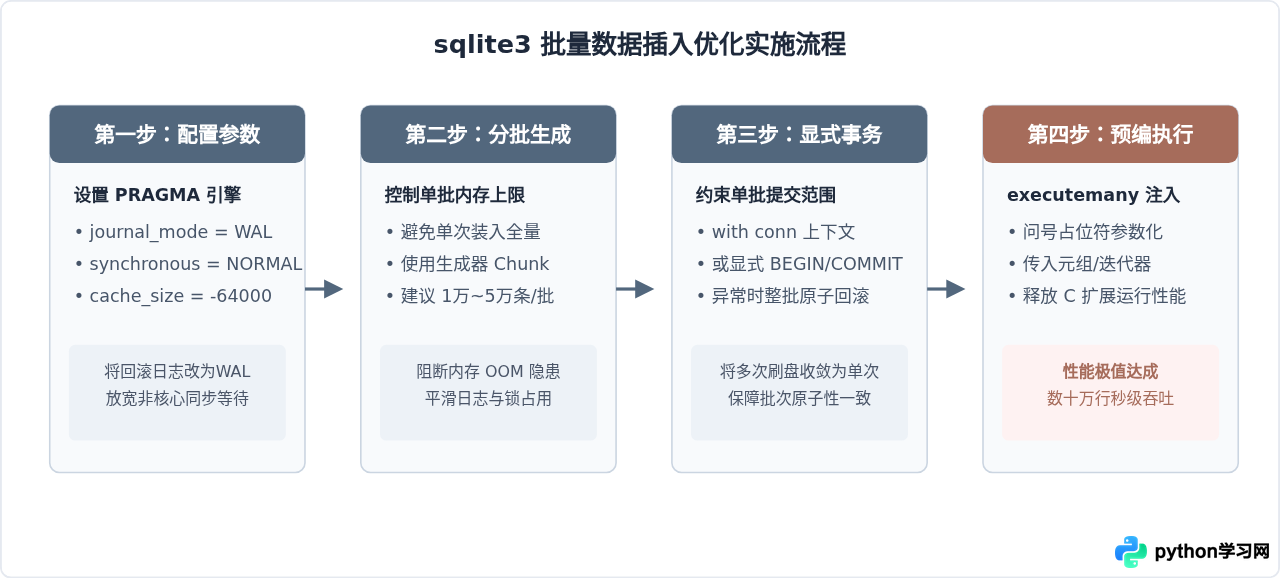
四、sqlite3 批量写入优化四步落地法
在生产级 Python 脚本或后台数据入库任务中,优化批量插入应遵循规范的工程流程。以下是标准化的四步落地路径:
完整优化实现代码
以下代码展示了一个可直接用于生产环境的批量插入模板,集成了内存分块生成器、事务保护及底层 PRAGMA 调优:
import sqlite3
from typing import Iterator, List, Tuple

def get_optimized_connection(db_path: str) -> sqlite3.Connection:
    """初始化数据库连接并注入高性能引擎参数"""
    conn = sqlite3.connect(db_path)

    # 启用 WAL 模式:读写互不阻塞,随机写转顺序写
    conn.execute("PRAGMA journal_mode = WAL;")

    # 将同步模式降为 NORMAL:在保证崩溃安全的同时避免过度同步
    conn.execute("PRAGMA synchronous = NORMAL;")

    # 调整内存缓存页大小(-64000 表示分配约 64MB 缓存)
    conn.execute("PRAGMA cache_size = -64000;")

    return conn

def chunk_generator(data_stream: Iterator[Tuple], batch_size: int = 20000) -> Iterator[List[Tuple]]:
    """将连续的数据流按固定容量切分为小批次,防止内存占用过高"""
    batch = []
    for item in data_stream:
        batch.append(item)
        if len(batch) >= batch_size:
            yield batch
            batch = []
    if batch:
        yield batch

def bulk_insert_records(conn: sqlite3.Connection, sql: str, data_stream: Iterator[Tuple], batch_size: int = 20000):
    """分批次显式提交插入"""
    cursor = conn.cursor()
    total_inserted = 0

    for batch in chunk_generator(data_stream, batch_size=batch_size):
        # 每一个 batch 包裹在一个独立的原子事务中
        with conn:
            cursor.executemany(sql, batch)
        total_inserted += len(batch)

    return total_inserted
五、工程落地中的易错陷阱与细节解析
sqlite3 存在一个长期为人诟病的“隐式事务魔法”(通过自动监控 DML 语句发送 BEGIN)。而在 Python 3.12 中,官方引入了符合 DB-API 规范的 autocommit 参数(sqlite3.connect(..., autocommit=False) 或 autocommit=True)。如果升级到高版本 Python 并启用了真正的 autocommit=True,不使用 with conn: 或手动 conn.commit() 将导致每条 SQL 语句彻底成为单条自治事务,引发严重的性能倒退。
1. 为什么不能将数百万条记录一次性交给 executemany?
许多开发者在尝到 executemany 的甜头后,习惯将整个 500 万行的数据列表整体传入。这会引发两个隐患:
- 内存消耗剧烈: Python 列表装载数百万个元组对象,不仅占用数百兆甚至数吉字节的 RAM,还会增加垃圾回收(GC)暂停时间。
- 事务过大与锁竞争: 单个包含数百万行的庞大事务会导致预写日志(WAL)文件迅速膨胀到数吉字节;若写入过程中程序意外终止,数据库重启时的恢复耗时会急剧增加。因此,建议将批次大小控制在 10,000 至 50,000 条 之间。
2. 临时关闭索引与外键约束
如果要向已经存在的大表中导入海量数据,表上的 B-Tree 索引 会随着每条数据的写入而频繁分裂与重构。最有效的方式是在执行批量导入前先 DROP INDEX,待全量数据写入提交后再执行 CREATE INDEX 统一重建,这通常能让大表入库耗时缩减 40% 到 60%。
六、方案选型与总结决策矩阵
面对不同的数据规模与可靠性要求,应当选择适配的优化组合:
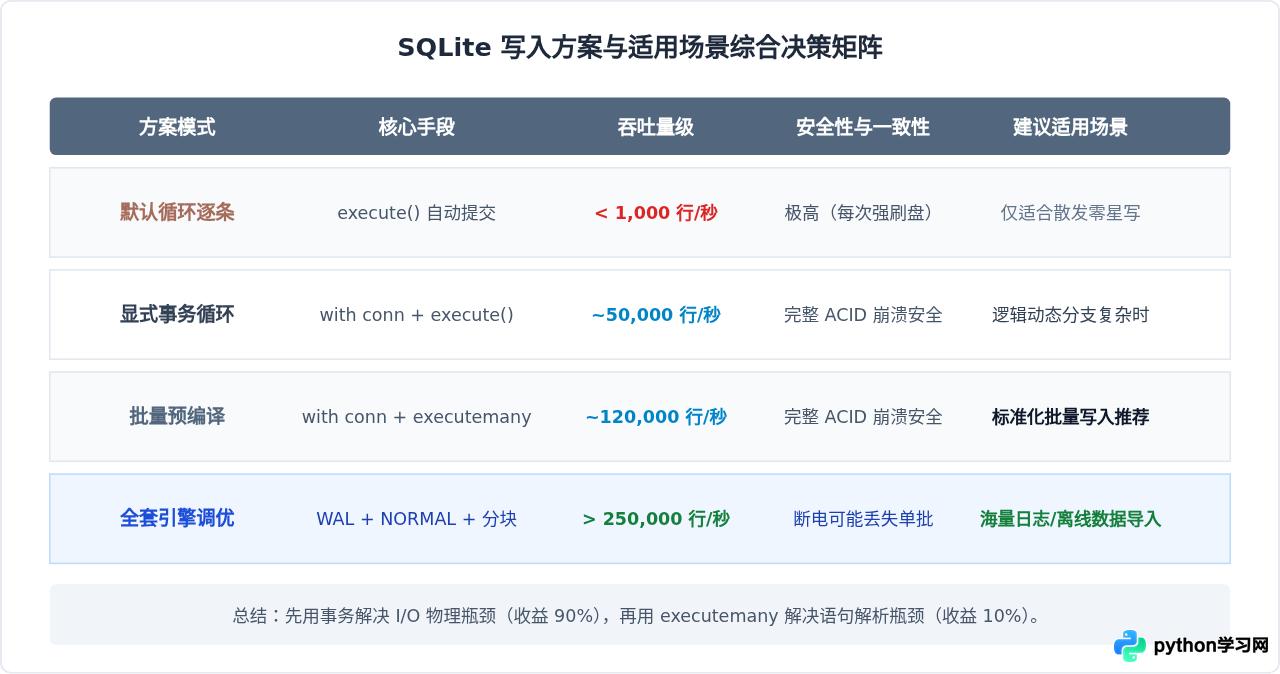
综上所述,优化 Python sqlite3 的批量写入性能并不需要引入复杂的外部依赖。首要任务是通过显式事务(with conn:)将成千上万次磁盘 I/O 刷盘合并为单次提交,消除绝对瓶颈;在此基础上,利用 executemany() 将参数循环绑定下沉至 C 扩展层;最后配合 WAL 模式与合理的分批生成器,即可让普通的 SQLite 数据库在常规机器上轻松拥有每秒数十万行的工业级插入性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















