


Python字符串切片提取前N位、后N位及中间子串代码示例
本文详细讲解Python中利用字符串切片提取前N位、后N位字符及中间子串的语法规则、代码示例与边界处理技巧,配合清晰图解帮助读者彻底掌握左闭右开区间与负索引机制。
string[start:end:step],我们无需调用冗长的子串截取函数,即可用一行代码完成前 N 位字符(s[:n])、后 N 位字符(s[-n:])以及任意中间子串(s[start:end])的高效提取。本文将深入剖析切片背后的区间与索引逻辑,结合完整可运行的代码示例与实战注意事项,助你全面掌握字符串截取技巧。
一、核心机制:切片语法与双向索引坐标系
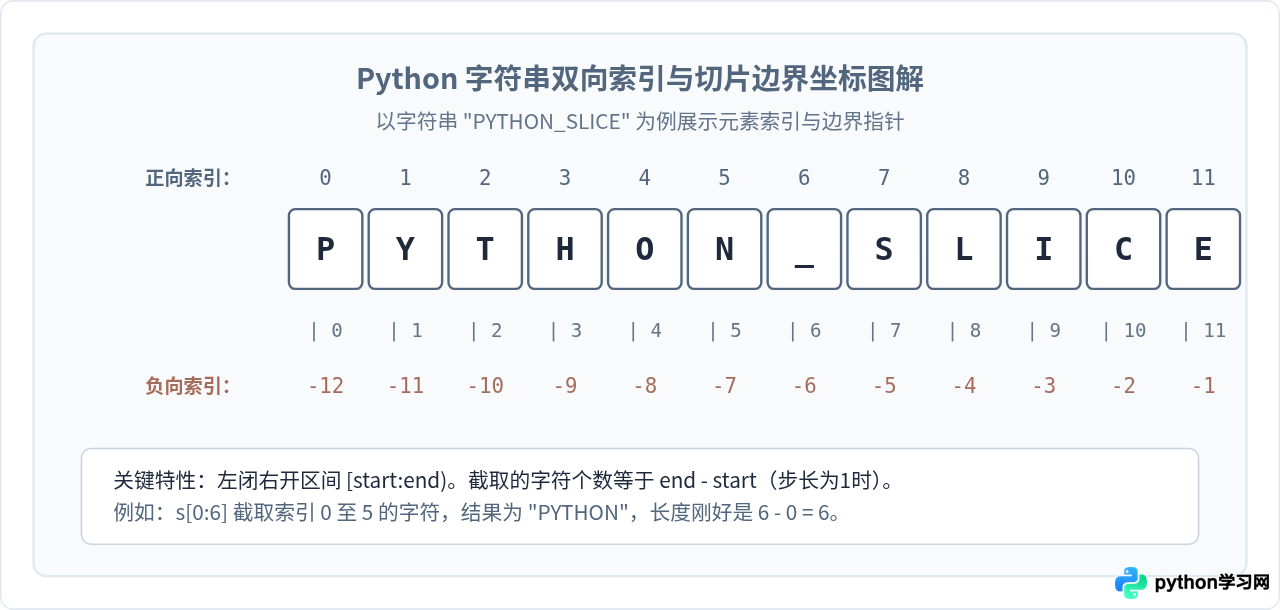
想要稳定写出无 bug 的切片代码,首先需要理解 Python 的“切片边界定位”概念。Python 切片语法包含三个可选参数:
substring = original_str[start:end:step]- start:切片起始位置的索引(包含该位置字符,默认为 0)。
- end:切片结束位置的索引(不包含该位置字符,即著名的“左闭右开”区间
[start, end);若省略则截取至末尾)。 - step:步长(每次递进的字符数,默认为 1;当步长为负数时可实现反向提取)。
很多初学者容易在这里困惑:为什么结束索引不包含在结果中?最直观的理解方式是将索引视为字符之间的“分隔缝隙(边界指针)”,而不是字符本身。此外,Python 支持双向索引系统:正向从左至右由 0 递增,负向从右向左由 -1 递减。
二、提取前 N 位字符:语法与实战步骤
提取字符串前 N 位字符的标准表达式是 string[:n]。
当切片起始位置为字符串头部时,0 可以完全省略,直接写 [:n]。由于切片采用左闭右开原则,结束索引 n 对应字符前方的切片边界,因此提取结果正好包含前 n 个字符。
1. 完整代码示例
# 示例 1:提取字符串前 N 位字符
text = "HelloWorld2026"

# 提取前 5 位字符
prefix_5 = text[:5]
print("前 5 位字符:", prefix_5)
# 输出: 前 5 位字符: Hello

# 显式书写 start 为 0(效果完全相同,但推荐简写 [:n])
prefix_explicit = text[0:5]
print("显式指定起始索引:", prefix_explicit)
# 输出: 显式指定起始索引: Hello

# 边界测试:当 N 大于等于字符串实际总长度时
prefix_overflow = text[:50]
print("N 超过总长度时的结果:", prefix_overflow)
# 输出: N 超过总长度时的结果: HelloWorld2026

# 边界测试:当 N 为 0 或负数时
prefix_zero = text[:0]
print("N 为 0 时的结果:", repr(prefix_zero))
# 输出: N 为 0 时的结果: ''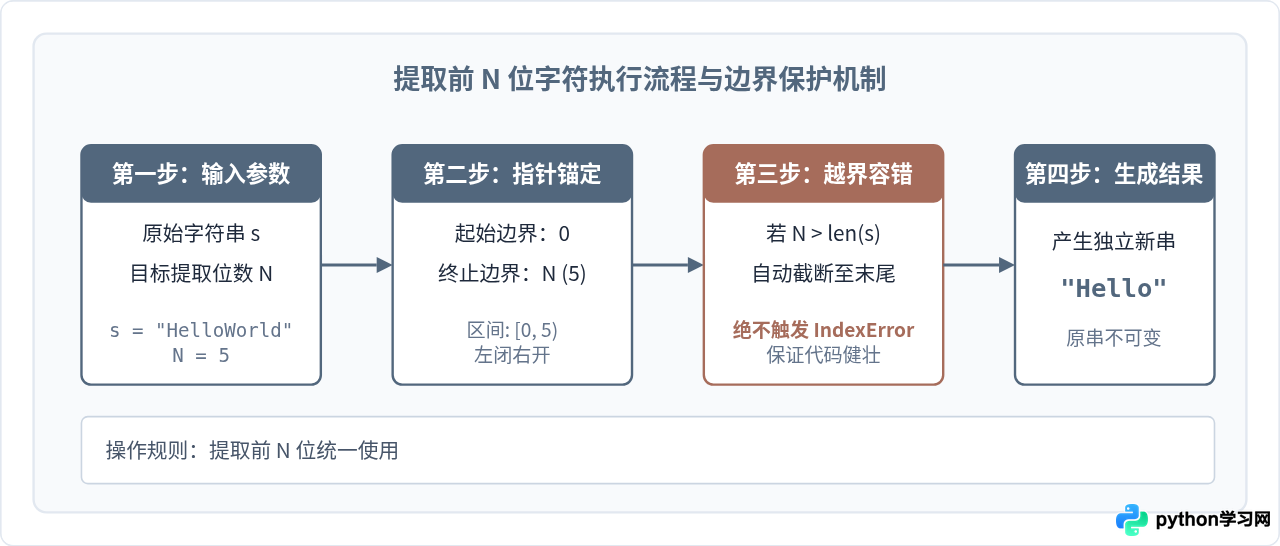
三、提取后 N 位字符:负向索引与易混淆陷阱
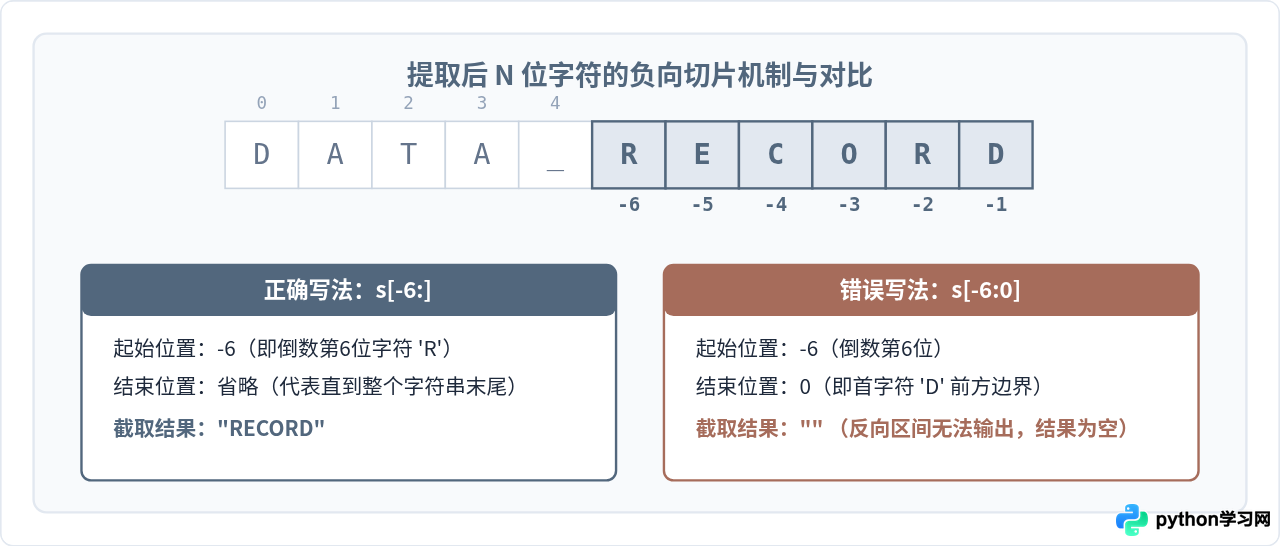
提取字符串末尾的后 N 位字符,是负向索引发挥优势的最佳场景,其标准写法为:string[-n:]。
在负向索引中,-1 表示最后一个字符,-2 表示倒数第二个字符,因此 -n 正好指向倒数第 n 个字符的起始位置。通过在冒号后省略结束索引([-n:]),切片机制会自然地从倒数第 n 个位置一直抓取到字符串末尾。
1. 完整代码示例
# 示例 2:提取字符串后 N 位字符
filename = "report_2026_q3_final.pdf"

# 提取后 4 位字符(包含扩展名 .pdf)
suffix_4 = filename[-4:]
print("提取后 4 位:", suffix_4)
# 输出: 提取后 4 位: .pdf

# 提取后 9 位字符
suffix_9 = filename[-9:]
print("提取后 9 位:", suffix_9)
# 输出: 提取后 9 位: final.pdf

# 边界测试:N 大于字符串总长度时
suffix_overflow = filename[-100:]
print("N 超长时的切片结果:", suffix_overflow)
# 输出: N 超长时的切片结果: report_2026_q3_final.pdf
高频易错警示:切勿写成 s[-n:0]!
许多初学者认为末尾是 0,因此尝试用 s[-5:0] 提取后 5 位,结果却得到空字符串 ""。这是因为索引 0 始终代表字符串的“绝对开头”。由于默认步长 +1 只能自左向右递增移动,从负索引 -5 出发根本无法“正向”到达索引 0,从而导致切片区间非法返回空串。提取末尾必须省略冒号右侧的结束参数:s[-n:]。
四、提取中间子串与步长控制代码示例
提取中间子串不仅需要同时明确 start 与 end,在实际业务中往往还会结合 find() 或 index() 进行动态定位。此外,步长参数 step 能够实现跳跃截取与字符串翻转。
1. 固定区间的中间子串提取
# 示例 3:固定位置的中间子串截取
id_card_sample = "110101199003072345"

# 提取中间的出生年份(索引 6 至 10,不包含 10)
birth_year = id_card_sample[6:10]
print("出生年份:", birth_year)
# 输出: 出生年份: 1990

# 提取生日月份与日期(索引 10 至 14)
birth_md = id_card_sample[10:14]
print("出生月日:", birth_md)
# 输出: 出生月日: 0307
2. 动态定位中间子串(基于关键字索引)
在爬虫清洗或日志分析场景中,目标内容两侧通常有固定的标志符。我们可以使用 find() 动态计算位置后再切片:
# 示例 4:动态定位提取标签内的中间子串
log_entry = "2026-10-28 [INFO] TaskCompleted: User ID 9527 finished processing."

# 目标:提取方括号内的日志级别
left_bracket = log_entry.find("[")
right_bracket = log_entry.find("]")

if left_bracket != -1 and right_bracket != -1:
    level = log_entry[left_bracket + 1 : right_bracket]
    print("提取的日志级别:", level)
    # 输出: 提取的日志级别: INFO
3. 利用步长 step 进行高级截取与反转
# 示例 5:步长参数应用
alphabet = "ABCDEFGHIJKLMN"

# 每隔一个字符取一个(步长为 2)
every_second = alphabet[::2]
print("步长为 2:", every_second)
# 输出: 步长为 2: ACEGIKM

# 提取从索引 2 到 10 之间、步长为 3 的子串
sub_step = alphabet[2:10:3]
print("区间带步长:", sub_step)
# 输出: 区间带步长: CFI

# 步长为 -1:字符串快速反转
reversed_str = alphabet[::-1]
print("完整反转:", reversed_str)
# 输出: 完整反转: NMLKJIHGFEDCBA
五、总结:核心切片模式全景对比
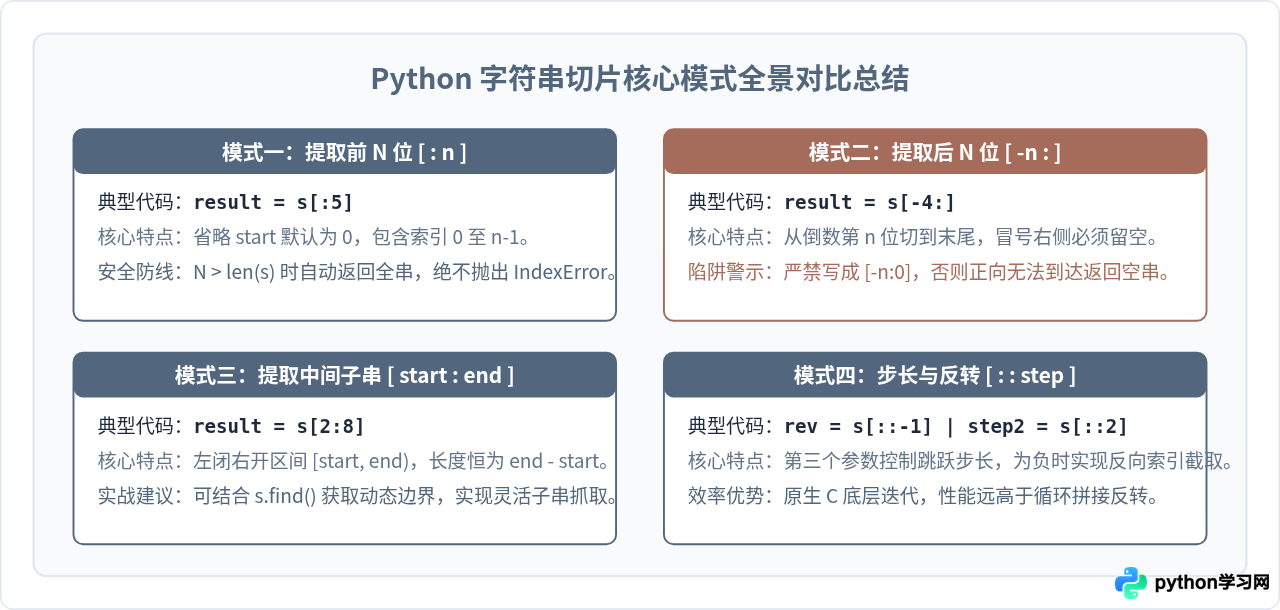
为了方便快速查阅与复用,下表与全景图对本文涉及的核心切片场景及其实际效果进行了梳理总结:
| 截取需求 | 切片表达式 | 示例(以 "ABCDEFG" 为例) | 结果 | 注意事项 |
|---|---|---|---|---|
| 提取前 N 位 | s[:n] |
s[:3] |
"ABC" |
省略起始 0;超出总长安全截断,不报错 |
| 提取后 N 位 | s[-n:] |
s[-3:] |
"EFG" |
右侧必须留空;严禁写成 s[-n:0] |
| 剔除后 N 位 | s[:-n] |
s[:-2] |
"ABCDE" |
保留从头开始除最后 n 位之外的所有字符 |
| 剔除前 N 位 | s[n:] |
s[2:] |
"CDEFG" |
从第 n 位开始保留至末尾 |
| 提取中间子串 | s[start:end] |
s[2:5] |
"CDE" |
左闭右开区间,子串长度恒等于 end - start |
| 反转字符串 | s[::-1] |
s[::-1] |
"GFEDCBA" |
负步长从右向左逐一提取 |
六、结语与注意事项
Python 字符串切片是语言设计中兼顾简洁与优雅的代表特性之一。掌握好前 N 位、后 N 位以及中间子串的截取,关键在于牢记左闭右开原则与负向索引的起点位置。同时,在日常开发中需要注意以下两点:
- 字符串的不可变性(Immutability):所有切片操作都不会修改原始字符串,而是创建并返回一个全新的字符串对象。
- 单索引访问 vs 切片访问的差异:直接通过单下标访问越界索引(如
s[100])会直接抛出IndexError;而切片语法(如s[10:100])拥有原生容错机制,超出部分会自动平滑截断,不会导致程序中断崩溃。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















