


Python跨模块共享全局变量的实现方法
深入解析Python跨模块共享全局变量的标准实现方法、底层模块单例机制、from import与import语法的内存绑定差异,以及多线程与并发场景下的工程规范。
一、核心机制与单例导入原理
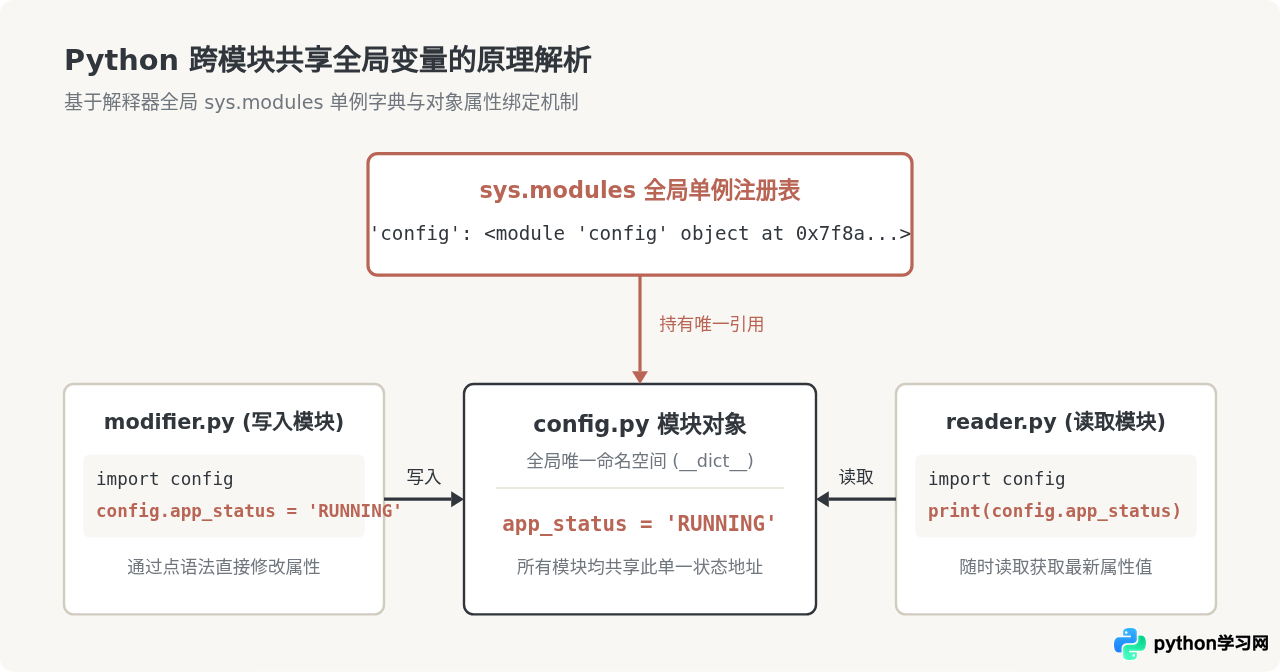
许多开发者在初次尝试跨文件共享变量时,经常会遇到“在 A 模块修改了变量,但在 B 模块读取时依旧是初始值”的困惑。理解这个问题的根源,首先需要明确 Python 的模块加载机制。
当 Python 程序首次执行 import xxx 时,解释器会按顺序执行以下关键操作:
- 检查内置的
sys.modules字典,确认该模块是否已经被加载过。 - 如果未加载,解释器会在独立的作用域中从头到尾执行该模块文件的代码,并构造一个模块对象(
module类型实例)。 - 将该模块对象以模块名为键,注册写入
sys.modules字典中。 - 后续在同一进程内的任何其它代码位置再次导入该模块时,解释器不再重复读取或执行文件,而是直接从
sys.modules返回这个已存在的模块对象引用。
这意味着:在同一个 Python 进程生命周期内,每一个模块对象在内存中是天然的单例(Singleton)。所有针对该模块对象属性(module.attribute)的直接赋值与读取,操作的都是同一个模块内部的命名空间字典(__dict__)。
二、标准实现四步法
实现跨模块共享变量的最稳健工程结构是建立专门的配置共享文件,并严格遵循“导入模块本身,通过点语法读写”的规范。以下通过一个标准的四文件目录结构进行演示:
project/
├── config.py      # 步骤1:共享配置与状态模块
├── writer.py      # 步骤2:更新全局变量的业务模块
├── reader.py      # 步骤3:读取全局变量的业务模块
└── main.py        # 步骤4:程序执行调度入口
步骤 1:创建共享配置模块 config.py
在该模块中显式定义需要跨模块共享的全局变量,并赋予明确的初始值(如 None、空字典或默认数值)。清晰的初值有助于代码阅读与静态类型检查。
# config.py
# 显式声明全局共享变量并设置默认初始值
current_user = None
system_mode = "STANDBY"
request_counter = 0
步骤 2:在写模块中修改属性 writer.py
在业务修改逻辑中,必须使用 import config。在需要改变全局状态时,通过 config.variable = new_value 显式指定属性归属。
# writer.py
import config

def initialize_system(username):
    # 直接修改 config 模块对象命名空间内的属性
    config.current_user = username
    config.system_mode = "ONLINE"
    config.request_counter += 1
    print(f"[Writer] 已完成系统状态初始化,当前用户: {config.current_user}")
步骤 3:在读模块中获取属性 reader.py
同理,在任何需要消费该状态的模块中,同样导入 config 模块,直接通过 config.variable 读取最新数据。
# reader.py
import config

def check_status():
    # 无论被谁调用,读取的都是 config 模块单例中的最新状态
    print(f"[Reader] 读取系统状态 -> 用户: {config.current_user}, "
          f"运行模式: {config.system_mode}, 请求次数: {config.request_counter}")
    return config.current_user
步骤 4:主程序调度与验证 main.py
主程序引入各个业务模块,按逻辑顺序调度写入与读取,验证跨模块变量是否成功保持一致。
# main.py
import writer
import reader

def main():
    print("--- 步骤 1: 初始检查 ---")
    reader.check_status()

    print("\n--- 步骤 2: 触发状态修改 ---")
    writer.initialize_system("Alice_Admin")

    print("\n--- 步骤 3: 再次检查读取结果 ---")
    reader.check_status()

if __name__ == "__main__":
    main()
在终端中执行 python main.py,其输出结果如下:
--- 步骤 1: 初始检查 ---
[Reader] 读取系统状态 -> 用户: None, 运行模式: STANDBY, 请求次数: 0

--- 步骤 2: 触发状态修改 ---
[Writer] 已完成系统状态初始化,当前用户: Alice_Admin

--- 步骤 3: 再次检查读取结果 ---
[Reader] 读取系统状态 -> 用户: Alice_Admin, 运行模式: ONLINE, 请求次数: 1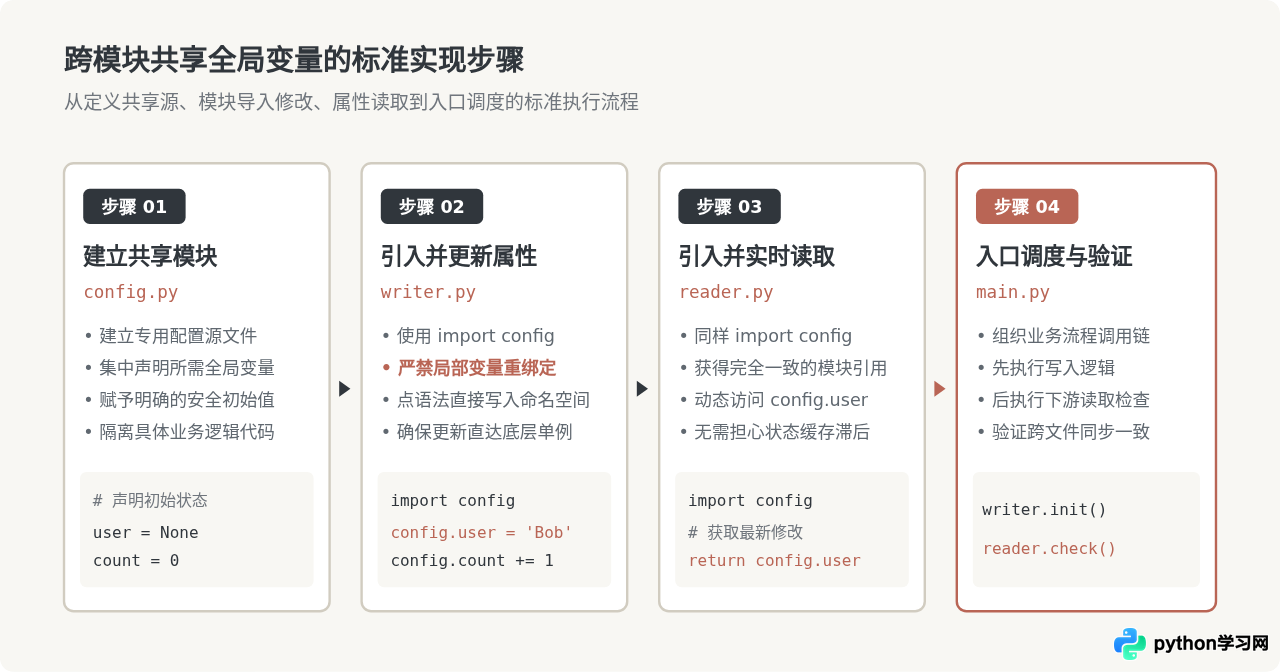
三、致命误区:为什么 from config import x 会失效?
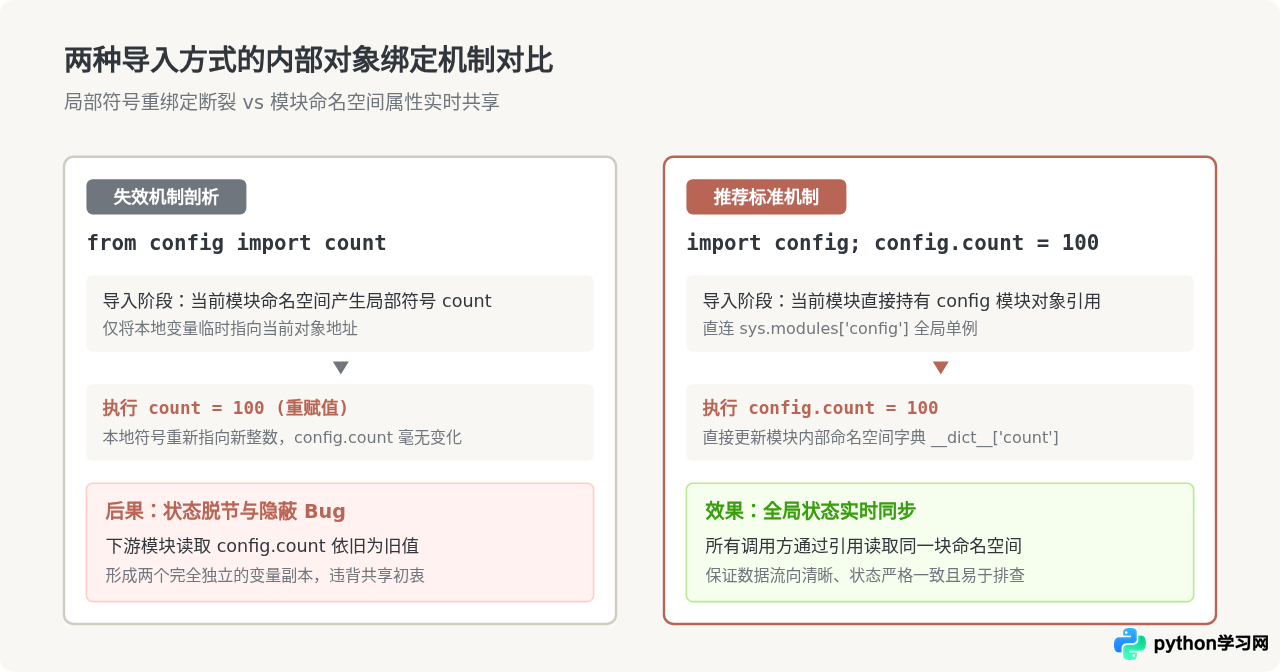
许多人在实践中常犯的严重错误是采用 from config import variable 导入变量。这种写法在大多数情况下会导致跨模块共享彻底失效。
不要在修改方使用 from config import variable!
在 Python 语法中,from config import count 会在当前模块的局部命名空间中创建一个名为 count 的局部变量,并将其指向 config.count 当时所指的对象。当你后续执行 count = 100 时,Python 只是将当前模块局部的符号 count 重新绑定到了新的整数对象 100 上,而 config 模块里的 count 属性完全没有被触碰!
以下代码直观还原了这种失效现象:
# bad_writer.py(错误写法)
from config import request_counter

def add_counter():
    # 局部变量发生重新绑定,config 内部依然是原值 0
    request_counter = 999
    print(f"本地 request_counter: {request_counter}")

# reader.py
import config
def read():
    print(f"全局 config.request_counter: {config.request_counter}") # 依然输出 0!
可变对象(字典/列表)的假象与隐患
有的开发者会反驳:“我写 from config import user_dict,然后执行 user_dict['name'] = 'Tom',其他模块能读到更新啊!”
这属于由于对象可变性(Mutability)带来的巧合:
- 通过方法原地修改可变对象(例如
dict.update()或list.append()),由于没有发生符号重新绑定,内存地址未变,确实能在其他模块体现。 - 但是,一旦某处逻辑执行了重新赋值(例如
user_dict = {'name': 'Jerry'}),当前模块的局部变量便立刻与原对象脱钩,共享链条瞬间断裂。
因此,为了消除不可变类型(数字、字符串、元组)与可变类型(字典、列表、集合)之间的心智负担与潜在 Bug,团队工程中应强制统一规范:一律使用 import config,并通过 config.attr 进行读写。
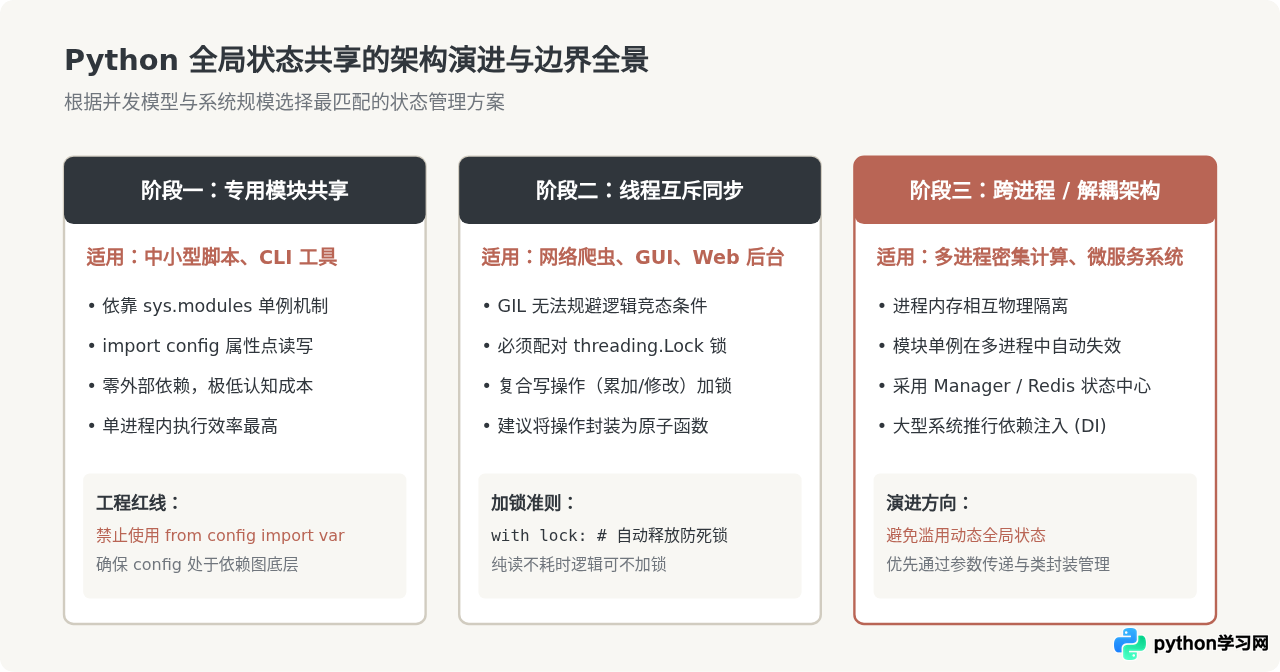
四、边界条件与多线程并发安全
虽然基于模块单例的共享方法简单高效,但在面对复杂业务、多线程或多进程环境时,必须识别其适用边界与限制条件。
1. 规避循环导入(Circular Import)
如果模块 A 导入模块 B,同时模块 B 又在顶层导入模块 A,并且都试图访问对方在导入期间定义的全局属性,就会抛出 ImportError: cannot import name ... 异常。
防护方案:将共享状态完全从业务逻辑中剥离,独立置于最底层的 config.py 模块中。该模块只定义纯数据与基础状态,不反向依赖任何业务模块。这样在项目依赖图中,config 永远处于叶子节点,天然隔绝循环导入。
2. 多线程环境下的并发安全
Python 具有 GIL(全局解释器锁),但 GIL 绝不等于线程安全。GIL 仅保证单个字节码指令执行的原子性。当多个线程同时执行自增运算(config.counter += 1)或“先检查后修改”(Check-then-Act)的复合逻辑时,极易发生竞态条件(Race Condition),导致状态丢失。
在多线程程序中跨模块共享变量时,应在 config.py 内置一把互斥锁(threading.Lock):
# config.py(线程安全版本)
import threading

# 共享变量
shared_counter = 0

# 配套的线程锁
counter_lock = threading.Lock()

def increment():
    global shared_counter
    with counter_lock:
        shared_counter += 1
各业务模块调用 config.increment(),利用上下文管理器 with 自动加锁与解锁,保证多线程修改下的数据一致性。
3. 多进程(Multiprocessing)环境的失效边界
特别注意:模块单例共享机制仅在同一个操作系统进程内有效。
如果使用 multiprocessing 派生多个子进程,每个子进程都拥有独立的内存空间与属于自己的 sys.modules 副本。此时在子进程中修改 config.value,主进程和其他子进程是完全感知不到的。
跨进程共享状态必须借助专门的 IPC 机制:
multiprocessing.Value/Array:适合简单的共享数值或定长数组。multiprocessing.Manager:提供基于网络代理的跨进程共享字典、列表。- 外部集中存储(如 Redis、SQLite):在分布式或微服务架构中维护全局状态。
五、常见实现方案对比与选型建议
在实际项目开发中,除了“专用模块共享法”,开发者也常接触其他全局状态传递方式。下表总结了各方案的优劣与适用条件:
| 方案名称 | 实现方式 | 主要优势 | 核心风险与局限 | 推荐适用场景 |
|---|---|---|---|---|
| 专用模块共享(推荐) | 创建 config.py,使用 import config; config.x = val |
轻量直观、无需额外依赖、符合 Python 原生模块单例机制 | 易被误写为 from import 导致绑定失效;多进程不共享 |
中小型脚本、单进程应用、基础配置中心 |
| 单例类实例 | 实现 __new__ 或模块导出一个预初始化的 Class 实例 |
支持封装 Getter/Setter,便于增加数据校验与加锁逻辑 | 代码量稍多,对于简单变量有一定过度设计成本 | 大型项目、需要数据校验或复杂状态控制的系统 |
| 内置命名空间注入 | 在 builtins 模块中挂载变量(如 __builtins__.val) |
任何地方无需导入即可全局直接读取 | 严重破坏代码可读性与模块隔离,极难排查依赖来源 | 严格禁止在生产代码中使用(调试辅助除外) |
| 外部集中存储 | 借助 Redis、Memcached 或本地共享文件数据库 | 天然支持多进程、多服务器实例间状态实时同步 | 引入外部网络与服务依赖,存在序列化与网络 I/O 开销 | 分布式系统、微服务架构、多进程计算任务 |
总结与工程落地清单
- 专包专用原则:建立独立的
config.py模块存放共享数据,不要把业务模块同时兼做配置共享源,避免循环导入。 - 导入语法红线:修改与读取共享变量时,始终使用
import config并通过config.var访问属性,杜绝在修改方使用from config import var。 - 显式初始化:在
config.py头部对所有可能被共享的变量显式声明并赋予合理的默认初值,提高可读性并配合 IDE 代码提示。 - 多线程加互斥锁:如果存在并发写操作,务必在配置模块内配备
threading.Lock,通过上下文管理器控制临界区。 - 知晓多进程边界:模块单例仅限于进程内内存,跨进程任务需转向
multiprocessing.Manager或集中式配置服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















