


Python发牌程序中random.shuffle的随机性原理与Fisher-Yates算法实现
深入解析Python发牌程序中random.shuffle的底层随机性原理与Fisher-Yates洗牌算法实现,包含概率推导、代码实现与工程避坑指南。
在编写扑克牌发牌程序或棋牌模拟逻辑时,核心要求是牌堆必须被彻底“洗匀”,即52张牌的所有可能排列必须以均等概率出现。Python 标准库中的 random.shuffle() 函数能够在 $O(N)$ 时间复杂度与 $O(1)$ 辅助空间下完成原地洗牌,其底层依赖的正是著名的 Fisher-Yates(也称 Knuth 洗牌)算法。理解该算法的数理推导、CPython 内部实现及其随机数发生器特性,不仅有助于写出没有概率偏差的发牌程序,还能避免常见的伪随机缺陷与工程陷阱。
一、发牌程序的核心架构与错误洗牌误区
一副标准扑克牌包含黑桃、红心、梅花、方块4种花色,各13张点数,共52张牌。一套完整的发牌逻辑通常分为三个阶段:牌组初始化(Deck Initialization)、序列洗牌(Shuffling)以及按规则分发(Dealing)。
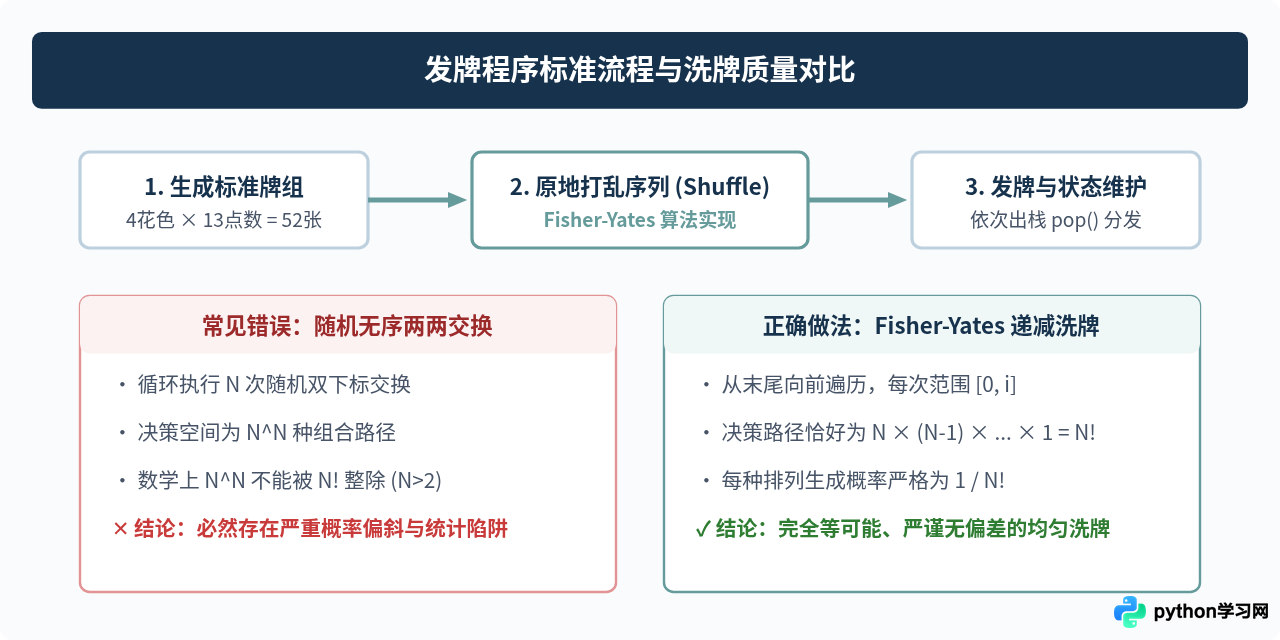
很多开发者在初次实现发牌逻辑时,容易凭借直觉采用非标准的随机化手段,最典型的两种错误模式如下:
- 错误模式一:基于随机权重的排序法。通过
deck.sort(key=lambda x: random.random())进行打乱。这种方式不仅时间复杂度高达 $O(N \log N)$,而且现代排序算法在元素比较时无法保证各排列的对称均匀性,极易产生非均匀偏差。 - 错误模式二:简单循环交换法。随意循环 $N$ 次,每次随机挑选两个下标
i和j进行交换。由于每次有 $N \times N = N^2$ 种交换可能,$N$ 次循环共有 $N^N$ 种决策路径。而一副牌的全排列总数为 $N!$。当 $N > 2$ 时,$N^N$ 永远不能被 $N!$ 整除,这意味着各种排列出现的概率不可能绝对均等,必然存在某些牌型分布概率偏高的情况。
二、Fisher-Yates 算法原理与数学严格性证明
Fisher-Yates 洗牌算法最初由 Ronald Fisher 与 Frank Yates 于 1938 年提出,后经计算机科学家 Richard Durstenfeld 和 Donald Knuth 改写为适合计算机原地执行的形式(常用 Knuth Shuffle 指代现代版本)。
1. 算法执行流程
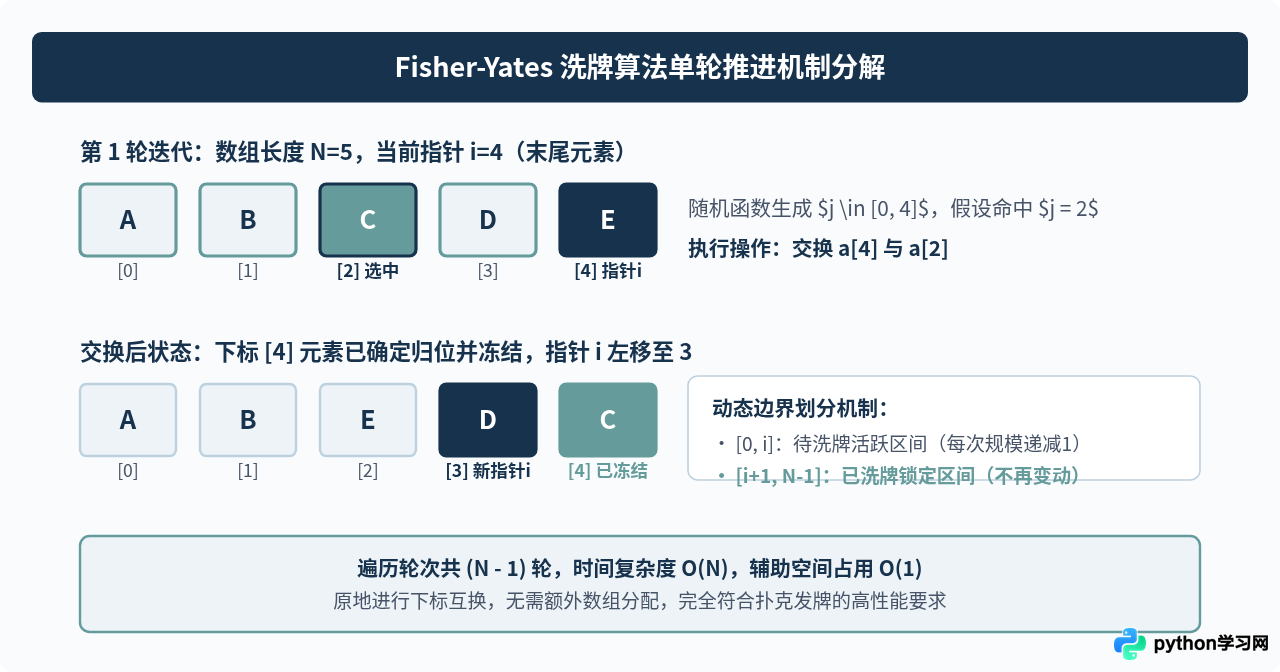
设数组长度为 $N$,下标范围为 $0$ 到 $N-1$:
- 指针 $i$ 从数组最后一个元素(下标 $N-1$)开始,递减遍历至下标 $1$;
- 在闭区间 $[0, i]$ 内等概率随机选取一个整数索引 $j$;
- 交换下标 $i$ 与下标 $j$ 处的两个元素;
- 指针 $i$ 左移一位,重复上述操作,直至整个数组全部处理完毕。
2. 数学等概率性证明
要证明算法的绝对均匀性,只需证明:原始序列中的任意元素,洗牌结束后出现在任意目标位置 $k$ 的概率均为 $1/N$。
我们以最后一个位置(下标 $N-1$)为例:在第一次迭代中,从 $N$ 个候选中等概率随机选取一个元素放在下标 $N-1$,该元素命中当前位置的概率显然为 $1/N$。随后该位置被“冻结”,后续迭代不再参与。
对于倒数第二个位置(下标 $N-2$):某特定元素要想落在这个位置,必须满足两个独立事件同时发生:
- 在第一轮未被选中留在候选集中,概率为 $\frac{N-1}{N}$;
- 在第二轮(从剩余 $N-1$ 个元素中选一个放入下标 $N-2$)恰好被选中,概率为 $\frac{1}{N-1}$。
两事件联合概率为:
$P = \frac{N-1}{N} \times \frac{1}{N-1} = \frac{1}{N}$
依此类推,通过数学归纳法可知,任意元素落在任意指定位置的综合概率均为严格的 $1/N$。全排列的概率即为 $1/N!$。这就是 Fisher-Yates 算法无可替代的核心理论基础。
三、Python 中手写 Fisher-Yates 算法实现
在 Python 中,我们可以通过 random.randrange() 或 random.randint() 来手动实现一个标准的 Fisher-Yates 洗牌函数:
import random
from typing import List, Any

def fisher_yates_shuffle(deck: List[Any]) -> None:
    """
    使用 Fisher-Yates (Knuth) 算法对序列进行原地均匀洗牌。
    参数:
        deck: 需要打乱的可变列表对象
    """
    n = len(deck)
    # i 从最后一个元素倒序遍历至下标 1
    for i in range(n - 1, 0, -1):
        # 在闭区间 [0, i] 随机挑选一个整数索引 j
        # random.randint(0, i) 等价于 random.randrange(i + 1)
        j = random.randint(0, i)
        # 原地交换当前位置与选中的随机位置
        deck[i], deck[j] = deck[j], deck[i]
该函数的运行逻辑与 CPython 的 random.shuffle() 本质完全一致。使用时需要注意,由于该函数是原地(in-place)修改输入列表,返回值默认为 None。如果需要保留原牌组,必须先对其进行浅拷贝(如 deck.copy() 或 deck[:])。
四、random.shuffle 的内部原理与随机数生成器机制
Python 标准库的 random.shuffle(x, random=None) 源码位于 Lib/random.py 中。观察源码可以发现,其内部逻辑即为 Fisher-Yates 算法的优化实现:
def shuffle(self, x):
    randbelow = self._randbelow
    for i in reversed(range(1, len(x))):
        # 内部调用 _randbelow(i + 1) 获取 [0, i] 的随机整数
        j = randbelow(i + 1)
        x[i], x[j] = x[j], x[i]
这里有两项关键的技术细节值得深入探讨:
1. 消除模偏差(Modulo Bias)的 _randbelow
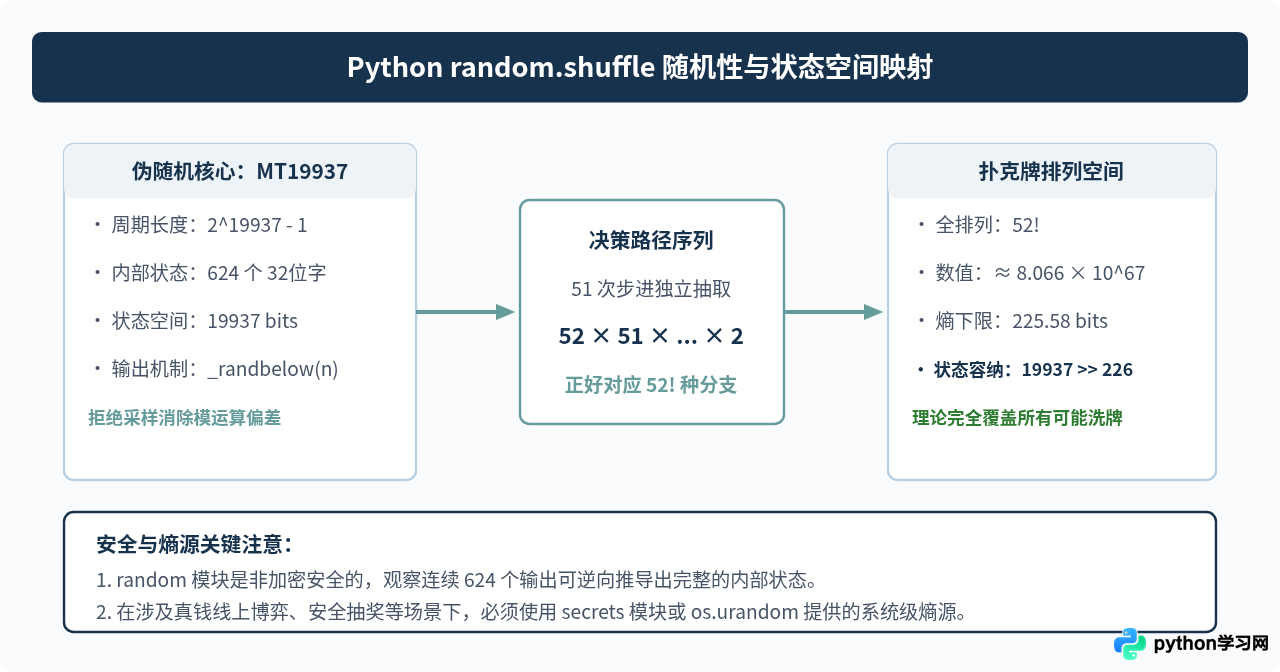
很多简单的随机算法在生成特定范围 $[0, k)$ 随机数时,容易采用 PRNG() % k(取模运算)。然而,当伪随机数生成器的输出值范围不是 $k$ 的整数倍时,取模会使较小数字出现的频次略高于较大数字,这种微小的偏差在密码学和高精度博弈模拟中是不可接受的。CPython 的 _randbelow(n) 采用拒绝采样(Rejection Sampling)技术,通过动态丢弃超出范围的高位位段,确保所选下标是真正均匀无偏的。
2. 梅森旋转算法(Mersenne Twister)与排列状态空间
Python 的 random 模块默认底层引擎是 MT19937(Mersenne Twister 32位版本)。其拥有极长的周期 $2^{19937} - 1$,并在高达 623 维的空间内保持均匀分布。
对于一副 52 张牌的扑克牌,其可能排列数为:
$52! = 80,658,175,170,943,878,571,660,636,856,403,766,975,289,505,440,883,277,824,000,000,000,000 \approx 8.066 \times 10^{67}$
由于 $52! \approx 2^{225.58}$,需要至少 226 位的内部熵才能代表所有可能的扑克牌洗牌排列。MT19937 内部拥有 19937 位的状态矩阵,状态空间容量远大于 $52!$。这意味着从理论容量上看,Python 的 random.shuffle 具备生成扑克牌所有可能排列的表达能力。
五、完整扑克发牌程序代码示例
下面是一个符合生产环境要求的完整扑克发牌程序,包含牌组定义、洗牌、手牌分发与底牌保留等完整流程:
import random
from typing import List, Dict

class Card:
    """定义单张扑克牌对象"""
    def __init__(self, suit: str, rank: str):
        self.suit = suit
        self.rank = rank

    def __repr__(self) -> str:
        return f"{self.suit}{self.rank}"

class PokerDealer:
    """标准 52 张扑克发牌器"""
    SUITS = ["♠", "♥", "♣", "♦"]
    RANKS = ["2", "3", "4", "5", "6", "7", "8", "9", "10", "J", "Q", "K", "A"]

    def __init__(self):
        # 初始化 52 张标准牌
        self.deck: List[Card] = [Card(s, r) for s in self.SUITS for r in self.RANKS]

    def shuffle_deck(self) -> None:
        """调用标准库底层 Fisher-Yates 算法原地洗牌"""
        random.shuffle(self.deck)

    def deal(self, num_players: int = 4, cards_per_player: int = 12) -> Dict[str, List[Card]]:
        """
        按轮流顺序向多名玩家发牌
        参数:
            num_players: 玩家数量
            cards_per_player: 每位玩家分发的牌数
        返回:
            每位玩家的手牌字典及剩余底牌
        """
        if num_players * cards_per_player > len(self.deck):
            raise ValueError("发牌总数超过了牌堆现有总张数")

        players: Dict[str, List[Card]] = {f"玩家{i+1}": [] for i in range(num_players)}

        # 模拟真实扑克发牌过程:轮流从牌顶抽取
        for _ in range(cards_per_player):
            for i in range(num_players):
                # pop() 每次从末尾以 O(1) 弹出,等价于从洗好牌堆的顶部取牌
                card = self.deck.pop()
                players[f"玩家{i+1}"].append(card)

        return players

if __name__ == "__main__":
    dealer = PokerDealer()
    print("【洗牌前前 5 张牌】:", dealer.deck[:5])

    # 执行洗牌
    dealer.shuffle_deck()
    print("【洗牌后前 5 张牌】:", dealer.deck[:5])

    # 模拟 4 位玩家发牌,每人 12 张
    hands = dealer.deal(num_players=4, cards_per_player=12)
    for player, hand in hands.items():
        print(f"{player} 手牌 ({len(hand)}张): {hand}")

    print(f"剩余底牌 ({len(dealer.deck)}张): {dealer.deck}")
六、随机性实验验证(蒙特卡洛测试)
要直观验证算法是否真正无偏,可以设计一个小型蒙特卡洛验证实验:选取包含 3 个元素 [1, 2, 3] 的列表,理论全排列总数为 $3! = 6$ 种。若均匀洗牌 60,000 次,每种排列出现的理论期望次数应极为接近 10,000 次。
from collections import Counter
import random

def test_shuffle_distribution(trials: int = 60000):
    counts = Counter()
    for _ in range(trials):
        arr = [1, 2, 3]
        random.shuffle(arr)
        counts[tuple(arr)] += 1

    print(f"总试验次数: {trials},各排列期望频次: {trials // 6}")
    for perm, freq in sorted(counts.items()):
        deviation = abs(freq - trials / 6) / (trials / 6) * 100
        print(f"排列 {perm}: 出现 {freq} 次, 相对偏差: {deviation:.2f}%")

test_shuffle_distribution()
在实际运行测试中,各个排列的实际统计频次与理论期望的偏差通常在 1% 以内,完全符合随机过程的大数定律与卡方检验标准。
七、工程实践选型与避坑总结
在实际工程和发牌游戏业务中,除了理解算法原理外,还需要牢记以下几点实现细节:
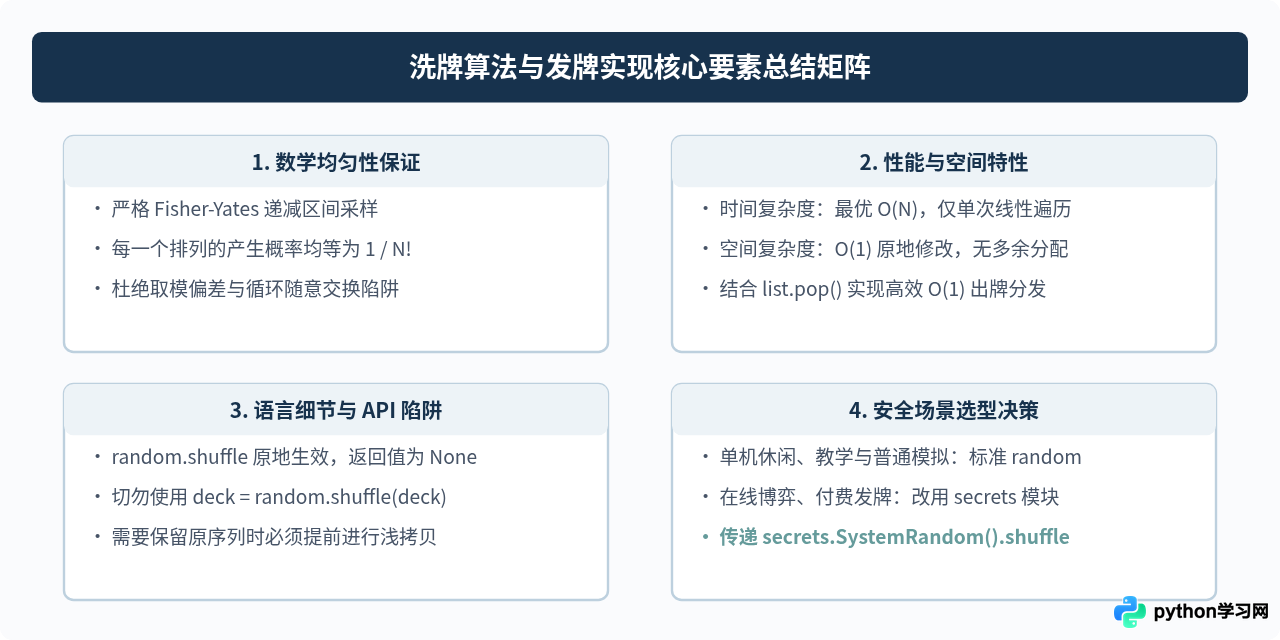
总结:发牌程序的公平性取决于洗牌逻辑的数学无偏性。Python 标准库的 random.shuffle 通过 Fisher-Yates 算法实现了 $O(N)$ 时间与 $O(1)$ 空间的高效原地打乱,配合 MT19937 的巨大状态空间,完全满足普通棋牌游戏的需求。在安全敏感场景下,仅需将随机源替换为 secrets.SystemRandom 即可保证加密级不可预测性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















