


自学Python前需要先掌握计算机基础知识吗
深入分析自学Python前是否需要先系统学习计算机基础知识,对比自底向上与自顶向下的学习路径,梳理真正的极简前置技能与按需回补策略。
核心结论:不需要。自学 Python 不需要先花几个月系统攻读计算机底层基础(如计算机组成原理、操作系统、汇编语言或复杂数据结构)。Python 是一门高度抽象的高级语言,初学者最有效、挫折感最低的路径是“直接动手上手,遇到具体问题再按需回补基础”。
一、两种学习路径的关键差异
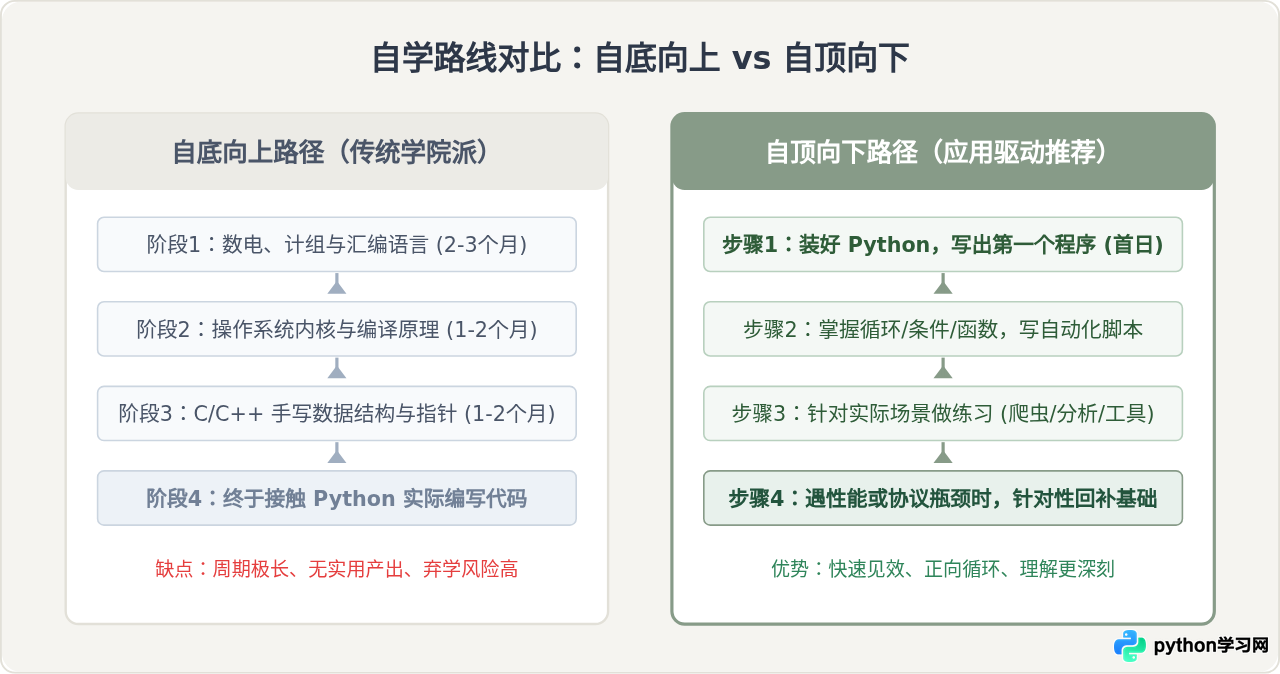
许多初学者在打算学编程时,常常被推荐一份厚重的书单:从二进制逻辑、门电路、计算机体系结构,到操作系统内核与 C 语言。这种传统的“自底向上”学院派路线与现代“自顶向下”应用驱动路线,在实际自学体验上存在本质差异。
传统自底向上路径
学习顺序:硬件电路原理 → 汇编与C语言 → 数据结构与算法 → Python高级语言。
特征与影响:概念高度抽象,前置周期长达数月甚至半年。因为长时间无法做出可见的实用程序,正向反馈极弱,初学者弃学率往往超过八成。
自顶向下按需补充(推荐)
学习顺序:安装运行环境 → 编写首个实用脚本 → 完成具体小需求 → 遇瓶颈回补底层原理。
特征与影响:数小时内即可看到实际运行结果。每一步都有明确的应用目的,在建立信心的同时,带着具体问题去理解底层知识,吸收效率大幅提升。
Python 设计的初衷就是让开发者关注“要解决什么问题”,而不是“底层内存如何分配、寄存器如何翻转”。它内置了自动垃圾回收(GC)、丰富的开箱即用数据结构(如列表与字典),以及庞大的标准库。如果强行把计算机硬件知识作为前置卡点,无异于在学习开车之前先要求学会手磨发动机零件。
二、自学前真正需要掌握的极简常识
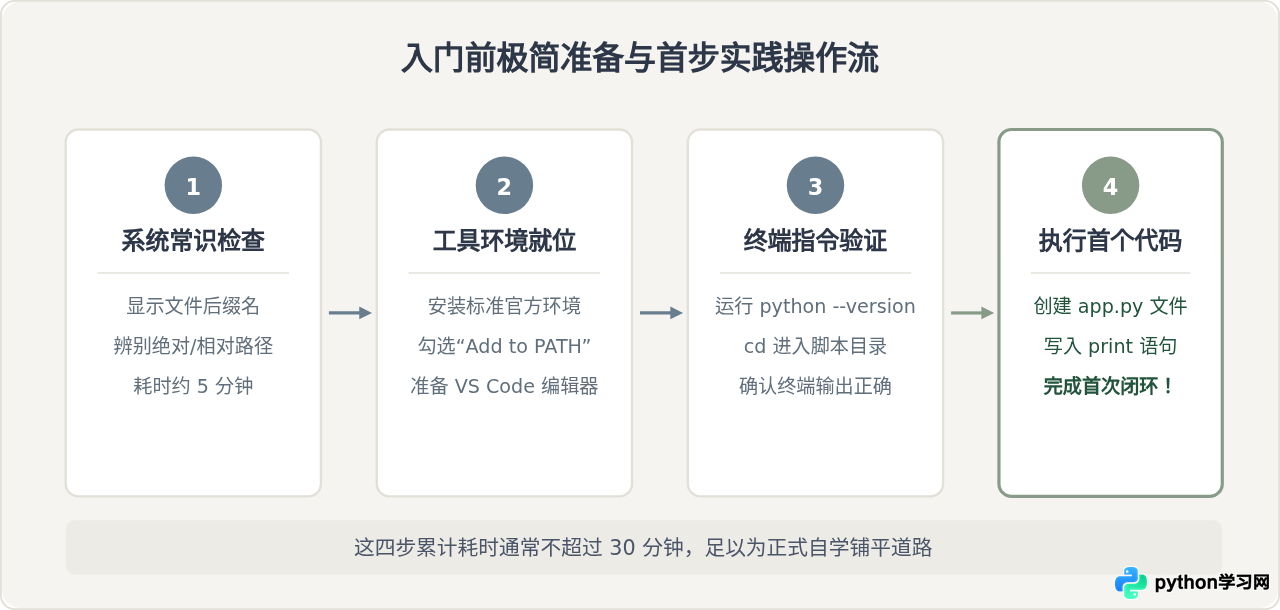
虽然不需要掌握深奥的计算机体系理论,但这并不意味着完全“零常识”。以下三项基础操作与概念,通常只需要花费半小时即可理清,它们是保证你顺利写出第一段代码的基础。
1. 文件扩展名与路径意识
在编写代码前,必须确保操作系统显示了文件的完整后缀名。Python 源码必须保存为 .py 结尾的纯文本文件。初学者常犯的错误包括将文件命名为 hello.py.txt 而不自知,或者在命令行中运行代码时,终端当前所在的文件夹与实际代码文件所在的文件夹不一致。
- 绝对路径:从磁盘根目录出发的完整路径,例如 Windows 下的
C:\Users\username\Desktop\test.py。 - 相对路径:相对于当前工作目录的位置,例如同级目录下的
./test.py。
2. 纯文本与编辑器
代码必须通过纯文本编辑器编写,例如 Visual Studio Code、PyCharm 或基础文本编辑器。切记不能使用微软 Word、WPS 或富文本备忘录保存代码,因为这些文字处理软件会在文件中混入字体样式、页面排版等二进制标记,导致解释器无法解析。
3. 命令行基础操作
掌握三个最基本的终端命令即可开展 Python 学习:
- 切换目录:
cd 文件夹路径(Windows 与 macOS/Linux 通用)。 - 查看当前目录下文件:Windows 下使用
dir,macOS/Linux 下使用ls。 - 运行脚本:
python main.py(或部分系统下的python3 main.py)。
三、进阶过程中如何“按需回补”计算机基础
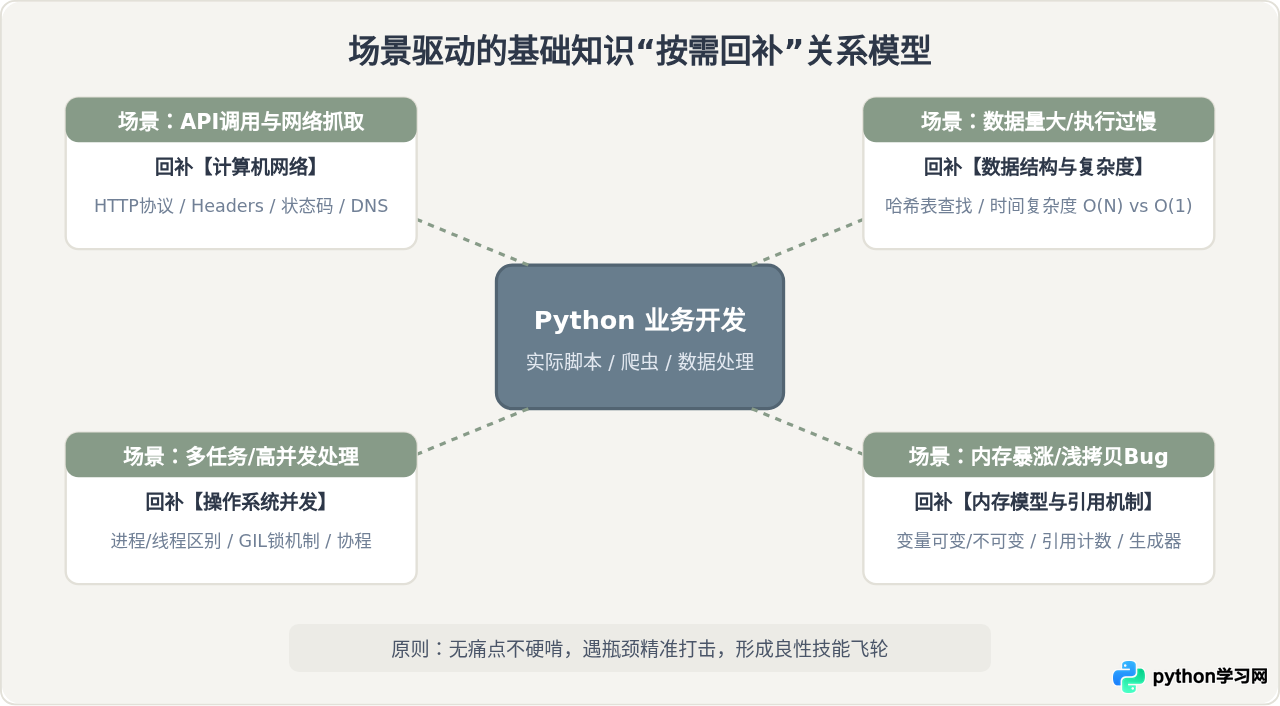
完全不前置学习计算机基础,并不意味着这些基础毫无价值。恰恰相反,在有了一定的代码量后,底层基础是决定开发者能否从“能写代码”跃迁到“写出高效、健壮程序”的核心力量。区别在于:应当在遇到特定应用场景和瓶颈时,带着明确的痛点去回补对应知识。
1. 场景 A:网络爬虫与接口调用时 → 回补网络通信基础
当你初学 Python 并使用 requests 或 urllib 抓取网页或对接 API 时,可能会遇到请求超时、状态码 403 Forbidden、跨域报错或编码乱码。
此时便是学习计算机网络知识的最佳时机。你不需要去背诵 OSI 七层模型的所有细节,而只需重点理解:
- HTTP 协议基础:请求方法(GET 与 POST)、常见的状态码含义(200、301、400、403、500)、请求头(Headers 中的 User-Agent、Cookie 与 Token)。
- 字符编码:明确 UTF-8 与 GBK 的区别,理解字节串(bytes)与字符串(str)在 Python 中的编解码转换关系。
2. 场景 B:处理海量数据或运行迟缓时 → 回补数据结构与算法
当你写了一个脚本去核对 10 万行数据,发现程序卡死运行了十分钟,此时单纯堆砌硬件配置往往解决不了问题。
# 示例:为什么在数据量大时,查询效率差异巨大
data_list = [i for i in range(1000000)]
data_set = set(data_list)

# 列表查询为线性扫描,时间复杂度为 O(N)
# 集合或字典查询采用哈希表定位,时间复杂度为 O(1)
if 999999 in data_set:  # 瞬间完成
pass在这个痛点下,再去学习时间复杂度(大 O 表示法)和哈希表实现机制,你会瞬间明白为什么字典(dict)的查找速度远快于列表(list)。这种由代码瓶颈倒逼的理论学习,记忆深度和理解程度远超单纯看书。
3. 场景 C:多任务与高并发执行时 → 回补操作系统进程与线程
当需要同时下载几百个文件或实时监听多个消息队列时,单线程顺序执行会产生大量等待。此时按需补充操作系统的核心知识:
- 进程(Process):操作系统资源分配的基本单位,内存相互独立。
- 线程(Thread):CPU 调度的基本单位,同一进程内的线程共享内存空间。
- Python 特色机制:理解全局解释器锁(GIL)对 CPU 密集型多线程任务的限制,以及为什么 IO 密集型任务可以使用多线程或
asyncio协程。
四、初学者常见的两大认知误区
许多人花费两个月看完了厚重的大部头教材,却连一个读取 CSV 并统计总和的脚本都写不出来。编程是一项高度依赖肌肉记忆与调试直觉的实践技能。代码报错、看懂 Traceback 堆栈信息、查阅文档并修正的过程,远比被动背诵知识点更能培养解决问题的能力。
不用“提前学”绝不等于“永远不学”。如果写了一年 Python 仍然完全不知道为什么 0.1 + 0.2 != 0.3(浮点数二进制精度问题),或者完全不理解浅拷贝导致的列表嵌套修改异常,就容易遇到难以排查的暗坑。正确的态度是在写过千行代码之后,带着对代码运行的疑问去查漏补缺。
五、自学阶段推进与决策指南
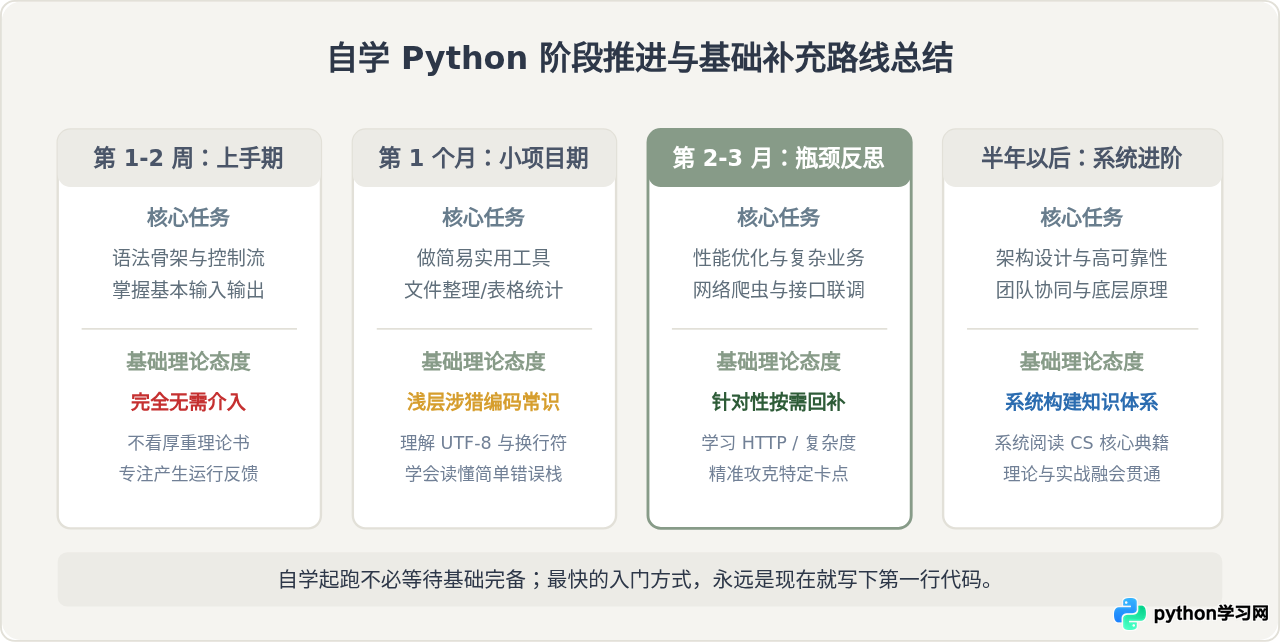
为了让自学过程有章可循,可以按照以下四个阶段来安排自己的学习重心:
- 上手期(前两周):心无旁骛,只学 Python 核心语法(变量、列表、字典、循环、条件判断、函数定义)。目标是能写出 30 到 50 行的自动化小脚本。
- 小项目期(第 1 个月):选定一个小方向(如利用
pandas分析 Excel 表格,或利用requests爬取公开数据),以完成功能为第一目标。 - 瓶颈反思期(第 2-3 个月):当程序运行变慢、出现莫名编码报错或遇到多任务需求时,暂停几天,针对性阅读网络协议或数据结构专项章节。
- 系统强化期(半年以后):当能够独立完成中小型项目后,再去系统通读一本优秀的基础理论书籍,此时你会发现曾经晦涩的理论都与自己的实操经验一一印证。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















