


从零开发Python爬虫项目:Scrapy框架实战详解
深入详解从零开发Python爬虫项目的全流程。基于工业级异步爬虫框架Scrapy,从架构剖析、脚手架搭建、数据解析、翻页循环到持久化管道与中间件配置,提供完整的实战操作代码与避坑指南。
requests 脚本不同,Scrapy 通过将任务调度、网络下载、页面解析与数据持久化解耦为独立组件,能够以极高的并发效率处理大规模结构化抓取任务。本文将从架构设计到工程落地,完整演示一个规范的 Scrapy 爬虫项目的构建过程。
一、Scrapy 架构模型与核心数据流转
在直接书写代码前,必须建立对 Scrapy 运行机制的整体认知。Scrapy 绝不是一个简单的网络请求库,而是一套高度协同的抓取流水线系统。整个系统由引擎(Engine)、调度器(Scheduler)、下载器(Downloader)、爬虫实体(Spiders)以及项目管道(Item Pipeline)五大核心组件协同运转,并外挂了下载中间件与爬虫中间件两组扩展层。
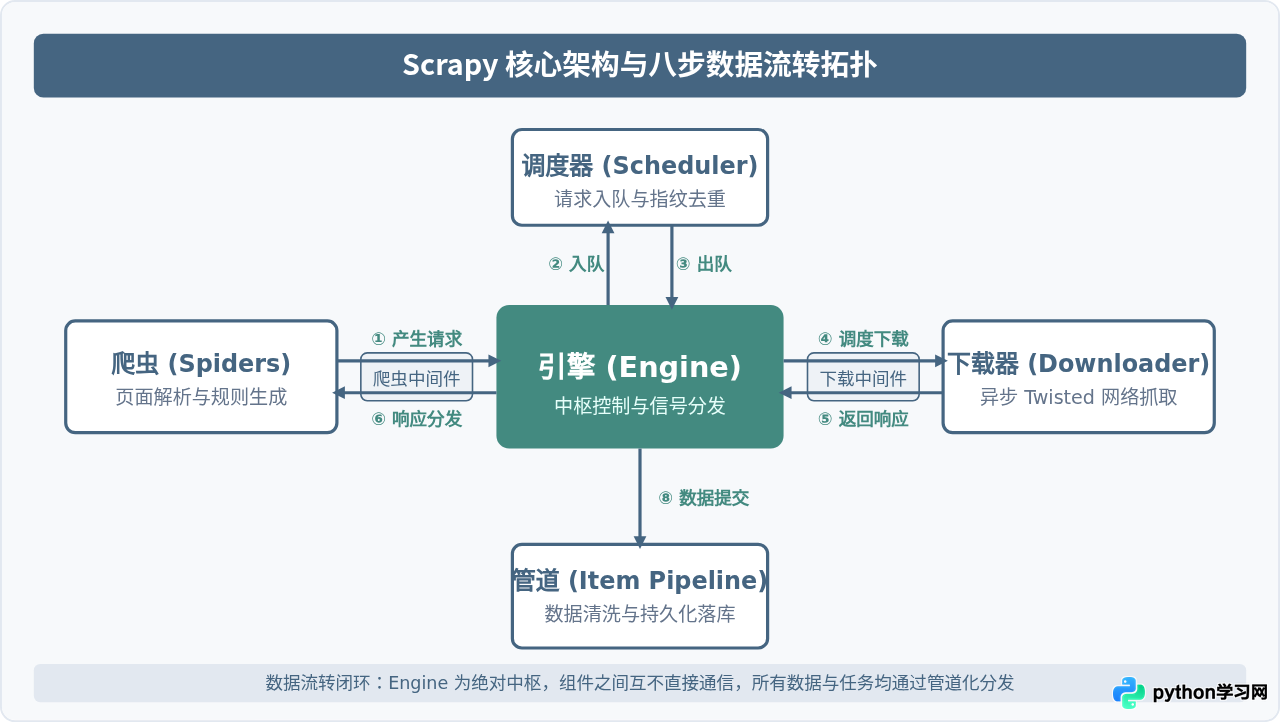
该拓扑结构完整涵盖了单次抓取任务的标准流转:
- 爬虫生成初始请求:Spider 启动并初始化种子 URL,生成
scrapy.Request提交给引擎。 - 引擎移交调度器:引擎将接收到的请求发送至调度器排队入队。
- 调度器释放请求:调度器完成 URL 指纹去重后,按优先级向引擎返回下一个待抓取请求。
- 引擎分发至下载器:请求穿过下载中间件到达下载器,触发底层异步 I/O。
- 下载器生成响应:下载器完成页面资源下载后生成
Response,原路经由下载中间件送回引擎。 - 引擎移交爬虫解析:引擎将
Response经由爬虫中间件投递至 Spider 的解析方法(默认parse)。 - 爬虫解析输出两类产物:Spider 解析提取出结构化数据(Item)或新的待爬链接(Request),重新交由引擎处理。
- 持久化与新循环:引擎将提取到的 Item 移交给 Item Pipeline 进行清洗和入库,同时将新的 Request 重新送入调度器排队,形成高效抓取闭环。
二、环境搭建与项目工程化脚手架
构建 Scrapy 项目的首要原则是坚持虚拟环境隔离。由于 Scrapy 依赖底层 C 扩展编译库(如 lxml 和 Twisted 依赖项),在隔离环境下可以避免系统全局包冲突。
1. 虚拟环境初始化与核心库安装
# 1. 创建并激活 Python 虚拟环境 (以 Python 3.10+ 为例)
python3 -m venv scrapy_env
source scrapy_env/bin/activate  # macOS / Linux
# Windows 环境运行: scrapy_env\Scripts\activate

# 2. 升级 pip 并安装 Scrapy
pip install --upgrade pip
pip install scrapybrew install openssl 或 apt install libxml2-dev libxslt1-dev)补齐即可。
2. 使用 CLI 脚手架生成标准工程
进入工作目录后,使用 Scrapy 内置脚手架命令生成标准的项目骨架。假设本次实战任务为抓取公开的书籍目录数据(以官方测试站点 books.toscrape.com 为例):
# 创建项目骨架
scrapy startproject book_scraper

# 进入项目工作区
cd book_scraper

# 使用 genspider 命令快速生成爬虫模板 (指定爬虫名 与 允许的目标域名)
scrapy genspider books books.toscrape.com
生成的项目标准目录层次如下:
book_scraper/
│── book_scraper/             # 项目 Python 模块根目录
│   ├── spiders/              # 爬虫实现代码目录
│   │   ├── __init__.py
│   │   └── books.py          # 刚才生成的具体爬虫逻辑
│   ├── __init__.py
│   ├── items.py              # 数据实体模型定义(字段规范)
│   ├── middlewares.py        # 下载中间件与爬虫中间件扩展
│   ├── pipelines.py          # 数据清洗、验证与数据库持久化管道
│   └── settings.py           # 项目全局配置(并发数、延迟、User-Agent 等)
└── scrapy.cfg                # 部署配置文件,包含项目名与 settings 指向
三、项目实战开发全流程路线
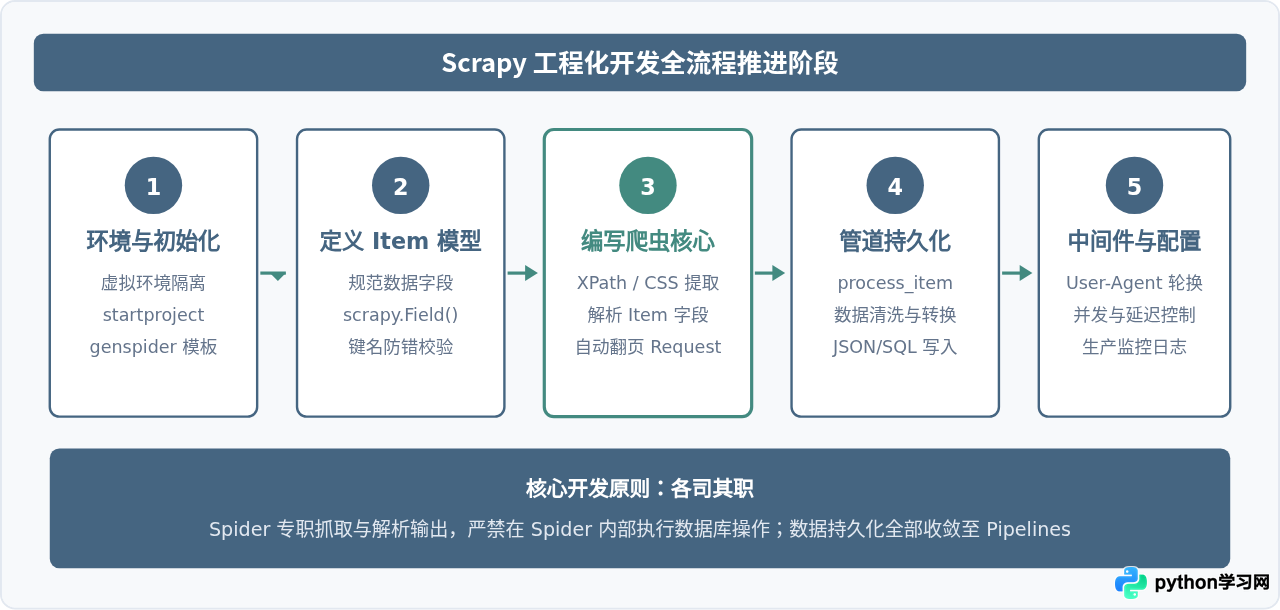
开发一个结构严谨的 Scrapy 爬虫项目,遵循自底向上的五阶段流水线模型:从定义数据实体开始,到编写提取规则、构建自动翻页、配置清洗管道,最后进行全局并发调优。
四、代码实战:从字段定义到分页爬取
1. 定义结构化数据模型 (items.py)
在 book_scraper/items.py 中定义我们需要收集的图书字段。使用 Item 类代替原生字典(dict)的最大好处在于:如果爬虫代码中出现了拼写错误的键名,Scrapy 会在赋值时立即抛出 KeyError,而原生 dict 则会把错误静默传递到后续环节。
# book_scraper/items.py
import scrapy

class BookItem(scrapy.Item):
    title = scrapy.Field()       # 书籍标题 (str)
    price = scrapy.Field()       # 价格文本 (str, 如 "£51.77")
    rating = scrapy.Field()      # 评分等级 (str, 如 "Three")
    in_stock = scrapy.Field()    # 库存状态 (bool)
    detail_url = scrapy.Field()  # 详情页绝对链接 (str)
2. 编写核心爬虫逻辑与解析方法 (spiders/books.py)
打开 book_scraper/spiders/books.py。爬虫类继承自 scrapy.Spider,必须提供三个基础要素:唯一的 name、初始爬取清单 start_urls,以及响应解析入口 parse(self, response)。
# book_scraper/spiders/books.py
import scrapy
from book_scraper.items import BookItem

class BooksSpider(scrapy.Spider):
    name = "books"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["https://books.toscrape.com/catalogue/page-1.html"]

    def parse(self, response):
        # 1. 定位当前页面上所有的图书卡片容器
        book_nodes = response.css("article.product_pod")

        for node in book_nodes:
            item = BookItem()

            # 提取书名:从 h3 内 a 标签的 title 属性中获取完整标题
            item["title"] = node.css("h3 a::attr(title)").get()

            # 提取价格:文本格式如 "£51.77"
            item["price"] = node.css("div.product_price p.price_color::text").get()

            # 提取评级:从 class 中解析评分 (例如 "star-rating Three")
            rating_classes = node.css("p.star-rating::attr(class)").get("").split()
            item["rating"] = rating_classes[1] if len(rating_classes) > 1 else "Unknown"

            # 提取库存状态:判断文本中是否包含 In stock
            stock_text = node.css("div.product_price p.instock::text").getall()
            joined_stock = "".join(stock_text).strip()
            item["in_stock"] = "In stock" in joined_stock

            # 提取并拼接详情页绝对 URL
            relative_url = node.css("h3 a::attr(href)").get()
            item["detail_url"] = response.urljoin(relative_url)

            # 将提取到的实体提交给引擎
            yield item

        # 2. 翻页调度逻辑:定位下一页链接并生成新请求
        next_page = response.css("li.next a::attr(href)").get()
        if next_page is not None:
            # 自动将相对路径拼接为完整 URL
            next_url = response.urljoin(next_page)
            # yield 一个新的 Request,指定由 parse 继续处理下一页
            yield scrapy.Request(url=next_url, callback=self.parse)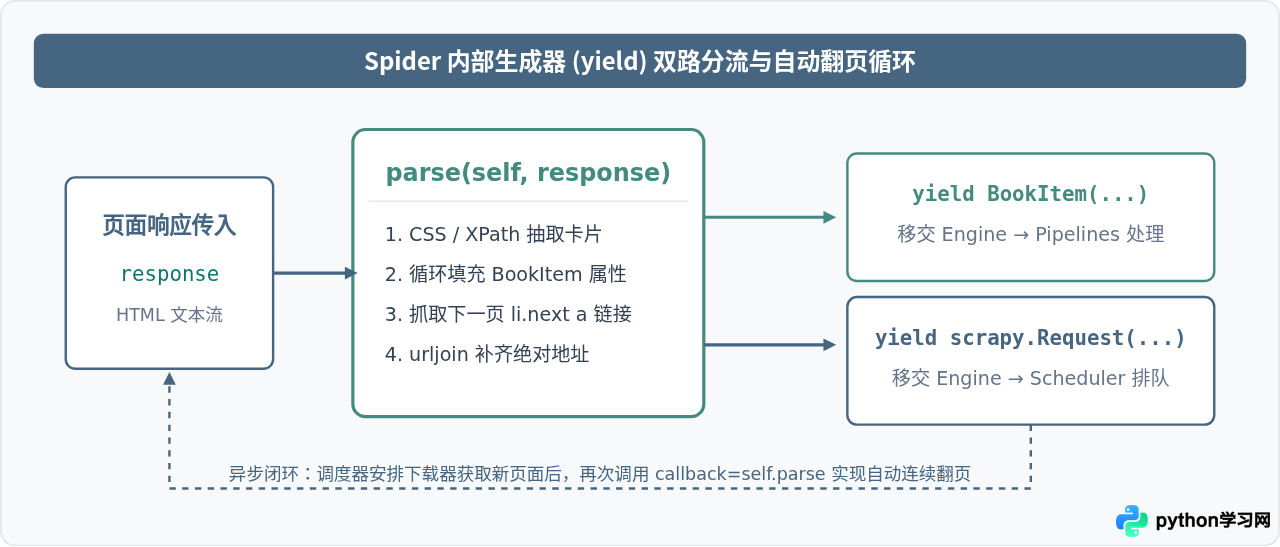
五、数据管道清洗与持久化落库 (pipelines.py)
当 Spider 输出 Item 后,数据会按照 settings.py 中定义的权重依次流经各个 Pipeline。每个 Pipeline 都可以对数据执行类型转换、异常过滤(通过抛出 DropItem 丢弃残缺数据)或者写入本地文件与关系型数据库。
# book_scraper/pipelines.py
import json
import re
from scrapy.exceptions import DropItem

class CleanDataPipeline:
    """管道 1:数据清理与类型标准化"""
    RATING_MAP = {
        "One": 1,
        "Two": 2,
        "Three": 3,
        "Four": 4,
        "Five": 5
    }

    def process_item(self, item, spider):
        # 1. 标题去除首尾空白
        if item.get("title"):
            item["title"] = item["title"].strip()
        else:
            raise DropItem(f"丢弃无标题数据: {item}")

        # 2. 价格字符串提取纯数字浮点值 (例如 "£51.77" -> 51.77)
        price_raw = item.get("price", "")
        price_match = re.search(r"[\d.]+", price_raw)
        if price_match:
            item["price"] = float(price_match.group())
        else:
            item["price"] = 0.0

        # 3. 评级文本转换为 1-5 整数
        item["rating"] = self.RATING_MAP.get(item.get("rating"), 0)

        # 必须返回 item,以便后续管道继续处理
        return item


class JsonLinesExportPipeline:
    """管道 2:将清洗后的数据逐行写入 JSON Lines 文件"""
    def open_spider(self, spider):
        # 爬虫开启时触发:打开输出文件
        self.file = open("books_cleaned.jsonl", "w", encoding="utf-8")

    def close_spider(self, spider):
        # 爬虫关闭时触发:安全关闭文件流
        self.file.close()

    def process_item(self, item, spider):
        # 将 item 转为字典序列化为 JSON 字符串写入
        line = json.dumps(dict(item), ensure_ascii=False) + "\n"
        self.file.write(line)
        return item
六、中间件扩展与反爬工程化配置 (settings.py)
爬虫的抓取稳定性主要取决于中间件与配置参数的协同。Scrapy 提供了细粒度的流量与并发控制选项。
1. 核心运行参数矩阵
| 配置项名称 | 推荐设置值 | 设计作用与防封说明 |
|---|---|---|
ROBOTSTXT_OBEY |
False (实战视情况) |
是否严格遵守 robots.txt,测试或授权抓取场景下可关闭以避免初始拦截。 |
CONCURRENT_REQUESTS |
8 ~ 16 |
全局最大并发请求数。根据目标服务承受能力调整,避免压垮对端服务器。 |
DOWNLOAD_DELAY |
0.5 ~ 1.5 |
相邻请求间隔秒数。引入合理间隔可有效规避基于单位时间频率的流控。 |
RANDOMIZE_DOWNLOAD_DELAY |
True |
开启随机延迟波幅(0.5 * delay 至 1.5 * delay),使请求时间离散化。 |
COOKIES_ENABLED |
False |
默认禁用 Cookie,防止目标网站通过 Cookie 追踪抓取行为。 |
ITEM_PIPELINES |
字典形式分配权重 | 数字越小(1-1000)优先级越高,数据先经过数字小的管道。 |
2. 编写随机请求头下载中间件 (middlewares.py)
# book_scraper/middlewares.py
import random

class RandomUserAgentMiddleware:
    """在请求发送前随机注入真实浏览器的 User-Agent"""
    UA_LIST = [
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/17.2 Safari/605.1.15",
        "Mozilla/5.0 (X11; Linux x86_64; rv:109.0) Gecko/20100101 Firefox/121.0"
    ]

    def process_request(self, request, spider):
        ua = random.choice(self.UA_LIST)
        request.headers["User-Agent"] = ua
        # 返回 None 表示继续交给后续下载中间件处理
        return None
3. 在 settings.py 中激活管道与中间件
# book_scraper/settings.py
BOT_NAME = "book_scraper"

SPIDER_MODULES = ["book_scraper.spiders"]
NEWSPIDER_MODULE = "book_scraper.spiders"

# 遵守 robots.txt 策略
ROBOTSTXT_OBEY = False

# 并发与频率控制
CONCURRENT_REQUESTS = 16
DOWNLOAD_DELAY = 1.0
RANDOMIZE_DOWNLOAD_DELAY = True

# 禁用 Cookie 追踪
COOKIES_ENABLED = False

# 激活下载中间件 (数值决定执行顺序)
DOWNLOADER_MIDDLEWARES = {
    "book_scraper.middlewares.RandomUserAgentMiddleware": 400,
}

# 激活数据持久化管道
ITEM_PIPELINES = {
    "book_scraper.pipelines.CleanDataPipeline": 300,        # 优先执行清洗
    "book_scraper.pipelines.JsonLinesExportPipeline": 400,  # 再写入文件
}

# 日志输出等级
LOG_LEVEL = "INFO"
七、运行调试与生产级最佳实践
完成上述代码与配置后,即可在终端启动爬虫。Scrapy 提供了丰富的 CLI 工具用于调试与运行。
1. 交互式调试利器:scrapy shell
在正式编写或修改选择器规则时,强烈建议使用 scrapy shell <url> 进行交互式验证,无需每次都重启整个项目:
# 进入 Scrapy 交互式控制台
scrapy shell "https://books.toscrape.com/catalogue/page-1.html"

# 在控制台中直接试验选择器
>>> response.css("h3 a::attr(title)").get()
'A Light in the Attic'
>>> len(response.css("article.product_pod"))
20
2. 启动正式任务与运行结果验证
# 启动爬虫任务
scrapy crawl books

# 也可以直接通过 -o 参数导出临时文件 (支持 csv / json / jsonlines)
scrapy crawl books -o raw_export.json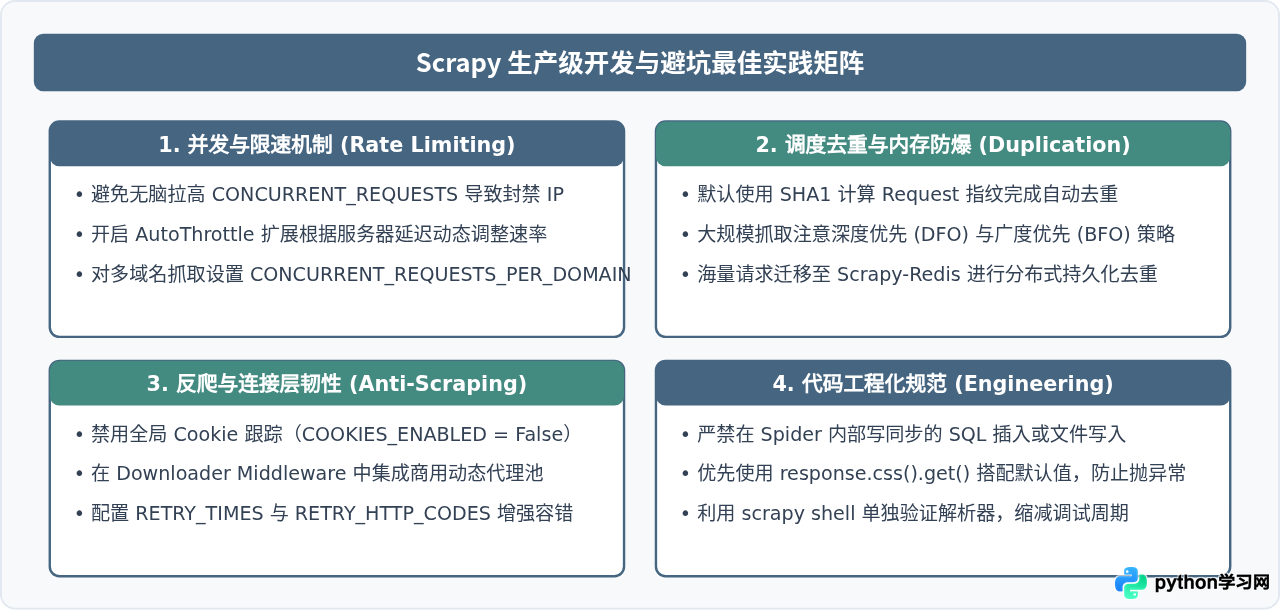
parse() 方法内部直接调用同步数据库库(如 pymysql 或 sqlite3)。因为 Scrapy 是单线程事件循环机制,任何同步阻塞的 I/O 操作都会导致整个引擎冻结,彻底失去并发优势。所有数据库持久化工作必须放在 Item Pipeline 中完成,且在数据量极大时推荐使用 Twisted 提供的 twisted.enterprise.adbapi 实现异步非阻塞落库。
八、全文总结
从零开发一个高质量的 Python 爬虫项目,关键在于充分利用 Scrapy 的组件化架构优势:
- 职责分离:Spider 仅负责抓取策略与数据解析,Item 规范字段契约,Pipeline 专职清洗与落库,Middleware 负责网络层面的加固与伪装。
- 事件驱动:借助 Twisted 异步并发模型,在低资源消耗下实现稳定、高效的批量采集。
- 防御性编程:配合请求随机化延迟、规范的异常捕获与重试机制,使爬虫程序具备极强的容错能力。
掌握这一套标准流程后,无论是单站点的千万级深度爬取,还是后续扩展为基于 Scrapy-Redis 的分布式集群架构,都具备了清晰坚实的工程基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















