


为什么Python不需要像C++那样包含头文件
深入解析为什么Python不需要像C++那样使用#include包含头文件。从C++的单编译单元与静态声明模型,到Python的运行时动态加载、模块对象自描述与命名空间查找机制,系统梳理两种语言在设计哲学与实现机制上的核心差异。
.py 文件都是自包含的执行单元,import 语句在运行时动态加载模块并构建命名空间字典,所有类型与属性均由模块对象自身在内存中实时解析。
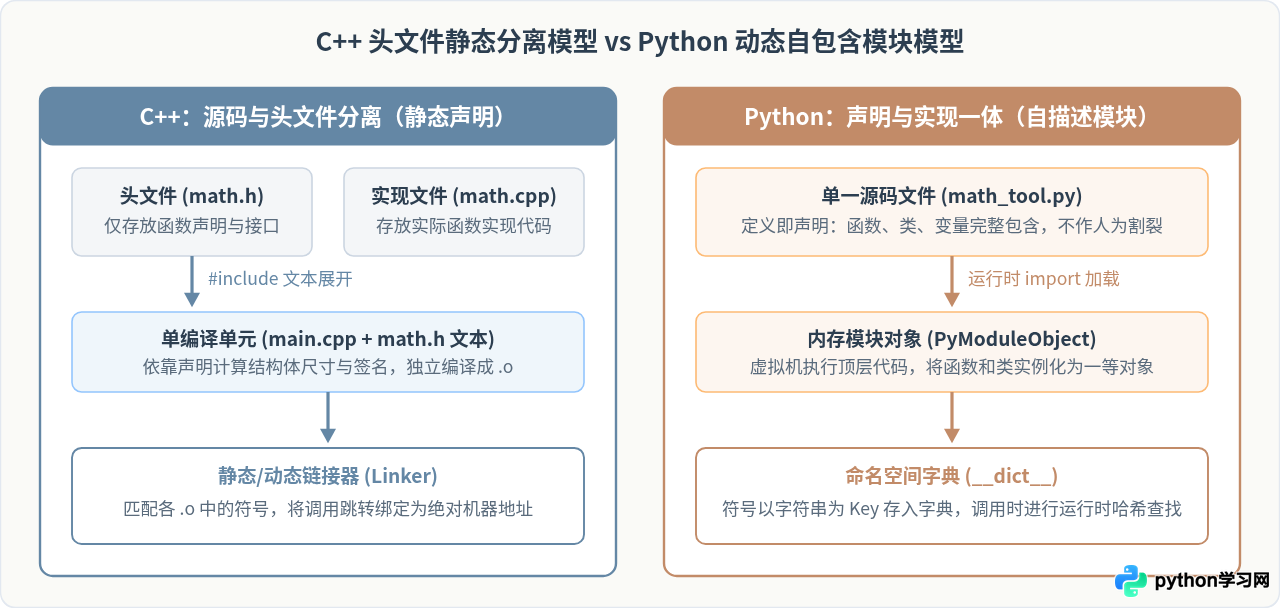
C++ 为什么离不开头文件:静态编译与单编译单元
要理解 Python 为什么能省去头文件,必须先看清 C++ 为什么必须依赖头文件。C++ 诞生于系统级编程与硬件资源极度受限的时期,其核心设计理念是“零运行时开销”与“编译期完全确定”。这一理念直接决定了 C++ 的编译管线特征:
- 先行声明原则(Forward Declaration):C++ 编译器按顺序扫描源码,当它看到一个函数调用
calculate(x)或变量定义Point p;时,必须在此之前就知道该符号的原型。编译器需要确切知道参数类型、返回值类型以及类对象的精确内存字节大小,以便在栈上分配空间并生成对应的 CPU 机器指令。 - 独立的单编译单元(Translation Unit):C++ 编译器一次只独立编译一个
.cpp源文件。在编译main.cpp时,编译器完全看不到math.cpp的内容。为了让main.cpp通过语法和类型检查,开发者必须通过#include "math.h"把函数声明引入进来。 - 预处理器的机械展开:C/C++ 的
#include本质上是预处理器的“文本复制粘贴”。它在真正编译前把头文件内的所有宏、类型定义和函数声明逐行展开到源文件中。 - 链接器后置组装:编译阶段生成的
.o目标文件中只记录了对外部符号的引用名字;最终由链接器(Linker)遍历所有目标文件和库文件,把真实的内存地址回填到调用指令处。
Python 的模块机制:import 语句在运行时做什么
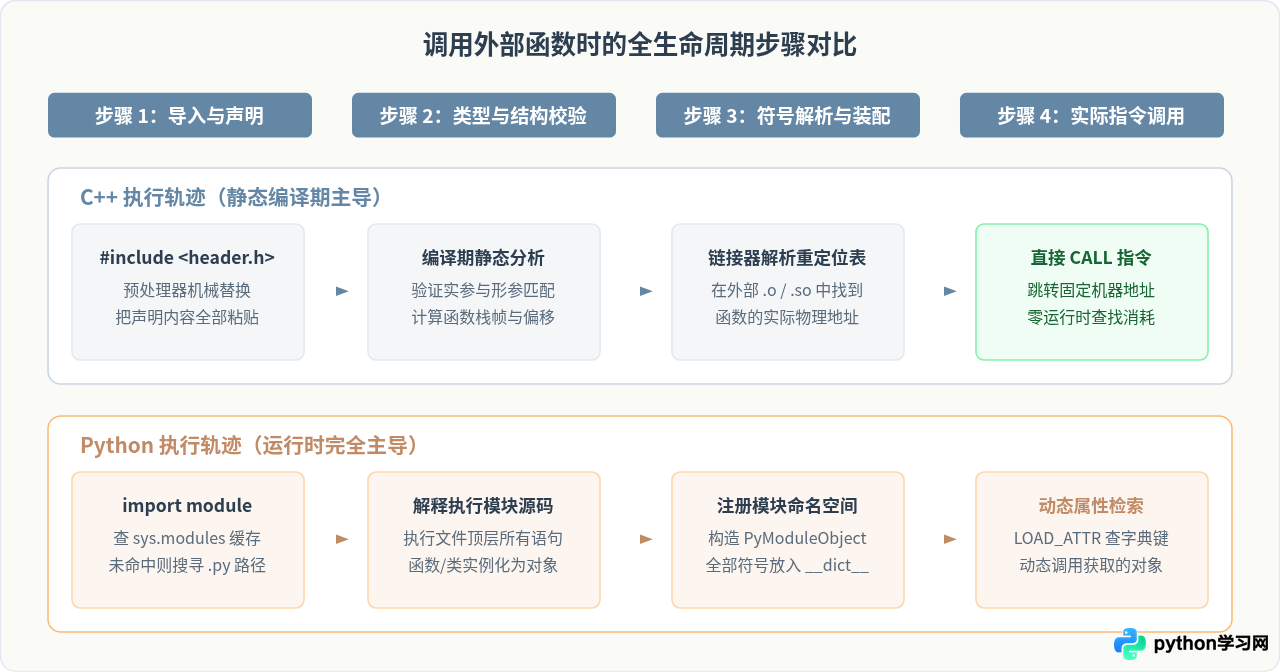
在 Python 中,根本没有所谓“声明”与“定义”的语法界限。写下一个函数 def add(a, b): return a + b 时,它既是声明也是定义。当另一个文件执行 import my_module 时,并不是预处理器在复制文本,而是一段真实的 Python 解释器内部执行流。
具体而言,Python 执行 import 时的完整操作步骤如下:
- 检查已加载模块缓存(
sys.modules):解释器首先查询全局字典sys.modules。如果该模块已经被加载过,直接返回已存在的模块对象,绝不重复解析或执行代码。 - 定位文件路径(Finders & Loaders):若缓存中未命中,模块导入系统遍历
sys.path包含的所有目录,根据模块名寻找匹配的.py源码文件、.pyc字节码文件或 C 扩展动态库。 - 编译并执行顶层代码:找到文件后,解释器将其源码编译为 Python 字节码,并为一个全新的独立命名空间(全局字典)执行该字节码。所有的
def、class和全局赋值语句在这个阶段被依序执行。 - 创建模块对象并挂载:执行完毕后,解释器实例化一个
types.ModuleType对象,将刚才执行过程中生成的全局字典绑定为该模块对象的__dict__,并登记到sys.modules。 - 当前作用域符号绑定:最后,将这个模块对象引用绑定到当前调用上下文的局部变量中。
没有头文件,Python 如何完成符号解析?
C++ 之所以需要头文件中的函数原型与类声明,是为了在编译期回答两个致命问题:“这个对象占用多大内存空间?” 以及 “调用的函数到底存不存在、接受什么参数?”。Python 完全不需要头文件回答这两个问题,因为它的底层架构依赖两项动态特性:
1. 堆上统一对象模型与指针传递
在 C++ 中,当你在函数内部声明局部对象 std::string s; 时,编译器必须确切知道 sizeof(std::string),以便在当前栈帧分配 24 或 32 个字节。如果不知道大小,编译就会彻底中断。但在 Python 中,一切皆对象,所有变量本质上都是指向 PyObject 的指针。指针的大小在 64 位系统上永远是固定的 8 字节。无论是整数、字符串还是自定义类实例,虚拟机分配引用时根本不需要事先了解其内部构造。
2. 自描述的模块对象与动态命名空间
Python 的模块不仅是代码逻辑的聚合体,更是运行时的实体对象。每一个导入的模块都会生成一个专属的符号字典 __dict__。这个字典完整记录了模块内部所有的属性、函数对象、类定义和文档字符串。这意味着模块本身具备完整的自描述性(Self-describing)和运行时自省能力(Introspection)。
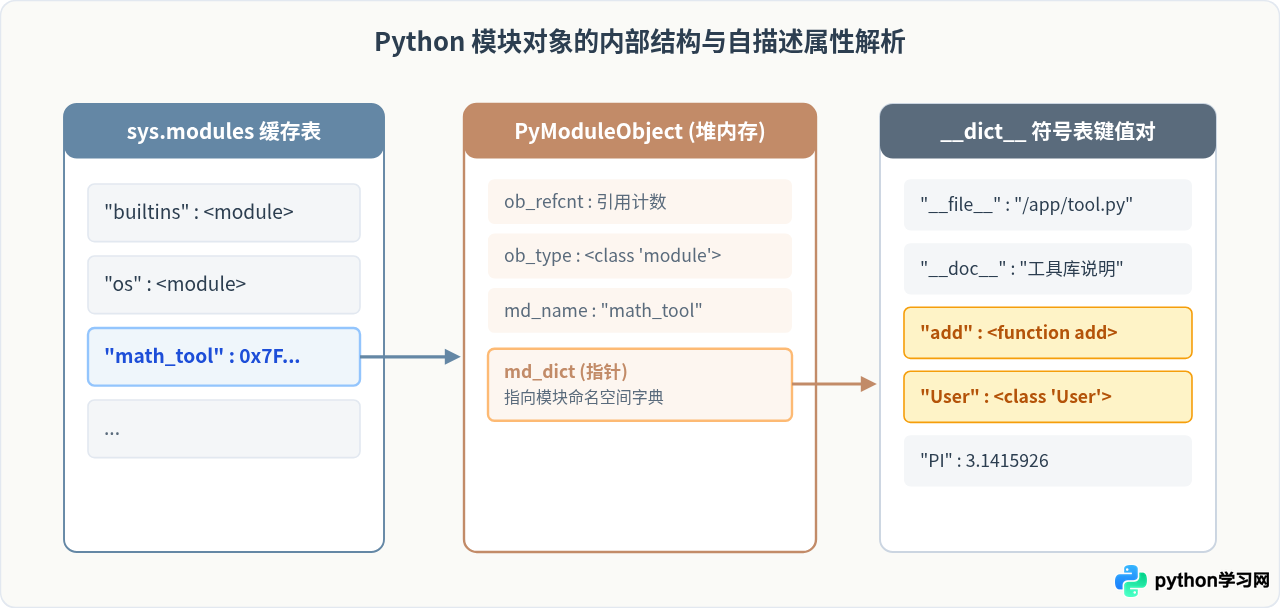
当开发者编写 math_tool.add(10, 20) 时,Python 底层执行的操作相当于:
# 伪代码:Python 解释器在执行 math_tool.add 时的内部逻辑
module_obj = sys.modules.get("math_tool")
target_func = module_obj.__dict__.get("add")
if target_func is None:
    raise AttributeError("module 'math_tool' has no attribute 'add'")
return target_func(10, 20)这种纯粹的动态属性查找机制意味着:被调用的模块本身就是自己最好的说明书。调用方无需任何外部头文件来声明接口,解释器在运行时随时随地都能“自问自答”。
两种设计哲学的代价与权衡
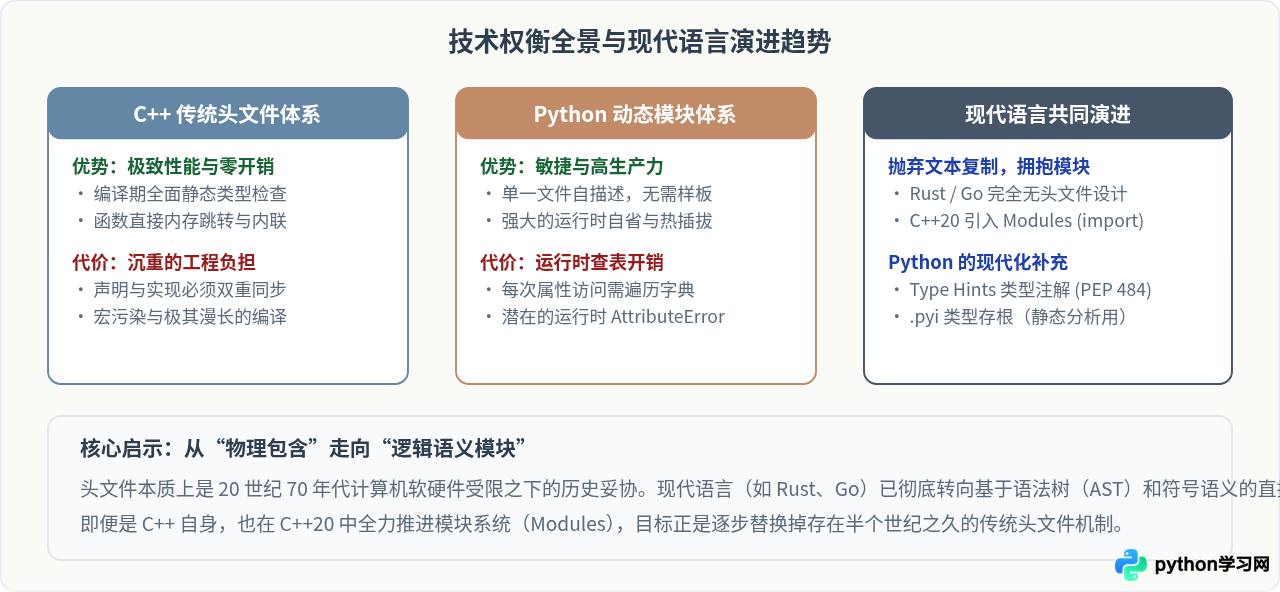
不需要头文件让 Python 拥有极其简洁的开发体验,但软件工程中不存在免费的午餐。头文件的存在与否,体现了两种截然相反的设计哲学:
- C++ 选择了极致的运行时性能与严格的编译期安全:通过头文件与强类型系统,C++ 编译器能把函数调用内联(Inline)优化为几条汇编指令,消除一切间接查找开销。其代价是开发者必须手工维护
.h与.cpp的双重接口,并且面临预处理宏污染、头文件循环依赖以及漫长缓慢的编译等待时间。 - Python 选择了极致的开发效率与动态表达力:省去头文件大幅减少了样板代码,单文件自成体系使得脚本编写、热重载(Reloading)和跨平台分发变得轻巧自如。其代价则是属性解析转移至运行时带来的执行开销,以及静态检查能力的天然缺失(拼写错误必须等到代码真正执行才能暴露)。
容易混淆的常见疑问与避坑指南
1. Python 中的 .pyi 存根文件是不是头文件?
在大型 Python 项目或 C 扩展包中,你经常能看到扩展名为 .pyi 的文件(如在标准库 typeshed 中)。这容易让人误以为 Python 最终还是回归了“头文件”。
.pyi 绝不是 C++ 意义上的头文件。
.pyi纯粹服务于 IDE 代码提示(如 VS Code / PyCharm)与离线静态检查工具(如mypy、pyright)。- 在程序真正运行时,Python 解释器完全忽略
.pyi文件的存在。即便删掉全部.pyi文件,代码依然能正常运行;而 C++ 缺少头文件在编译期就会立刻崩溃。
2. 为什么 Python 也会出现“循环导入”(Circular Import)?
很多从 C++ 转来的开发者在 Python 中遇到 ImportError: cannot import name 'X' from partially initialized module 时会感到困惑:“既然不需要头文件,为什么还会循环引用冲突?”
原因在于执行时机的不同:
- C++ 的循环引用发生在预编译与链接期,通常由头文件守卫(
#pragma once或#ifndef)避免重复展开,并通过前向声明(class B;)解决定义死锁。 - Python 的循环引用发生在代码运行时。当
a.py执行到一半去import b,而b.py又在顶层去from a import func时,由于a.py尚未执行完全部顶层语句,func尚未被写入其__dict__字典,此时访问就会报出“部分初始化模块”错误。
解决方法:将循环引用的 import 移动到函数内部延迟加载,或者重构架构将公共数据提取到第三方独立的底层模块中。
总结
回顾核心问题:为什么 Python 不需要像 C++ 那样包含头文件?
答案可以用一句话概括:C++ 的头文件是为静态编译器的单文件孤立编译、内存布局计算与链接定位服务的;而 Python 拥有运行时的动态加载器、统一的指针对象模型以及自包含的模块字典。这种语言架构层面的根本差异,使得 Python 天生具备了消除头文件的能力,把符号关联的责任从编译期文本预处理器,完全交给了运行时的虚拟机。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















