


Python元组不能修改怎么更新数据?
深入解析Python元组不可变特性的底层逻辑,提供转列表更新、切片拼接、解包重构、可变对象引用及namedtuple等多种实际更新元组数据的方法与性能选型建议。
很多刚学习 Python 的开发者在尝试通过索引给元组赋值时,都会遇到 TypeError: 'tuple' object does not support item assignment 报错。Python 的元组(tuple)是不可变序列,一旦在内存中创建,其结构、长度以及包含的元素引用就无法被原位修改。直接回答标题的核心问题:想要更新元组数据,物理上不能改动原对象,但可以通过“类型转换中转”、“切片重构生成新元组”、“利用元组内的可变对象”或“使用命名元组的替换接口”来实现业务上的数据更新。
一、为什么元组不可变?理解背后的更新机制
在寻找解决方法前,有必要先弄清不可变性的底层含义。在 Python 的对象模型中,不可变对象指的是该对象在内存中的属性和指针序列无法改变。这一设计赋予了元组固定的哈希值,使其能够作为字典的键(Key)或集合(Set)的成员,同时也带来了更高的访问效率与数据安全性。
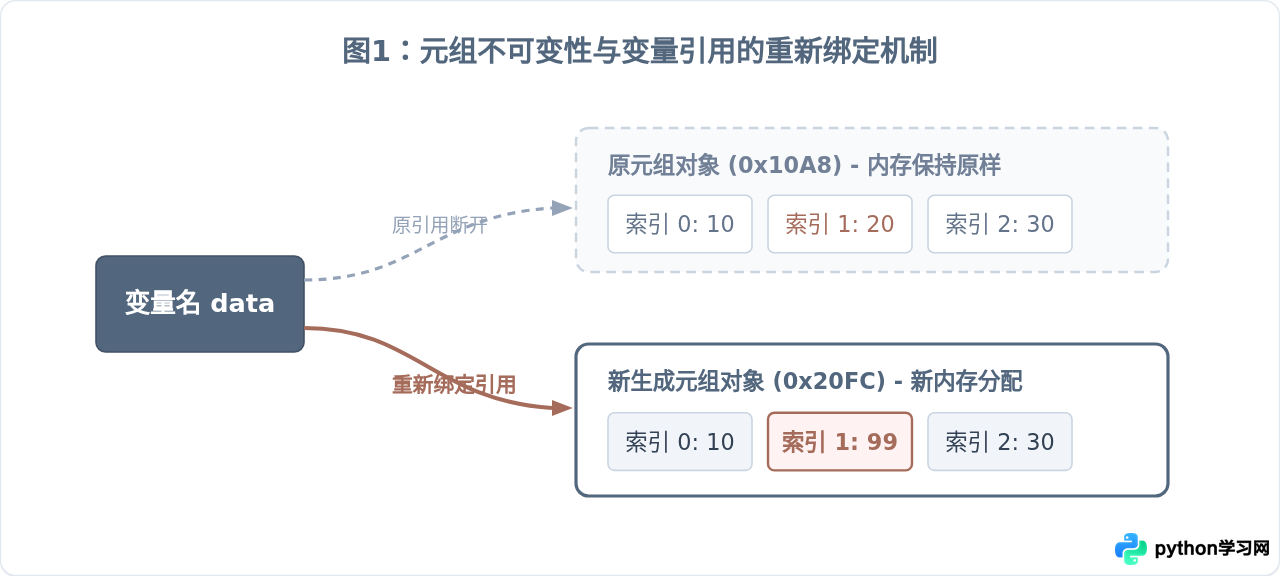
当我们谈论“更新元组数据”时,实际上是在用一个包含新内容的新元组,去替换变量名原本绑定的旧元组。变量名本质上是一个指针,重新赋值只是改变了指针的朝向,旧元组如果没有其他引用,就会在随后的垃圾回收机制中被释放。
二、方法一:转换为列表操作后再转回元组
这是最符合直觉且适用面最广的解决方案。由于 Python 的列表(list)是高度优化的可变序列,支持灵活的增删改操作,我们可以把元组转为临时列表完成操作,再通过 tuple() 构造回元组。
代码实现步骤
# 初始元组
original_tuple = ("苹果", "香蕉", "橙子")

# 步骤 1:转为可变列表
temp_list = list(original_tuple)

# 步骤 2:对列表进行常规更新(支持修改、追加、删除)
temp_list[1] = "西瓜"         # 修改指定索引位置的值
temp_list.append("葡萄")      # 在末尾追加元素

# 步骤 3:重新打包为元组并回赋
updated_tuple = tuple(temp_list)

print(updated_tuple)
# 输出示例:('苹果', '西瓜', '橙子', '葡萄')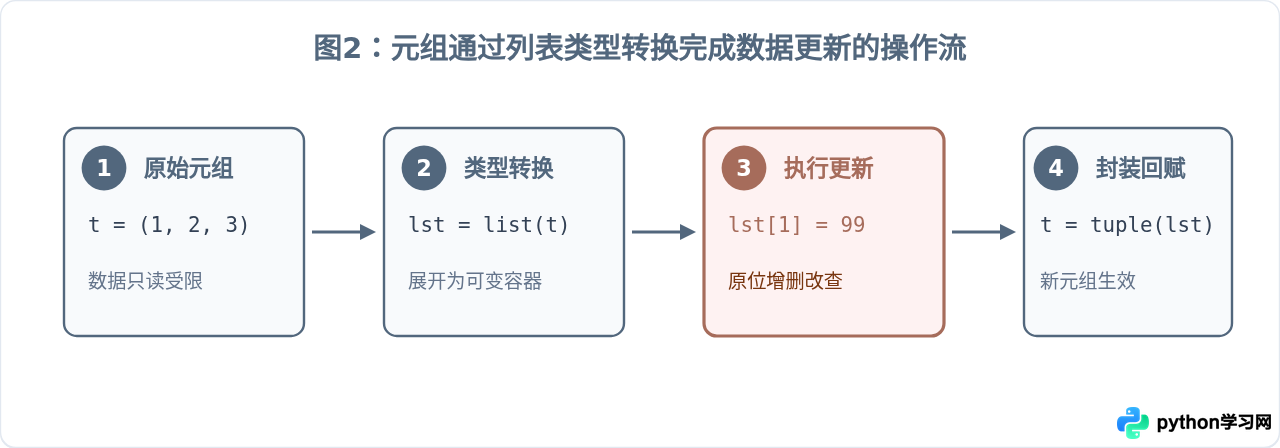
当你需要对元组进行较为复杂的改动(例如既要修改某个元素,又要删除另一项,甚至还要重排)时,这种方法最不易出错。但注意:该方法会产生一次完整的列表复制及一次元组构建,如果数据规模极大且处于高频循环内,会有额外的内存与分配开销。
三、方法二:利用切片(Slice)与解包拼接构建新元组
如果你只需要更新某一个特定位置的元素,或者在特定位置插入新项,完全不需要动用 list()。Python 的元组支持加法运算符(+)与星号解包语法(*),通过切片可以高效提取未改变的部分并拼装新元组。
1. 切片加法拼接
items = ("A", "B", "C", "D")

# 假设需要把索引为 2 的 "C" 替换成 "X"
index_to_update = 2
new_value = "X"

# 使用切片提取前后部分,并与包含新元素的单项元组相加
# 注意:(new_value,) 后的逗号不可省略!
updated_items = items[:index_to_update] + (new_value,) + items[index_to_update + 1:]

print(updated_items)
# 输出示例:('A', 'B', 'X', 'D')
2. 星号解包拼接(Python 3.5+ 推荐)
星号解包语法更加灵活直观,省去了拼装单元素元组时容易漏写逗号的烦恼:
numbers = (10, 20, 30, 40)

# 替换索引 1 处的 20 为 999
new_numbers = (*numbers[:1], 999, *numbers[2:])

# 在末尾追加元素
appended_numbers = (*numbers, 50)

print(new_numbers)        # 输出示例:(10, 999, 30, 40)
print(appended_numbers) # 输出示例:(10, 20, 30, 40, 50)在 Python 中,单纯的括号 (new_value) 会被解析器当做普通的数学运算符括号,其类型依然是内部数据的类型。只有加上逗号 (new_value,),Python 才会将其识别为包含单个元素的元组。如果漏掉逗号直接与元组相加,会抛出 TypeError: can only concatenate tuple (not "str") to tuple 错误。
四、方法三:元组包含可变对象时的“原位更新”
很多开发者会产生一个误解,认为“元组不可变意味着元组里的所有数据都绝对固定”。但实际上,元组的不可变性仅约束其直接持有的元素引用(即内存指针)。
如果元组的某个元素是一个可变容器(例如 list 或 dict),该容器本身的引用地址是固定不变的,但我们可以对这个容器内部的数据进行原位修改。
# 包含列表的元组
user_record = ("Alice", [95, 88, 92], {"role": "admin"})

# 直接修改列表内容
user_record[1].append(100)

# 修改字典键值
user_record[2]["status"] = "active"

print(user_record)
# 输出示例:('Alice', [95, 88, 92, 100], {'role': 'admin', 'status': 'active'})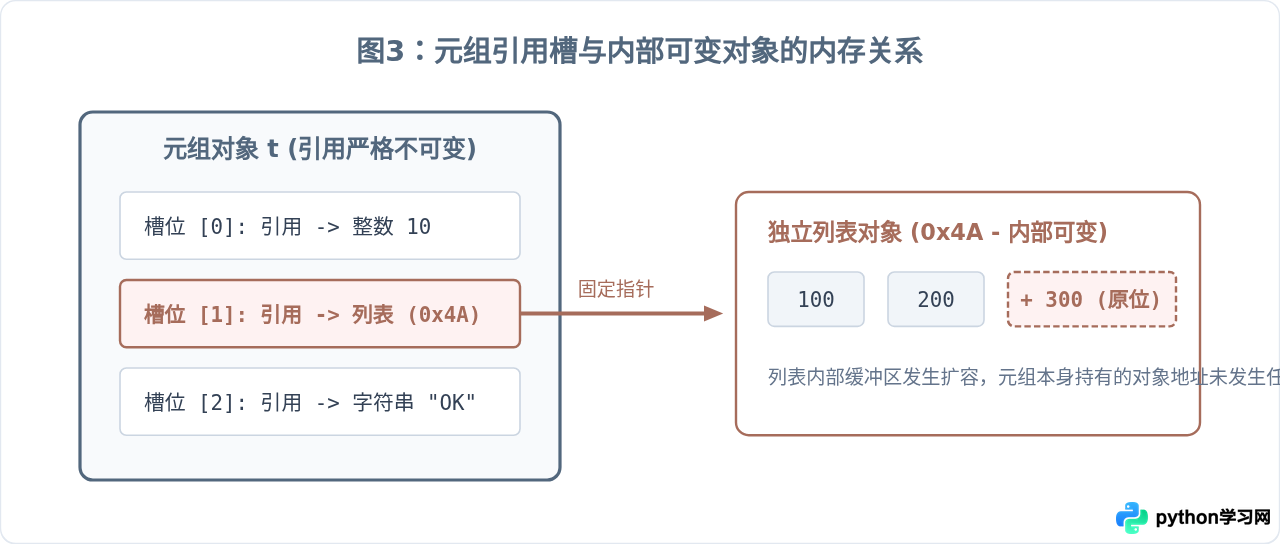
虽然这种技巧可以“更新”元组展现的内容,但它破坏了元组的哈希纯洁性。如果一个元组内包含列表等不可哈希元素,那么执行 hash(t) 会立即抛出 TypeError: unhashable type: 'list',这意味着该元组将无法再作为字典的 Key 或存入集合。
五、方法四:结构化数据使用命名元组(namedtuple)与 _replace
如果你的元组不仅是一串无序数据的集合,而是带有字段意义的“记录”(例如存储坐标、用户信息或数据库单行记录),强烈建议使用 Python 标准库 collections.namedtuple。
namedtuple 提供了一个专门用于更新字段并返回新元组的官方方法:_replace()。它的代码表现力远高于切片索引。
from collections import namedtuple

# 定义命名元组结构
User = namedtuple("User", ["id", "username", "role"])

# 实例化对象
current_user = User(id=101, username="ZhangSan", role="editor")

# 使用 _replace() 更新指定字段(返回一个全新的 namedtuple 实例)
updated_user = current_user._replace(role="admin")

print(current_user)
# 原始数据未受影响:User(id=101, username='ZhangSan', role='editor')

print(updated_user)
# 输出新对象:User(id=101, username='ZhangSan', role='admin')
六、方案对比与技术选型指南
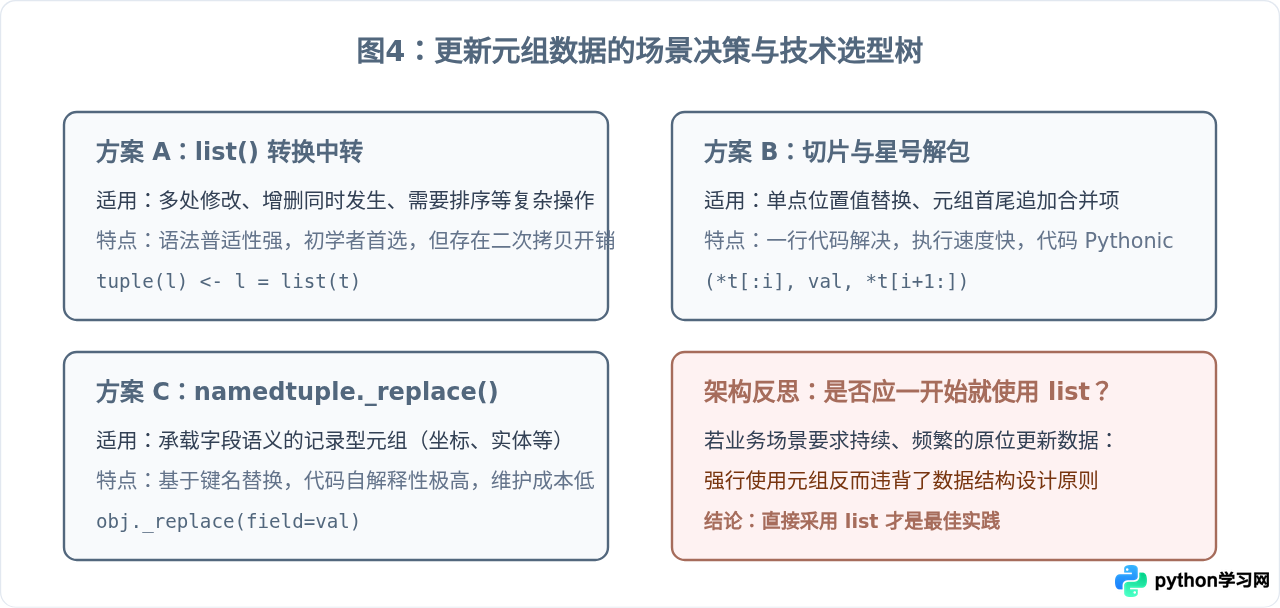
在实际项目工程中,不同更新手段适用的场景与代价各不相同。根据需求特征,可以参考以下综合决策图表与选型对比:
| 更新方案 | 典型代码范例 | 性能开销 | 主要优势 | 潜在短板 |
|---|---|---|---|---|
| 列表转换法 | tuple(list(t)...) |
中等(2次对象全量拷贝) | 灵活度最高,支持所有列表方法 | 代码略显繁琐,大数据量时稍慢 |
| 切片拼接法 | t[:i] + (x,) + t[i+1:] |
较低(浅拷贝切片区间) | 代码简洁直接,适合单值变动 | 多位置批量更新时表达式繁冗 |
| 解包重构法 | (*t[:i], x, *t[i+1:]) |
较低(原生解包执行快) | 可读性好,无单元素逗号隐患 | 需要掌握 Python 3.5+ 解包语法 |
| 命名元组替换 | nt._replace(key=v) |
较低(生成新 namedtuple) | 语义极佳,避免魔术数字索引 | 必须提前定义 namedtuple 类 |
七、总结
面对“Python元组不能修改怎么更新数据”这一问题,关键在于认清两点:
- 尊重数据不可变约束:元组天生为“只读”和“防窜改”而设计。在 Python 运行时内部,原元组无法被原位写入,所有合法的更新手段都是通过产生新元组并重绑定变量引用来完成的。
- 按需选择应对方案:对于偶发性的单值调整,优先使用切片或解包拼接;对于复杂的整体修改或批量增删,先转为
list是最稳妥的路径;对于结构化业务对象,选用namedtuple._replace()兼顾安全与可读性。如果发现程序需要高频动态修改序列成员,应当果断将数据类型重构为list。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















