


Python中为什么推荐用dict.get()而不是直接通过键访问字典
深入对比Python中dict.get()与直接键索引dict[key]的区别、执行机制与适用场景,通过流程图示与实际代码示例,详细解析推荐使用dict.get()的核心原因与最佳工程实践。
dict[key] 虽直观,但遇到不存在的键时会立即抛出 KeyError 并打断程序运行;而调用 dict.get(key, default) 方法不仅可以在键缺失时平稳返回指定的默认备选值,还能显著减少冗余的分支校验代码,是保障系统健壮性与可读性的核心实践。
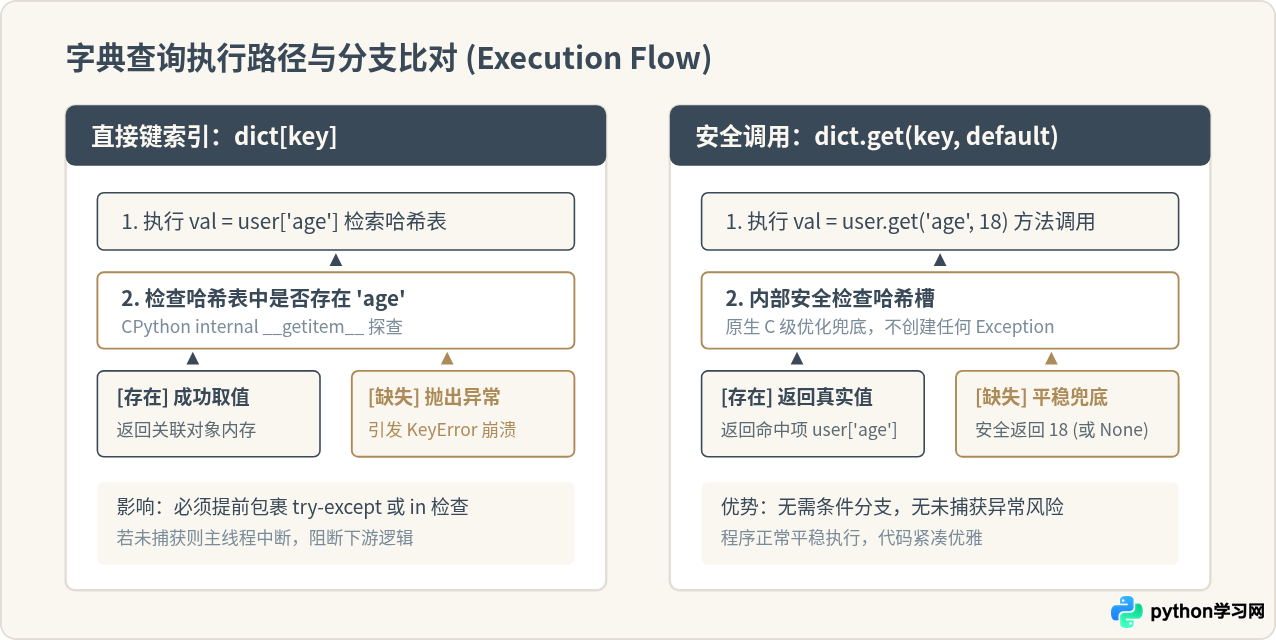
一、核心机制对比:直接索引与 get() 方法的底层差异
Python字典基于哈希表实现,键查找的时间复杂度平均为 O(1)。然而在对未定义键的处理逻辑上,直接下标访问([])与 get() 方法有着本质区别:
- 直接键访问
dict[key]:作为Python序列与映射容器的标准下标语法,其设计原则是“严格契约”。解释器在哈希槽中寻找目标键,一旦未命中,便直接构建并抛出KeyError异常对象。如果不通过显式的try-except或if key in dict进行预检,整个调用栈将即刻中断。 - 方法调用
dict.get(key, default=None):属于内置的高级查询接口。当键存在时,它与直接访问完全等效;当键不存在时,底层并不触发异常,而是直接将预设的default参数(默认是None)作为函数返回值交付给调用方。
二、推荐使用 dict.get() 的四大核心原因
1. 杜绝未知数据引发的非预期崩溃
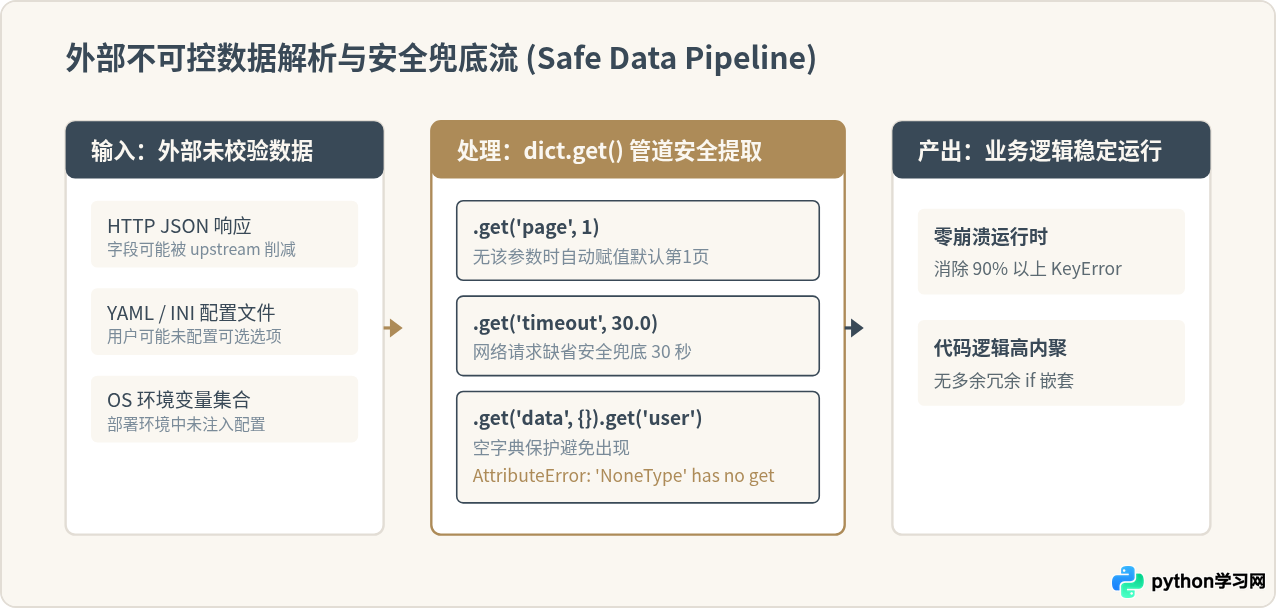
在实际生产环境中,字典内容往往来自于第三方服务接口响应(JSON)、用户提交的表单、本地动态配置文件或数据库无结构字段。这些外部数据源天然具备“非强保障性”:接口字段可能会升级变更、某个选填参数在请求中可能直接缺失。
如果使用直接键索引,只要数据提供方漏传了一个字段,整个进程就可能直接中断。而使用 dict.get(),系统能够从容接受不完整的数据集,保证服务持续在线。
2. 原生支持默认值,消除大量冗余代码
当某个配置项未设置时,我们通常需要给予一个合理的初始默认值(如分页大小、超时时间、默认开关状态)。直接使用下标索引与使用 get() 的代码复杂度差异显而易见:
# 传统方式:多层防御性检查
if "timeout" in config:
    timeout_val = config["timeout"]
else:
    timeout_val = 30

# 或者使用异常捕获(冗长且影响执行流直观性)
try:
    timeout_val = config["timeout"]
except KeyError:
    timeout_val = 30

# 推荐方式:dict.get() 单行表达意图
timeout_val = config.get("timeout", 30)
可以看到,dict.get() 仅需一行代码,就将“查找键”与“缺失时设定后备值”两个操作原子化地表达出来,极大地提升了代码的可读性和维护效率。
3. 避免额外的两次哈希查找开销
很多开发者为了防止 KeyError,喜欢先使用 if key in d: 校验,然后再用 d[key] 取值。这种写法不仅多占用了两行代码,而且在逻辑上对字典执行了两次独立的哈希计算与槽位探测。
而 dict.get() 是由底层的 C 代码一次性完成寻址与缺失判断的。在键缺失或存在的场景下,get() 内部只进行单次哈希查找,执行路径更加高效纯粹。
4. 能够优雅处理 None 值与不存在键的逻辑语义
有时字典中可能合法存储着值为 None 的键。直接使用 get(key) 默认返回 None,如果需要准确区分“键不存在”还是“键存在但值为 None”,get() 允许我们传递一个哨兵对象(Sentinel):
_SENTINEL = object()

val = data.get("status", _SENTINEL)
if val is _SENTINEL:
    print("键 'status' 在字典中根本不存在")
elif val is None:
    print("键 'status' 存在,但其被显式赋值为了 None")
else:
    print(f"键 'status' 的实际业务值为: {val}")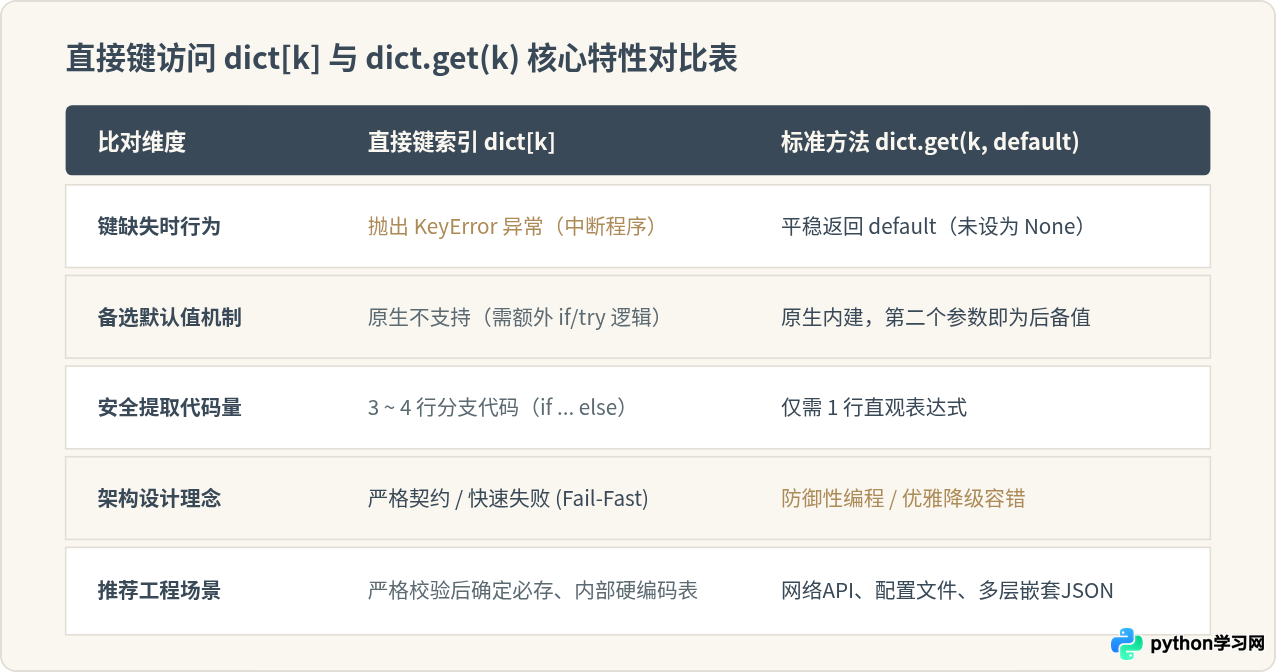
三、典型应用场景与实战技巧
1. 稳健解析多层嵌套的复杂 JSON 结构
在微服务与开放API调用中,返回的数据结构往往层层嵌套。若中途某一层对象为空或者缺少父节点,使用直接索引会导致层层崩塌:
response_data = {
    "status": "success",
    "data": {
        "user": {
            "name": "张三"
            # 注意:此处没有 "settings" 键
        }
    }
}

# 危险写法:一旦 user 或 settings 缺失,立刻引发 KeyError 导致服务中断
# theme = response_data["data"]["user"]["settings"]["theme"]

# 安全写法:利用 get() 的链式调用与空字典兜底
theme = (
    response_data
    .get("data", {})
    .get("user", {})
    .get("settings", {})
    .get("theme", "light")
)
print(f"当前主题配置: {theme}")  # 输出: 当前主题配置: light
每一级 .get() 都配置了一个空字典 {} 作为后备默认值,即使上层节点全为空,链式调用也能一路顺畅地流转到最深处的 "light" 默认值,全程无任何异常抛出。
2. 频次统计与累加运算
在处理数据词频统计或分组累加时,初学者经常会写出多行判断。利用 get() 指定默认值为 0,可以极大压缩统计代码:
words = ["python", "dict", "get", "python", "hash", "dict"]
frequency = {}

for w in words:
    # 键存在时取当前频次,不存在时初始化为 0 并加 1
    frequency[w] = frequency.get(w, 0) + 1

print(frequency)
# 运行输出示例: {'python': 2, 'dict': 2, 'get': 1, 'hash': 1}
四、什么时候仍然应该使用直接索引 dict[key]?
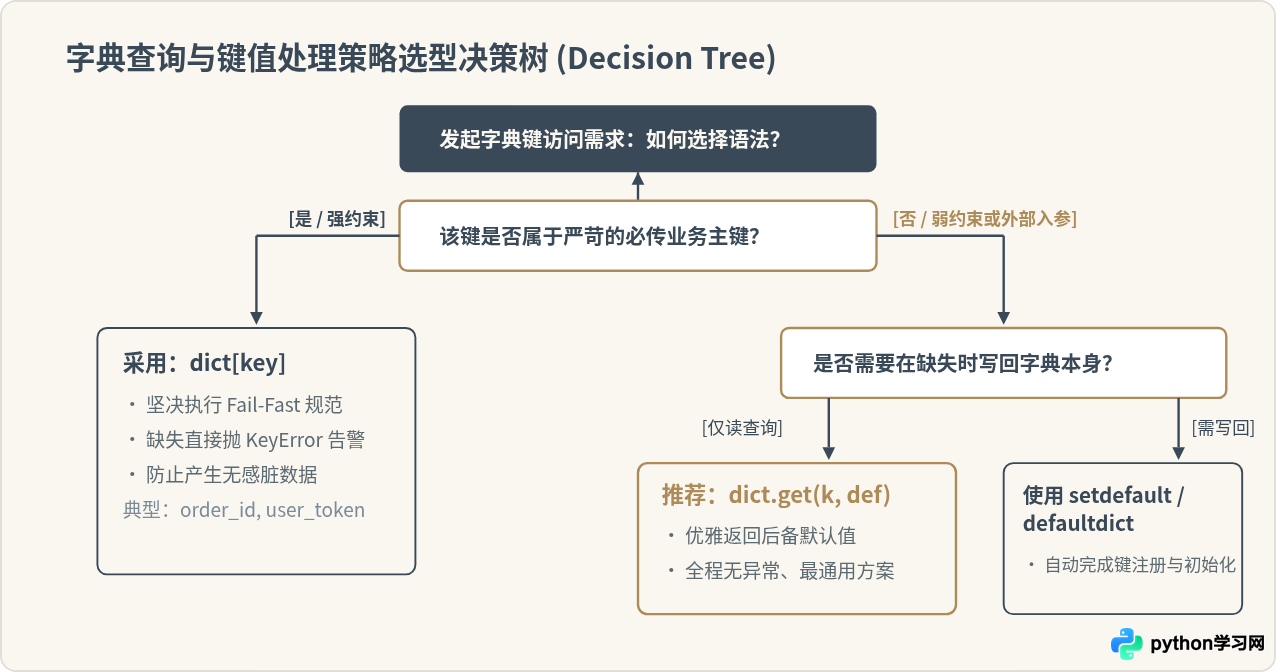
尽管 dict.get() 优势显著,但并不意味着所有字典访问都应该盲目替换为 get()。在软件工程中,选择何种语法必须结合业务语义与错误契约:
-
必须满足“快速失败”(Fail-Fast)原则的关键契约:
如果某个键(例如数据库记录中的主键 ID、用户身份凭证 Token)在数据结构中是绝对必填的,一旦缺失说明上游逻辑存在严重漏洞或数据损坏。此时使用
get()默默返回None反而会“掩盖真相”,将问题推迟到不可预测的后续逻辑才暴露。这种情况下,使用dict[key]立即触发KeyError是最合理的做法。 -
赋值与就地更新操作:
dict.get()属于只读探测方法,无法用于键的赋值操作。如果需要更新字典中的值,必须使用dict[key] = value;如果需要在键不存在时顺便在字典中插入默认对象,则应当使用dict.setdefault()或collections.defaultdict。 -
极端高频循环下的微秒级性能调优:
在极少数性能极端敏感的核心计算循环内(例如每秒执行上千万次查表),直接执行操作码
BINARY_SUBSCR(即d[k])比通过方法查找并建立函数栈帧调用d.get(k)要快 10%~20% 左右。当然,这一微小的性能差距在常规业务中基本可以忽略不计。
五、总结
之所以在大多数业务代码与教程规范中极力推荐使用 dict.get(),核心原因在于“防患于未然”的防御性编程哲学。它以极具表达力的一行代码,把易碎的“直接寻址”改造成了自带容错屏障的“安全查询”。
非关键输入与外部数据优先用 dict.get(),赋予系统优雅降级与缺省兜底能力;
强一致性契约与必填主键坚持用 dict[key],坚守快速失败防线,避免脏状态扩散。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















