


Python中partition与split在字符串分割截取时的区别
详细对比Python中str.partition与str.split两个核心字符串方法的区别,深入解析返回类型、分隔符保留、未匹配边界行为及安全解包场景,帮助开发者准确选型。
核心结论:str.partition() 专为“以首个分隔符将字符串切分为两半”而设计,恒定返回包含 (前缀, 分隔符, 后缀) 的三元组,保留分隔符本身且解包绝不报错;而 str.split() 专为“多段切分或词项提取”设计,返回由各片段构成的列表,默认丢弃分隔符且切分数量随匹配次数变化。
在日常 Python 字符串处理中,开发者频繁需要解析配置项、提取文件名后缀、切分 URL 或提取键值对。面对这些截取需求,str.split() 和 str.partition() 是最常被拿来使用的两个内置方法。表面上看它们都能依据指定字符切割文本,但由于两者在返回值类型、分隔符保留机制、切分次数以及未找到分隔符时的回退逻辑上存在本质差异,若选型不当,极易在生产环境中引发 ValueError 解包异常或产生难以察觉的截断漏洞。
一、核心机制与返回结构对比
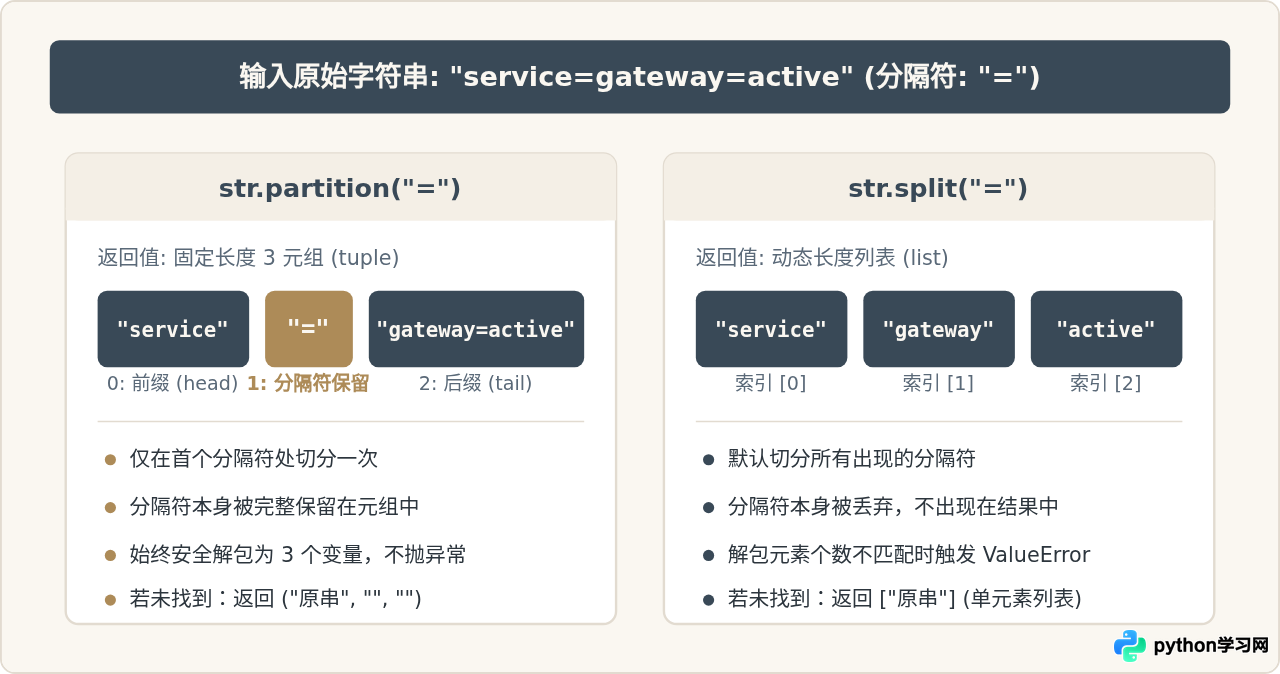
理解两者的最直接切入点是观察其返回值的结构与元素的保留方式。我们通过一个具体的键值对字符串来说明它们的基础行为差异:
raw_text = "service=gateway=active"

# 使用 partition 进行分割
res_part = raw_text.partition("=")
print(type(res_part), res_part)
# 示例输出: <class 'tuple'> ('service', '=', 'gateway=active')

# 使用 split 进行分割
res_split = raw_text.split("=")
print(type(res_split), res_split)
# 示例输出: <class 'list'> ['service', 'gateway', 'active']
从上面的示例可以清晰看到两处根本性的不同:
- 返回值类型与长度稳定性:
partition("=")返回的是不可变元组(tuple),其长度永远固定为 3;而split("=")返回的是列表(list),其长度取决于等号在字符串中出现的次数。 - 分隔符的去留:
partition()忠实保留了用于分割的分隔符"=",并将其放在元组的中间(索引为 1 的位置);而split()在分割完成后直接将分隔符从结果中剔除。 - 切分截止点:
partition()遇到第一个等号就立即停止分割,剩余的所有内容完整保存在后缀中;split()默认会扫描整串文本,切分出全部片段。
二、分割执行原理与参数机制详解
除了外在的表现形式,深入两者的内部扫描逻辑与参数支持,能帮助我们更精准地掌握性能与边界。
1. partition 的执行机制与 rpartition
str.partition(sep) 接收且只接收一个参数 sep,该参数不能为全局默认或空字符串。其内部实现高度优化:底层 C 语言代码从左向右顺序检索,一旦遇到第一个匹配子串,立即申请一个固定 3 槽位的元组对象,分别填入匹配点前的内容、分隔符本身以及匹配点后的全部内容,然后直接返回,不再继续扫描剩余字符串。
如果业务需求是从右向左查找最后一个分隔符(例如提取文件拓展名或日志最后一段标签),Python 提供了孪生方法 str.rpartition(sep)。当目标分隔符不存在时,两者的填充规则非常直观且有规律:
s.partition(sep)未找到匹配时:返回(s, '', ''),即原字符串被置于首位,后两项为空字符串。s.rpartition(sep)未找到匹配时:返回('', '', s),即原字符串被置于末位,前两项为空字符串。
2. split 的参数机制与空白切分特性
str.split(sep=None, maxsplit=-1) 具备两个可选参数:
sep:指定分隔字符。当为None(即默认无参调用s.split())时,会触发特殊的“空白符连续折叠算法”,将换行符\n、制表符\t、空格等连续空白视为单一分隔符,并自动去除首尾空白。maxsplit:最大分割次数。若指定为1(即s.split(sep, 1)),它同样只切割一次,但结果仍然是list,且分隔符依旧被丢弃。
三、边界条件与解包安全性防线
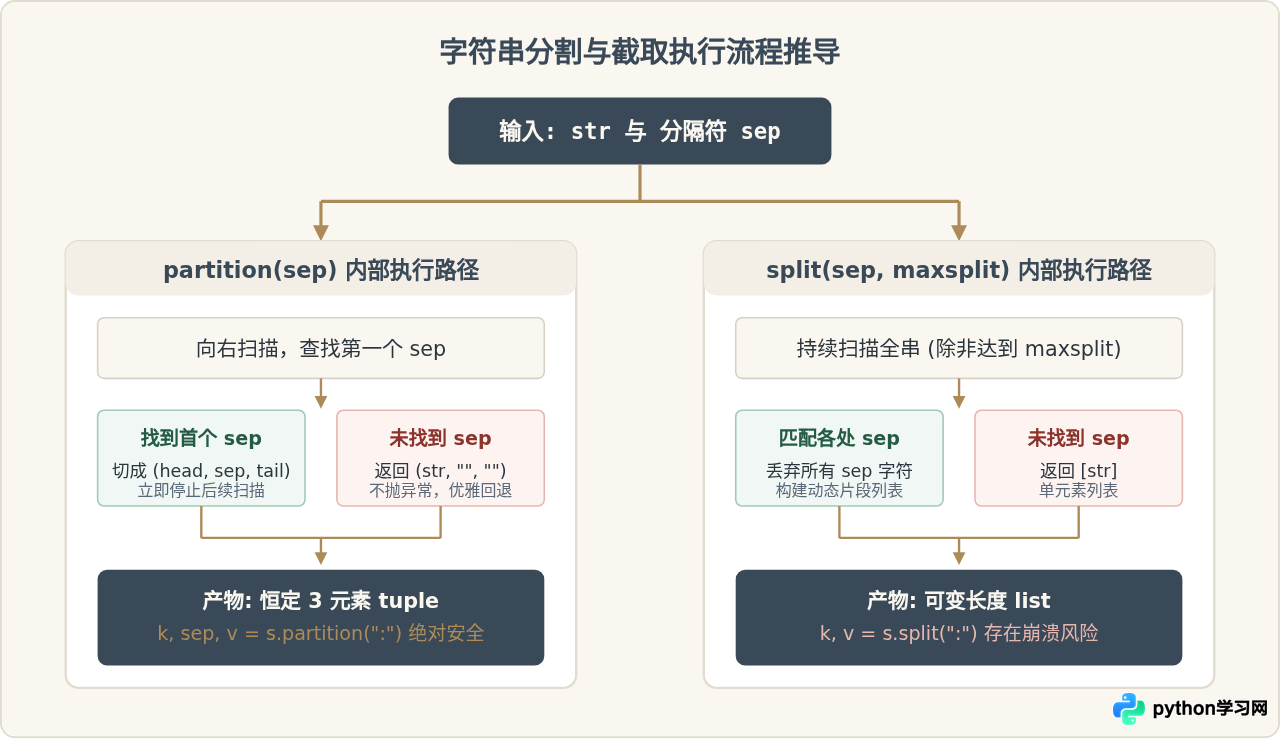
在编写实际业务逻辑(如网络协议解析、环境变量读取、日志结构化清洗)时,开发者最常犯的错误便是使用 split() 进行多变量解包。我们来看以下典型隐患场景:
def parse_header_vulnerable(line):
    # 假设输入可能是格式不合规的脏数据,例如缺少冒号
    key, value = line.split(":", 1)
    return key.strip(), value.strip()

# 当输入正常时运行良好
print(parse_header_vulnerable("Content-Type: application/json"))
# 示例输出: ('Content-Type', 'application/json')

# 当数据损坏或遇到空行时:
# parse_header_vulnerable("corrupted_line_without_colon")
# 直接抛出崩溃异常: ValueError: not enough values to unpack (expected 2, got 1)
许多开发者为了规避多冒号的情况,加上了 maxsplit=1,但只要字符串中完全不含冒号,split(":", 1) 就会退化为包含单一元素的列表 ["corrupted_line_without_colon"],试图解包给两个变量时必定抛出 ValueError。
相比之下,改用 partition() 可以构建零异常、防御性极强的解析逻辑:
def parse_header_robust(line):
    key, sep, value = line.partition(":")
    if not sep:
        # 通过判断中间分隔符是否为空,精准识别格式错误,而无需 try-except 包裹
        return None, "Invalid format: separator missing"
    return key.strip(), value.strip()

print(parse_header_robust("Content-Type: application/json"))
# 示例输出: ('Content-Type', 'application/json')

print(parse_header_robust("corrupted_line_without_colon"))
# 示例输出: (None, 'Invalid format: separator missing')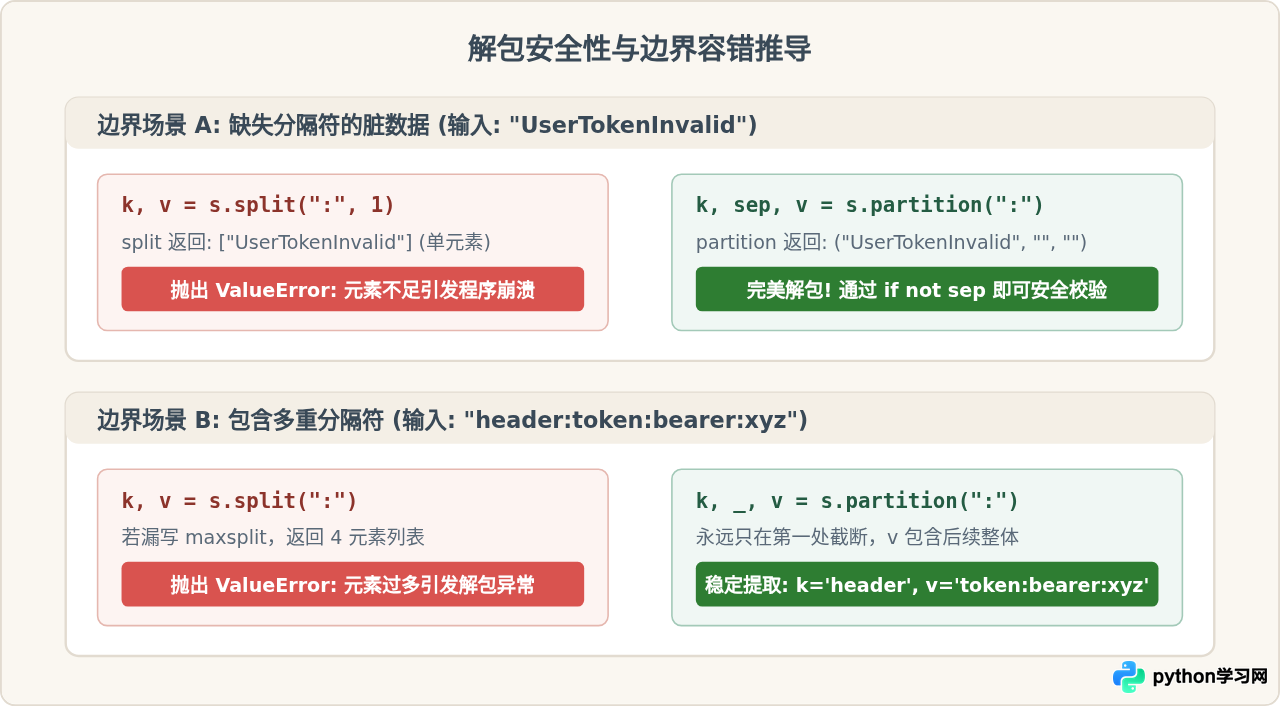
无论是 partition() 还是 split(),当显式传入空字符串 "" 作为分隔符时,都会抛出 ValueError: empty separator。但差异在于:split() 允许不传参(默认为 None,用于按空白拆分);而 partition() 则强制要求传入非空的分隔符,调用 s.partition() 不带任何参数会导致 TypeError。
四、方法特性全景对比与工程选型建议
为了让技术选型更加清晰直观,我们将两个方法(包括各自的反向方法)的核心技术指标汇总如下表:
| 对比维度 | str.partition() / rpartition() | str.split() / rsplit() |
|---|---|---|
| 返回值类型 | 定长三元组 tuple |
动态长度列表 list |
| 切分段数 | 固定切分为 3 项 (head, sep, tail) |
切分为 1 到 N 项,取决于匹配数与 maxsplit |
| 分隔符保留 | 完整保留(位于元组索引 1) | 完全丢弃(不出现在列表中) |
| 未找到分隔符时 | (s, '', '') 或 ('', '', s) |
[s](单元素列表) |
| 解包安全性 | 极高,解包给 3 个变量绝不引发长度错误 | 脆弱,在脏数据下容易抛出 ValueError |
| 默认空白切分 | 不支持,必须显式传递非空 sep |
原生支持,不传参时智能压缩连续空白符 |
| 底层内存开销 | 极小(命中首个后提前退出,产出轻量 tuple) | 相对稍高(需创建动态列表并收集全部元素) |
五、总结
在 Python 字符串截取体系中,str.partition() 与 str.split() 并非互斥的竞争关系,而是分工极其明确的两个利器:
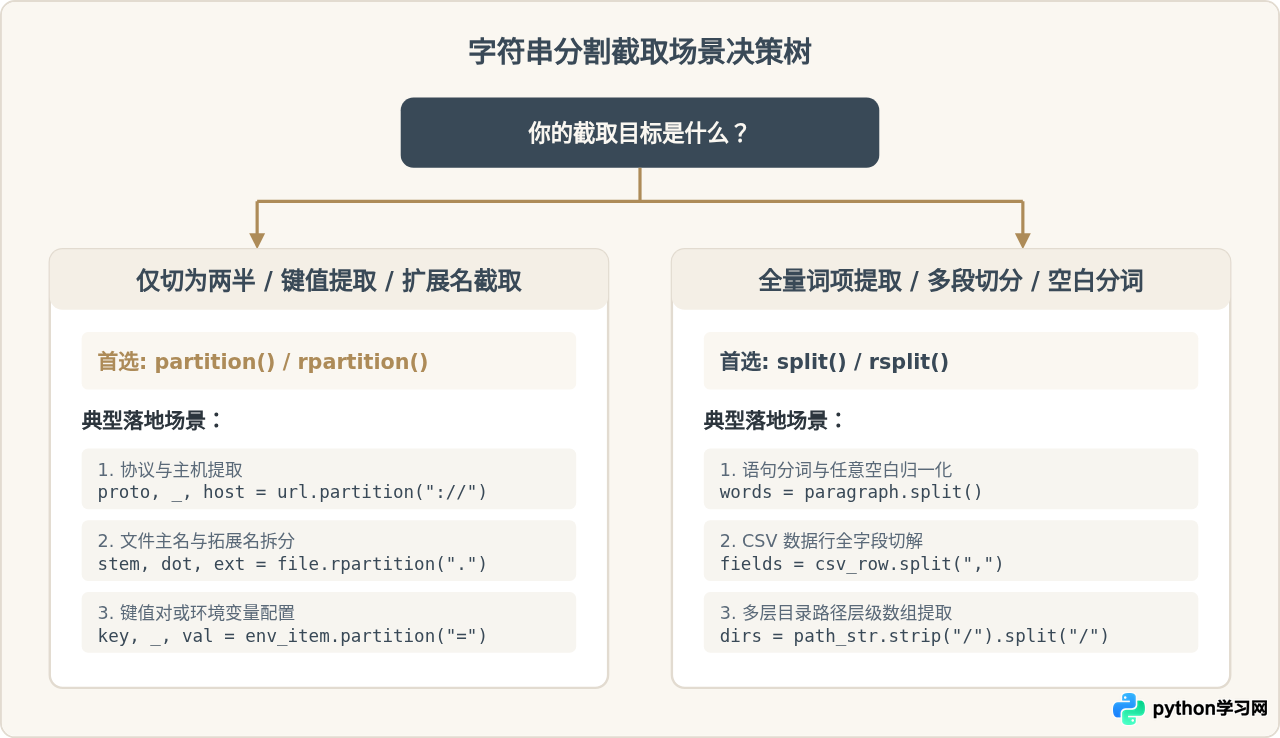
- 当你的任务是“一分为二”(例如抓取第一个冒号、等号或最后一个点号两侧的内容)时,应当无条件优先选择
partition()或rpartition()。它具有更优异的执行效率、固定的三元组结构,以及彻底杜绝解包报错的容错能力。 - 当你的任务是“全量切散”(例如提取所有单词、拆分所有逗号项,或是利用默认参数清除多余空白)时,
split()才是唯一正选。在使用split()时,如果需要解包赋值,务必提前校验结果列表的长度,或用try-except ValueError做好异常兜底。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















