


专业Python开发用什么软件?数据科学与Web后端工具选型指南
针对专业Python开发者的软件与工具链选型指南,深入解析数据科学与Web后端在代码编辑器、包与环境管理、调试测试及容器化上的差异与最佳实践。
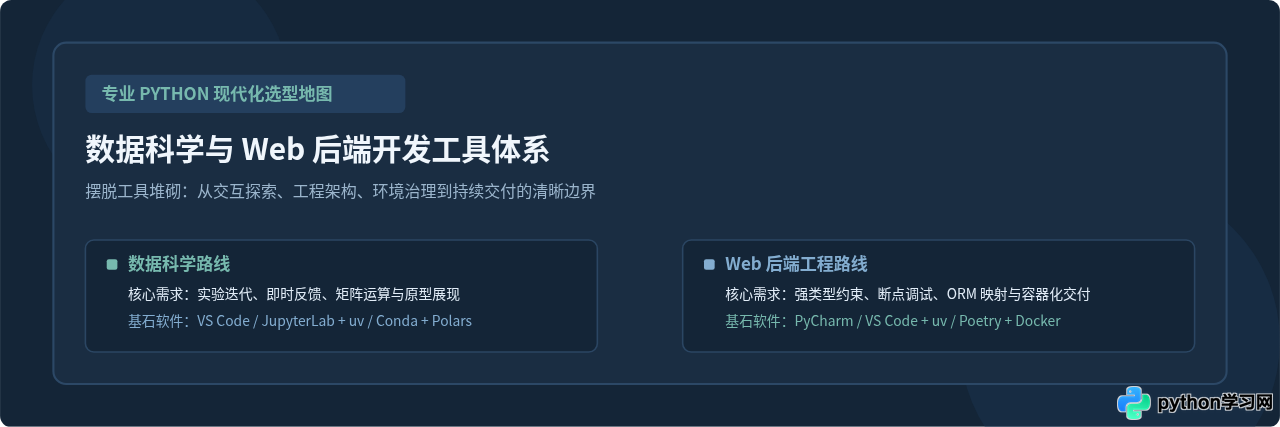
一、核心代码编辑器与 IDE 选型:PyCharm 与 VS Code 的权衡
很多开发者在搭建环境时最先纠结的问题是:到底该用 JetBrains PyCharm 还是微软的 Visual Studio Code?在专业开发语境下,两者的本质区别不是“谁更好看”,而是“开箱即用的专业集成环境”与“高定制性的模块化开发平台”的取舍。
1. JetBrains PyCharm:重型工程与大型 Web 项目的压舱石
PyCharm 分为社区版(Community)和专业版(Professional)。对于企业级 Web 后端开发,专业版具备无可替代的开箱生产力:
- 深度框架感知:对 Django、FastAPI、Flask 拥有深度模板语法提示、路由导航及端点直接跳转能力。
- 内建数据库与 HTTP 客户端:集成 DataGrip 数据库引擎与基于文本的
.http测试文件,不需要频繁在各类独立工具间切屏。 - 强大的远程与容器调试:原生支持 SSH 远程解释器、Docker Compose 运行时调试,断点步进分析极其扎实。
- 局限性:内存占用高(常态占用 1.5GB 至 3GB 内存),重载大型数据集时索引耗时长,不适合轻量级数据快速探索。
2. Visual Studio Code:轻量敏捷与跨领域开发的首选
VS Code 凭借极其活跃的扩展生态,已经成为当今 Python 开发者覆盖面最广的编辑器。配合微软官方的 Python 扩展包、Pylance(基于 Pyright 的类型分析引擎)以及 Ruff 插件,其开发体验既迅捷又完备:
- 秒级冷启动与低开销:适合处理轻量脚本、单文件微服务及多语言混合仓库。
- 卓越的 Notebook 混合支持:在同一个编辑器内既能无缝浏览和运行
.ipynb,也能以交互式窗口(Interactive Window)形式执行.py脚本中的代码单元块(# %%)。 - 远程开发套件(Remote - SSH / Containers):能够在远程服务器或容器内透明映射开发环境,体验与本地无异。
- 局限性:需要手动组装插件链,若团队缺少统一的
.vscode/settings.json规范,容易出现环境配置不一致的问题。
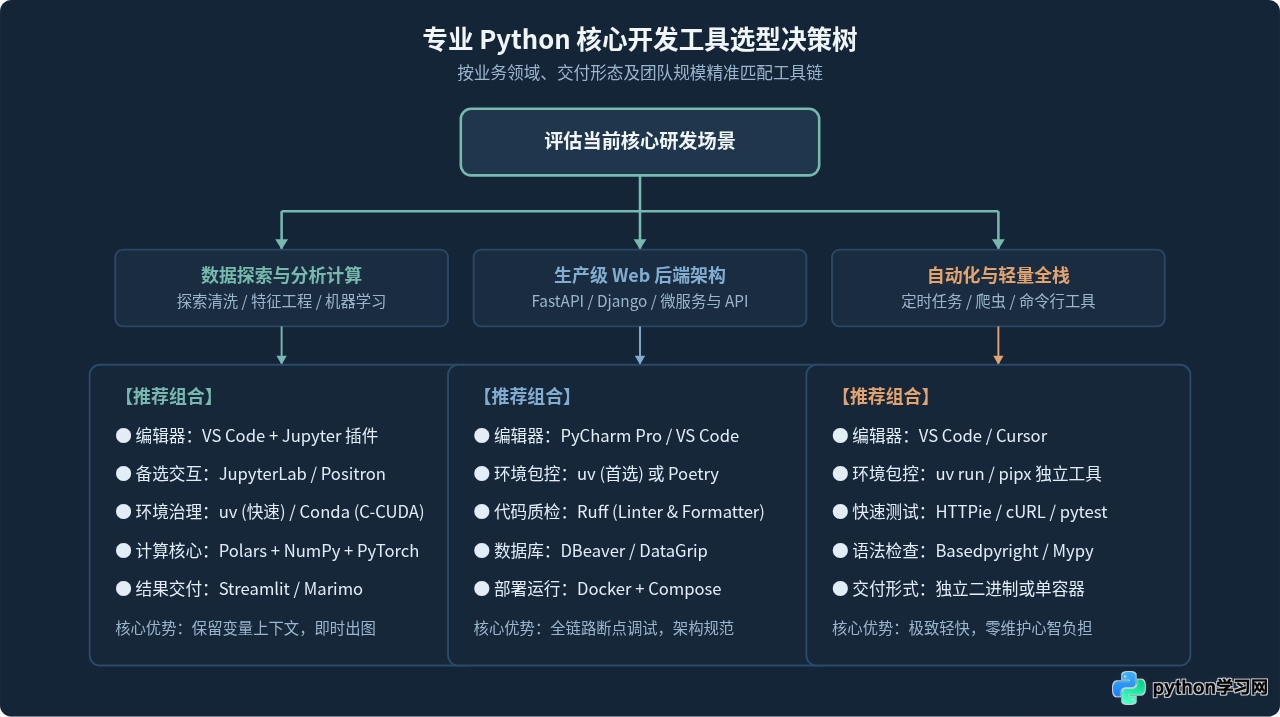
二、数据科学专业工具栈:从探索到生产的原型闭环
数据科学开发与工程开发的根本差异在于:数据科学是假设验证导向的。开发者需要随时驻留内存中的数十万行数据表格,观察统计指标,并以毫秒级的反馈调整清洗逻辑,而不是每次改动都重新编译运行。
1. 交互式分析基座:JupyterLab 与 VS Code Interactive
原生的 Jupyter Notebook 在原型设计阶段足够简单,但在专业项目中往往难以进行版本控制(.ipynb 包含大量输出元数据与 Base64 编码图片,导致 Git diff 杂乱)。现代团队的成熟方案是:
- VS Code Interactive Window:使用普通
.py文件书写代码,通过在逻辑段前加入# %%标记将其声明为一个独立单元格。运行时右侧窗口直接渲染图表与表格,既保留了交互式运行与变量内存驻留,又保证了文件是纯文本 Python,Git 版本比较清晰直观。 - JupyterLab 4.x:当需要在一个界面中聚合终端、文件树、CSV 预览及多个协同 Notebook 时,JupyterLab 依然是实验室与云端算力节点(如 JupyterHub)的标准环境。
- 新锐选择 Marimo:新一代响应式 Notebook,采用有向无环图(DAG)自动追踪变量依赖,彻底解决了传统 Notebook 因单元格无序执行导致的状态污染问题。
2. 科学计算包与环境管理:Conda/Mamba 与 uv 的选择
在数据科学领域,包管理常常涉及底层 C++、Fortran 与 NVIDIA CUDA 动态链接库。判断标准非常明确:
- 涉及复杂非 Python 驱动与 CUDA 时:选择
Miniforge(集成轻量 Conda 及加速客户端Mamba),能够直接安装编译好的系统级二进制库,免去本地缺少 C++ 构建工具链的麻烦。 - 基于现代纯 Python 或已发布预编译 Wheel 的库时:果断选择
uv。其利用 Rust 编写的解析器比传统 Conda 提速数十倍,创建虚拟环境仅需几十毫秒。
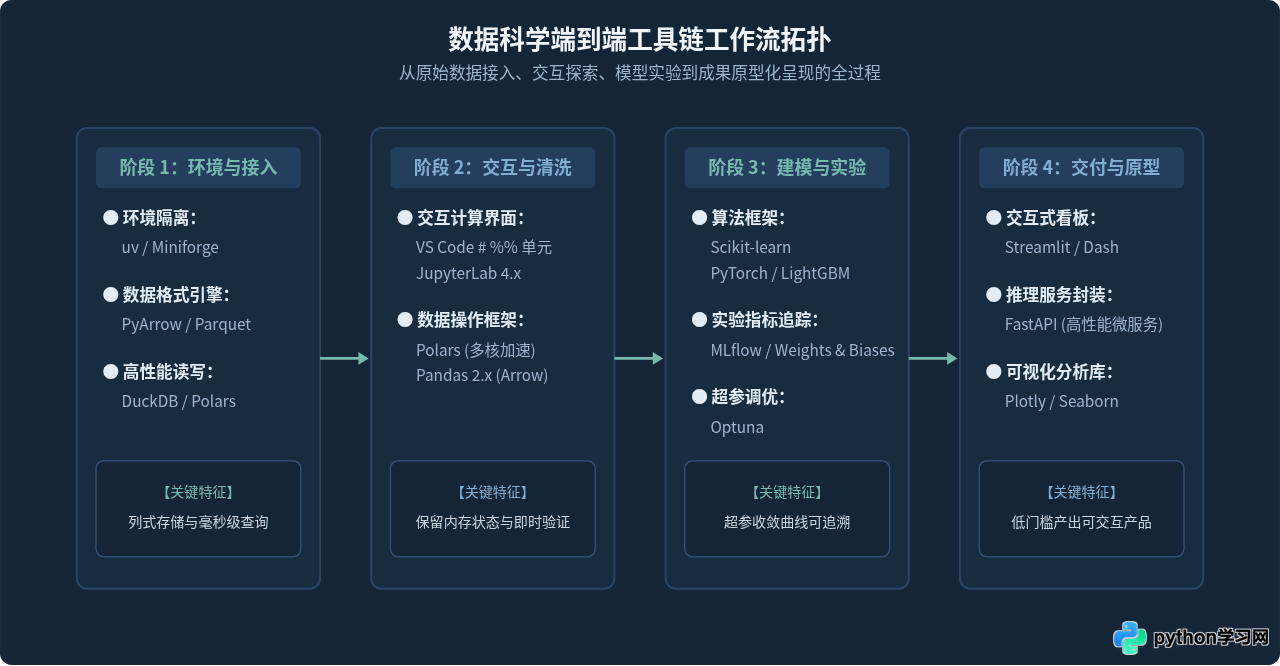
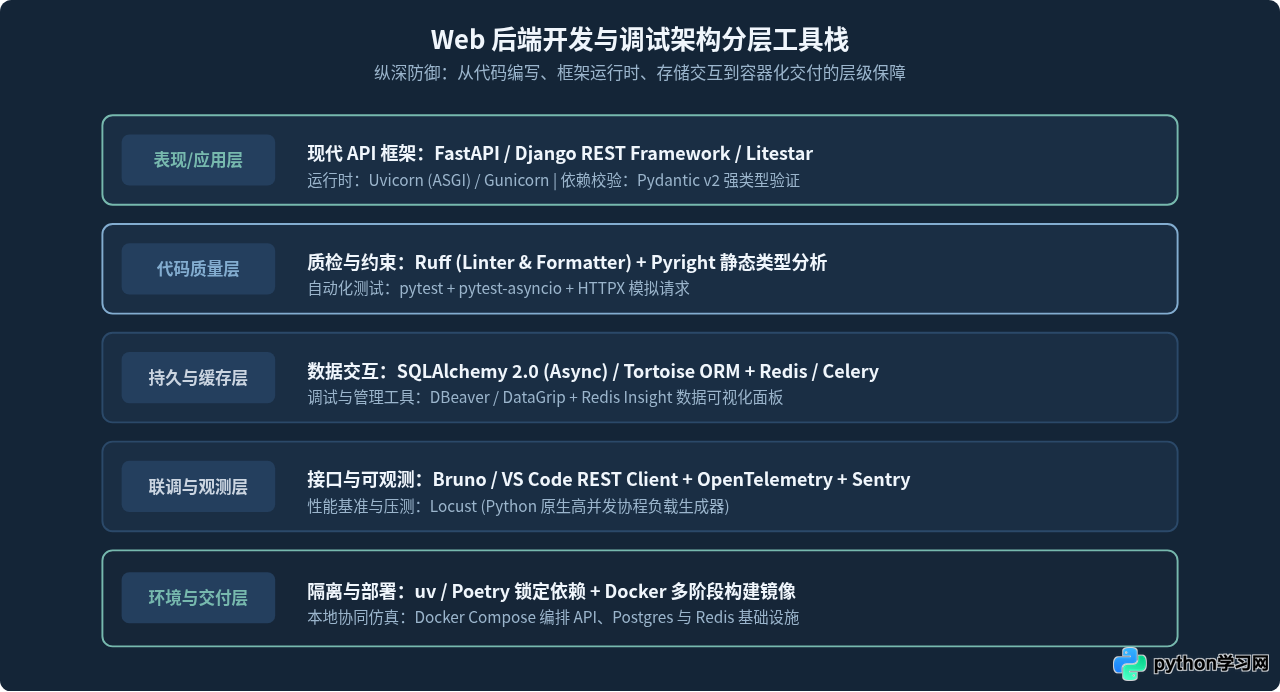
三、Web 后端工程工具栈:注重可靠性、可测性与隔离交付
与数据科学不同,Web 后端服务是长时间在服务器后台守护运行的。它更关注高并发吞吐、数据库事务完整性、严密的类型约束与自动化回归测试。专业后端开发需要建立一套分层协同的工具网络。
1. 项目与依赖管理:告别混乱的 requirements.txt
传统手工维护 requirements.txt 存在两大致命缺陷:无法区分“直接业务依赖”与“间接传递依赖”;无法确定性锁定跨平台的依赖子版本。专业 Web 工程必须采用具备Lockfile(锁定文件)机制的现代工具:
- Astral uv(强烈推荐):目前 Python 生态演进最迅猛的项目管理工具。一条
uv init即可初始化包含pyproject.toml与uv.lock的完整工程,解析依赖速度相比传统 pip 提升 10 到 100 倍。 - Poetry:成熟稳定的老牌工具,具备严谨的依赖图解析和发布打包机制,适合成熟企业历史项目的持续维护。
2. 代码质量卫士:Ruff 与类型检查器
以前 Python 项目需要同时集成 Flake8、Black、isort、autopep8 等四五个独立工具,配置繁琐且执行缓慢。如今已被彻底统一:
- Ruff:由 Rust 编写,集成了代码语法检查(Linting)与代码排版格式化(Formatting),执行速度比传统工具快两个数量级。在编辑器中设置“保存时自动修复”,几乎完全消除了关于代码格式的代码审查争议。
- 基于类型的语言服务器(Pylance / Pyright / Basedpyright):配合 Python 3.10+ 的类型提示(Type Hints),在编写代码的第一时间阻断
NoneType异常和方法调用入参错误。
3. 数据库与接口联调基础设施
- 数据库可视化客户端:推荐开源跨平台的 DBeaver(通用全能,支持 PG、MySQL、ClickHouse)或 JetBrains DataGrip(极致的 SQL 智能补全与执行计划分析)。
- API 设计与接口测试:告别体积臃肿的商业工具,推荐开源轻量的 Bruno(离线优先、接口文件直接存为纯文本并纳入 Git 管理)或 VS Code 的 REST Client 扩展插件。
四、落地实操:现代专业开发环境搭建四步法
为了让选型切实落地,以下以目前行业前沿的高效技术栈(以 uv 与现代配置规范为例)演示标准工程的初始化过程。
步骤 1 安装包管理器并初始化工程
打开终端,首先安装独立工具链并创建项目骨架:
# 1. 独立安装 uv(Linux/macOS 示例,官方推荐脚本)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 2. 初始化一个名为 my-backend-service 的应用项目
uv init my-backend-service
cd my-backend-service

# 3. 指定并创建特定 Python 版本的隔离虚拟环境
uv venv --python 3.12
步骤 2 明确声明业务依赖与开发工具依赖
专业工程中,生产运行库与本地开发工具必须分离(避免生产环境安装 pytest 或调试器):
# 添加 Web 运行时核心依赖
uv add fastapi uvicorn[standard] pydantic

# 将代码格式化与测试工具添加到开发依赖组(dev-dependencies)
uv add --dev ruff pytest httpx
执行完成后,目录中会生成 pyproject.toml 与严格锁定的 uv.lock 文件,其他成员拉取代码后只需执行 uv sync 即可获得 100% 一致的环境状态。
步骤 3 配置代码检查与保存即格式化
在项目根目录创建或编辑 pyproject.toml,添加 Ruff 规则;并在 .vscode/settings.json 中启用自动排版:
# pyproject.toml 中的 Ruff 配置示例
[tool.ruff]
line-length = 88
target-version = "py312"

[tool.ruff.lint]
select = ["E", "F", "I", "B"] # 启用语法、未引用、导入排序及常见 bug 规则
// .vscode/settings.json
{
"[python]": {
"editor.defaultFormatter": "charliermarsh.ruff",
"editor.formatOnSave": true,
"editor.codeActionsOnSave": {
"source.organizeImports": "explicit"
}
}
}步骤 4 验证自动化断点调试与测试
在编辑器中按下 F5 或通过 uv run pytest 执行测试套件:
# 运行项目中的所有单元与集成测试,验证当前工具链闭环
uv run pytest -v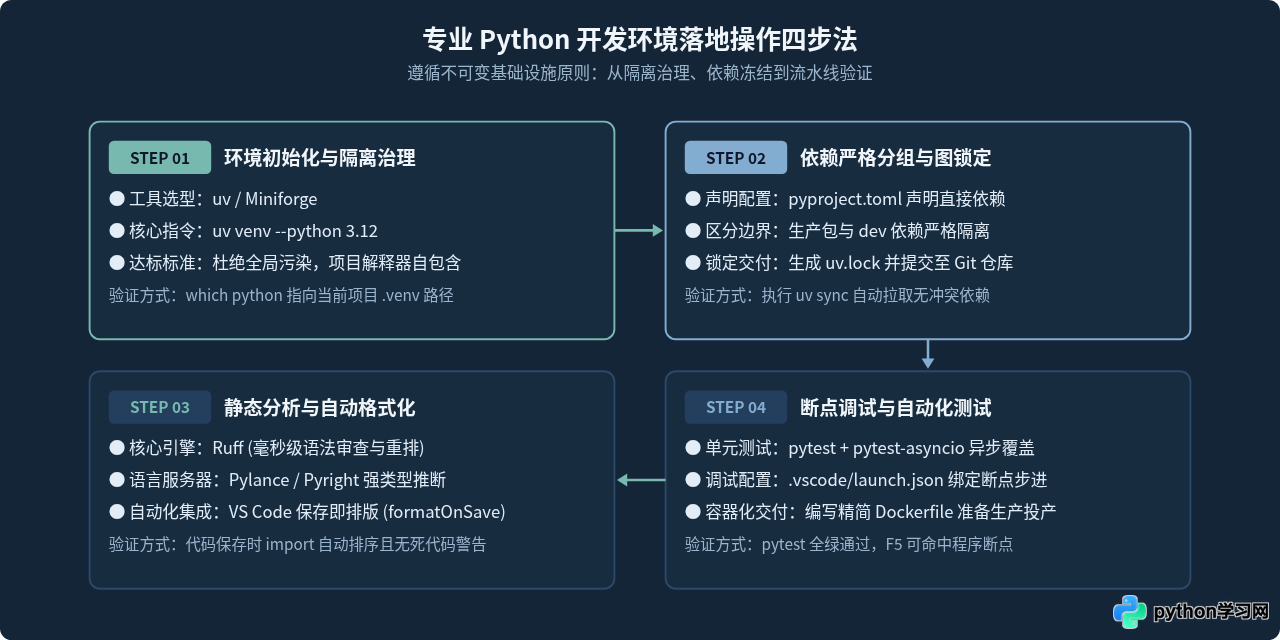
五、工具选型常见误区与避坑建议
Jupyter 的优势在于内存交互与可视化探索,但其缺乏静态接口契约、类型推断与系统性异常重试机制。当数据探索阶段完成、模型或逻辑定型后,必须将其重构为遵循单一职责的
.py 模块与包结构,并通过 pytest 建立自动化测试防护网。
sudo pip install。Linux/macOS 操作系统本身的许多关键组件(如桌面管理器、网络配置脚本)依赖系统自带的 Python 解释器。全局安装第三方库极易引发底层依赖冲突(如破损 OpenSSL、urllib3 导致包管理器瘫痪)。始终保持每个项目具备独立的虚拟环境(
.venv)。
在 VS Code 中安装过多未经筛选的扩展(如多套重复的语法高亮或未优化的 AI 补全插件)会导致进程卡顿、自动补全延迟增加。保持核心扩展聚焦于
Python、Pylance、Ruff 即可获得最稳定流畅的响应体验。
六、总结与选型速查表
为了便于在项目启动时快速查阅,下表将两大赛道的核心工具组件进行归纳汇总:
| 选型维度 | 数据科学与算法路线 | Web 后端与服务架构路线 |
|---|---|---|
| 主力开发工具 | VS Code(+ Jupyter) / JupyterLab 4.x / Positron | PyCharm Professional / VS Code |
| 环境与包治理 | uv(纯 Python 首选) / Miniforge (Conda/Mamba) | uv(现代化首选) / Poetry(传统工程) |
| 计算与核心框架 | Polars / PyArrow / PyTorch / Scikit-learn | FastAPI / Django REST Framework / Litestar |
| 代码质检与排版 | Ruff(快速修复) / nbqa(Notebook 代码格式化) | Ruff + Pylance (Pyright) 静态类型检查 |
| 交互调试与界面 | 交互式窗口(# %%) / Data Wrangler / Streamlit | 深层断点步进 / DBeaver / Bruno / REST Client |
| 运行与发布介质 | 交互式看板 / 导出纯代码模型文件 / Docker | 多阶段构建 Docker 镜像 + Kubernetes / Compose 编排 |
专业软件选型的本质并不是寻找“绝对最强”的单一软件,而是根据代码交付的形式、状态管理的生命周期以及团队协作的规范,建立起一套摩擦最小、反馈最快、环境最干净的工具闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















