


Python中print、sys.stdout.write与logging模块的区别与选择
深入对比Python中print、sys.stdout.write与logging模块的底层原理、功能差异与适用场景,提供清晰的代码示例与选型决策指南。
在编写Python程序时,向控制台或外部介质输出信息是最基础的操作。初学者通常习惯于直接使用内置函数 print(),但随着程序规模扩大、逻辑复杂化以及对性能与运维要求的提升,直接使用 sys.stdout.write() 或标准库 logging 模块往往成为更专业的方案。这三者并非单纯的替代关系,而是处于不同抽象层级、面向不同应用场景的输出工具。选择的核心依据在于程序对“使用便捷度”、“流输出粒度控制”以及“多级别与持久化运维”的具体需求。
一、底层原理与层级抽象关系
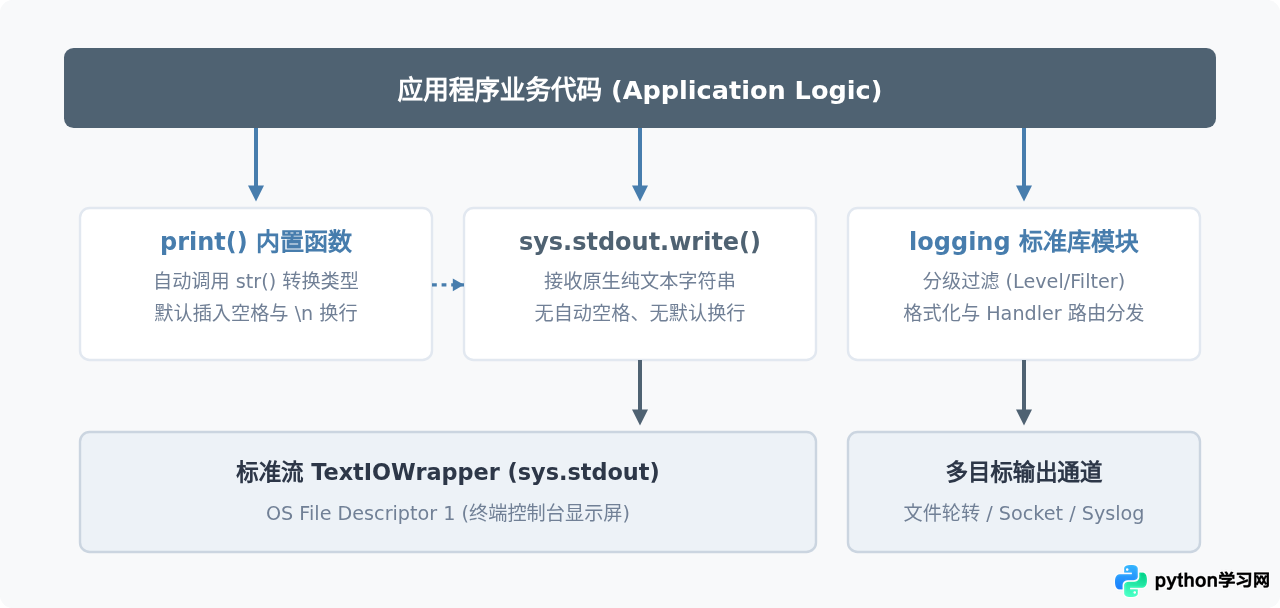
要理解三者的本质差异,首先需要了解Python处理输出的内部层级。计算机操作系统为每个运行的进程分配了标准输入(stdin)、标准输出(stdout)和标准错误(stderr)三个文件描述符。Python通过 sys.stdout 对标准输出进行面向对象的封装。
sys.stdout.write() 是对标准输出流(io.TextIOWrapper)的直接调用。它要求入参必须为字符串类型,不会主动追加任何换行符或空格,其行为高度贴近底层系统调用。而内置函数 print() 实际上是对 sys.stdout.write() 的高级封装,它在内部自动完成多参数对象的字符串转换(调用对象的 __str__)、参数之间的分隔符插入、末尾换行符追加以及缓冲区的刷新策略。相比之下,logging 模块则构建在完整的日志事件流之上,包含 Logger、Handler、Formatter 和 Filter 四大组件,不仅能够输出到标准输出,还能在同一逻辑下将日志安全分发到磁盘文件、网络套接字或系统守护进程。
二、核心机制与具体代码对比
1. print():快速反馈的高层语法糖
print() 的完整函数签名为:
print(*objects, sep=' ', end='\n', file=None, flush=False)它的优势是极简、宽容。传入任何类型的对象(整数、字典、列表、自定义类),它都会隐式调用 str(obj) 转换为文本;同时自动以空格隔开多个入参,并在行尾加上换行符 \n。当进行简单的逻辑检验或编写单次执行的脚本时,print() 是开发效率最高的选择。
然而,print() 无法方便地区分信息的重要程度。在大型工程中,如果充斥着 print(),控制台将输出混杂无序的内容,排查生产问题时极易被无效信息淹没,且在正式发布时难以快速统一关闭调试输出。
2. sys.stdout.write():精确控制文本流与光标
sys.stdout.write() 仅接受唯一的字符串参数,并返回写入的字符数。如果不显式传递字符串(例如传递整数),将直接抛出 TypeError: write() argument must be str, not int。
正因为其没有任何多余的换行与分隔符逻辑,它常用于构建需要精确控制光标位置的终端交互效果,最典型的应用便是单行原地刷新进度条。配合回车符 \r(将光标移至行首但不换行)以及 sys.stdout.flush()(强制将缓冲区数据写入物理终端),可以实现动态无滚动的进度展示:
import sys
import time

def render_progress_bar(total_steps):
    for current in range(1, total_steps + 1):
        percent = (current / total_steps) * 100
        bar = "=" * int(percent // 4)
        # \r 将光标移动到当前行行首,随后覆盖输出新内容
        sys.stdout.write(f"\r[{bar:<25}] {percent:6.2f}% ({current}/{total_steps})")
        sys.stdout.flush()
        time.sleep(0.05)
    # 完成后输出一个换行符,避免终端下一行命令与进度条粘连
    sys.stdout.write("\n")

if __name__ == "__main__":
    render_progress_bar(100)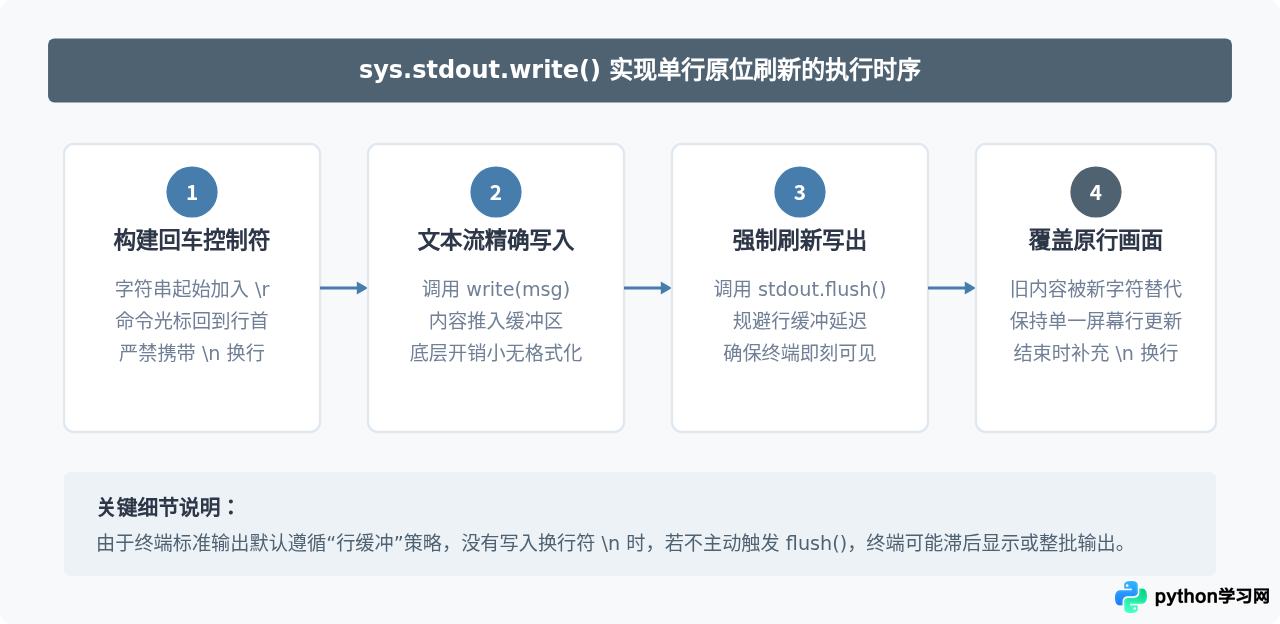
3. logging:工程级系统的可观测性基石
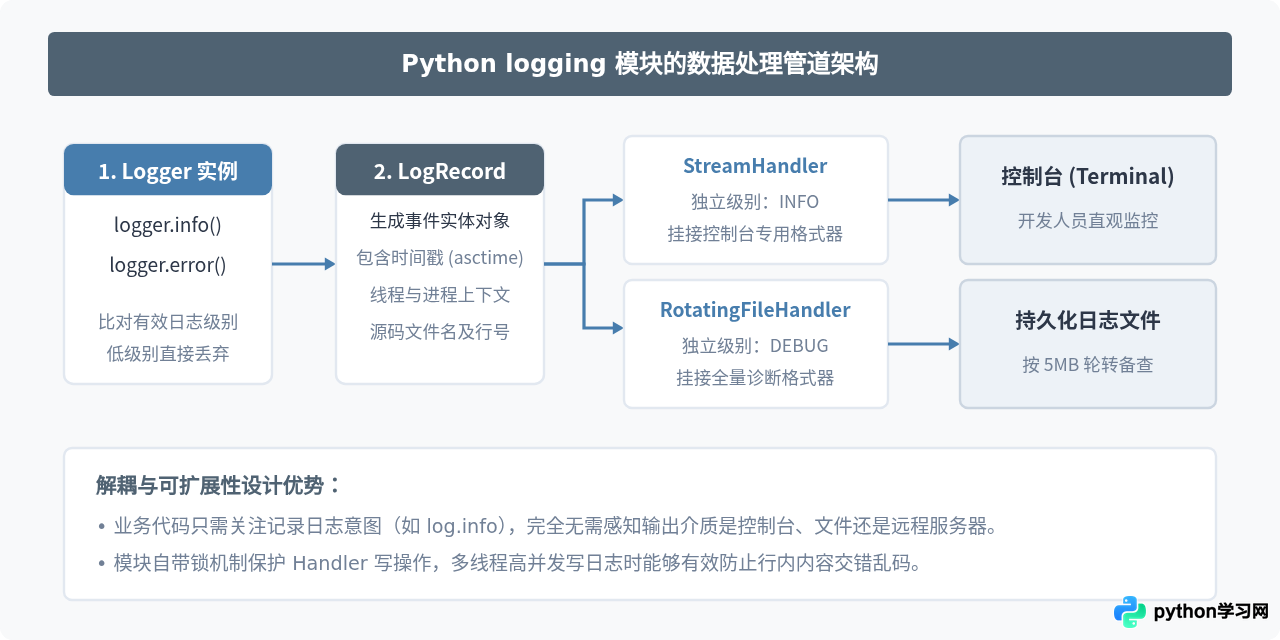
在生产系统、长期运行的后台服务或模块化代码库中,信息的价值不仅在于“被打印”,更在于具备时间维度、上下文追踪能力以及可控的分发途径。logging 模块提供了以下不可替代的核心特性:
- 严重级别划分(Log Levels):从低到高包含 DEBUG、INFO、WARNING、ERROR、CRITICAL。开发者可在运行时调整级别,如测试环境输出 DEBUG,生产环境只记录 WARNING 及以上,无需改动任何源码。
- 上下文丰富性:能够自动记录发生时间戳、模块名、函数名、行号、进程与线程 ID、异常追踪栈(Traceback)。
- 多目标输出(Handlers):支持同时将关键告警输出到控制台,将全量日志追加到按体积或按天滚动的日志文件(如
RotatingFileHandler),甚至推送到远程集中式日志收集系统。 - 线程安全:内置互斥锁机制,保证在多线程环境下高频写日志不会出现文本碎片交叉交错的混乱现象。
下面是一个标准的工程级日志配置示例:
import logging
from logging.handlers import RotatingFileHandler

def setup_logger():
    # 1. 创建命名 Logger
    logger = logging.getLogger("service_worker")
    logger.setLevel(logging.DEBUG)

    # 避免重复添加 Handler 导致日志重复打印
    if logger.handlers:
        return logger

    # 2. 定义格式器:包含时间、线程、日志级别与信息
    formatter = logging.Formatter(
        "[%(asctime)s] [%(levelname)-8s] [%(threadName)s] %(message)s",
        datefmt="%Y-%m-%d %H:%M:%S"
    )

    # 3. 创建控制台输出 Handler(仅输出 INFO 及以上)
    console_handler = logging.StreamHandler()
    console_handler.setLevel(logging.INFO)
    console_handler.setFormatter(formatter)

    # 4. 创建滚动文件输出 Handler(记录 DEBUG 全量日志,单文件 5MB,保留 3 个备份)
    file_handler = RotatingFileHandler(
        "app_runtime.log", maxBytes=5 * 1024 * 1024, backupCount=3, encoding="utf-8"
    )
    file_handler.setLevel(logging.DEBUG)
    file_handler.setFormatter(formatter)

    # 5. 装配 Handler
    logger.addHandler(console_handler)
    logger.addHandler(file_handler)

    return logger

if __name__ == "__main__":
    log = setup_logger()
    log.debug("正在加载初始配置项...")     # 仅写入文件,不打扰控制台
    log.info("数据库连接池初始化完成")       # 同时写入控制台和文件
    try:
        val = 10 / 0
    except ZeroDivisionError:
log.error("计算任务失败,触发异常", exc_info=True) # 记录完整 Traceback[2026-10-29 16:30:00] [ERROR ] [MainThread] 计算任务失败,触发异常
Traceback (most recent call last):
File "example.py", line 38, in <module>
val = 10 / 0
ZeroDivisionError: division by zero
三、核心维度横向对比
为了直观评估三者在不同技术维度的能力表现,下表汇总了其关键特性:
| 对比维度 | print() | sys.stdout.write() | logging 模块 |
|---|---|---|---|
| 抽象级别 | 最高(内置高级语法糖) | 最低(标准文本流接口) | 工程级框架(事件流抽象) |
| 类型宽容度 | 宽容,自动将任意对象转换为字符串 | 严格,仅接受 str,非字符串抛出 TypeError |
支持格式化字符串及任意上下文对象 |
| 格式化支持 | 基础,需开发者预先拼接或使用 f-string | 无,完全依赖开发者预先格式化 | 高度完备,支持时间戳、行号、堆栈追踪模版 |
| 末尾追加逻辑 | 默认追加空格与换行符 \n |
不追加任何内容,完全由输入字符串决定 | 由具体 Formatter 与 Handler 规范管理 |
| 输出目标灵活性 | 支持重定向到文件对象(file=f) |
仅定向到所绑定的输出流对象 | 极其灵活,支持文件轮转、网络、终端同时分发 |
| 运行时动态开关 | 困难,必须修改代码或覆写 stdout | 困难,需在业务逻辑内自行判断 | 极简,统一调整 Logger 级别即可静音某类输出 |
| 执行性能开销 | 极低 | 最低(无多余层级打包) | 适中(包含对象创建、锁竞争与格式化逻辑) |
| 并发安全性 | 多线程下可能在行末出现轻微字符交错 | 无内置行锁,多线程并发写入易交错 | 内置线程锁(Thread-safe),保障输出整洁 |
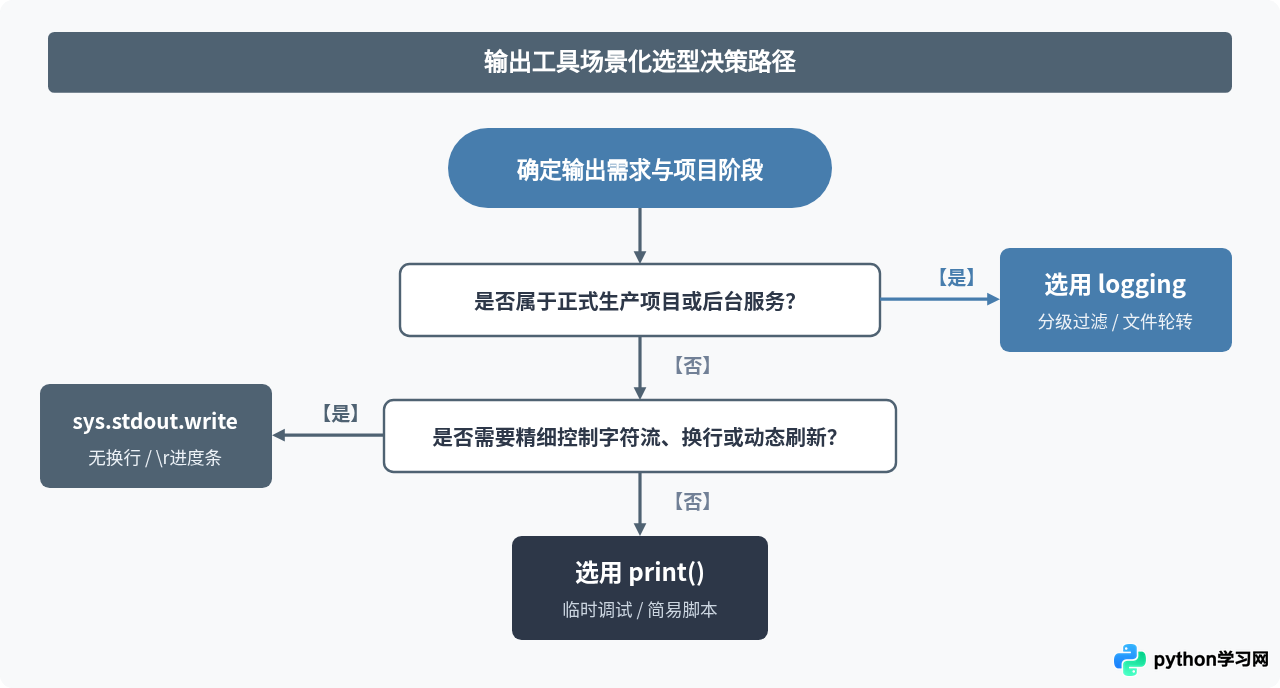
四、场景化选型决策指南
在实际项目开发中,选择何种工具不应凭个人直觉,而应根据项目生命周期、目标环境与功能职责来判断:
- 使用 print() 的场景:
- 算法刷题、短平快的原型验证脚本。
- 交互式命令行程序(CLI)明确面向终端用户呈现的结果信息(例如
grep匹配到的结果展示)。 - 开发初期的就地排查(排查完毕后应及时清理或替换)。
- 使用 sys.stdout.write() 的场景:
- 终端文本UI(TUI)或精细的终端进度展示(需要
\r配合flush())。 - 底层通信管道、文本协议构建,要求输出严禁有多余空格与意外换行符。
- 对极致性能有严苛要求的控制台输出循环(例如每秒百万次级的高频文本输出)。
- 终端文本UI(TUI)或精细的终端进度展示(需要
- 使用 logging 的场景:
- Web API(FastAPI、Django、Flask)、微服务、后台持续运行的 Daemon 服务。
- 需要保留历史故障证据、具备审计合规要求的业务系统。
- 多人协作开发的中大型代码库或开源通用 SDK 库。
五、常见误区与避坑指南
1. 误区一:线上生产代码随意保留 print()
在 Docker 容器或云原生集群中运行的后端服务,如果大量滥用 print(),控制台输出将难以结构化采集。当容器重启或标准输出缓冲未满时,关键的故障信息可能无法及时落盘造成丢失。此外,print() 无法动态调整级别,一旦遇到高并发流量,大量的 I/O 阻塞会直接拉低业务吞吐量。
2. 误区二:向 sys.stdout.write() 传入非字符串对象
习惯了 print() 的开发者容易写出 sys.stdout.write(100) 或 sys.stdout.write(["item"]),这会在运行时立刻导致异常中断。务必记住 sys.stdout.write() 仅仅是一个纯字节/文本流接口,必须通过 str() 显式转换或传入预处理好的字符串。
3. 误区三:logging 的 Handler 重复挂载导致多倍输出
在函数内动态执行 logger.addHandler() 时,如果该函数被多次调用,每次都会向 Logger 注册新的 Handler,导致同一条日志在控制台重复打印 2 遍、3 遍甚至更多。正确的做法是在模块初始化时统一配置,或在挂载前检查 if not logger.handlers:。
print() 或直接配置 root logger,而应该创建专门的命名日志记录器(如 logger = logging.getLogger(__name__))并挂载 logging.NullHandler(),将日志输出的主动权完全交还给顶层应用开发者。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















