


Python运维脚本必备库:Subprocess执行命令与Pathlib管理路径
深入讲解Python自动化运维脚本中两大核心标准库subprocess与pathlib的工程实践,涵盖面向对象路径管理、安全执行外部命令、超时控制、管道处理及防注入实战。
在编写自动化运维脚本时,最基础且频繁的两项操作是“处理文件与路径”和“调用系统命令完成任务”。过去许多脚本习惯混用 os.path 拼接字符串与 os.system 裸调外部程序,这种写法往往伴随着平台分隔符不兼容、缺乏返回值状态校验以及命令注入等稳定性与安全隐患。Python 标准库提供的 pathlib 与 subprocess 分别确立了面向对象的文件系统抽象和安全严谨的进程调用接口。掌握这两个库的工程化用法,是编写可靠、健壮且易于维护的 Python 运维脚本的关键。
一、Pathlib:面向对象的现代路径管理
在 Python 3.4 之前,路径处理依赖 os.path 模块。路径本质上只是纯字符串,文件查找、扩展名提取或跨目录拼接都需要嵌套调用多个函数,语法冗长且极易遗漏斜杠。pathlib 将文件系统中的路径抽象为对象,通过直观的操作符和内置方法,提供了更自然且兼顾跨平台特性的编程模型。
1. 路径对象创建与优雅拼接
在 pathlib 中,所有路径操作围绕 Path 类展开。创建路径无需关心当前操作系统是 Linux、macOS 还是 Windows,库内部会自动根据平台选择合适的具体实现类(如 PosixPath 或 WindowsPath)。
from pathlib import Path

# 获取当前工作目录或脚本所在目录
base_dir = Path.cwd()
script_path = Path(__file__).resolve()

# 使用除号运算符 / 进行路径拼接,自动处理分隔符
log_dir = base_dir / "logs" / "nginx"
target_file = log_dir / "access.log"

print("目标完整路径:", target_file)
2. 路径属性拆解与检查
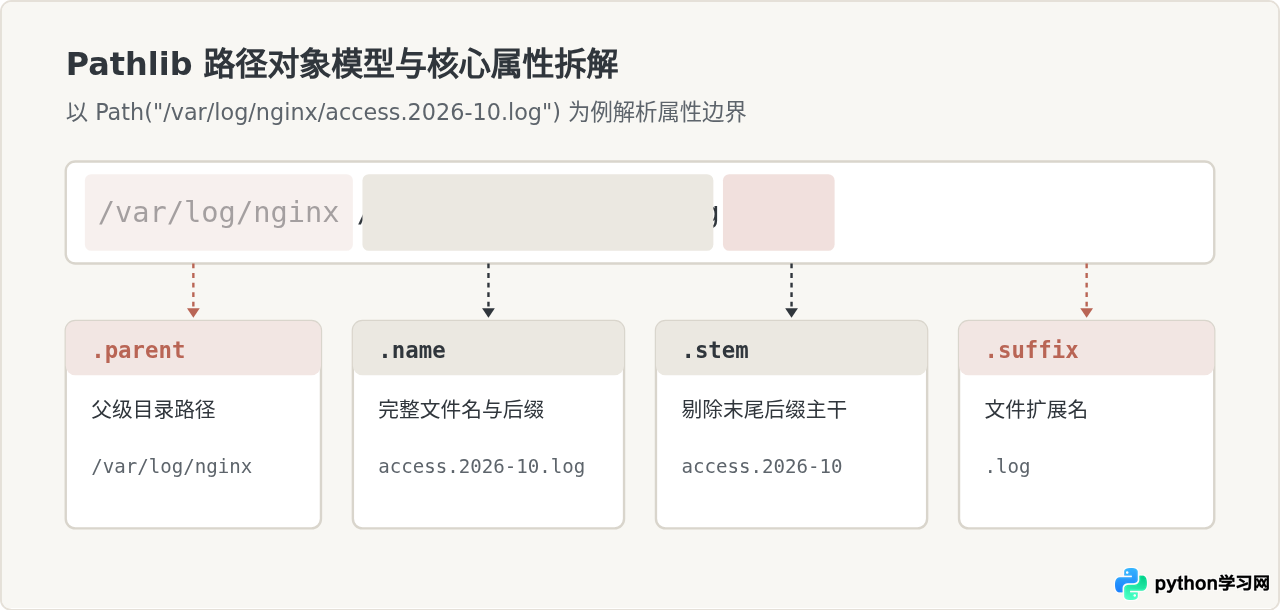
过去拆分文件名、主干名与后缀通常需要 os.path.basename、os.path.splitext 等配合切片,而在 Path 对象中,这些都变成了直接可读的属性:
path.name:返回完整文件名(如access.2026-10.log)。path.stem:返回不含最后一个扩展名的文件名主干(如access.2026-10)。path.suffix:返回文件后缀(如.log),多级后缀可通过suffixes获取列表。path.parent:返回上级目录路径对象;多层上级可通过parents[0]、parents[1]连续访问。
3. 目录创建与文件扫描过滤
在运维自动化中,准备输出目录以及遍历筛选日志是高频动作。Path 对象提供了更具声明性的封装:
from pathlib import Path

backup_dir = Path("/opt/backup/daily")

# 类似 mkdir -p:若父级目录不存在则递归创建,已存在则不报错
backup_dir.mkdir(parents=True, exist_ok=True)

# 目录遍历与模式匹配
log_dir = Path("/var/log")

# 1. 仅在当前目录匹配 .log 文件
for log_file in log_dir.glob("*.log"):
    print("当前层日志:", log_file.name)

# 2. 递归遍历所有子目录匹配所有的压缩归档文件
for gz_file in log_dir.rglob("*.tar.gz"):
    size_mb = gz_file.stat().st_size / (1024 * 1024)
print(f"归档文件: {gz_file.name}, 大小: {size_mb:.2f} MB")此外,对于小体积配置文件的读取或写入,Path 提供了 read_text()、write_text() 方法,无需显式书写 with open(...) 结构,大幅精简脚本篇幅。
二、Subprocess:安全可靠的命令执行
许多系统级操作(如磁盘扩容检测、调用 systemctl、打包 tar 或调用 rsync)直接借助成熟的系统二进制工具效率最高。早期 Python 脚本常使用 os.system("command " + arg),这不仅无法捕获标准输出和标准错误,更存在严重的命令注入安全隐患。
1. 现代化统一调用:subprocess.run
从 Python 3.5 起,官方推荐以 subprocess.run() 作为同步执行外部命令的核心入口。它会启动子进程并等待其运行完毕,最终返回一个 CompletedProcess 实例。
import subprocess

# 推荐写法:传递参数列表,无需经过系统 shell 解释
result = subprocess.run(
    ["df", "-h", "/"],
    capture_output=True, # 捕获 stdout 与 stderr
    text=True,           # 以字符串而非字节返回解码内容
    check=False          # 不在退出码非 0 时自动抛出异常,由代码手动判断
)

print("命令退出码:", result.returncode)
print("标准输出内容:\n", result.stdout)
2. 核心安全准则:杜绝 shell=True 与命令注入
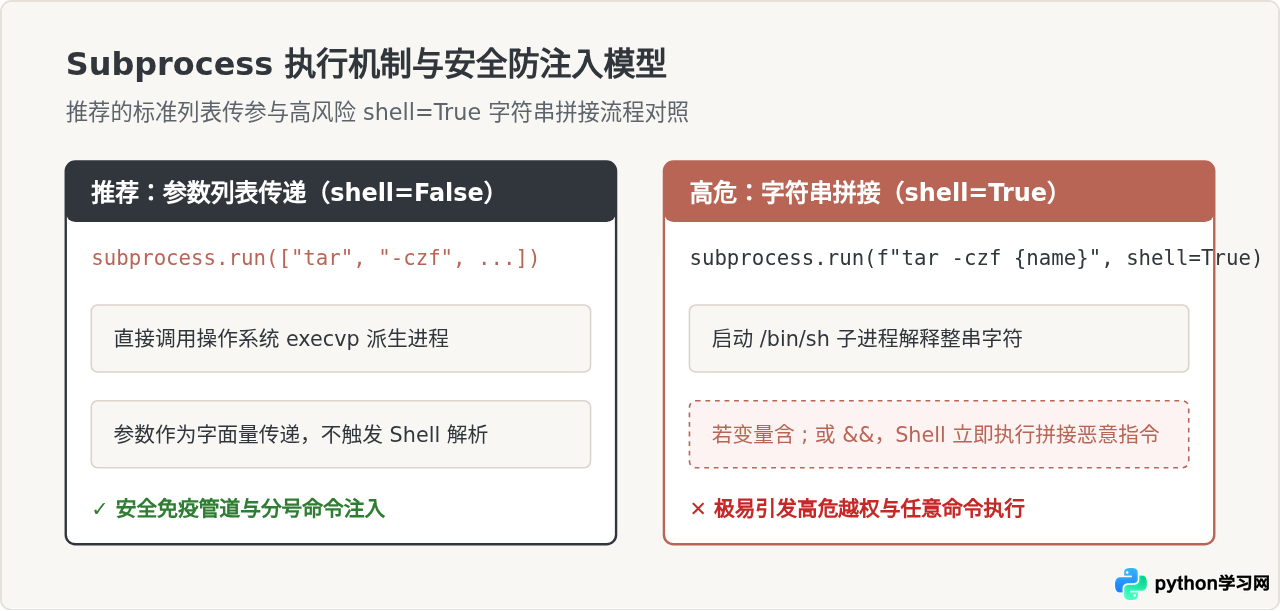
当设置 shell=True 时,Python 会启动一个系统 shell(如 /bin/sh)并将整条命令作为字符串交给 shell 解析。如果命令中的参数包含外部输入或不可信的变量名(例如包含 ; rm -rf / 或 && reboot),shell 会将其解释为复合命令,引发注入漏洞。
通过使用列表传递命令(如 ["ls", "-l", user_input]),系统直接通过 execvp 系统调用将 user_input 视为纯参数传给目标程序,从根本上杜绝了任何 shell 语法的二次解析。
三、健壮运维:超时控制、退出码检查与异常处理
运维脚本经常无人值守运行(例如配置在 Crontab 或 CI/CD Pipeline 中)。如果外部进程由于网络阻塞、死锁或等待交互输入而长时间挂起,没有防护的脚本将无限期僵死。通过 subprocess 的防御性参数可以构建自愈型执行流程。
1. 设定超时熔断(timeout)
在 subprocess.run() 中设置 timeout 参数(单位为秒)。一旦子进程运行超时,Python 将自动向其发送终止信号,并抛出 subprocess.TimeoutExpired 异常:
import subprocess

cmd = ["ping", "-c", "4", "192.168.1.1"]

try:
    result = subprocess.run(cmd, capture_output=True, text=True, timeout=5)
    print("网络连通状态输出:", result.stdout)
except subprocess.TimeoutExpired as exc:
    print(f"命令执行超时(超过 {exc.timeout} 秒),已主动终止该子进程!")
    # 此时依然可以检查可能已产生的部分输出
    print("已捕获输出片段:", exc.output)
2. 自动化退出码校验(check=True)
很多初学者会忽略命令的执行结果,导致后续步骤在错误的状态上继续运行。传入 check=True 可以让 subprocess.run 在子进程退出码非 0 时自动抛出 subprocess.CalledProcessError 异常:
import subprocess

try:
    # 尝试拉取远端配置
    subprocess.run(["curl", "-sSf", "https://internal.ops.local/config.json"], capture_output=True, text=True, check=True)
except subprocess.CalledProcessError as err:
    print(f"命令执行失败,退出状态码: {err.returncode}")
    print(f"错误输出详情: {err.stderr.strip()}")
    # 执行报警逻辑或退出
    raise SystemExit(1)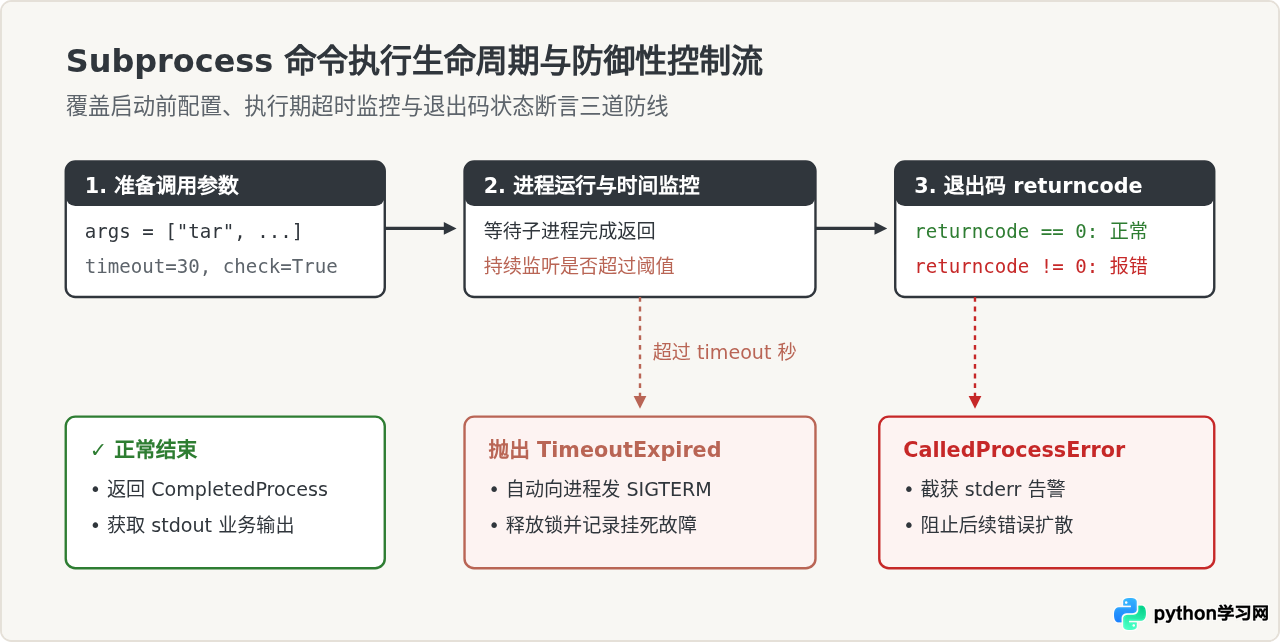
四、协同实战:日志归档与压缩清理脚本
在实际运维工作中,pathlib 与 subprocess 最常成对出现:通过 pathlib 精准定位、筛选并规范化待处理文件,再通过 subprocess 调度高性能系统工具(如 tar、gzip、zstd 等)进行流式处理。以下是一个工业级日志自动归档与轮转清理脚本示例:
import sys
import logging
import subprocess
from datetime import datetime
from pathlib import Path

# 配置日志记录
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def archive_and_clean_logs(log_base: Path, archive_base: Path, keep_days: int = 7):
    """
    扫描 log_base 目录下所有过期 .log 文件,利用 tar 打包压缩至 archive_base,
    确认打包校验无误后安全移除原文件。
    """
    if not log_base.exists():
        logging.error("指定的日志根目录不存在: %s", log_base)
        return False

    archive_base.mkdir(parents=True, exist_ok=True)
    today = datetime.now()
    archived_count = 0

    # 1. 使用 pathlib 扫描需要归档的文件
    for file_path in log_base.glob("*.log"):
        if not file_path.is_file():
            continue

        # 检查文件修改时间
        mtime = datetime.fromtimestamp(file_path.stat().st_mtime)
        file_age_days = (today - mtime).days

        if file_age_days >= keep_days:
            archive_filename = f"{file_path.stem}_{mtime.strftime('%Y%m%d')}.tar.gz"
            dest_archive = archive_base / archive_filename

            logging.info("正在归档: %s -> %s", file_path.name, dest_archive.name)

            # 2. 调用 subprocess 执行 tar 归档压缩
            tar_cmd = [
                "tar",
                "-czf",
                str(dest_archive),
                "-C",
                str(file_path.parent),
                file_path.name
            ]

            try:
                # 设置 60 秒超时与自动报错
                subprocess.run(tar_cmd, capture_output=True, text=True, check=True, timeout=60)

                # 校验归档文件大小确保写入有效
                if dest_archive.exists() and dest_archive.stat().st_size > 0:
                    file_path.unlink()  # 安全删除源日志文件
                    logging.info("归档成功,已移除原日志: %s", file_path.name)
                    archived_count += 1
                else:
                    logging.warning("归档文件存在但体积异常,保留原文件: %s", file_path.name)

            except subprocess.TimeoutExpired:
                logging.error("压缩文件 %s 超时,跳过该文件清理", file_path.name)
            except subprocess.CalledProcessError as err:
                logging.error("压缩失败 [%s]: %s", file_path.name, err.stderr.strip())

    logging.info("任务结束,本次共完成 %d 个文件的归档清理", archived_count)
    return True

if __name__ == "__main__":
    # 执行路径配置
    LOG_DIR = Path("/var/log/app_services")
    ARCHIVE_DIR = Path("/opt/data_backup/logs")
    archive_and_clean_logs(LOG_DIR, ARCHIVE_DIR, keep_days=3)
五、速查对照与实践建议
为了在编写运维脚本时快速挑选最符合工程规范的写法,下表总结了传统旧模式与现代标准库写法的对照关系:
| 场景需求 | 传统遗留写法(不推荐) | 现代标准库写法(推荐) | 优势与原因 |
|---|---|---|---|
| 路径拼接 | os.path.join(a, b) |
Path(a) / b |
语法紧凑直观,返回强类型 Path 对象,天然跨平台兼容 |
| 创建多层目录 | if not os.path.exists: os.makedirs |
path.mkdir(parents=True, exist_ok=True) |
一行代码解决递归创建与幂等性检查,避免竞争条件异常 |
| 文件名与后缀拆分 | os.path.splitext(os.path.basename(p)) |
p.stem, p.suffix |
属性化读取,无需繁琐切片与下标解构 |
| 执行系统命令 | os.system("cmd " + arg) |
subprocess.run(["cmd", arg]) |
杜绝 shell 注入隐患,支持精准捕获输出与超时熔断 |
| 获取命令执行结果 | os.popen("cmd").read() |
subprocess.run(..., capture_output=True, text=True) |
明确区分 stdout 与 stderr,同时拿到独立退出码 |
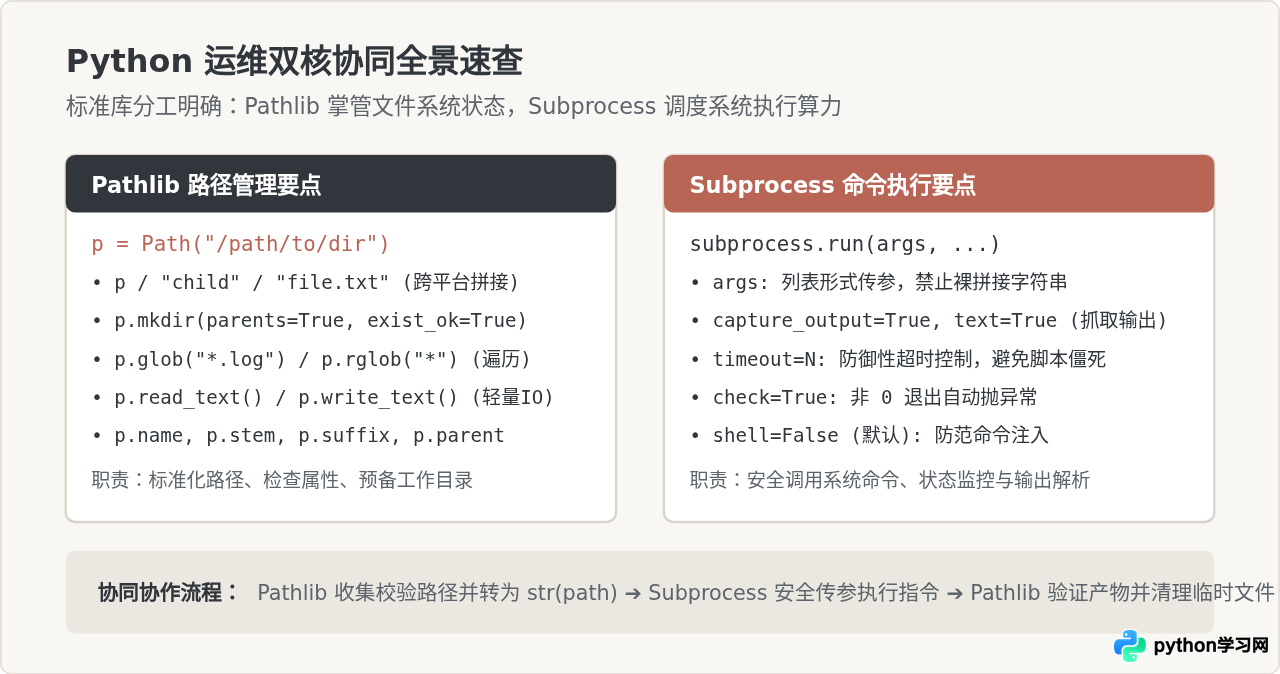
避坑提示:在将 Path 实例传递给 subprocess.run 时,Python 3.8+ 已经全面支持直接在参数列表中接收 Path 对象(实现了 os.PathLike 协议)。但在需要拼接外部参数或维护旧兼容性时,显式使用 str(path_obj) 依然是最清晰无误的工程习惯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















