


Python新闻爬虫中文乱码与403错误调试指南
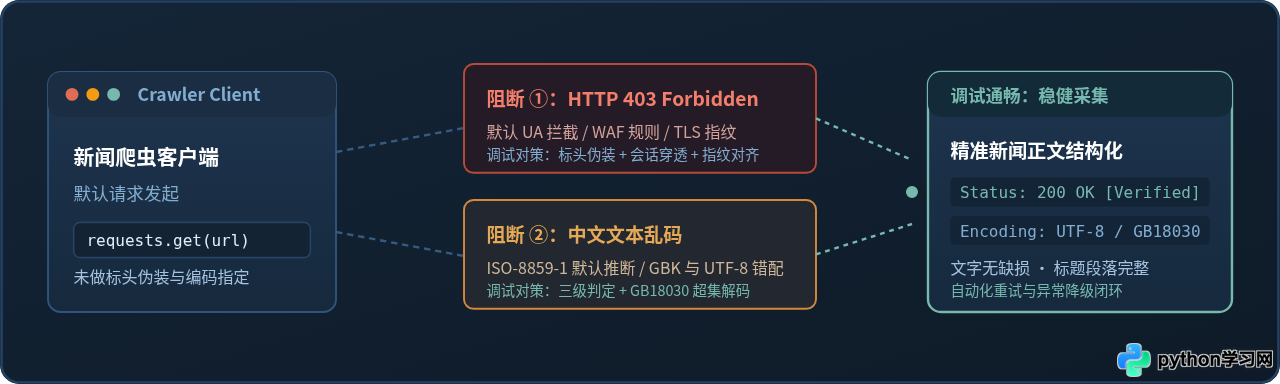
针对Python新闻爬虫开发中高频出现的中文乱码与HTTP 403 Forbidden错误,系统梳理底层编码判定机制、请求头与TLS指纹伪装、全流程排查步骤以及生产级健壮抓取代码。
假设你正在使用 Python 的 requests 库批量抓取主流中文新闻门户的宏观资讯,刚刚执行脚本,终端便遭遇了两种截然不同的阻断现象:一种是直接返回 <Response [403]>,服务器判定请求为非法人机流量并拒绝交互;另一种虽然获得了 200 成功响应,但无论是文章标题还是正文内容,打印出来均是一串类似“æ–°é—»”或连续“?”的无意义字符。这两个问题分别卡在爬虫数据链路的准入鉴权阶段与传输解码阶段。本文将深入拆解这两大故障的底层触发机理,提供逐层推进的排查流程、对比原理图示以及经过生产验证的稳健抓取实现。
一、中文乱码成因剖析与多层梯次解码
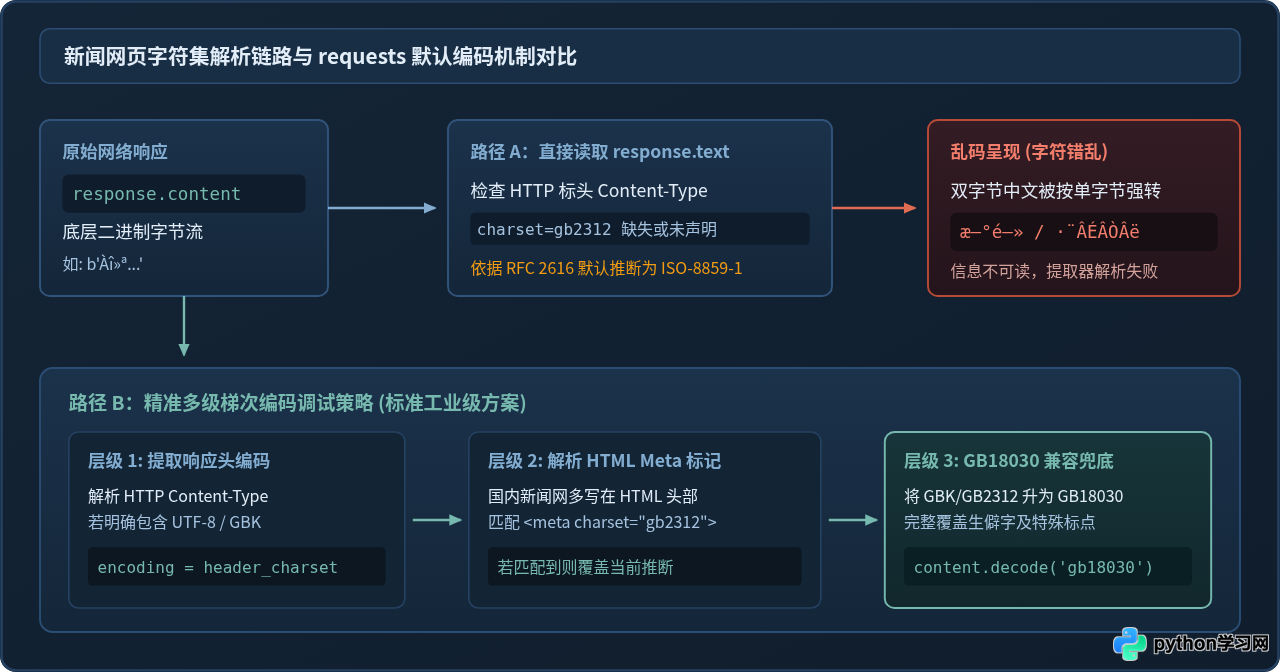
在网络传输中,一切文本在物理线路中均以二进制字节序列(Bytes)流动。爬虫客户端要想把字节流还原为人类可读的文字(Unicode 字符串),必须获知该字节流所遵循的字符集编码规格(如 UTF-8、GBK、GB2312 或 GB18030)。
1.1 requests 默认推断机制与 ISO-8859-1 陷阱
很多初学者抓取网页时习惯直接调用 response.text,这正是乱码发生的主要诱因。requests 在生成 .text 属性时,内部会先读取 response.encoding。如果目标服务器在 HTTP 响应头部的 Content-Type 中没有显式附带 charset 参数(例如头部仅返回 Content-Type: text/html),依据 HTTP/1.1 规范(RFC 2616),客户端应假定默认字符集为 ISO-8859-1(单字节西欧拉丁字符集)。
当一个原本使用双字节 GBK 或三字节 UTF-8 编码的汉字字节序列被 ISO-8859-1 逐字节当成 ASCII 扩展符去查表时,原本完整的汉字编码被强行撕裂,终端便会输出如“æ–°é—»”等西欧生僻符号。必须明确:此时服务器返回的原始二进制数据是完全正确的,错在客户端采用了错误的解码字典。
response.content 返回的是未经任何处理的底层 bytes 原生字节流;而 response.text 则是使用当前 response.encoding 解码后的 str 字符串。在调试乱码时,永远以 response.content 作为基准源数据,绝不能在已经解码乱套的 .text 字符串上再做二次推测。
1.2 apparent_encoding 的运作原理与性能取舍
社区中常见的一种调试建议是将代码写为 response.encoding = response.apparent_encoding。apparent_encoding 依靠底层的 charset_normalizer(或早期版本的 chardet)库,通过统计学频率算法扫描响应正文字节分布来猜测字符集。这种做法在处理中小型纯文本时通常有效,但在新闻爬虫中存在两大隐患:
- 性能损耗显著:对于几百 KB 包含大量广告脚本与 HTML 标记的新闻长文,统计学扫描需要耗费数十毫秒的 CPU 运算,在高并发采集任务中会成为严重性能瓶颈;
- 长尾短文本误判:若正文字数较少(例如快讯、快报、简讯),由于字频特征不显著,极易将
GB2312误判为韩文(EUC-KR)或日文(Shift_JIS)。
1.3 为什么统一升级为 GB18030 是最优解
我国新闻门户网站的历史演进具有特殊性。部分建立时间较早的新闻系统内部仍沿用 GB2312 或 GBK 编码,页面内部的 <meta charset="gb2312"> 声明甚至与后端的真实存储并不一致。GB2312 仅收录了 6763 个常用汉字,遇上人名、地名中的生僻字或特殊标点(如弯引号、破折号),直接使用 gb2312 解码会抛出 UnicodeDecodeError。而 GB18030 是国家强制标准,向下完全兼容 GBK 与 GB2312,并收录了超过 7 万个汉字。因此,凡是判断属于国标编码族的页面,一律统一使用 gb18030 进行解码。
二、HTTP 403 Forbidden 故障诊断与阶梯突破
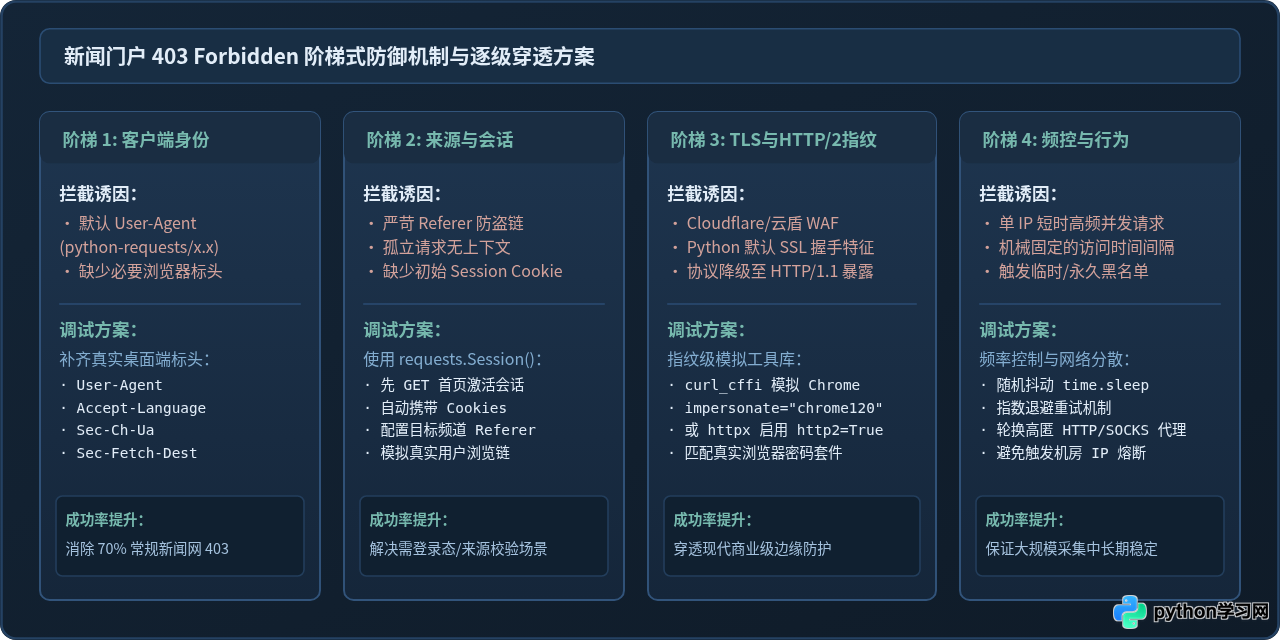
HTTP 403 意味着服务器充分理解了客户端发出的请求意图,但在策略层认定该客户端无权获取对应资源。对于新闻网站而言,绝大多数 403 并非真正的内容鉴权保护(如付费墙或后台管理系统),而是反爬安全网关(WAF / CDN)对异常访问流量的机械阻断。
2.1 阶梯一:请求头特征缺失与伪装
执行 requests.get(url) 时,默认携带的标头是 User-Agent: python-requests/2.x.x。对主流新闻站点而言,防火墙规则库里通常配置了最基本的正则过滤规则,一旦发现 UA 包含 python、crawler、bot 等字样,直接在网关层丢弃或响应 403。
此外,现代浏览器发出的请求会带有完整的协同标头。如果仅把 User-Agent 换成 Chrome,但缺少 Accept、Accept-Language、Sec-Ch-Ua 等元数据,部分对标头完整性做布尔判定的防爬网关依然会打上机器标记并拦截。
2.2 阶梯二:上下文关联与 Referer 防盗链校验
新闻门户通常存在频道聚合页(如财经列表页)与详情页。很多站点的详情页设置了同源或特定来源校验:请求头必须包含指向该新闻频道主站的 Referer,否则视为外部直接盗链或独立爬虫探查,直接返回 403。同时,新闻页面在初次载入时可能会下发与时间戳绑定的追踪 Cookie,孤立且无状态的单次 HTTP GET 请求极易触发安全告警。
2.3 阶梯三:TLS JA3 指纹与协议协商层检测
当开发者将请求头完整伪装为 Chrome 120 后,依然频繁收到 403 时,问题往往已经下沉到了 TLS 握手层。这是近年来 Cloudflare、Akamai、阿里云云盾等 Web 应用防火墙的主流防御手段。
Python 的 ssl 模块依赖系统的 OpenSSL 库,其在 TLS Client Hello 握手阶段所协商的密码套件(Cipher Suites)顺序、支持的椭圆曲线扩展与 ALPN 标识构成了固定且唯一的 TLS 指纹(即 JA3 / JA4 哈希)。浏览器端 Chrome 的 JA3 指纹与 Python 原生 OpenSSL 的指纹存在根本性差异。当服务端发现请求头声明自己是“Chrome 桌面端”,但在网络底层握手时却呈现典型的“Python-OpenSSL”指纹时,即可判定为伪装客户端并立即阻断。
三、新闻爬虫标准化调试排查步骤
面对抓取异常时,严禁盲目尝试无逻辑的参数修改。按照以下受控步骤依次推进,可以迅速定位问题根因:
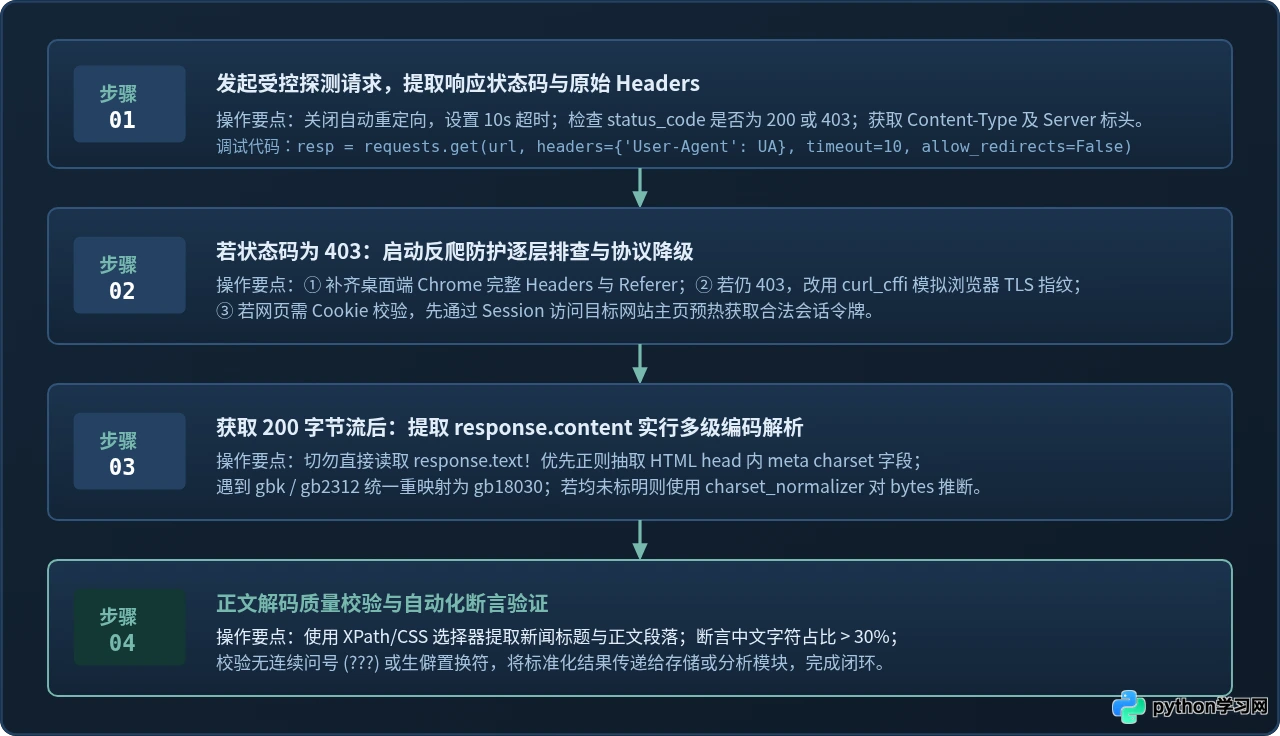
步骤 1:以隔离模式发起探测请求,记录状态码与标头
先用最小化的受控请求获取最基础的网络元数据,关闭自动重定向,并打印关键状态指标:
import requests

url = "https://news.example.com/finance/article_1024.html"
base_headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    "Accept-Encoding": "gzip, deflate, br",
}

# allow_redirects=False 便于捕获真实的 403 或重定向跳转
resp = requests.get(url, headers=base_headers, timeout=10, allow_redirects=False)
print(f"[Status] {resp.status_code}")
print(f"[Content-Type] {resp.headers.get('Content-Type')}")
print(f"[Server] {resp.headers.get('Server')}")[Status] 403
[Content-Type] text/html; charset=UTF-8
[Server] cloudflare
步骤 2:若状态码为 403,启动协议与指纹层穿透
若常规标头仍返回 403,直接调用基于标准客户端指纹实现的 curl_cffi 库进行请求复现。该库使用真实的浏览器客户端网络栈,自动对齐 JA3/JA4 握手特征与 HTTP/2 协议流:
# 依赖安装命令: pip install curl_cffi
from curl_cffi import requests as cffi_requests

# impersonate 参数全真模拟 Chrome 120 的 TLS 指纹与 HTTP/2 头部帧
resp_cffi = cffi_requests.get(
    url,
    headers=base_headers,
    impersonate="chrome120",
    timeout=10
)
print(f"[CFFI Status] {resp_cffi.status_code}")[CFFI Status] 200 (成功绕过 WAF 边缘检测)
步骤 3:获得 200 字节流后,执行多层降级编码判定
取得 status_code == 200 后,转入内容解析阶段。先从二进制字节流中正则扫描 <meta> 声明,若未获取到则依次降级到 Header 与统计推断:
import re

raw_bytes = resp_cffi.content

# 1. 优先提取 HTML 文档前 2048 字节中声明的 meta charset
meta_pattern = re.compile(rb'<meta[^>]+charset=["']?([a-zA-Z0-9_\-]+)', re.IGNORECASE)
match = meta_pattern.search(raw_bytes[:2048])

if match:
    detected_encoding = match.group(1).decode('ascii', errors='ignore').lower()
else:
    # 2. 尝试从响应头提取
    detected_encoding = resp_cffi.encoding or "utf-8"

# 3. 规范化映射:国标族统一升至 GB18030
if detected_encoding in ["gbk", "gb2312", "gb_2312", "windows-936"]:
    final_encoding = "gb18030"
elif "utf" in detected_encoding:
    final_encoding = "utf-8"
else:
    final_encoding = detected_encoding

html_text = raw_bytes.decode(final_encoding, errors="replace")
步骤 4:正文解码完整度断言与验证
最后,通过统计中文字符分布与关键段落长度,验证清洗结果是否真实可用,规避“半截乱码”流入存储环节。
四、生产级健壮新闻采集模块实现
综合上述原理与排查步骤,以下封装一套工业级的通用新闻页面抓取模块。该模块集成了请求头轮换、会话复用、TLS 浏览器指纹自适应降级、三级编码提取以及自动化中文质量断言功能。
import re
import time
import logging
from typing import Optional, Tuple, Dict, Any
import requests
try:
    from curl_cffi import requests as cffi_requests
    HAS_CURL_CFFI = True
except ImportError:
    HAS_CURL_CFFI = False

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("NewsCrawler")

class RobustNewsFetcher:
    """
    高稳定性新闻页面采集器
    具备 403 WAF 指纹穿透、三级编码推断与自动重试功能
    """
    DEFAULT_HEADERS: Dict[str, str] = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
        "Accept-Encoding": "gzip, deflate, br",
        "Sec-Ch-Ua": '"Chromium";v="122", "Not(A:Brand";v="24", "Google Chrome";v="122"',
        "Sec-Ch-Ua-Mobile": "?0",
        "Sec-Ch-Ua-Platform": '"Windows"',
        "Sec-Fetch-Dest": "document",
        "Sec-Fetch-Mode": "navigate",
        "Sec-Fetch-Site": "none",
        "Sec-Fetch-User": "?1",
        "Upgrade-Insecure-Requests": "1",
    }

    def __init__(self, timeout: int = 12, max_retries: int = 2):
        self.timeout = timeout
        self.max_retries = max_retries
        self.session = requests.Session()
        self.session.headers.update(self.DEFAULT_HEADERS)

    def _resolve_encoding(self, raw_bytes: bytes, header_encoding: Optional[str]) -> str:
        """三级字符编码自适应判别算法"""
        # 1. 解析 HTML 头部 meta 声明
        meta_pattern = re.compile(
            rb'<meta[^>]+(?:charset=["']?([a-zA-Z0-9_\-]+)|content=["'][^"']*charset=([a-zA-Z0-9_\-]+))',
            re.IGNORECASE
        )
        match = meta_pattern.search(raw_bytes[:3072])
        detected = None
        if match:
            g1, g2 = match.groups()
            detected = (g1 or g2).decode("ascii", errors="ignore").lower()

        # 2. 回退到 HTTP Header 声明
        if not detected and header_encoding and header_encoding.lower() != "iso-8859-1":
            detected = header_encoding.lower()

        # 3. 规范化映射与兜底
        if detected:
            if detected in ["gb2312", "gbk", "gb_2312", "windows-936"]:
                return "gb18030"
            if "utf-8" in detected or "utf8" in detected:
                return "utf-8"
            return detected

        # 4. 终极兜底:优先以 utf-8 试探,若失败则降级为 gb18030
        try:
            raw_bytes[:4096].decode("utf-8")
            return "utf-8"
        except UnicodeDecodeError:
            return "gb18030"

    def fetch(self, url: str) -> Tuple[bool, str, Dict[str, Any]]:
        """执行健壮抓取,返回 (成功标识, HTML字符串, 诊断元数据)"""
        meta = {"url": url, "attempts": 0, "engine": "requests", "encoding": ""}

        for attempt in range(1, self.max_retries + 2):
            meta["attempts"] = attempt
            try:
                # 阶段 A:使用标准 Session 请求
                resp = self.session.get(url, timeout=self.timeout)

                # 遇到 403 时,尝试利用 curl_cffi 升级突破
                if resp.status_code == 403 and HAS_CURL_CFFI:
                    logger.warning(f"Standard requests caught 403, upgrading to curl_cffi: {url}")
                    resp_cffi = cffi_requests.get(
                        url,
                        headers=self.DEFAULT_HEADERS,
                        impersonate="chrome120",
                        timeout=self.timeout
                    )
                    if resp_cffi.status_code == 200:
                        meta["engine"] = "curl_cffi"
                        raw_bytes = resp_cffi.content
                        encoding = self._resolve_encoding(raw_bytes, resp_cffi.encoding)
                        meta["encoding"] = encoding
                        html_text = raw_bytes.decode(encoding, errors="replace")
                        return True, html_text, meta

                # 正常 200 响应处理
                if resp.status_code == 200:
                    raw_bytes = resp.content
                    encoding = self._resolve_encoding(raw_bytes, resp.encoding)
                    meta["encoding"] = encoding
                    html_text = raw_bytes.decode(encoding, errors="replace")
                    return True, html_text, meta

                logger.warning(f"Fetch HTTP {resp.status_code} on attempt {attempt}: {url}")

            except requests.RequestException as e:
                logger.error(f"Network error on attempt {attempt}: {e}")

            time.sleep(1.0 * attempt)

        return False, "", meta
代码验证与断言方法
为确保采集回来的文本没有发生隐式截断或乱码污染,可在解析器前置加入断言逻辑。以下是测试抓取效果的具体验证方法:
if __name__ == "__main__":
    fetcher = RobustNewsFetcher()
    test_url = "https://news.sina.com.cn/"  # 典型可能包含 GBK/UTF-8 混合新闻

    success, html, diag = fetcher.fetch(test_url)
    assert success is True, f"抓取失败,元数据: {diag}"
    assert len(html) > 1000, "返回正文字符数异常偏短"

    # 校验是否含有正常的中文字符集(通过统计中文汉字占比)
    chinese_chars = len(re.findall(r'[一-龥]', html))
    assert chinese_chars > 100, f"中文有效字符数过低 ({chinese_chars}),极大概率存在乱码!"

    print(f"✔ 验证通过!成功采集,最终解析编码: {diag['encoding']},中文字符数: {chinese_chars}")
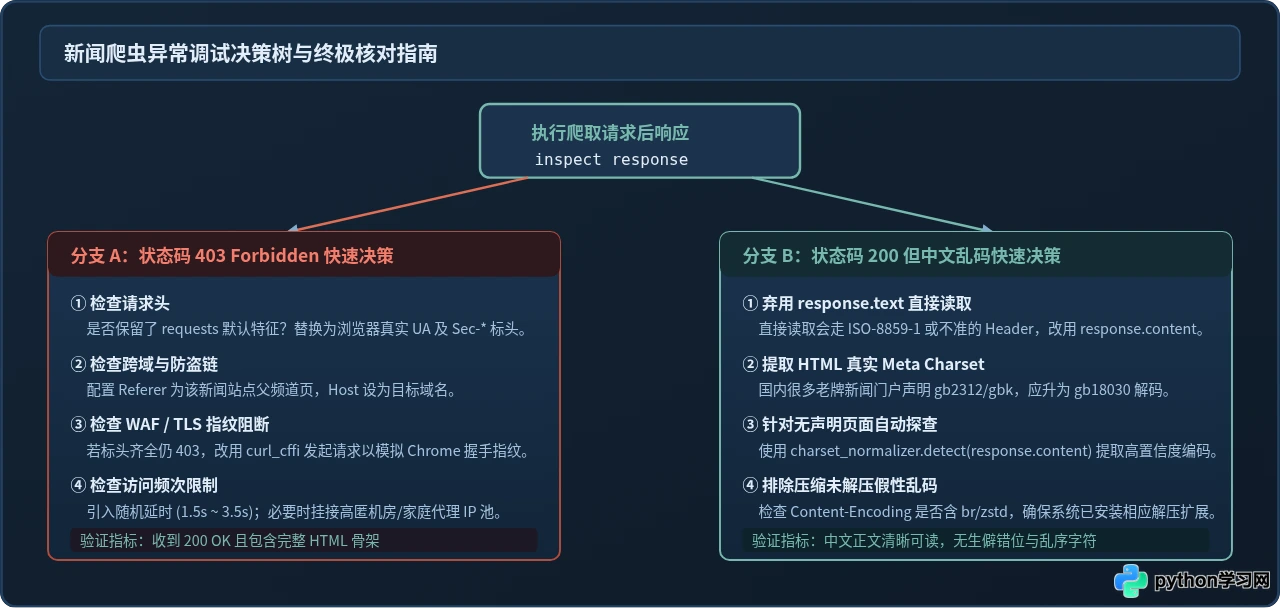
五、故障排查决策树与常见场景速查
将日常排查新闻爬虫故障的思考路径归纳为以下决策体系。当程序在测试环境或生产环境发生异常时,可直接按图索骥:
| 故障表象 | 根本原因 | 核心调试手段 | 预期恢复结果 |
|---|---|---|---|
| 中文变成“å‰åˆ”或连续问号 | HTTP 标头缺少 charset,requests 默认按照 ISO-8859-1 解码 | 弃用 response.text,改用 response.content 并优先读取 meta charset |
正文字符清晰显示,生僻字不抛异常 |
| 部分生僻人名/引号显示为方框或抛出 UnicodeDecodeError | 页面使用了 GBK / GB2312,但内容超出了字符集子集收录范围 | 在解码前统一将 gb2312 与 gbk 映射为 gb18030 |
生僻字、特殊标点与繁体字正常渲染 |
| 终端打印乱码且首字节为二进制压缩标识(如 ) | 请求头声明了 Accept-Encoding: gzip, br,但运行环境缺少 brotli 模块未能自动解压 |
执行 pip install brotli,或改用 response.content 走标准自动解压流 |
恢复为常规 HTML 明文字符串 |
| 单次测试正常,上并发后立刻 403 | 触发了新闻站点的 IP 频控或单 IP 短时并发限制阈值 | 降低并发度,加入 random.uniform(1.0, 3.0) 抖动,引入高匿动态代理池 |
状态码稳定在 200,连接不被重置 |
| 已完整伪装桌面端 User-Agent 与标头,依然稳定返回 403 | 遇到商业 WAF(如 Cloudflare / 云盾),被识别了 Python 的 TLS JA3 握手特征 | 引入 curl_cffi 替换标准 requests,设置 impersonate="chrome120" |
穿透 WAF 防护层,成功拿到 HTML 正文 |
现代大型新闻站点(新浪、网易、腾讯、人民网等)的前端架构正在向动静分离演进。若排查确认页面解码完全正确但正文容器标签内内容为空,应打开浏览器开发者工具检查“Network - Fetch/XHR”,确认新闻正文是否改为通过 JSON 接口异步加载。此时直接抓取并解析对应的 API 接口通常具有更高的吞吐量与稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















