


Python多线程死锁与多进程资源泄漏:常见陷阱及避免方法
深入解析Python多线程开发中的ABBA死锁、重入锁陷阱,以及多进程环境下的僵尸进程、Queue管道阻塞与共享内存泄漏,提供经过生产检验的规避代码、排查工具与架构范式。
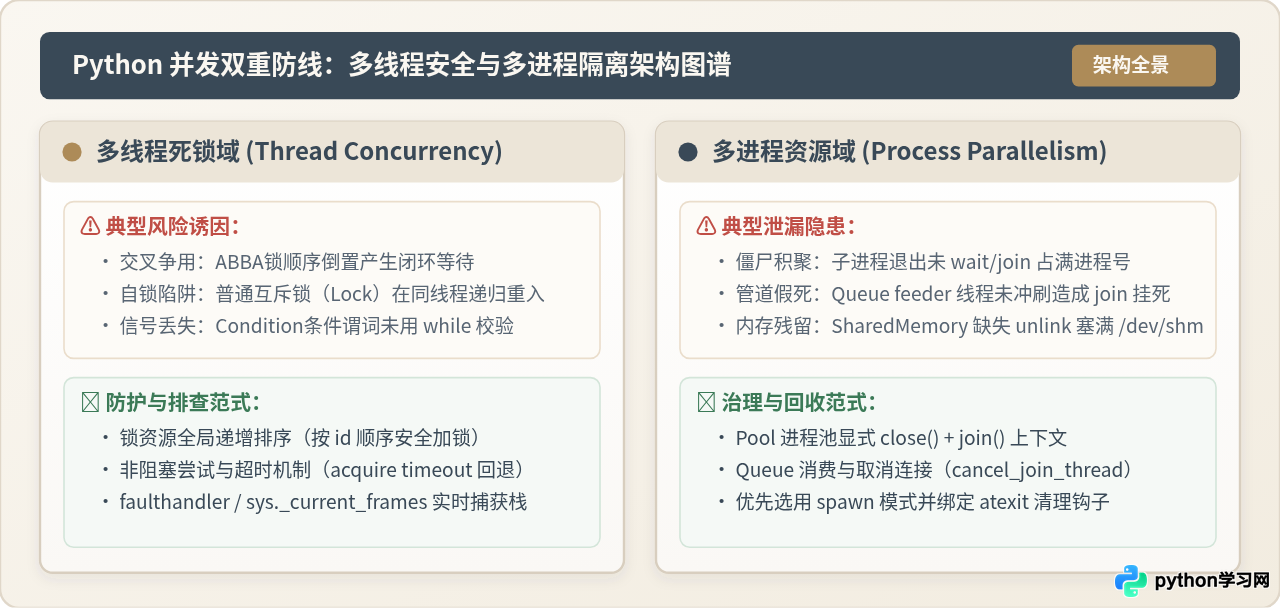
在Python并发与并行编程中,多线程中的死锁与多进程中的资源泄漏是两类隐蔽且高发的系统级故障。死锁多由互斥锁时序竞争、不可重入递归加锁或异常未正确回滚导致,使工作线程永久挂死;资源泄漏则集中于孤儿与僵尸进程未回收、IPC管道缓冲区未清空导致进程假死,以及共享内存(SharedMemory)未被显式注销(unlink)而持续膨胀。解决这些问题的核心路径在于打破死锁的四个必要条件,并为多进程资源引入严格的全生命周期上下文管理。本文将详细剖析最常踩中的核心陷阱,并给出标准排查工具和工程级预防实现。
一、多线程死锁:三大典型陷阱与根因剖析
在CPython运行时中,由于全局解释器锁(GIL)的存在,许多开发者误以为多线程程序无需担心复杂的并发问题。然而,GIL仅能保证单个字节码指令执行的原子性,无法保护业务逻辑层面的多步骤临界区。当多个线程使用 threading.Lock 或其他同步原语时,死锁(Deadlock)依然频繁发生。
1. 陷阱一:交叉加锁与循环等待(经典的 ABBA 死锁)
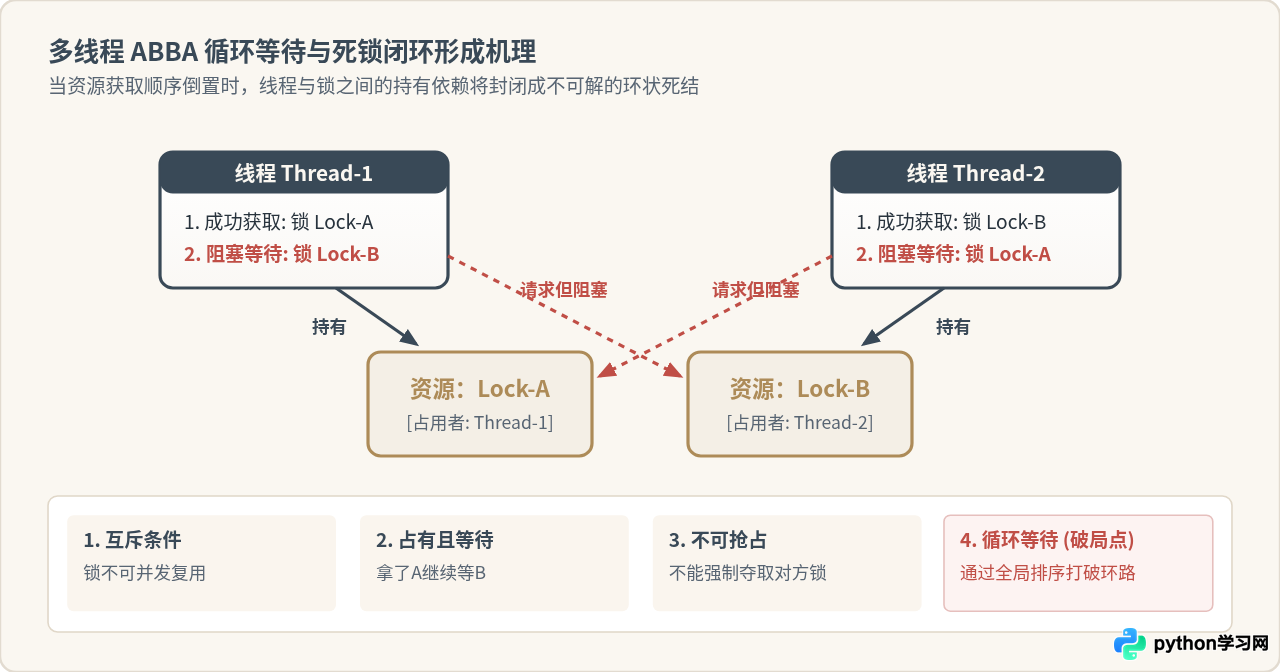
最常见且最隐蔽的死锁发生在多个线程以不同的顺序申请同一组锁时。例如:线程 1 先获取锁 A,再请求锁 B;与此同时,线程 2 先获取了锁 B,转而请求锁 A。此时双方各自持有对方所需的资源,同时等待对方释放,程序在无任何报错提示的情况下永久停滞。
import threading
import time

lock_a = threading.Lock()
lock_b = threading.Lock()

def worker_thread_1():
    with lock_a:
        time.sleep(0.01)  # 模拟耗时业务,放大时间窗口
        # 此时若 worker_thread_2 已拿到 lock_b,此处将无限期阻塞
        with lock_b:
            pass

def worker_thread_2():
    with lock_b:
        time.sleep(0.01)
        # 此时 worker_thread_1 已占有 lock_a,此处将无限期阻塞
        with lock_a:
            pass

# 同时启动两个线程,触发死锁
t1 = threading.Thread(target=worker_thread_1)
t2 = threading.Thread(target=worker_thread_2)
t1.start()
t2.start()
t1.join()
t2.join()
学术上,死锁的产生必须同时满足四个必要条件(Coffman 条件):
- 互斥条件(Mutual Exclusion): 资源不能被多个线程共享,锁同一时刻只能被一个线程持有。
- 占有且等待(Hold and Wait): 线程持有了至少一个资源,并继续申请已被其他线程持有的资源。
- 不可抢占(No Preemption): 线程已获得的资源在未主动释放前,不能被外界强行剥夺。
- 循环等待(Circular Wait): 存在一个线程等待链:T1 等待 T2 持有的锁,T2 等待 T1 持有的锁。
2. 陷阱二:不可重入锁与同线程“自死锁”
Python 标准库的 threading.Lock 是标准的互斥锁(Mutex),并不支持重入。如果同一个线程在尚未释放锁的情况下,由于递归调用、回调函数或嵌套逻辑再次请求该锁,将直接自我阻塞:
import threading

lock = threading.Lock()

def helper_function():
    # 陷阱:同线程二次 acquire 导致自锁
    with lock:
        print("执行辅助逻辑")

def main_task():
    with lock:
        print("执行核心逻辑")
        helper_function()

# 调用 main_task() 将永远卡死在 helper_function 的 with lock 处threading.RLock(可重入锁)。RLock 内部维护了一个持有线程 ID 与重入计数器。但注意,RLock 的 acquire 与 release 必须严格成对出现;此外,RLock 的运行时开销略高于普通 Lock,不应无节制替代普通锁。
3. 陷阱三:条件变量(Condition)误判与信号丢失
使用 threading.Condition 协调生产者与消费者时,常见陷阱是使用 if 而非 while 来判断唤醒条件。由于操作系统的调度特性或底层唤醒机制,线程可能经历“虚假唤醒(Spurious Wakeup)”;若采用 if 检查,线程被唤醒后在条件仍未满足时就往下执行,极易导致状态紊乱或逻辑死锁。
二、多线程死锁的预防与排查方案
规避死锁最有效的手段是主动打破循环等待条件。在工程实践中,主要采用“全局锁层级”与“超时自旋回退”两种机制。
1. 预防策略:全局锁层级(按内存地址/唯一键排序)
只要系统中所有线程在需要同时获取多个锁时,严格按照预先约定的固定次序(例如锁对象的 id() 或自定义递增标识)获取,就绝不可能形成环状等待。以下是可直接复用的多锁安全获取上下文管理器:
import threading
from contextlib import contextmanager

@contextmanager
def acquire_locks(*locks):
    """
    按照锁的内存地址全局单调递增排序,确保加锁次序绝对一致,
    从根本上消除 ABBA 循环等待。
    """
    sorted_locks = sorted(locks, key=lambda l: id(l))
    acquired = []
    try:
        for lock in sorted_locks:
            lock.acquire()
            acquired.append(lock)
        yield
    finally:
        # 释放时按相反顺序释放
        for lock in reversed(acquired):
            lock.release()

# 使用方式:无论传入顺序如何,内部自动保证加锁一致性
# 线程 1
with acquire_locks(lock_a, lock_b):
    pass

# 线程 2 (即便逆向传入,也会自动调整为一致次序)
with acquire_locks(lock_b, lock_a):
    pass
2. 在线排查步骤:使用 faulthandler 与 sys._current_frames
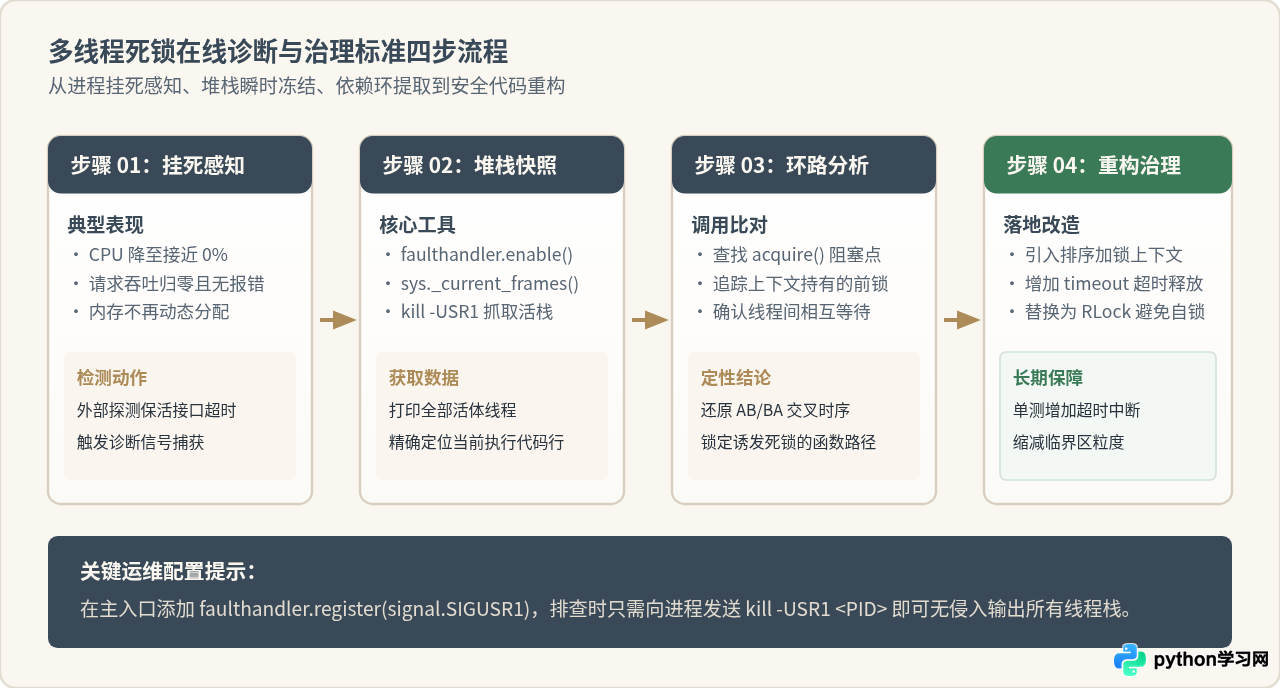
当生产环境中的 Python 进程突然失去响应且 CPU 占用率极低时,极大概率陷入了死锁。以下是定位死锁标准且高效的排查流程:
import faulthandler
import signal
import sys
import traceback

# 1. 注册 USR1 信号处理:kill -USR1  自动在标准错误输出全部活跃线程栈
faulthandler.register(signal.SIGUSR1)

# 2. 或者在代码内部编写排查函数进行主动快照
def dump_all_threads():
    print("=== 开始捕获所有活跃线程调用栈 ===", file=sys.stderr)
    for thread_id, frame in sys._current_frames().items():
        print(f"\n--- 线程 ID: {thread_id} ---", file=sys.stderr)
        traceback.print_stack(frame, file=sys.stderr)
    print("=== 调用栈快照输出完毕 ===", file=sys.stderr)
三、多进程资源泄漏:四大高发场景与根因剖析
由于多进程间拥有独立的虚拟内存空间,很多人认为多进程模型更加健壮、“完全隔离”。然而,多进程的资源不仅包括物理内存,还深度依赖操作系统的内核数据结构(PID 进程表、文件描述符表、POSIX 共享内存段、IPC 管道与信号量)。一旦生命周期管理缺失,会导致系统级资源不可逆泄漏。
1. 陷阱一:僵尸进程(Zombie Process)与进程号耗尽
子进程执行完毕退出后,并不会立刻从操作系统内核中彻底消失。其退出状态信息(包括退出码、CPU统计)会保留在内核的进程表中,等待父进程调用 wait() / waitpid()(在 Python 中表现为 process.join())进行读取。
如果父进程长时间运行、源源不断创建子进程,却从不调用 join(),这些已经终结的子进程就会变成僵尸进程(在 ps 中标记为 [defunct] 或 Z)。当系统可用的 PID 耗尽时,系统将拒绝创建任何新进程,导致所有系统级操作瘫痪。
2. 陷阱二:multiprocessing.Queue 隐蔽的管道假死与缓冲区泄漏
这是 multiprocessing.Queue 最恶名昭彰的死锁陷阱。Python 的 Queue 并不是纯内核对象,它内部依赖一个后台 Feeder 线程将序列化的对象推送到底层 OS 管道(Pipe)。
当子进程向 Queue 写入了较多数据,但父进程并没有完全读取,此时子进程尝试退出时,其内部会自动等待后台 Feeder 线程将缓冲区数据全部清空。然而管道缓冲区已满,Feeder 线程被无限期挂起;若父进程紧接着调用 child_process.join(),就会出现:父进程等子进程退出,子进程等父进程把管道读空。双方陷入永久挂起,关联的文件句柄也无法回收。
from multiprocessing import Process, Queue

def writer(q):
    # 写入大量数据塞满管道缓冲区
    for i in range(100000):
        q.put("x" * 1024)
    # 子进程执行完毕试图退出,Feeder 线程因缓冲区满阻塞无法终止

if __name__ == "__main__":
    q = Queue()
    p = Process(target=writer, args=(q,))
    p.start()

    # 典型陷阱:在尚未完全消耗 Queue 数据前调用 join()
    # 导致父子进程互相等待,程序永久挂起!
    p.join()

    # 正确做法:先读取消费数据,或者在不需要残留数据时使用 q.cancel_join_thread()
3. 陷阱三:POSIX 共享内存(SharedMemory)与信号量残存
Python 3.8 推出的 multiprocessing.shared_memory.SharedMemory 允许跨进程零拷贝传输超大数据(如 NumPy 矩阵)。但必须清醒认识到:共享内存段是操作系统全局的持久内核资源,独立于进程的生命周期!
仅仅调用 shm.close() 只会断开当前进程的文件映射句柄;只有最后调用 shm.unlink() 才会通知操作系统内核销毁该内存段。如果创建共享内存的进程异常崩溃或未执行 unlink(),该共享内存段会永远残留在 /dev/shm 中,即使父子进程均已退出,物理内存也不会释放,直到机器重启或手动注销!
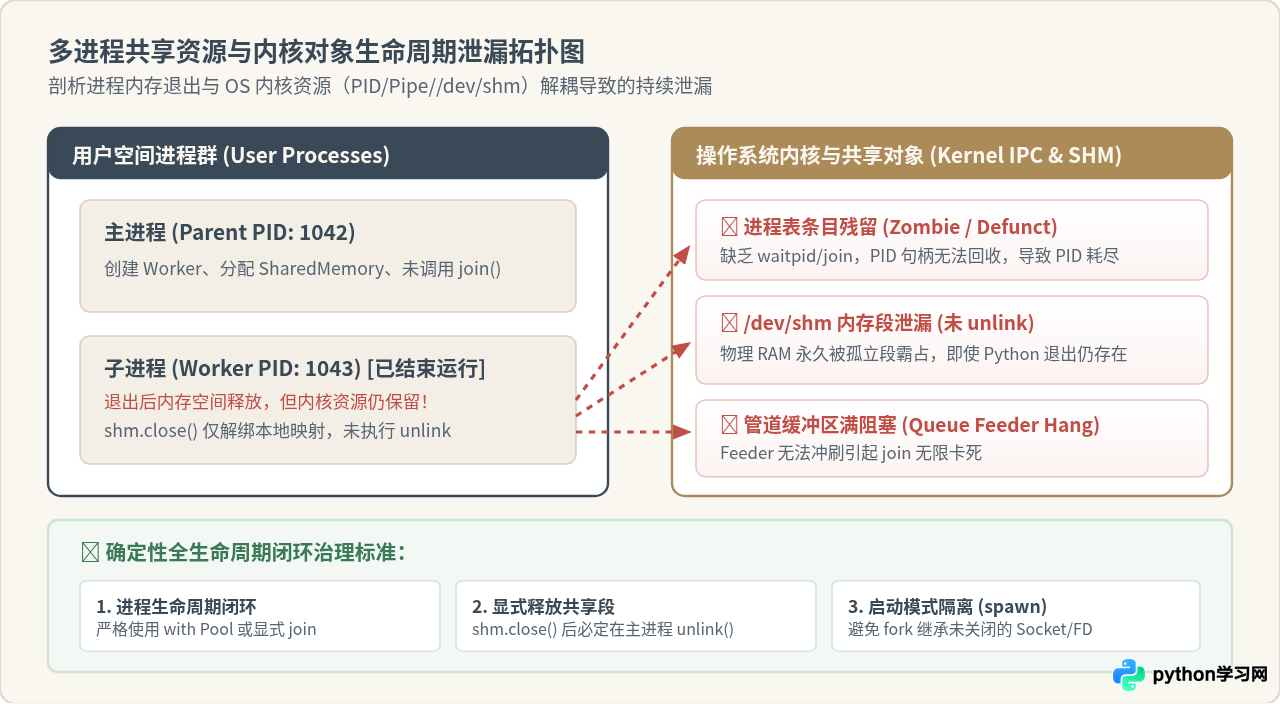
4. 陷阱四:fork 模式下的文件描述符(FD)隐式继承与连接污染
在 Linux 平台上,Python 默认曾长期采用 fork 作为多进程的启动方式(Start Method)。fork 会将父进程中打开的所有文件描述符、数据库连接、Redis 套接字乃至尚未触发的锁状态全盘拷贝至子进程。
子进程若未显式关闭这些继承而来的文件描述符,不仅会导致系统 FD 数量激增报警,还会因多进程并发向同一个 TCP 连接收发数据而产生严重的数据错乱与协议解析崩溃。
四、多进程资源生命周期管理最佳实践
避免多进程资源泄漏,核心在于不依赖操作系统的隐式回收,对所有外部资源实施确定性的清理兜底。
1. 规范进程池使用:标准上下文与终止链
对于批量任务,强烈推荐使用 multiprocessing.Pool 的上下文管理器,但需注意其退出行为。在 Python 3.7+ 中,with Pool(...) as pool: 在退出代码块时仅会调用 pool.terminate(),而不会等待任务优雅收尾。如果需要等待任务全部完成并彻底释放资源,应显式保证 close() 和 join() 链条:
import multiprocessing

def safe_process_pool_execution(tasks):
    # 显式管理进程池生命周期
    pool = multiprocessing.Pool(processes=4)
    try:
        results = pool.map_async(worker_task, tasks)
        # 获取结果并设定业务超时,防止子任务挂死阻塞主线程
        return results.get(timeout=60)
    finally:
        # 1. 停止接受新任务
        pool.close()
        # 2. 回收子进程退出码,清除僵尸进程状态
        pool.join()
2. 共享内存安全包装类:atexit 与 weakref 双重兜底
为彻底杜绝 /dev/shm 中遗留孤立内存块,在创建共享内存时,可将其封装在具有确定性析构和退出注册的生命周期管理器中:
import atexit
from multiprocessing import shared_memory

class SafeSharedMemory:
    """
    具备自动回收与全局退出兜底的共享内存管理包装器
    """
    def __init__(self, size: int, name: str = None, create: bool = True):
        self.is_creator = create
        self.shm = shared_memory.SharedMemory(create=create, size=size, name=name)

        # 若是创建者,注册进程退出兜底清理
        if self.is_creator:
            atexit.register(self.cleanup)

    @property
    def buf(self):
        return self.shm.buf

    def cleanup(self):
        try:
            self.shm.close()
        except BufferError:
            pass
        if self.is_creator:
            try:
                self.shm.unlink()
                print(f"[Resource Cleaned] 共享内存 {self.shm.name} 已成功 unlink 注销")
            except FileNotFoundError:
                pass

    def __enter__(self):
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        self.cleanup()
3. 切换进程启动模式:优先采用 spawn 替代 fork
为了杜绝文件描述符继承与多线程混用时的 fork 死锁,建议在程序主入口显式设置启动方法为 spawn(Windows/macOS 默认,Linux 可选)。spawn 会启动一个全新的 Python 解释器实例,仅传递必要参数,不继承父进程的任何多线程状态与文件句柄:
import multiprocessing

if __name__ == '__main__':
    # 在所有多进程操作前显式设置
    multiprocessing.set_start_method('spawn', force=True)
    # 启动后续工作进程...
五、并发防御指南与决策对比
下表系统对比了多线程与多进程在常见故障、陷阱场景、检测手段及预防机制上的关键差异,可作为并发架构选型与评审的参考依据:
| 比对维度 | 多线程并发体系 (Threading) | 多进程并行体系 (Multiprocessing) |
|---|---|---|
| 核心资源载体 | 内存共享、线程私有栈、系统原生线程 | 独立虚拟内存空间、内核进程表、OS 级 IPC 设施 |
| 首要致命风险 | 锁竞争死锁(Deadlock)、竞态条件、虚假唤醒 | 僵尸进程堆积、/dev/shm 内存泄漏、Pipe 缓冲区卡死 |
| 排查诊断工具 | faulthandler、sys._current_frames() |
ps aux | grep defunct、ls /dev/shm、lsof -p |
| 标准预防范式 | 加锁次序单调排序、带 timeout 的加锁尝试、RLock 重入 | with Pool() 上下文、shm.unlink()、显式 join() |
| 隔离防护推荐 | 细化临界区粒度,优先选择 queue.Queue |
强制使用 spawn 启动模式,杜绝 FD 隐式跨进程泄漏 |
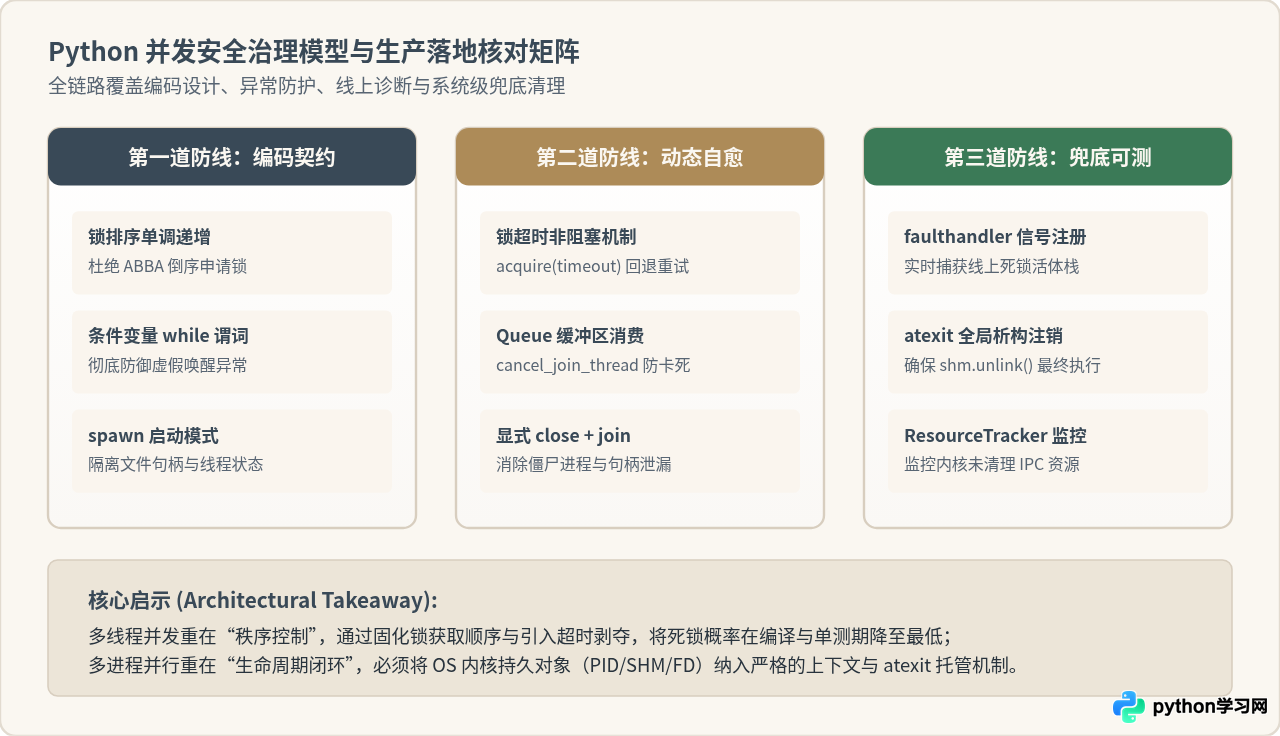
- 锁顺序审查: 是否存在多个函数交错获取
lock1和lock2的情况?是否可以使用acquire_locks统一排序? - 加锁超时机制: 所有可能产生争用的
lock.acquire()是否设置了合理的timeout,还是盲目无限期阻塞? - 子进程退出回收: 所有的
multiprocessing.Process是否都有对应的join(),或者已被托管在明确的 Pool 上下文中? - 共享内存注销:
SharedMemory创建端是否包含shm.unlink(),并注册了异常或atexit清理钩子? - IPC 管道排空: 向
Queue写入大量数据的进程在退出前,是否已确保数据被消费,或调用了cancel_join_thread()?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















