


怎么用项目驱动法巩固Python 3基础知识
详细解析如何通过微型项目驱动法扎实巩固Python 3基础知识,提供从知识点解耦、I/O协议确立到增量编码与边界重构的完整落地指南及配套可运行示例。
一、为什么传统按章刷题难以真正掌握Python 3基础
初学Python 3时,绝大多数读者都会经历这样的循环:跟随教程学习变量赋值、if/else分支、for与while循环,再到list、dict与set等内置容器。在看书或观看教学视频时,每一节的配套单行练习通常都能顺利通过。然而,一旦关闭参考答案,面对一个没有任何引导的空白代码编辑器,往往不知道第一行代码该从哪里写起。
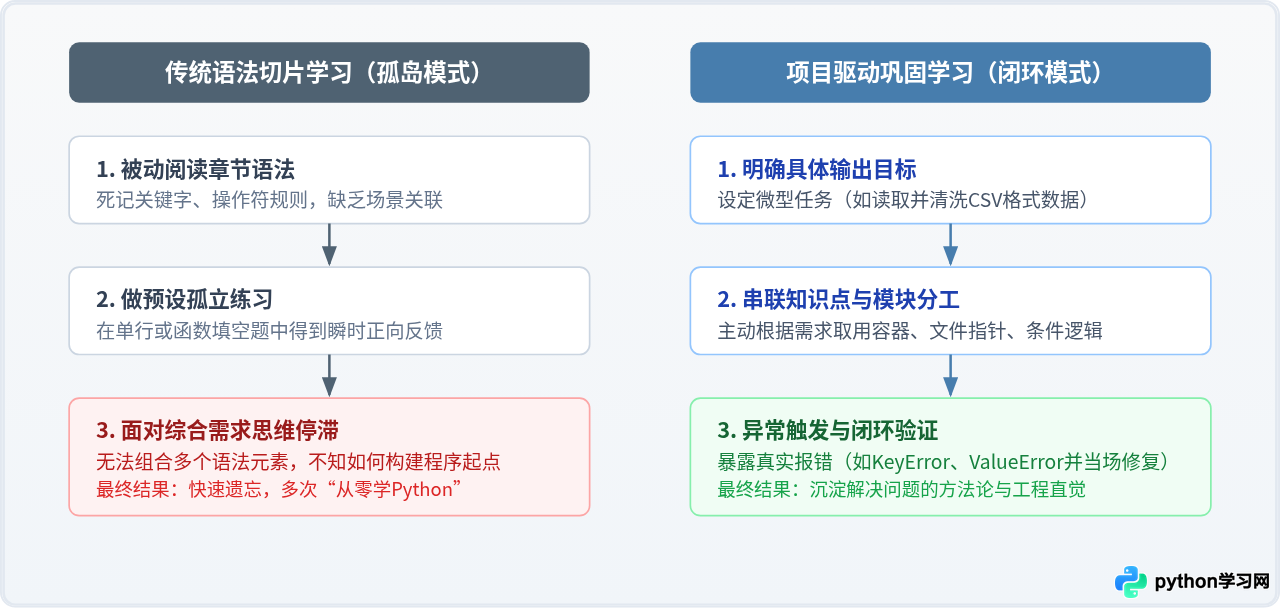
这种现象被称为“虚假熟练度陷阱”。传统按章学习的模式是“知识点切片式”的,每道练习题预先设定了唯一考核点(例如“请用列表推导式过滤偶数”)。学习者在此情境下处于被动填空状态,大脑无需判断“什么时候应该选用列表而非字典”、“当输入数据格式异常时程序如何保活”,更没有处理多个语法点组合协作的机会。
项目驱动法的价值在于反转认知链路:不再以“我今天必须把字典学完”为起点,而是以“我要做一个能统计本地文本单词出现频次的命令行工具”为目标。在解决这个具体任务时,你必须主动调动文件读写(open/with)、字符串清洗(strip/split)、容器计数(dict或collections.Counter)以及数据排序输出。语法从被动记忆的知识符号,变成了解决实际障碍的工具。
二、四步落地法:如何设计与实施一个基础巩固项目
实施项目驱动法绝不意味着初学者要立刻去开发一个复杂的电商系统或全功能博客。过早引入庞大的第三方框架(如Django或PyQt)只会让初学者被复杂的配置、数据库ORM和前端技术分散注意力,丧失巩固Python 3核心语法的初衷。
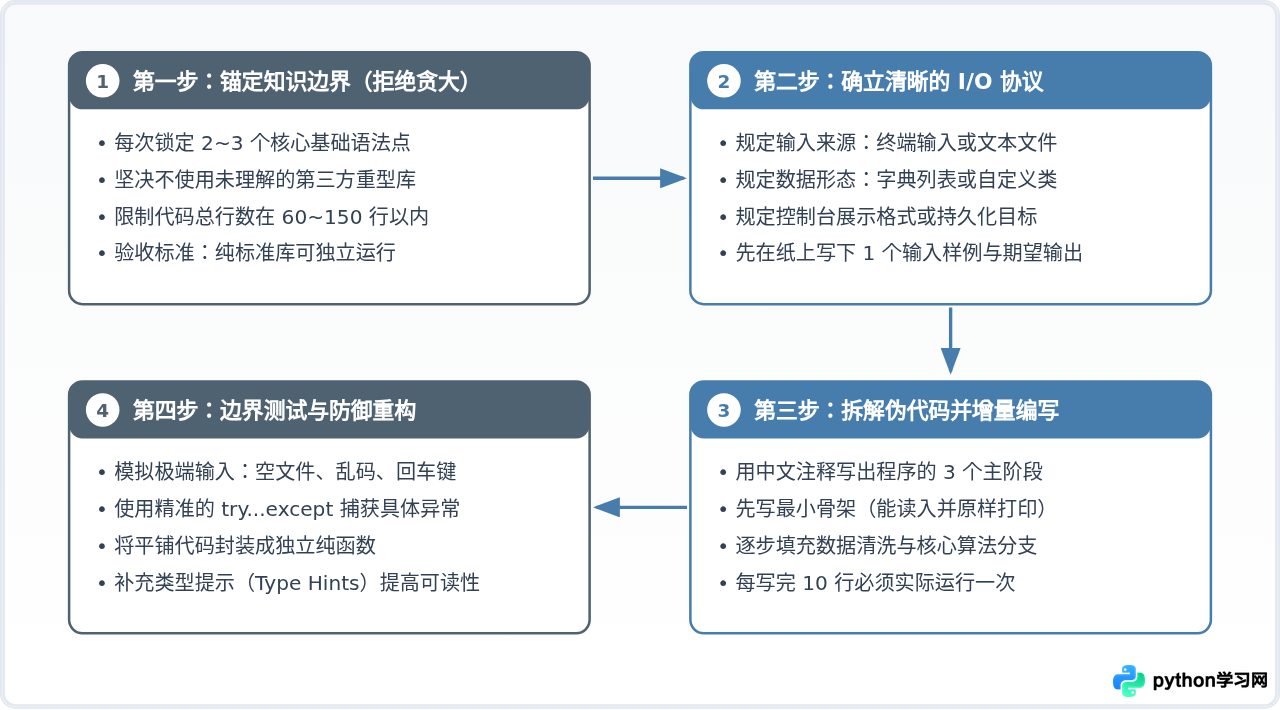
有效的项目驱动应当是“轻量级、自包含、单任务”的。推荐遵循以下四步实施闭环:
1. 锚定单一或组合语法点
在立项之前,必须在笔记本上写下本项目的目标语法清单。例如:“本次任务只考核三个点:with open()文件读写、dict字典嵌套结构、try/except ValueError异常捕获”。一旦中途产生想给它加上GUI界面或调用云端API的想法,必须立刻克制。超纲的技术栈会稀释基础语法的训练密度。
2. 明确输入与输出(I/O)协议
计算机程序的本质是数据的转换。在编码前,先规定输入格式(例如标准控制台字符串输入,或者一行一个记录的.txt文件),以及最终输出的形式(例如整齐对齐的控制台报表,或者转换后的JSON数据)。明确I/O之后,中间的处理逻辑就是对基础语法的具体组合过程。
3. 增量编码:从骨架到细节
严禁一次性写完整整100行代码再点击运行。正确的做法是:
- 用注释列出顶层结构(如
# 1. 初始化容器、# 2. 循环读取、# 3. 统计汇总)。 - 先写能够打印输入数据的最简代码,验证数据是否进得来。
- 逐步补充数据清洗与判断逻辑,每完成一个子功能,运行一次并观察中间变量。
4. 边界排错与重构
当程序在“理想输入”下成功跑通时,任务只完成了50%。剩下的50%是基础能力飞跃的关键期:
- 如果用户直接输入回车,程序会报错吗?
- 如果读取的文件不存在或内容为空,会出现
FileNotFoundError还是IndexError? - 有没有重复的代码段可以抽离为带参数的独立函数?
三、知识点与微项目映射方案
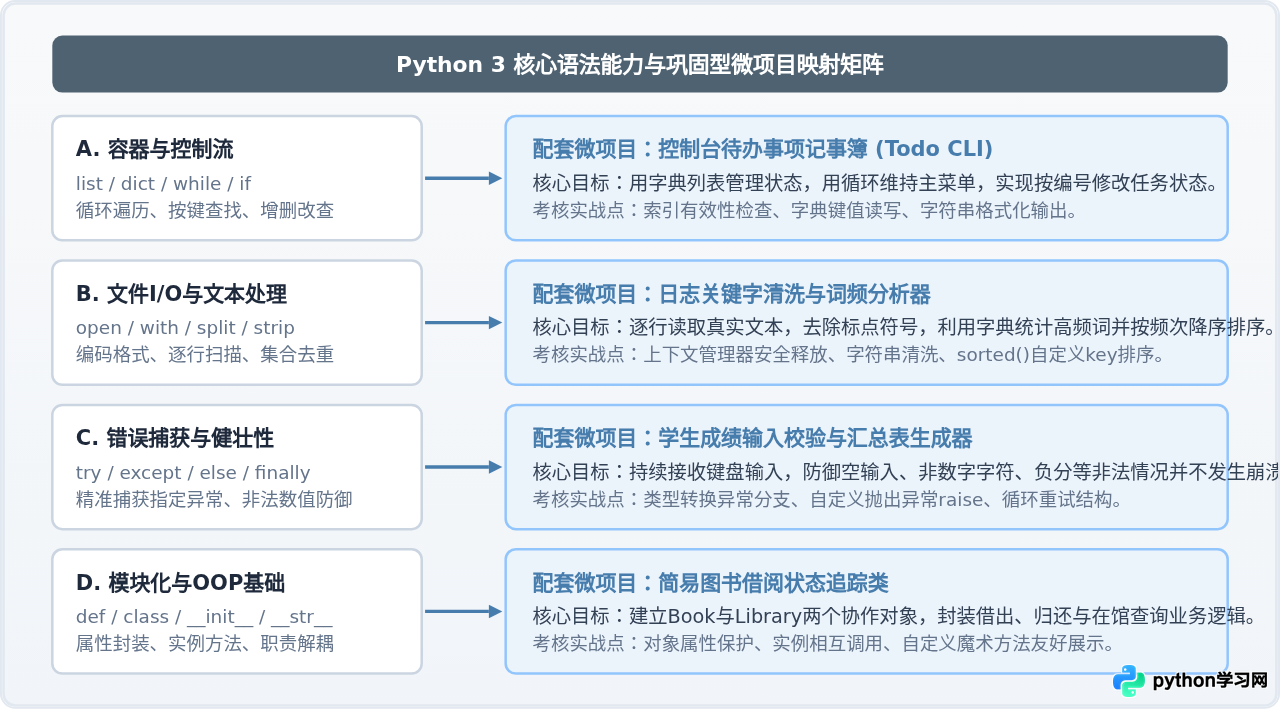
为了让读者有直观的参照,下表及图示归纳了Python 3常见基础知识点与对应微型项目的设计映射。选择项目时,可以按照由浅入深的层级逐步推进。
四、完整实战范例:从零构建“文件词频统计与清洗工具”
为了具体展示如何通过微项目将各个知识点融会贯通,下面以“文本清洗与Top-K高频词提取”为例。这个项目涵盖了以下基础考点:
- 文件操作:使用
with open(...)确保句柄自动释放,显式指定encoding='utf-8'规避不同操作系统编码陷阱。 - 字符串方法:使用
lower()统一大小写,使用translate()或条件判断剥离标点符号。 - 字典数据结构:使用普通
dict的get()默认值方法实现无依赖的频次累加。 - 高级内置函数:使用
sorted()配合匿名函数key=lambda x: x[1]实现字典按值降序排序。 - 异常防御:使用
try...except FileNotFoundError捕获文件缺失,保证程序优雅退出。
完整可执行源代码(word_counter.py)
# word_counter.py
# 执行环境:Python 3.8+ 纯标准库环境,无需安装任何第三方依赖

import string
import os

def clean_and_split(text: str) -> list:
    """
    清洗原始文本:统一转换为小写,过滤英文标点符号,拆分为单词列表。
    """
    # 创建标点符号映射表(将所有标点替换为空格)
    translator = str.maketrans(string.punctuation, " " * len(string.punctuation))
    cleaned_text = text.translate(translator).lower()

    # 拆分并过滤长度不足 2 个字符的无意义词
    words = [w for w in cleaned_text.split() if len(w) >= 2]
    return words

def count_frequencies(words: list) -> dict:
    """
    统计单词出现次数,返回频次字典。
    """
    counts = {}
    for word in words:
        # 使用 dict.get(key, 0) 处理键不存在的边界情况
        counts[word] = counts.get(word, 0) + 1
    return counts

def analyze_file(file_path: str, top_k: int = 5):
    """
    主执行函数:读取文件并输出 Top-K 词频榜单。
    """
    try:
        with open(file_path, mode="r", encoding="utf-8") as f:
            content = f.read()
    except FileNotFoundError:
        print(f"[错误] 目标文件未找到: {file_path}")
        return
    except UnicodeDecodeError:
        print(f"[错误] 文件编码非UTF-8,无法正确解码: {file_path}")
        return

    words = clean_and_split(content)
    if not words:
        print("[提示] 文本内容为空或无有效单词。")
        return

    freq_dict = count_frequencies(words)

    # 将字典条目转换为 (word, count) 元组列表,并按频次降序排列
    sorted_items = sorted(freq_dict.items(), key=lambda item: item[1], reverse=True)

    print(f"\n=== 分析完成: 共发现 {len(freq_dict)} 个独立单词,前 {top_k} 名如下 ===")
    print(f"{'排名':<6}{'单词':<15}{'频次':<6}")
    print("-" * 28)
    for rank, (word, count) in enumerate(sorted_items[:top_k], start=1):
        print(f"{rank:<6}{word:<15}{count:<6}")

if __name__ == "__main__":
    # 创建测试样例文件
    test_file = "sample_note.txt"
    sample_text = (
        "Python is a clear and powerful object-oriented programming language. "
        "Python is easy to learn for beginners, and Python provides great libraries."
    )
    with open(test_file, "w", encoding="utf-8") as f:
        f.write(sample_text)

    # 运行分析函数
    analyze_file(test_file, top_k=3)

    # 清理临时文件
    if os.path.exists(test_file):
        os.remove(test_file)
排名 单词 频次
----------------------------
1 python 3
2 is 2
3 and 2
- 字典排序的误区:初学者常试图对字典本身调用
.sort()。请记住字典本身没有排序方法,必须通过sorted(dict.items(), key=...)得到元组列表。 - 文件读取内存溢出:当处理极大型文本(数GB)时,一次性
f.read()会占满内存。进阶思考时可改为for line in f:逐行清洗累加。
五、实施项目驱动法的三大常见误区与避坑指南
在辅导与自学实践中,很多学习者虽然意识到了项目驱动的重要性,却往往因为方法偏差而半途而废。以下三个误区需要特别警惕:
误区一:陷入“大项目执念”,一开始就引入庞大框架
不少人在刚学完列表和字典后,就急于上手网页爬虫框架(如Scrapy)、异步网络(如Aiohttp)或Web后端(如Django)。这些框架自身包含了大量的抽象设计和配置约定。当程序报错时,80%的问题是由于框架配置不当或网络协议异常造成的,而非Python基础语法错误。初学者会把宝贵的时间消耗在查阅第三方框架的英文文档上,完全失去了巩固语言本身核心能力的机会。
误区二:“照抄代码”产生的虚假成就感
跟着视频或博客一步步把作者的代码敲进编辑器,即使运行成功,脑神经也并未建立主动联结。检验是否真正掌握的标准只有一条:“把代码窗口关掉,把需求重新列在记事本上,自己能不能从第一行开始独立还原出来?”如果在没有参考代码的情况下寸步难行,说明你只是打字员,而非写作者。
误区三:遇到错误立即搜索引擎盲搜,忽视Traceback日志
Python 3自带的错误追溯(Traceback)是极其清晰和友好的。每次报错时,Python不仅指出了错误的具体类型(如 KeyError, TypeError, IndexError),还精确到了文件名和代码行数。基础阶段最宝贵的财富恰恰是亲手调试各种报错。不要一看到红色报错就整体复制去搜索,先看最后一行是什么错误类型,再看倒数第二行指出是在哪一行代码发生的,顺着变量的值顺藤摸瓜。
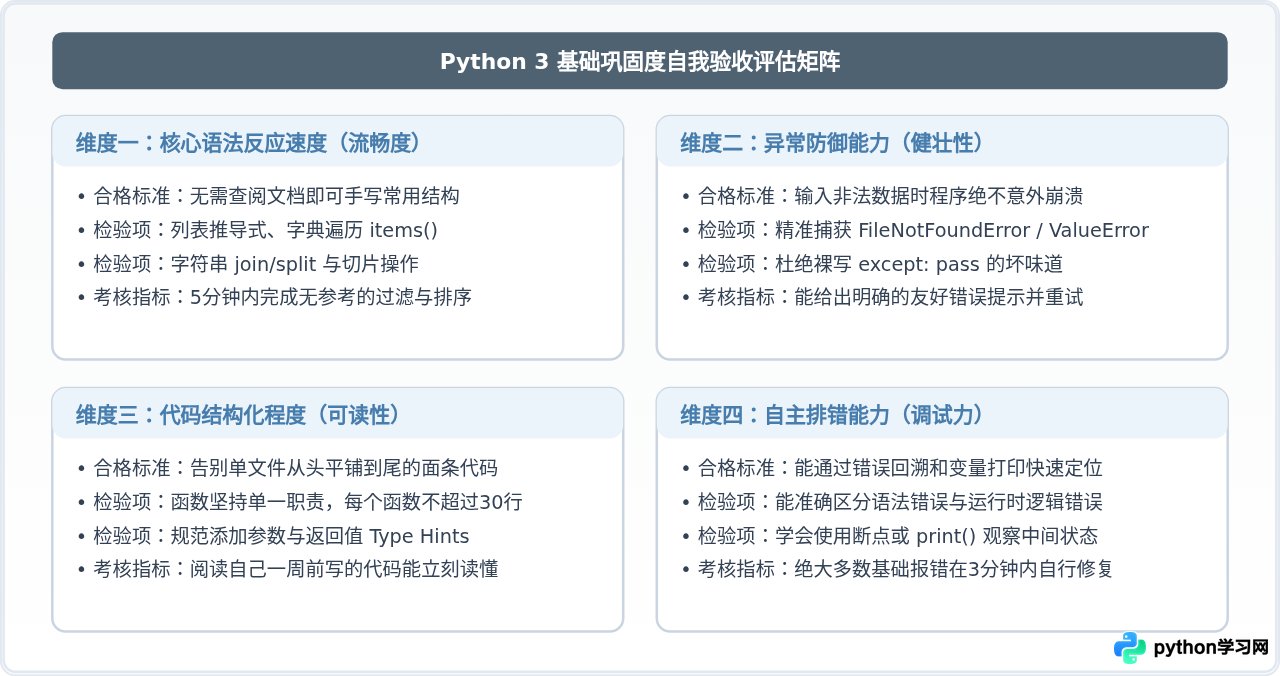
六、基础巩固成果的自我评估与验收矩阵
当你完成了3~5个微型项目后,如何判断自己的Python 3基础是否已经真正扎实?可以通过以下四个维度进行量化复盘与自我检测。
七、持续践行的日常建议
巩固Python 3基础并不是一个有终点的突击任务,而是一种把日常需求转化为代码实现的习惯。推荐读者在本地电脑上建立一个名为 python-foundations-lab 的个人代码仓库,按照日期或模块划分文件夹。
当你在日常工作或学习中遇到需要批量重命名文件、从剪贴板提取指定格式电话号码、整理桌面杂乱文件、汇总几个表格中相同列名数据时,不要急着寻找现成软件。尝试用1~2个小时的时间,使用Python 3的标准库为自己量身编写一个微型脚本。当你把这些独立完成的小工具一件件放进自己的工具箱时,Python 3的基础知识就已经真正沉淀为肌肉记忆了。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















