


Python用secrets模块生成更安全的随机字母
详细讲解在Python中如何使用标准库secrets模块生成密码学安全的随机字母与字母串,解析CSPRNG底层原理、与random模块的安全性差异,并提供生产环境可用的代码示例与安全注意事项。
random.choice。但在涉及密码与凭证的场景中,random 模块的算法存在被逆向推导的风险。Python 3.6 起内置的 secrets 模块专用于解决安全随机数需求。本文介绍如何使用 secrets 配合 string 模块快速生成高强度的单字母及指定长度字母串,解析密码学安全伪随机数生成器(CSPRNG)的底层机制,并提供规范的代码范式与避坑要点。
一、为什么 random 不够安全,而 secrets 可以?
Python 标准库中包含两个常用于生成随机数据的模块:random 与 secrets。许多开发者在编写生成随机会话标识、验证码或随机测试串时,最常使用的是 random.choice。然而官方文档明确警告:random 模块绝不能用于安全敏感或加密用途。
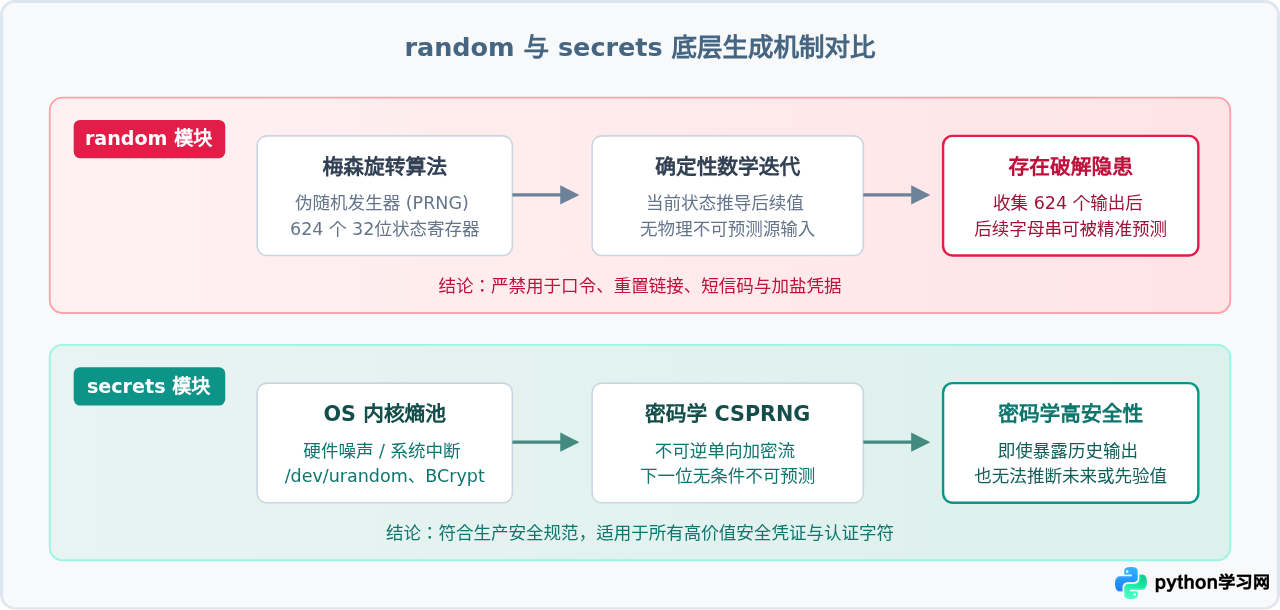
根本原因在于两者背后的随机数发生器机制有着本质差异:
-
random模块(伪随机数,PRNG):采用梅森旋转算法(Mersenne Twister, MT19937)。该算法周期极长且统计分布均匀,适合科学计算、数据抽样和模拟仿真。但它是一个确定性状态机。攻击者只要观察到连续输出的 624 个 32 位整数,就能精确推算出发生器的内部寄存器状态,进而预测未来的每一个随机值,甚至推算先前的历史输出。 -
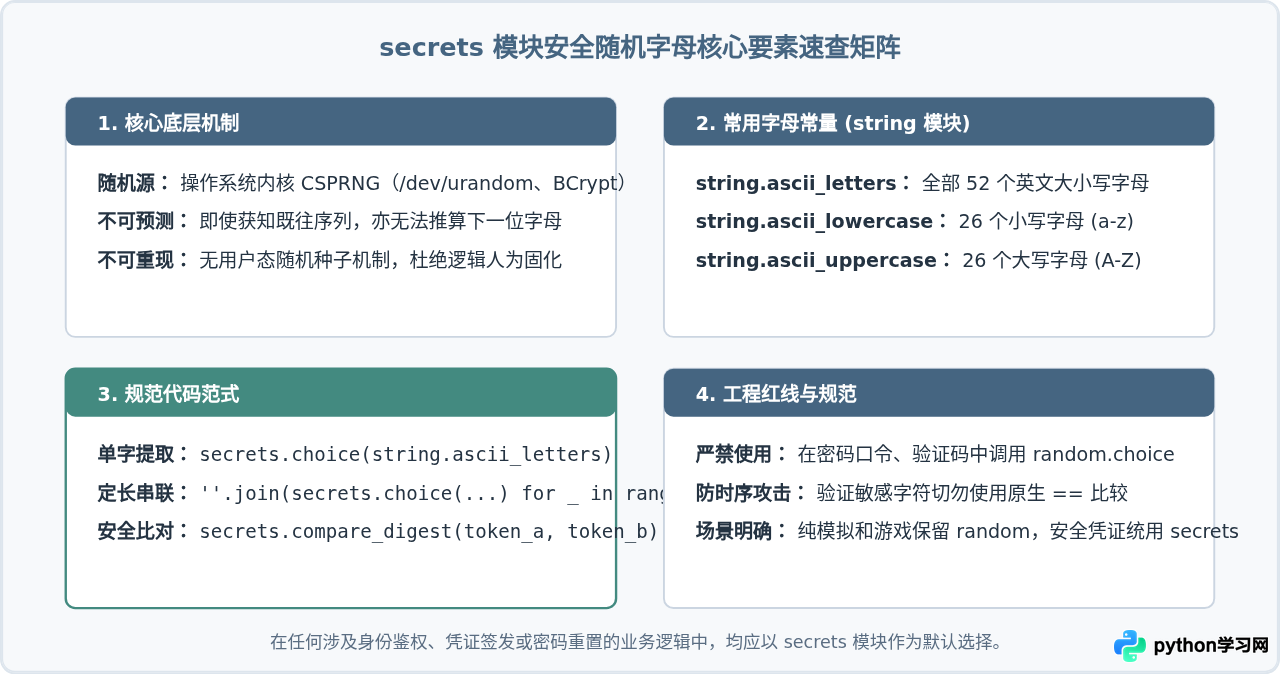
secrets模块(密码学安全伪随机数,CSPRNG):直接调用宿主操作系统内核维护的高熵随机源(例如 Linux 的getrandom()系统调用、macOS/Unix 的/dev/urandom以及 Windows 的BCryptGenRandom)。这些随机源融合了硬件噪音、中断时间及不可预测的系统事件,具备“下一位不可预测性”与抗逆向推导特性,达到密码学安全级别。
| 对比维度 | random 模块 |
secrets 模块 |
|---|---|---|
| 随机数算法 | 梅森旋转算法 (MT19937) | 操作系统 CSPRNG 内核熵池 |
| 状态可预测性 | 完全可逆向预测 (获取 624 个输出后) | 不可预测 (计算复杂度不可行) |
| 随机种子机制 | 可通过 random.seed() 重现 |
不可手动设置种子(强制系统熵源) |
| 适用场景 | 游戏、蒙特卡洛模拟、乱序洗牌 | 密码、临时凭证、防重放Token、验证码 |
二、生成安全随机字母的核心操作步骤
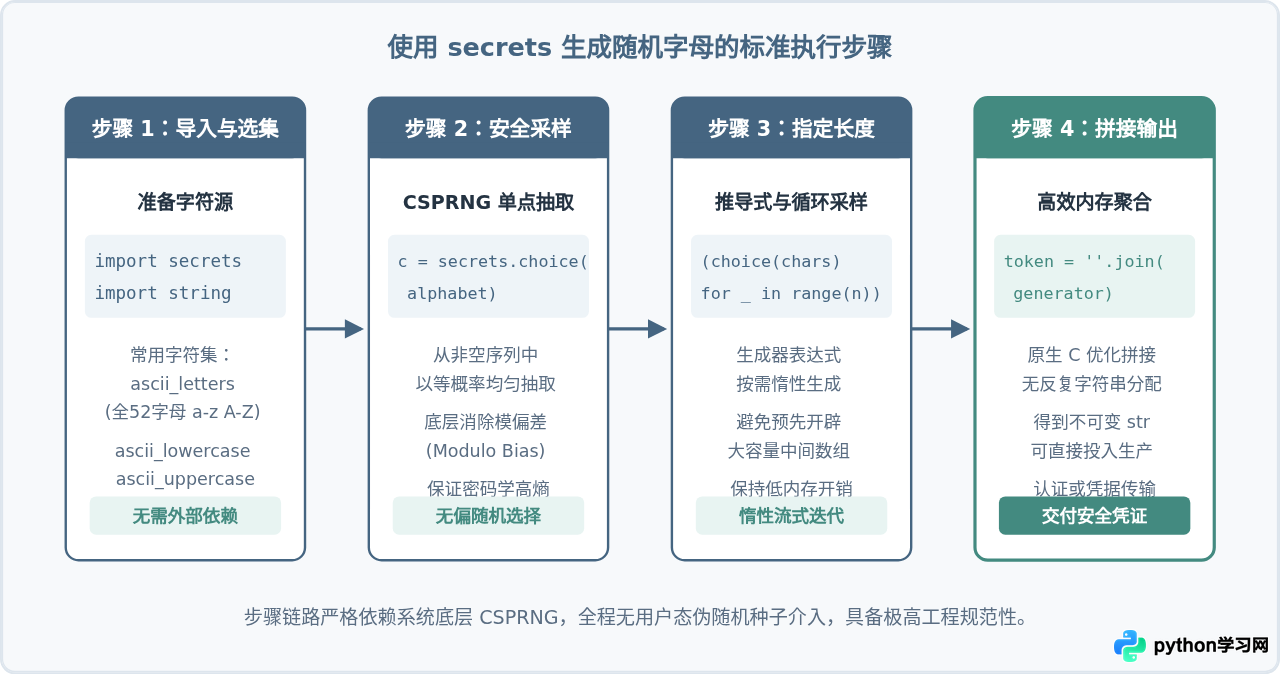
在 Python 中,结合 string 模块提供的标准字符常量与 secrets.choice() 方法,是生成指定长度随机字母的标准做法。具体实现可分为四个操作步骤:
步骤 1:导入模块与明确候选字符集
Python 标准库的 string 模块中预定义了完整的 ASCII 字母常量。根据业务对大小写的要求,可以选择不同的字符源:
string.ascii_letters:包含小写与大写共 52 个英文字母('abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ')。string.ascii_lowercase:纯小写 26 个字母('a'到'z')。string.ascii_uppercase:纯大写 26 个字母('A'到'Z')。
步骤 2:抽取单个安全随机字母
secrets.choice(sequence) 是核心方法,它接收一个非空序列(例如字符串或列表),并通过系统 CSPRNG 均匀抽取其中的一个元素。
# 抽取单个安全随机字母示例
import secrets
import string

single_letter = secrets.choice(string.ascii_letters)
print(f"安全随机字母: {single_letter}")步骤 3 与步骤 4:生成指定长度的纯字母序列
需要生成长度为 N 的字母串时,最规范高效的方式是使用生成器推导式配合 ''.join()。这种方式能充分利用 Python 内部的 C 优化完成单次内存分配拼接,执行效率高且代码表达简洁:
import secrets
import string

def generate_random_letters(length: int = 16) -> str:
    """使用 secrets 模块生成指定长度的安全纯字母字符串。

    参数:
        length: 需要生成的字母串长度,需大于 0。
    返回:
        由大小写英文字母组成的随机字符串。
    """
    if length <= 0:
        raise ValueError("生成长度必须大于 0")

    alphabet = string.ascii_letters
    return ''.join(secrets.choice(alphabet) for _ in range(length))

# 调用函数生成 16 位与 32 位安全字母串
token_16 = generate_random_letters(16)
token_32 = generate_random_letters(32)

print("16位随机字母凭据:", token_16)
print("32位随机字母凭据:", token_32)32位随机字母凭据: YxRnWpLkQsDaVbCjGhTmFeZrXyUiPoNm
三、典型应用场景与代码实现
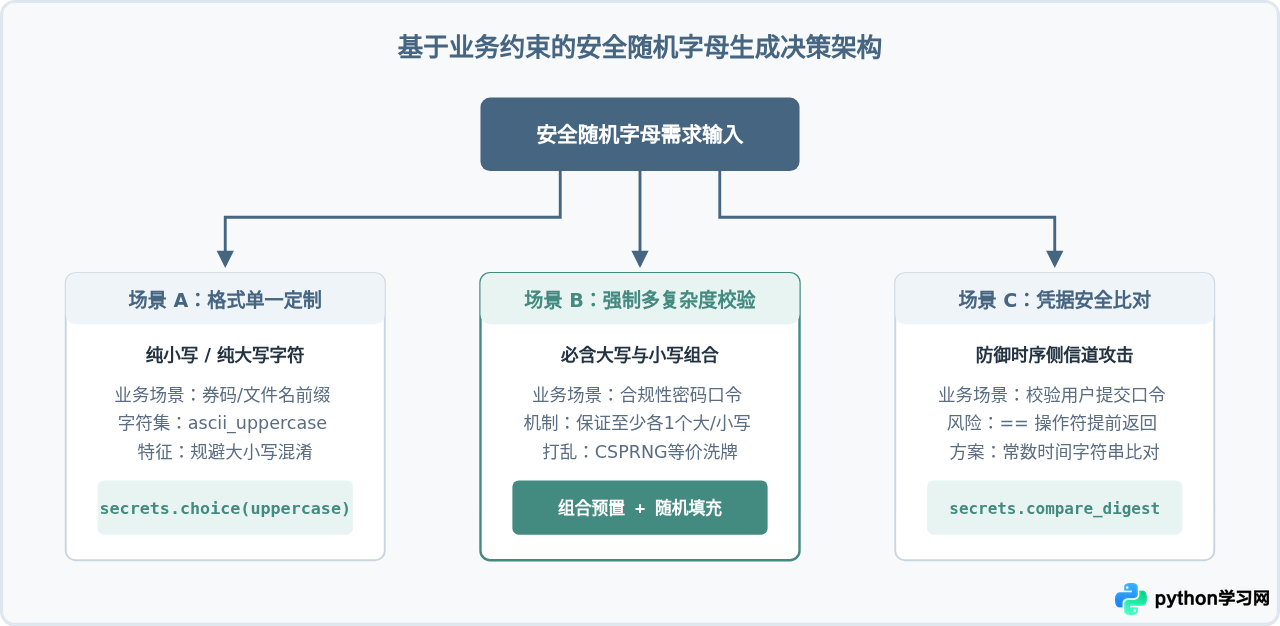
现实开发中,对随机字母的需求往往不仅限于无规则抽取,还需要满足特定格式约束(例如限制全大写、强制混合大小写或与既有标准凭证比对)。以下为三种高频场景的完整落地实现。
场景 1:生成仅包含大写字母的安全兑换码/工单号
在人机交互、客服报修或纸质票据打印场景中,小写字母(如 l 与 1、o 与 0)容易产生视觉歧义。直接指定 string.ascii_uppercase 可以生成便于人工阅读且密码学安全的大写字母凭据:
import secrets
import string

def generate_uppercase_code(length: int = 8) -> str:
    """生成指定长度的纯大写安全随机字母串。"""
    return ''.join(secrets.choice(string.ascii_uppercase) for _ in range(length))

# 连续生成 3 组示例凭证
for i in range(1, 4):
print(f"凭证 #{i}: {generate_uppercase_code(8)}")凭证 #2: BDWRYPAJ
凭证 #3: TUFGLCKW
场景 2:强制同时包含大写与小写字母(防单极分布)
若业务要求生成的随机字符串必须同时包含至少 1 个大写字母和 1 个小写字母,单纯从 52 个全字母池中随机采样存在极小的概率生成“全大写”或“全小写”。规范的做法是:先明确采样两个强制字符,其余位自由采样,随后使用密码学安全的算法进行位置重排:
import secrets
import string

def generate_mixed_letters(length: int = 12) -> str:
    """生成强制同时包含大写和小写字母的安全随机串。"""
    if length < 2:
        raise ValueError("为确保包含大小写混合,长度至少为 2")

    # 保证至少包含 1 个大写和 1 个小写
    result = [
        secrets.choice(string.ascii_lowercase),
        secrets.choice(string.ascii_uppercase)
    ]

    # 剩余长度从全部字母集中抽取
    all_letters = string.ascii_letters
    result.extend(secrets.choice(all_letters) for _ in range(length - 2))

    # 使用 Fisher-Yates 算法结合 secrets.randbelow 实现安全的无偏洗牌
    for i in range(len(result) - 1, 0, -1):
        j = secrets.randbelow(i + 1)
        result[i], result[j] = result[j], result[i]

    return ''.join(result)

print("混合强度凭证:", generate_mixed_letters(14))场景 3:为什么不能用 secrets.token_urlsafe() 代替纯字母?
secrets 模块自带了便捷函数 secrets.token_urlsafe(nbytes) 与 secrets.token_hex(nbytes)。很多开发者会问:为什么不直接调用它们?
原因在于字符集边界与业务协议约束:
secrets.token_urlsafe()基于 Base64 编码,其产物包含数字(0-9)以及连字符(-)和下划线(_)。secrets.token_hex()则是十六进制编码,仅包含数字0-9与字母a-f,无法覆盖完整的英文首字母集合。
当某些对外接口、变量命名规范或协议约束严格限定字符范围为正规表达式 ^[a-zA-Z]+$ 时,使用 secrets.choice(string.ascii_letters) 才是完全符合协议标准的做法。
四、安全实施细节与避坑指南
random 和 secrets,开发者在后续编写时随手键入了 random.choice()。代码能正常通过所有单元测试,但在安全层面已退化为可预测的伪随机数。代码静态检查(如 Flake8-bandit 或 Bandit 规则 B311)会对 random 的使用发出安全告警。
1. 为什么不使用 random.SystemRandom().choice()?
在 Python 3.6 之前,官方推荐的安全做法是实例化 random.SystemRandom()。secrets 模块内部正是对 random.SystemRandom 进行了封装与 API 精简。推荐直接使用 secrets 模块,因为它语义明确、无多余的暴露接口,且专门为安全敏感场景设立。
2. 验证随机字母凭据时的时序攻击(Timing Attack)防范
生成随机字母串后,当系统需要比对用户输入的验证码或凭据是否匹配时,绝对不要使用原生的 == 操作符。
常规的 str1 == str2 在遇到首个不匹配字符时会立即中断返回(Short-circuit evaluation)。攻击者可以通过统计网络响应时间差异,以纳秒级的分辨率逐步推测出正确的字符。正确的做法是使用 secrets.compare_digest,该函数以常数时间执行字符串比较:
import secrets

stored_token = "mKqWvPzLgUjTbFxA"
user_input = "mKqWvPzLgUjTbFxA"

# 正确的安全比对方式(常数时间比较,防御侧信道分析)
is_valid = secrets.compare_digest(stored_token, user_input)
print(f"凭证比对结果: {is_valid}")五、总结与核心要素速查
使用 Python 标准库 secrets 模块生成随机字母,能够从根本上切断伪随机数算法的可预测性风险。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















